LTX-Video 是第一個基於 DiT 的視訊生成模型,可以即時產生高品質的視訊。它可以以 1216×704 的分辨率生成 30 FPS 的視頻,比觀看這些視頻的速度還快。該模型在多樣化影片的大規模資料集上進行訓練,可以產生具有逼真和多樣化內容的高解析度影片。模型支援文字轉圖像、圖像轉影片、基於關鍵影格的動畫、影片擴充(正向和反向)、影片轉影片以及這些功能的任意組合。
LTX-Video 是第一個基於 DiT 的視訊生成模型,可以即時產生高品質的視訊。它可以以 1216×704 的分辨率生成 30 FPS 的視頻,比觀看這些視頻的速度還快。該模型在多樣化影片的大規模資料集上進行訓練,可以產生具有逼真和多樣化內容的高解析度影片。模型支援文字轉圖像、圖像轉影片、基於關鍵影格的動畫、影片擴充(正向和反向)、影片轉影片以及這些功能的任意組合。
LTX-Video 是第一個基於 DiT 的視訊生成模型,可以即時產生高品質的視訊。它可以以 1216×704 的分辨率生成 30 FPS 的視頻,比觀看這些視頻的速度還快。該模型在多樣化影片的大規模資料集上進行訓練,可以產生具有逼真和多樣化內容的高解析度影片。模型支援文字轉圖像、圖像轉影片、基於關鍵影格的動畫、影片擴充(正向和反向)、影片轉影片以及這些功能的任意組合。
FramePack 是一種新的視頻擴散設計,用壓縮上下文令工作量不會隨著影片的長度而增加,只需一張圖片,就可以令你的 6GB vRAM 的電腦透過 13B 模型生成每秒 30 格影片的 60 秒影片。而用 RTX 4090 的話,最快速度為每格 1.5 秒。 作者 Lvmin Zhang
FramePack 是一種新的視頻擴散設計,用壓縮上下文令工作量不會隨著影片的長度而增加,只需一張圖片,就可以令你的 6GB vRAM 的電腦透過 13B 模型生成每秒 30 格影片的 60 秒影片。而用 RTX 4090 的話,最快速度為每格 1.5 秒。
作者 Lvmin Zhang

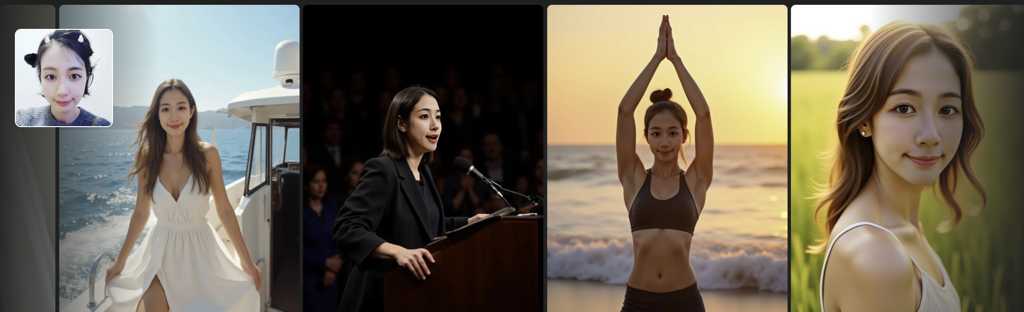
InfiniteYou 的獨特之處在於其強大的身份保留技術!透過核心組件 InfuseNet,即使在生成全新場景或是不同風格的相片,也能精準保留相片中的人物特徵。您可以僅以文字描述,就能讓同一人物出現在不同情境、穿著不同的衫,甚至呈現不同的風格。它亦支援 ControlNet 和 LoRA 的進階控制,令創意揮灑的同時,也能精細調整生成結果,直至符合您需要的獨特內容!(ByteDance)
InfiniteYou 的獨特之處在於其強大的身份保留技術!透過核心組件 InfuseNet,即使在生成全新場景或是不同風格的相片,也能精準保留相片中的人物特徵。您可以僅以文字描述,就能讓同一人物出現在不同情境、穿著不同的衫,甚至呈現不同的風格。它亦支援 ControlNet 和 LoRA 的進階控制,令創意揮灑的同時,也能精細調整生成結果,直至符合您需要的獨特內容!(ByteDance)
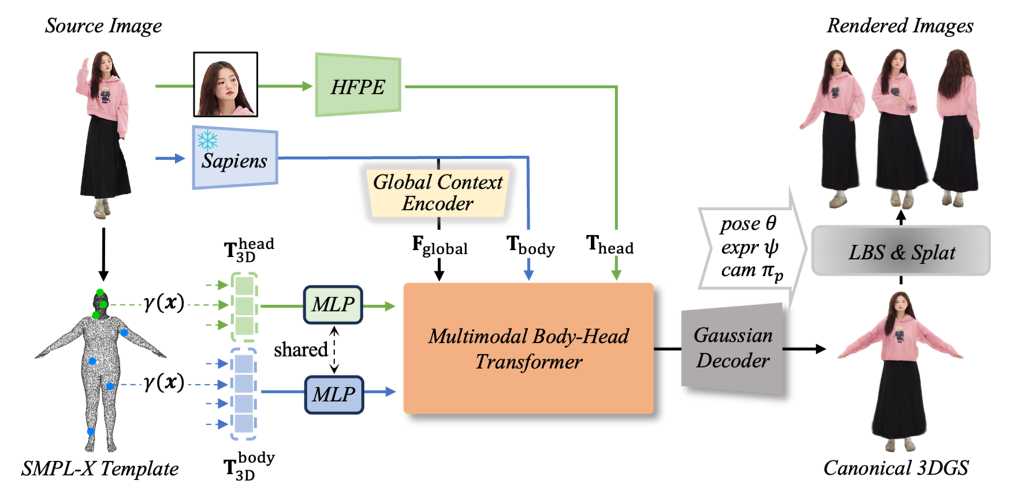
LHM (Large Animatable Human Reconstruction Model) 是一個高效及高質量的 3D 人體重建方案模型,能夠在幾秒鐘內生成影片。模型利用了多模態的 Transformer 架構,以注意力機制,對人體特徵和影像特徵進行編碼,能夠詳細保存服裝的幾何形狀和紋理。為了進一步增強細節,LHM 提出了一種針對頭部特徵的金字塔型編碼方案,能夠生成頭部區域的多種特徵。(阿里巴巴)
LHM (Large Animatable Human Reconstruction Model) 是一個高效及高質量的 3D 人體重建方案模型,能夠在幾秒鐘內生成影片。模型利用了多模態的 Transformer 架構,以注意力機制,對人體特徵和影像特徵進行編碼,能夠詳細保存服裝的幾何形狀和紋理。為了進一步增強細節,LHM 提出了一種針對頭部特徵的金字塔型編碼方案,能夠生成頭部區域的多種特徵。(阿里巴巴)
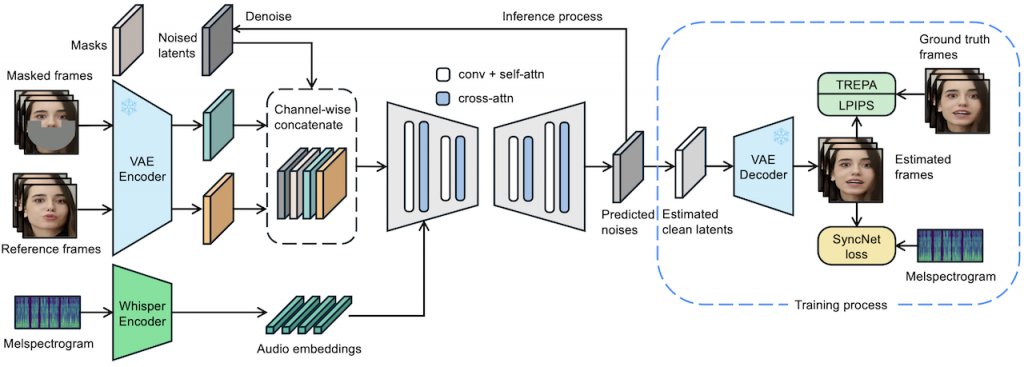
LatentSync 1.5 是 ByteDance 團隊在 GitHub 上發佈的開源專案。1.5 版本增強了中文影片的表現。它的主要功能是直接地將音頻資訊轉換成為逼真的口型動作。專案提供了完整的訓練和推論程式碼,包含資料處理流程、兩種模型訓練步驟(U-Net 和 SyncNet),以及詳細的推論指令。
LatentSync 1.5 是 ByteDance 團隊在 GitHub 上發佈的開源專案。1.5 版本增強了中文影片的表現。它的主要功能是直接地將音頻資訊轉換成為逼真的口型動作。專案提供了完整的訓練和推論程式碼,包含資料處理流程、兩種模型訓練步驟(U-Net 和 SyncNet),以及詳細的推論指令。


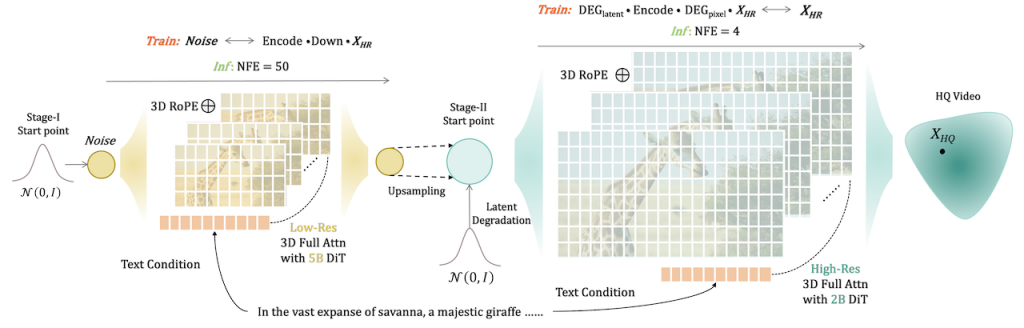
FlashVideo 由香港大學、香港科技大學及 ByteDance 聯合開發,你只需要準備一張或者幾張參考圖片,加上文字提示詞,就可以生成高解像度的影片。過程主要分為兩部份,第一部分是優先處理提示詞,同時以低解像度處理圖片,減少 DIT 的運算時間。第二部分會建立低解像度和高解像度之間的匹配。結果能夠以高速生成 1 0 8 0 P 的高清影片。[DiT] Diffusion Transformer | [NFE ] Number of Function Evaluations
FlashVideo 由香港大學、香港科技大學及 ByteDance 聯合開發,你只需要準備一張或者幾張參考圖片,加上文字提示詞,就可以生成高解像度的影片。過程主要分為兩部份,第一部分是優先處理提示詞,同時以低解像度處理圖片,減少 DIT 的運算時間。第二部分會建立低解像度和高解像度之間的匹配。結果能夠以高速生成 1 0 8 0 P 的高清影片。[DiT] Diffusion Transformer | [NFE ] Number of Function Evaluations
Stability AI 最新發佈的研究預覽模型「Stable Virtual Camera」是一個創新的多視角擴散模型,無需複雜的 3D 建模,就能夠將 2D 圖像轉換成為具有真實深度和透視感的沉浸式 3D 影片。同時,它亦提供了靈活的 3D 攝影機控制,用家可以自定攝影軌跡,而預設的 14 種動態攝影機路徑包括 360°、雙紐線、螺旋、移動推拉、平移和滾動等等。並且能夠由一張或者最多 32 張的圖片生成長達 1000 frames 的連貫影片。這模型目前以非商業授權,主要作為學術研究。而相關的論文、模型權重和程式碼都已經公開下載。其它 Stability 3D 模型
Stability AI 最新發佈的研究預覽模型「Stable Virtual Camera」是一個創新的多視角擴散模型,無需複雜的 3D 建模,就能夠將 2D 圖像轉換成為具有真實深度和透視感的沉浸式 3D 影片。同時,它亦提供了靈活的 3D 攝影機控制,用家可以自定攝影軌跡,而預設的 14 種動態攝影機路徑包括 360°、雙紐線、螺旋、移動推拉、平移和滾動等等。並且能夠由一張或者最多 32 張的圖片生成長達 1000 frames 的連貫影片。這模型目前以非商業授權,主要作為學術研究。而相關的論文、模型權重和程式碼都已經公開下載。其它 Stability 3D 模型
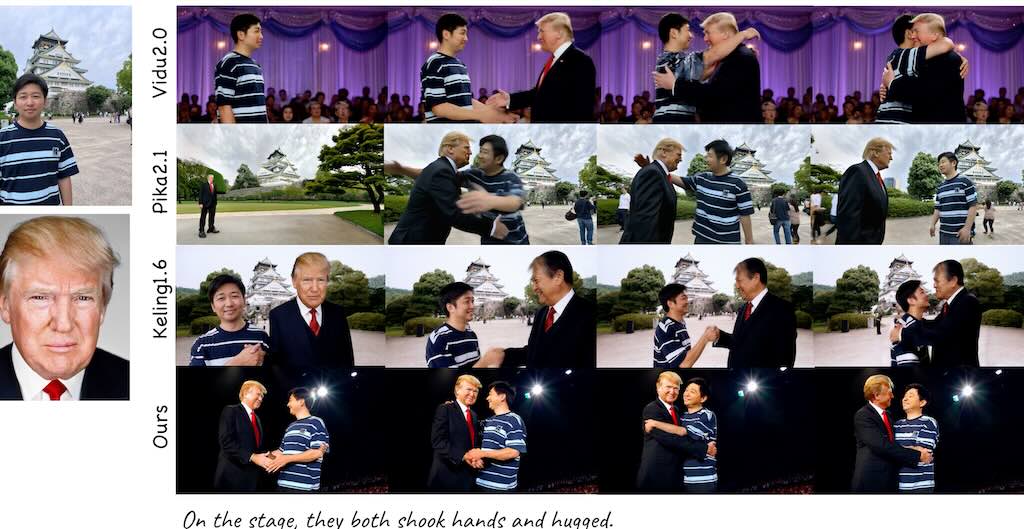
Phantom 是字節跳動最新的影片生成框架,主要是可以生成主體一致性(Subject-to-Video)的影片 。Phantom 會嚴格保留由用家提供的參考影像特徵,同時亦會根據提供的提示詞,創造出生動同連貫的影片。這個技術不單止可以用於單一主體,亦能夠同時處理多個主體之間的互動。透過跨模態對齊的訓練方式,Phantom 確保生成的影片內容既符合文字指令,亦能夠精準呈現參考影像中的主體。
Phantom 是字節跳動最新的影片生成框架,主要是可以生成主體一致性(Subject-to-Video)的影片 。Phantom 會嚴格保留由用家提供的參考影像特徵,同時亦會根據提供的提示詞,創造出生動同連貫的影片。這個技術不單止可以用於單一主體,亦能夠同時處理多個主體之間的互動。透過跨模態對齊的訓練方式,Phantom 確保生成的影片內容既符合文字指令,亦能夠精準呈現參考影像中的主體。
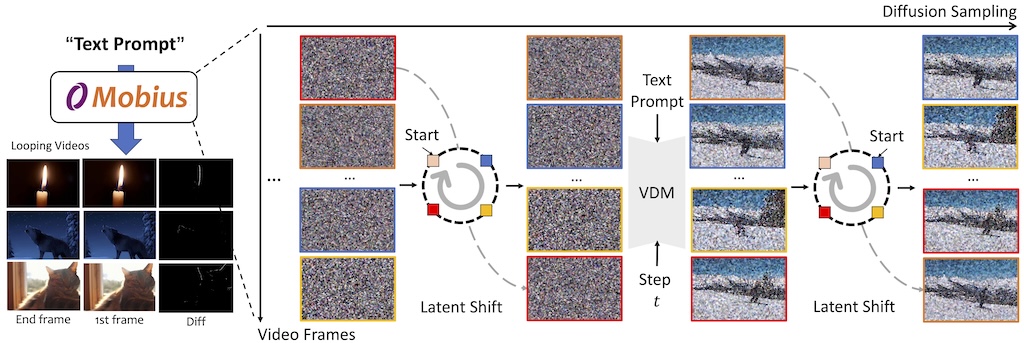
Mobius 無縫循環影片是一個創新的技術方法,通過構建一個潛在循環(Latent Cycle),將影片的起始和結束噪音連接起來,並在推理過程逐步移動潛在空間,結果可以產生具有時間連貫性的循環影片。
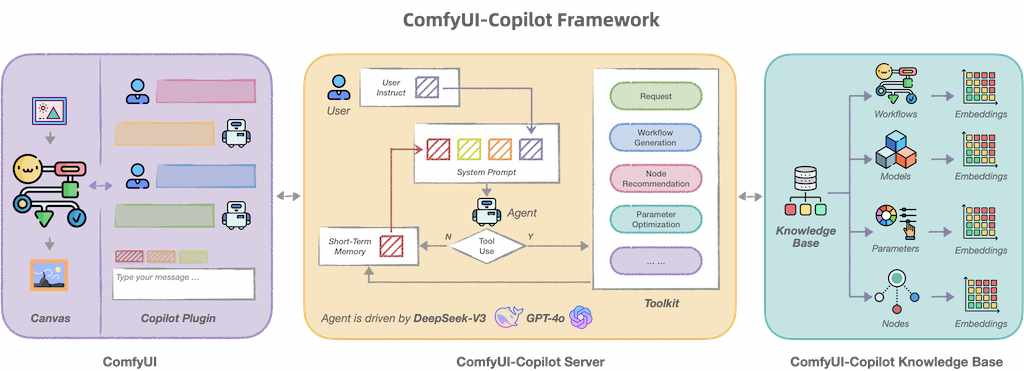
ComfyUI-Copilot 是基於 ComfyUI 框架構建的智能助手,通過自然語言交互簡化並增強 AI 算法調試和部署過程。無論是生成文本、圖像還是音頻,ComfyUI-Copilot 都提供直觀的節點推薦、工作流構建輔助和模型查詢服務,以簡化您的開發過程。
ComfyUI-Copilot 是基於 ComfyUI 框架構建的智能助手,通過自然語言交互簡化並增強 AI 算法調試和部署過程。無論是生成文本、圖像還是音頻,ComfyUI-Copilot 都提供直觀的節點推薦、工作流構建輔助和模型查詢服務,以簡化您的開發過程。