LongSplat 是個用於從隨機拍攝的長影片中生成新穎視角的三維高斯噴灑(3D Gaussian Splatting)框架。它能夠解決從隨機拍攝、具有不規則攝影機運動和未知攝影機姿態的長影片中進行新視角合成的關鍵挑戰。
LongSplat 是個用於從隨機拍攝的長影片中生成新穎視角的三維高斯噴灑(3D Gaussian Splatting)框架。它能夠解決從隨機拍攝、具有不規則攝影機運動和未知攝影機姿態的長影片中進行新視角合成的關鍵挑戰。
LongSplat 是個用於從隨機拍攝的長影片中生成新穎視角的三維高斯噴灑(3D Gaussian Splatting)框架。它能夠解決從隨機拍攝、具有不規則攝影機運動和未知攝影機姿態的長影片中進行新視角合成的關鍵挑戰。
LongSplat 是個用於從隨機拍攝的長影片中生成新穎視角的三維高斯噴灑(3D Gaussian Splatting)框架。它能夠解決從隨機拍攝、具有不規則攝影機運動和未知攝影機姿態的長影片中進行新視角合成的關鍵挑戰。
Qwen-Image-Edit 是 Qwen-Image 的圖像編輯版本,基於20B模型進一步訓練,支持精准文字編輯和語義/外觀雙重編輯能力。它具備多項關鍵功能與技術優勢:
Qwen-Image-Edit 是 Qwen-Image 的圖像編輯版本,基於20B模型進一步訓練,支持精准文字編輯和語義/外觀雙重編輯能力。它具備多項關鍵功能與技術優勢:

傳統的卡通/動漫製作耗時耗力,需要技藝精湛的藝術家進行關鍵影格、中間畫和上色。 ToonComposer 利用生成式 AI 簡化了這個流程,將數小時的中間畫和上色手動工作簡化為一個無縫銜接的流程。
傳統的卡通/動漫製作耗時耗力,需要技藝精湛的藝術家進行關鍵影格、中間畫和上色。 ToonComposer 利用生成式 AI 簡化了這個流程,將數小時的中間畫和上色手動工作簡化為一個無縫銜接的流程。

FantasyPortrait 支援使用多個單人影片或單一多人影片驅動多個角色,產生細緻的表情和逼真的肖像動畫。 從靜態圖像中製作富有表現力的臉部動畫是一項極具挑戰性的任務。現有方法缺乏對多角色動畫的支持,因為不同個體的驅動特徵經常相互幹擾,使任務變得複雜。FantasyPortrait 提出了 Multi-Expr 資料集和 ExprBench,它們是專門為訓練和評估多角色肖像動畫而設計的資料集和基準。大量實驗表明,FantasyPortrait 在定量指標和定性評估方面均顯著超越了最先進的方法,尤其是在具有挑戰性的交叉重現和多角色情境中表現出色。
FantasyPortrait 支援使用多個單人影片或單一多人影片驅動多個角色,產生細緻的表情和逼真的肖像動畫。
從靜態圖像中製作富有表現力的臉部動畫是一項極具挑戰性的任務。現有方法缺乏對多角色動畫的支持,因為不同個體的驅動特徵經常相互幹擾,使任務變得複雜。FantasyPortrait 提出了 Multi-Expr 資料集和 ExprBench,它們是專門為訓練和評估多角色肖像動畫而設計的資料集和基準。大量實驗表明,FantasyPortrait 在定量指標和定性評估方面均顯著超越了最先進的方法,尤其是在具有挑戰性的交叉重現和多角色情境中表現出色。

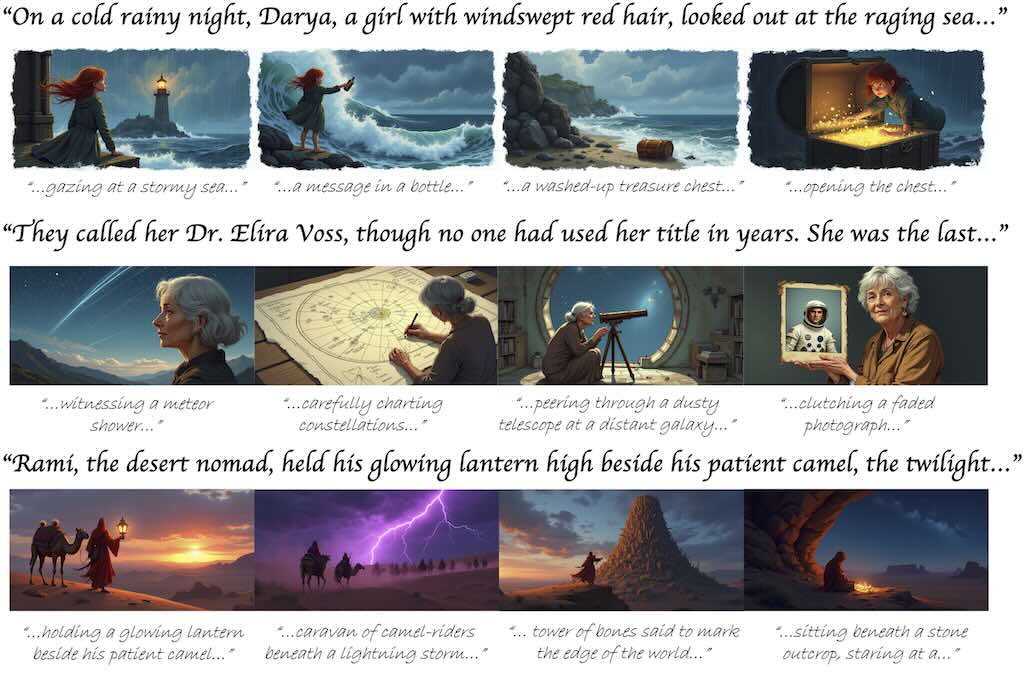
Story2Board 是個無需訓練的框架,用於從自然語言中生成富有表現力的故事板。目標是將敘事呈現為一系列連貫的故事板面板——每個面板描繪不同的場景,同時保留主要角色的身份和外觀。
Story2Board 是個無需訓練的框架,用於從自然語言中生成富有表現力的故事板。目標是將敘事呈現為一系列連貫的故事板面板——每個面板描繪不同的場景,同時保留主要角色的身份和外觀。
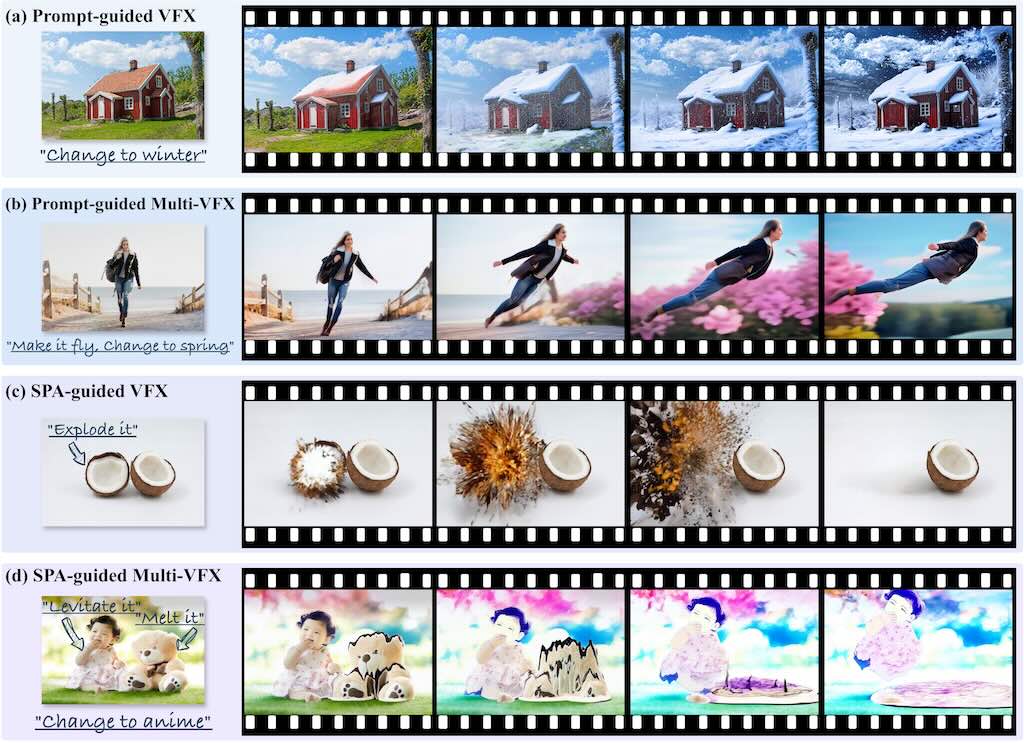
Omni-Effects 是一套針對視覺特效(VFX)生成的統一框架,主打多效果合成和空間可控性。這項技術突破了以往僅能針對單一特效單獨訓練(如 per-effect LoRA)的限制,可同時在指定區域生成多種特效,極大拓展了在影視製作及創意領域的應用可能性。 框架的核心包含兩項關鍵創新:(1) 基於 LoRA 的混合專家 (LoRA-MoE),將多種效果整合到統一模型中,同時有效地減少跨任務幹擾。 (2) 空間感知提示 (SAP)將空間遮罩資訊合併到文字標記中,從而實現精確的空間控制。
Omni-Effects 是一套針對視覺特效(VFX)生成的統一框架,主打多效果合成和空間可控性。這項技術突破了以往僅能針對單一特效單獨訓練(如 per-effect LoRA)的限制,可同時在指定區域生成多種特效,極大拓展了在影視製作及創意領域的應用可能性。
框架的核心包含兩項關鍵創新:(1) 基於 LoRA 的混合專家 (LoRA-MoE),將多種效果整合到統一模型中,同時有效地減少跨任務幹擾。 (2) 空間感知提示 (SAP)將空間遮罩資訊合併到文字標記中,從而實現精確的空間控制。
影片主要介紹如何使用 Ostris AI 開發的 AI Toolkit,在僅有 24 GB VRAM 的 RTX 4090 或 3090 GPU 上,訓練一個基於 Qwen-Image 模型的 LoRA(Low-Rank Adaptation)風格模型。Qwen-Image 是一個 20 億參數的巨型模型,通常需要更高規格的硬體(如 32 GB VRAM 的 RTX 5090),但作者透過創新技術(如量化與 Accuracy Recovery Adapter)實現了在消費級 GPU 上的訓練。影片強調這是對先前影片的延續,先前影片曾在 5090 上使用 6-bit 量化訓練角色 LoRA,而本次聚焦於更常見的 24 GB VRAM 硬體。

影片主要介紹如何使用 Ostris AI 開發的 AI Toolkit,在僅有 24 GB VRAM 的 RTX 4090 或 3090 GPU 上,訓練一個基於 Qwen-Image 模型的 LoRA(Low-Rank Adaptation)風格模型。Qwen-Image 是一個 20 億參數的巨型模型,通常需要更高規格的硬體(如 32 GB VRAM 的 RTX 5090),但作者透過創新技術(如量化與 Accuracy Recovery Adapter)實現了在消費級 GPU 上的訓練。影片強調這是對先前影片的延續,先前影片曾在 5090 上使用 6-bit 量化訓練角色 LoRA,而本次聚焦於更常見的 24 GB VRAM 硬體。
教程展示了AI工具鏈整合的未來趨勢,將碎片化任務轉爲端到端自動化系統,適合想提升創作效率的技術型用戶。若需實作細節,可參考影片中的Docker指令與節點配置截圖。
教程展示了AI工具鏈整合的未來趨勢,將碎片化任務轉爲端到端自動化系統,適合想提升創作效率的技術型用戶。若需實作細節,可參考影片中的Docker指令與節點配置截圖。


1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。 影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)
1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。
影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)
