elframe 簡易提取影片任何幀

最近 AI 生成技術越來越流行應用 image to video,其中最常見的是駛用(first frame)和(last frame)作為提示(prompt)來引導 AI 模型產生更平滑的影片延續效果。令到生成的影片更加有連貫性。例如想由一個影片平滑過渡到另一個影片。ElFrame 正是專為這種工作流設計的簡單輔助工具,它專注影片快速提取最後一幀,用家能夠輕鬆攞到這些關鍵圖像作為後續 AI 生成的輸入。 ElFrame 是一個免費的(Video Frame Extractor),可以快速提取影片的任何一幀。這些提取出的圖像可以直接用於像 Wan 2.1 的 First-Last-Frame to Video 或者其他類似的 AI 工具(例如 Veo3、Luma Dream Machine、Runway ML),作為生成影片的邊界提示,減少生成過程的抖動和不連貫問題。順帶一提,呢個免費服務係由 OpenSpec 協助一邊睇戲一邊自動生成!

最近 AI 生成技術越來越流行應用 image to video,其中最常見的是駛用(first frame)和(last frame)作為提示(prompt)來引導 AI 模型產生更平滑的影片延續效果。令到生成的影片更加有連貫性。例如想由一個影片平滑過渡到另一個影片。ElFrame 正是專為這種工作流設計的簡單輔助工具,它專注影片快速提取最後一幀,用家能夠輕鬆攞到這些關鍵圖像作為後續 AI 生成的輸入。

ElFrame 是一個免費的(Video Frame Extractor),可以快速提取影片的任何一幀。這些提取出的圖像可以直接用於像 Wan 2.1 的 First-Last-Frame to Video 或者其他類似的 AI 工具(例如 Veo3、Luma Dream Machine、Runway ML),作為生成影片的邊界提示,減少生成過程的抖動和不連貫問題。順帶一提,呢個免費服務係由 OpenSpec 協助一邊睇戲一邊自動生成!

本免費功能為本站測試 OpenSpec 開發成果
Categories: Image, 影像處理, 線上服務

NVidia Cosmos 重組光源

開源 Cosmos DiffusionRenderer 是一個視訊擴散框架,用於高品質影像和視訊的去光和重光。它是原始DiffusionRenderer 的重大更新,在 NVIDIA 改進的資料管理流程的支持下,實現了顯著更高品質的結果。 最低要求 Python 3.10 NVIDIA GPU 至少配備 16GB VRAM,建議配備 >=48GB VRAM NVIDIA 驅動程式和 CUDA 12.0 或更高版本 至少 70GB 可用磁碟空間 教學:

開源 Cosmos DiffusionRenderer 是一個視訊擴散框架,用於高品質影像和視訊的去光和重光。它是原始
DiffusionRenderer 的重大更新,在 NVIDIA 改進的資料管理流程的支持下,實現了顯著更高品質的結果。

最低要求
Python 3.10
NVIDIA GPU 至少配備 16GB VRAM,建議配備 >=48GB VRAM
NVIDIA 驅動程式和 CUDA 12.0 或更高版本
至少 70GB 可用磁碟空間
Relight Any Scene with AI: NVIDIA Research Unveils DiffusionRenderer

教學:

NVIDIA's new AI Just Made Any Video Relightable (DiffusionRenderer Demo)
Categories: 開源, 視頻模型, 影像處理, 教學, Linux


USO:統一風格的生成模型

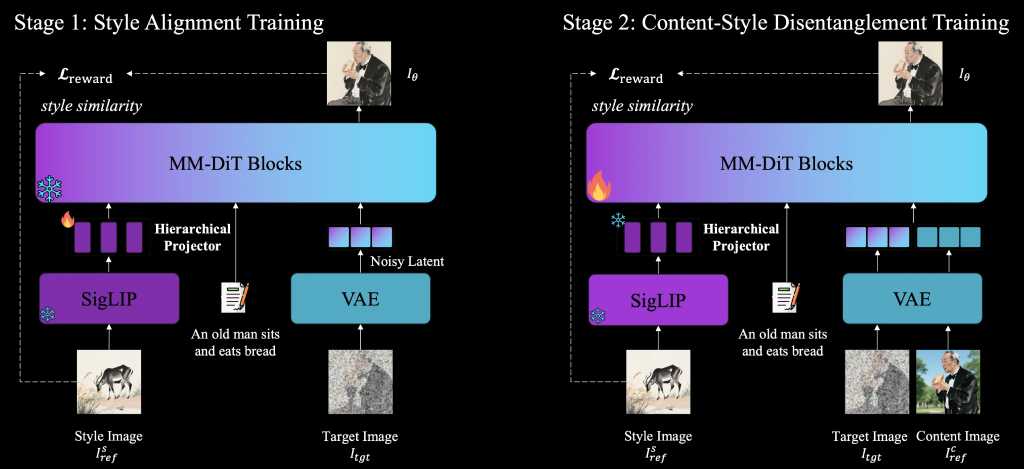
USO 全稱為「Unified Style-Subject Optimized customization model」,能將任何影像主體融入任何風格,開啟創作新紀元並在各種情境中自由揮灑創意。 傳統上,風格驅動生成模型側重於風格相似性,而主體驅動生成模型則強調主體的一致性,這兩者往往難以兼顧。USO 模型的誕生,打破了這種壁壘,它提出了一種統一的框架,透過對「內容」與「風格」的解耦與重組,實現了兩者的自由組合。無論您想將特定人物融入動漫風格,或是為靜物照片賦予水彩畫的韻味,USO 都能輕鬆應對。

USO 全稱為「Unified Style-Subject Optimized customization model」,能將任何影像主體融入任何風格,開啟創作新紀元並在各種情境中自由揮灑創意。

傳統上,風格驅動生成模型側重於風格相似性,而主體驅動生成模型則強調主體的一致性,這兩者往往難以兼顧。USO 模型的誕生,打破了這種壁壘,它提出了一種統一的框架,透過對「內容」與「風格」的解耦與重組,實現了兩者的自由組合。無論您想將特定人物融入動漫風格,或是為靜物照片賦予水彩畫的韻味,USO 都能輕鬆應對。

(more…)
Categories: 開源, 字節跳動, 影像模型, 影像處理

Vision-SR1 圖像超解析度解決方案

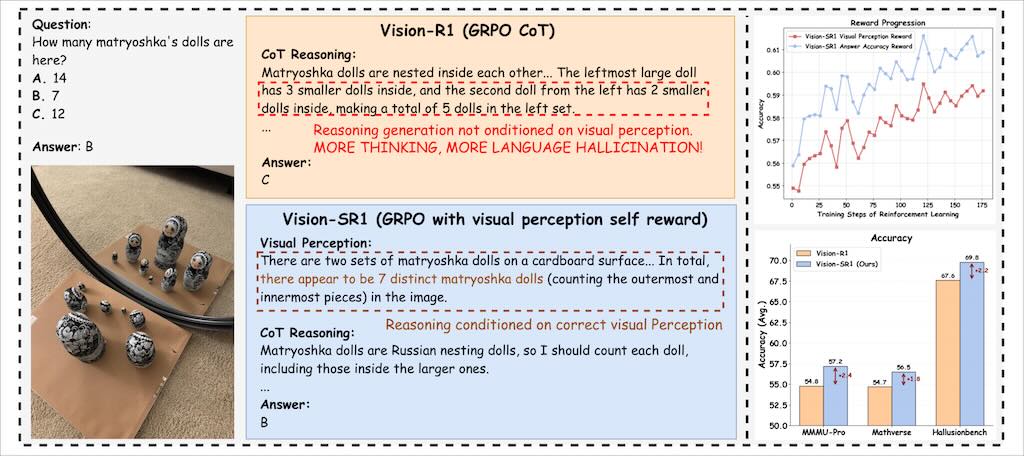
你是否曾因圖像模糊而感到困擾?想放大照片卻又擔心細節盡失?在數位時代,清晰的視覺體驗至關重要。今天,我們將深入探討一項令人興奮的技術——Vision-SR1,一個基於視覺空間推理網路的圖像超解析度解決方案,它有望徹底改變我們處理低解析度圖像的方式。 圖像超解析度(Super-Resolution, SR)的目標是從低解析度(Low-Resolution, LR)圖像中重建出高解析度(High-Resolution, HR)圖像。這項技術在監控、醫學影像、娛樂等多個領域都有廣泛應用。然而,如何有效恢復細節並生成逼真的高解析度圖像,一直是研究人員面臨的挑戰。Vision-SR1 正是為了解決這一挑戰而誕生的創新方法。 Vision-SR1 項目,全名為「Visual-Spatial Reasoning Network for Image Super-Resolution」(用於圖像超解析度的視覺空間推理網路),其核心在於引入了一個獨特的視覺空間推理機制。這意味著它不僅僅是簡單地放大圖像,而是能夠理解圖像中的空間關係和視覺語義,進而更智慧地推斷和重建缺失的細節。透過這種方式,Vision-SR1 能夠生成更為精確和自然的高解析度圖像,顯著提升視覺品質.。

你是否曾因圖像模糊而感到困擾?想放大照片卻又擔心細節盡失?在數位時代,清晰的視覺體驗至關重要。今天,我們將深入探討一項令人興奮的技術——Vision-SR1,一個基於視覺空間推理網路的圖像超解析度解決方案,它有望徹底改變我們處理低解析度圖像的方式。

圖像超解析度(Super-Resolution, SR)的目標是從低解析度(Low-Resolution, LR)圖像中重建出高解析度(High-Resolution, HR)圖像。這項技術在監控、醫學影像、娛樂等多個領域都有廣泛應用。然而,如何有效恢復細節並生成逼真的高解析度圖像,一直是研究人員面臨的挑戰。Vision-SR1 正是為了解決這一挑戰而誕生的創新方法。

Vision-SR1 項目,全名為「Visual-Spatial Reasoning Network for Image Super-Resolution」(用於圖像超解析度的視覺空間推理網路),其核心在於引入了一個獨特的視覺空間推理機制。這意味著它不僅僅是簡單地放大圖像,而是能夠理解圖像中的空間關係和視覺語義,進而更智慧地推斷和重建缺失的細節。透過這種方式,Vision-SR1 能夠生成更為精確和自然的高解析度圖像,顯著提升視覺品質.。

Categories: 開源, 影像處理

ROSE2025 移除影片中任何物件

ROSE2025,全名為「可靠且開放集事件修補(Remove Objects with Side Effects)」。旨在推動電腦視覺領域,為處理複雜、動態的視覺數據缺失問題提供更穩健、更智能的解決方案。在不斷演進的電腦視覺領域,事件修補(Event Inpainting)正成為一項引人注目的新興研究方向。 ROSE2025 涵蓋了多個關鍵研究主題,包括但不限於:基於生成式模型的事件修補方法、深度學習在事件資料恢復的應用、新穎的損失函數與評估指標、開源數據集與基準的創建、以及與機器人、自動駕駛、監控等實際應用場景的結合。

ROSE2025,全名為「可靠且開放集事件修補(Remove Objects with Side Effects)」。旨在推動電腦視覺領域,為處理複雜、動態的視覺數據缺失問題提供更穩健、更智能的解決方案。在不斷演進的電腦視覺領域,事件修補(Event Inpainting)正成為一項引人注目的新興研究方向。
ROSE2025 涵蓋了多個關鍵研究主題,包括但不限於:基於生成式模型的事件修補方法、深度學習在事件資料恢復的應用、新穎的損失函數與評估指標、開源數據集與基準的創建、以及與機器人、自動駕駛、監控等實際應用場景的結合。

Categories: 開源, 香港大學, 視覺模型, 視頻模型, 影像模型, 影像處理

MVTracker 多視角 3D 點追蹤技術突破

在動態場景中精確追蹤物體,一直是電腦視覺領域的一大挑戰。傳統的單目追蹤器常受限於深度模糊和遮擋問題,而現有的多攝影機解決方案又往往需要多達20多個攝影機,並進行繁瑣的逐序列優化。然而,一項由ETH Zürich等機構開發的創新技術——MVTracker,正以其獨特的方法,為多視角3D點追蹤領域帶來革命性的突破。 引領多視角3D追蹤進入數據驅動新時代

在動態場景中精確追蹤物體,一直是電腦視覺領域的一大挑戰。傳統的單目追蹤器常受限於深度模糊和遮擋問題,而現有的多攝影機解決方案又往往需要多達20多個攝影機,並進行繁瑣的逐序列優化。然而,一項由ETH Zürich等機構開發的創新技術——MVTracker,正以其獨特的方法,為多視角3D點追蹤領域帶來革命性的突破。

引領多視角3D追蹤進入數據驅動新時代

(more…)
Categories: 開源, 視覺模型, 影像處理, 3D

Nano Banana 的秘密

Logan Kilpatrick 目前在 Google DeepMind 任職資深 AI 團隊成員。主持人與 Logan Kilpatrick 的一次對談與示範,介紹Google最新的圖像生成與編輯AI模型Nano Banana(基於Gemini 2.5 Flash Image 模型)

Logan Kilpatrick 目前在 Google DeepMind 任職資深 AI 團隊成員。主持人與 Logan Kilpatrick 的一次對談與示範,介紹Google最新的圖像生成與編輯AI模型Nano Banana(基於Gemini 2.5 Flash Image 模型)

I got a private lesson on Google's NEW Nano Banana AI Model
Categories: 影像模型, 影像處理

LIA-X 肖像動畫器

LIA-X (Interpretable Latent Portrait Animator)強調其控制性,適合 AI 研究者和內容創作者使用,旨在將臉部動態從驅動影片遷移到指定的頭像,並實現精細控制。 LIA-X 功能列表 LIA-X 的可解釋性與細粒度控制能力,使其支援多種實際應用: 圖像動畫 (Image Animation):能夠將驅動影片的臉部動態轉移到來源肖像上,並可透過控制面板進行編輯。使用者可以上傳來源圖像和驅動影片,然後使用控制面板編輯來源圖像,並生成動畫影片。 圖像編輯 (Image Editing):允許使用者上傳來源圖像,並透過控制面板對其進行精確編輯。這包括對臉部細節的控制,例如偏航 (yaw)、噘嘴 (pout)、閉眼和眼球移動。 影片編輯 (Video Editing):支援使用者上傳影片,並透過控制面板編輯影片的第一幀,以產生新的編輯後影片。同樣支援細粒度控制,例如頭部偏航和閉眼。 線性操控 (Linear Manipulation):可以進行諸如偏航 (yaw)、俯仰 (pitch)、眼睛閉合與張開,以及眼球移動等臉部動態的線性控制。 3D 感知肖像影片操控 (3D-aware Portrait Video Manipulation):這是一個更進階的應用,LIA-X 的可控性質支援此類應用。 動畫化個人資料 (Animating Your Own Data):支援使用者自行準備圖像和影片資料(例如裁剪),然後進行動畫化處理。 細粒度、使用者引導的圖像和影片編輯:作為其可解釋和可控性質的直接結果,LIA-X 能夠實現這種精確的編輯。

LIA-X (Interpretable Latent Portrait Animator)強調其控制性,適合 AI 研究者和內容創作者使用,旨在將臉部動態從驅動影片遷移到指定的頭像,並實現精細控制。

LIA-X 功能列表

LIA-X 的可解釋性與細粒度控制能力,使其支援多種實際應用:

  • 圖像動畫 (Image Animation):能夠將驅動影片的臉部動態轉移到來源肖像上,並可透過控制面板進行編輯。使用者可以上傳來源圖像和驅動影片,然後使用控制面板編輯來源圖像,並生成動畫影片。
  • 圖像編輯 (Image Editing):允許使用者上傳來源圖像,並透過控制面板對其進行精確編輯。這包括對臉部細節的控制,例如偏航 (yaw)、噘嘴 (pout)、閉眼和眼球移動。
  • 影片編輯 (Video Editing):支援使用者上傳影片,並透過控制面板編輯影片的第一幀,以產生新的編輯後影片。同樣支援細粒度控制,例如頭部偏航和閉眼。
  • 線性操控 (Linear Manipulation):可以進行諸如偏航 (yaw)、俯仰 (pitch)、眼睛閉合與張開,以及眼球移動等臉部動態的線性控制。
  • 3D 感知肖像影片操控 (3D-aware Portrait Video Manipulation):這是一個更進階的應用,LIA-X 的可控性質支援此類應用。
  • 動畫化個人資料 (Animating Your Own Data):支援使用者自行準備圖像和影片資料(例如裁剪),然後進行動畫化處理。
  • 細粒度、使用者引導的圖像和影片編輯:作為其可解釋和可控性質的直接結果,LIA-X 能夠實現這種精確的編輯。

Categories: 開源, 數字人, 視頻模型, 影像模型, 影像處理, 動畫

OmniTry 無需 Mask 的虛擬試穿技術

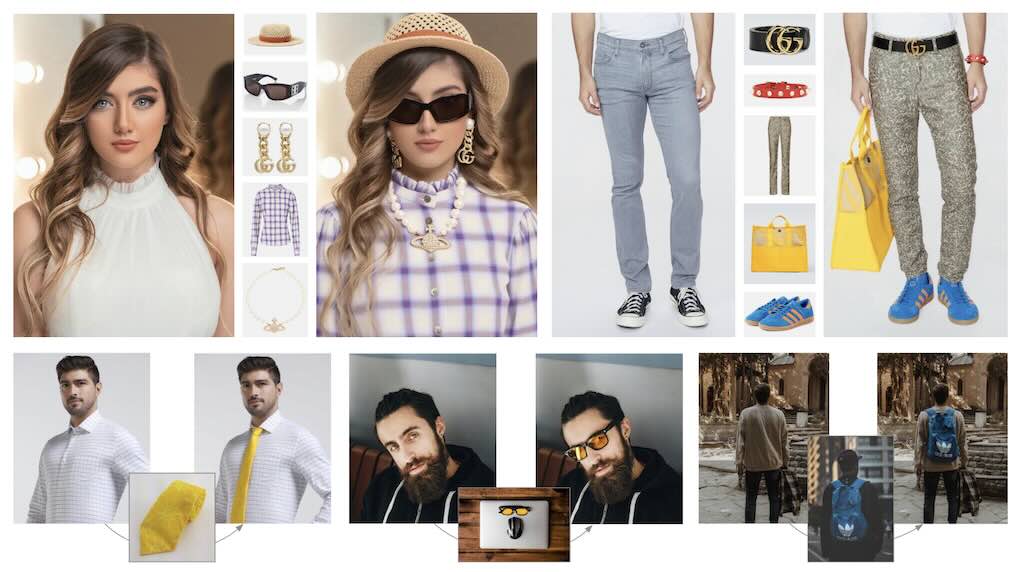
OmniTry,這是一個由昆位元人工智慧和浙江大學開發的虛擬試穿框架。該系統旨在擴展虛擬試穿功能,使其不僅限於服裝,還能應用於各種可穿戴物品,例如珠寶和配飾,並且支援無遮罩設置,更適合實際應用。OmniTry 採用了兩階段訓練管道,首先利用大量不成對的圖像進行無遮罩定位訓練,然後再利用成對圖像進一步精細調整以確保外觀一致性。該專案的程式碼、模型權重和評估基準都已公開發布,供研究人員和開發者使用。

OmniTry,這是一個由昆位元人工智慧和浙江大學開發的虛擬試穿框架。該系統旨在擴展虛擬試穿功能,使其不僅限於服裝,還能應用於各種可穿戴物品,例如珠寶和配飾,並且支援無遮罩設置,更適合實際應用。OmniTry 採用了兩階段訓練管道,首先利用大量不成對的圖像進行無遮罩定位訓練,然後再利用成對圖像進一步精細調整以確保外觀一致性。該專案的程式碼、模型權重和評估基準都已公開發布,供研究人員和開發者使用。

Screenshot
Categories: 開源, 數字人, 影像處理

Page 16 of 22
1 … 14 15 16 17 18 … 22