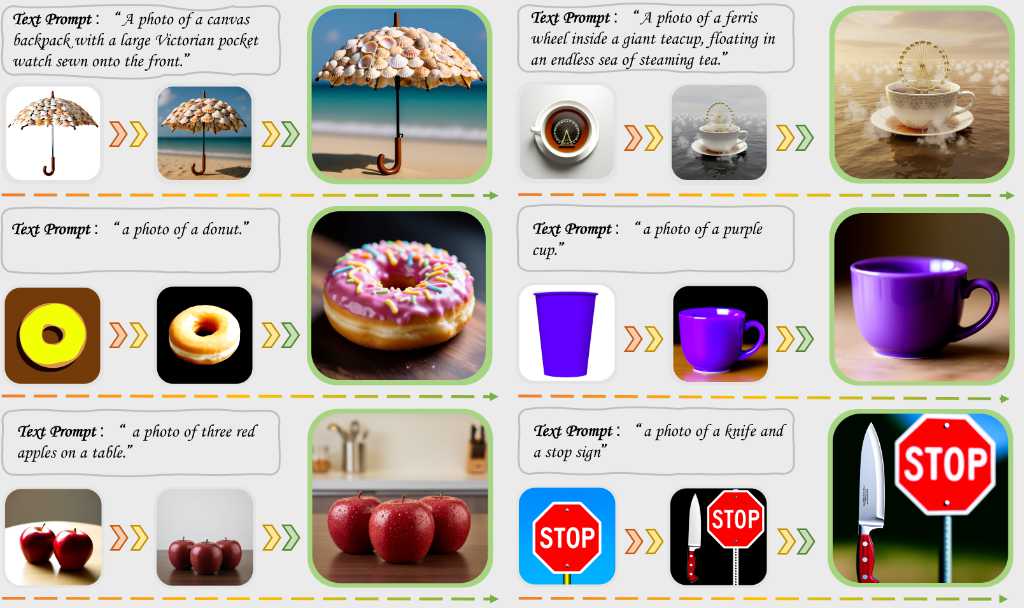
RealRestorer 是一個開源、通用型實拍圖像修復模型,目標是統一處理多種真實世界降級(blur、rain、low‑light、noise、haze 等),同時盡量保留原始場景結構與細節。
RealRestorer 是一個開源、通用型實拍圖像修復模型,目標是統一處理多種真實世界降級(blur、rain、low‑light、noise、haze 等),同時盡量保留原始場景結構與細節。
RealRestorer 是一個開源、通用型實拍圖像修復模型,目標是統一處理多種真實世界降級(blur、rain、low‑light、noise、haze 等),同時盡量保留原始場景結構與細節。
RealRestorer 是一個開源、通用型實拍圖像修復模型,目標是統一處理多種真實世界降級(blur、rain、low‑light、noise、haze 等),同時盡量保留原始場景結構與細節。
Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。 Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。 跨域資料混合:研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。
Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。
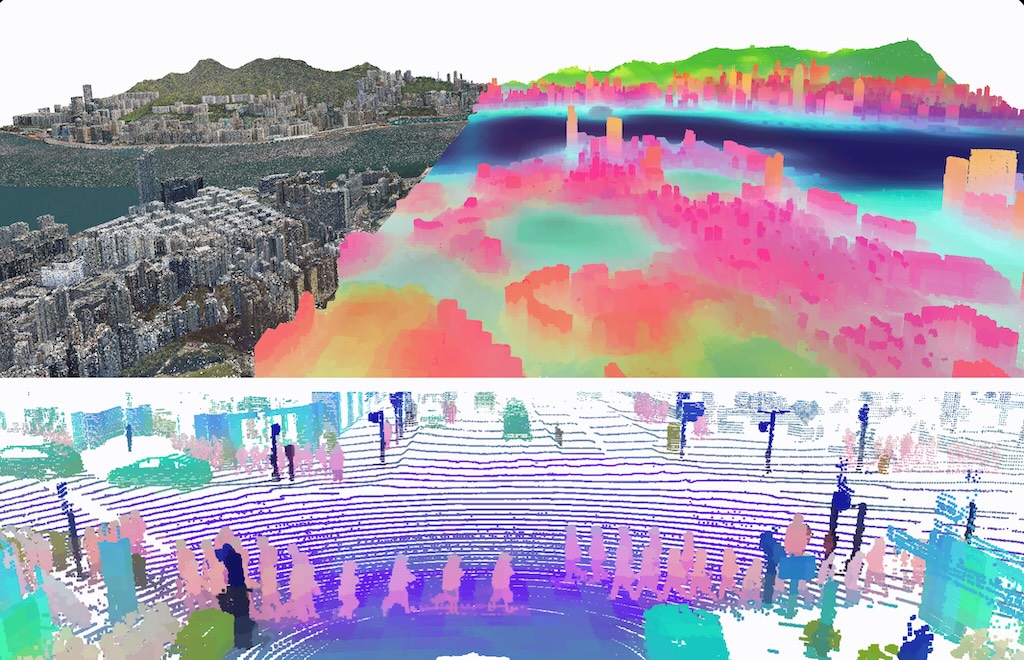
Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。
跨域資料混合:
研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。
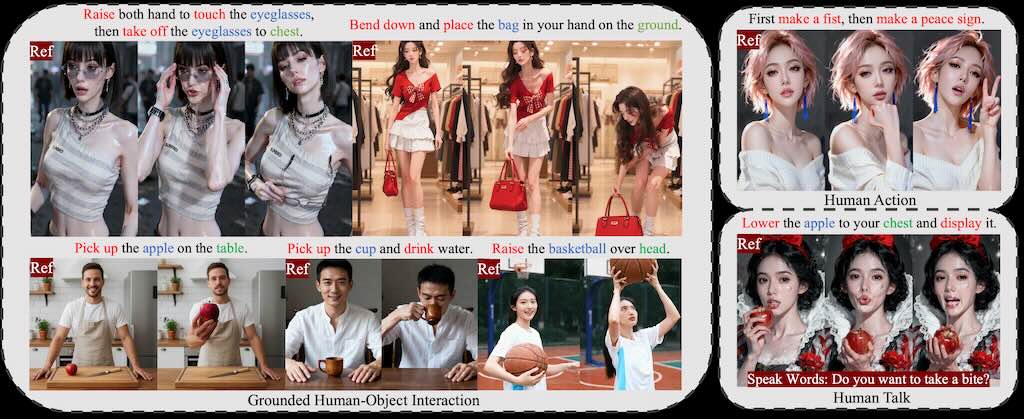
InteractAvatar 能從一張靜態參考圖生成「人與物體互動」的視頻,同時保持音畫同步(lip‑sync + co‑speech gestures)。同時能夠執行基於場景的人機互動 (GHOI)。與以往僅限於簡單手勢的方法不同,我們的模型可以從靜態參考圖像中感知環境,並產生複雜的、文本引導的與物體的交互,同時保持高保真度的唇部同步。 雙流 Diffusion Transformer(DiT)架構:一個分支做「感知與互動規劃」(Perception and Interaction Module, PIM),負責理解圖片裡的物體位置與關係,並生成對齊文字指令的動作序列。另一個分支做「音訊‑互動感知生成」(Audio‑Interaction Aware Generation Module, AIM),把動作與語音融合成高品質視頻。
InteractAvatar 能從一張靜態參考圖生成「人與物體互動」的視頻,同時保持音畫同步(lip‑sync + co‑speech gestures)。同時能夠執行基於場景的人機互動 (GHOI)。與以往僅限於簡單手勢的方法不同,我們的模型可以從靜態參考圖像中感知環境,並產生複雜的、文本引導的與物體的交互,同時保持高保真度的唇部同步。
雙流 Diffusion Transformer(DiT)架構:一個分支做「感知與互動規劃」(Perception and Interaction Module, PIM),負責理解圖片裡的物體位置與關係,並生成對齊文字指令的動作序列。另一個分支做「音訊‑互動感知生成」(Audio‑Interaction Aware Generation Module, AIM),把動作與語音融合成高品質視頻。
DreamActor-M2 是一個通用的角色圖像動畫框架,它將運動條件化重新定義為時空上下文學習任務。我們的設計利用了視訊基礎模型固有的生成先驗訊息,同時實現了從原始視訊直接進行無姿態、端到端運動遷移的關鍵演進。這種範式消除了明確姿態估計的需求,使得DreamActor-M2 能夠在各種複雜場景中實現卓越的泛化能力和高保真度的結果。
DreamActor-M2 是一個通用的角色圖像動畫框架,它將運動條件化重新定義為時空上下文學習任務。我們的設計利用了視訊基礎模型固有的生成先驗訊息,同時實現了從原始視訊直接進行無姿態、端到端運動遷移的關鍵演進。這種範式消除了明確姿態估計的需求,使得
DreamActor-M2 能夠在各種複雜場景中實現卓越的泛化能力和高保真度的結果。
ShapeR 是以 rectified‑flow 為基礎的生成模型,能直接從日常拍攝的影像序列(即「不規則」捕捉)重建高保真的三維物件。整體流程大致可以分成幾個步驟: 先用現成的視覺‑慣性 SLAM 演算法把鏡頭移動和稀疏點雲拿出來,接著再交給 3D 物件偵測器把每個目標物分割出來。每個偵測到的物件會得到幾張具備相機位姿的多視角圖片、一組稀疏的 SLAM 點,還有一段由視覺語言模型自動產生的文字說明。這些資訊(點雲、多視圖、文字)會被封裝成一個多模态的條件向量,送給訓練好的 rectified‑flow Transformer 去去噪。 Transfomer 輸出的 latent VecSet 接著經過一個 3D VAE 解碼,最後生成完整的三維網格。整個模型只需要在合成資料上先做大量的單物件預訓練,接著再在更具挑戰性的合成場景與真實場景資料上進行兩階段的訓練,過程中會不斷加入各種自然的背景、遮擋、噪聲以及 augmentations,讓模型學會在「雜亂」的環境下仍保持穩定。 研究團隊也釋出了一個專屬的評估資料集:裡面有 178 個真實世界的物件分布在七個場景中,配有完整的地面真值網格、配對好的多視圖影像、SLAM 點雲與文字描述。這筆資料專門用來測試在野外捕捉時的遮擋、雜亂、解析度變化等情況,讓模型在更貼近實務的條件下接受測試。 在測試結果上,ShapeR 在 Chamfer Distance 指標上比目前最好的方法提升了 2.7 倍,顯示出在「不規則」情境下的穩定性確實比先前的單視圖或全局場景重建方式更佳。相較於同樣流行的 SAM3D 方法,ShapeR 的特色在於它利用多視圖的幾何資訊(SLAM 點、相機位姿)來保證形狀的尺度與真實感,而 SAM3D 則依賴單張圖像與互動,對於規模和視角的一致性較弱。兩者其實可以互補——把 ShapeR 的幾何結果再送給 SAM3D 生成更豐富的材質或細節。 總結來說,ShapeR 透過把 SLAM 點雲、3D 偵測、多視圖影像和自動文字說明這幾種資訊全部結合起來,做出一個能在日常拍攝場景下產生高品質、具備度量真實性的單物件三維形狀的生成模型,並提供了完整的測試素材與模型資源讓研究者直接使用。 面向 ShapeR SAM3D 輸入 多視角序列 + […]
ShapeR 是以 rectified‑flow 為基礎的生成模型,能直接從日常拍攝的影像序列(即「不規則」捕捉)重建高保真的三維物件。整體流程大致可以分成幾個步驟:
先用現成的視覺‑慣性 SLAM 演算法把鏡頭移動和稀疏點雲拿出來,接著再交給 3D 物件偵測器把每個目標物分割出來。每個偵測到的物件會得到幾張具備相機位姿的多視角圖片、一組稀疏的 SLAM 點,還有一段由視覺語言模型自動產生的文字說明。這些資訊(點雲、多視圖、文字)會被封裝成一個多模态的條件向量,送給訓練好的 rectified‑flow Transformer 去去噪。
Transfomer 輸出的 latent VecSet 接著經過一個 3D VAE 解碼,最後生成完整的三維網格。整個模型只需要在合成資料上先做大量的單物件預訓練,接著再在更具挑戰性的合成場景與真實場景資料上進行兩階段的訓練,過程中會不斷加入各種自然的背景、遮擋、噪聲以及 augmentations,讓模型學會在「雜亂」的環境下仍保持穩定。
研究團隊也釋出了一個專屬的評估資料集:裡面有 178 個真實世界的物件分布在七個場景中,配有完整的地面真值網格、配對好的多視圖影像、SLAM 點雲與文字描述。這筆資料專門用來測試在野外捕捉時的遮擋、雜亂、解析度變化等情況,讓模型在更貼近實務的條件下接受測試。
在測試結果上,ShapeR 在 Chamfer Distance 指標上比目前最好的方法提升了 2.7 倍,顯示出在「不規則」情境下的穩定性確實比先前的單視圖或全局場景重建方式更佳。相較於同樣流行的 SAM3D 方法,ShapeR 的特色在於它利用多視圖的幾何資訊(SLAM 點、相機位姿)來保證形狀的尺度與真實感,而 SAM3D 則依賴單張圖像與互動,對於規模和視角的一致性較弱。兩者其實可以互補——把 ShapeR 的幾何結果再送給 SAM3D 生成更豐富的材質或細節。
總結來說,ShapeR 透過把 SLAM 點雲、3D 偵測、多視圖影像和自動文字說明這幾種資訊全部結合起來,做出一個能在日常拍攝場景下產生高品質、具備度量真實性的單物件三維形狀的生成模型,並提供了完整的測試素材與模型資源讓研究者直接使用。

| 面向 | ShapeR | SAM3D |
|---|---|---|
| 輸入 | 多視角序列 + SLAM 點 + caption 等多模態 | 單張影像 +(物件時多半要 mask / 互動) |
| 任務重點 | 場景級、物件為中心的度量重建與佈局 | 單視圖高品質幾何 + 貼圖的物體/人體重建 |
| 幾何精度 | 強調 metric accuracy、相對尺度與佈局一致性 | 可缺乏精確比例與 layout,特別是複雜場景 |
| 紋理 / 外觀 | 較偏幾何與場景結構(官網重點在 shape) | 強調 photoreal 紋理與真實外觀 priors |
| 互動需求 | 不需要使用者互動,pipeline 自動處理 | 需要物件 mask / prompt,屬於 promptable / interactive workflow |
| 訓練數據 | 合成多模態場景(SLAM + 多視圖) | 大規模真實 image→3D(Objects/Body 各自的 dataset) |
| 適合場景 | AR 眼鏡 / 機器人多視角感知、場景 mapping、學術評測 | 商業應用:電商 AR、human pose & shape、單圖 3D content creation |
CoF-T2I 模型透過漸進式視覺細化,將 CoF 推理整合到 T2I 生成過程中,其中中間幀作為顯式推理步驟,最終幀作為輸出。為了建立這種明確生成過程,CoF-T2I 建立了CoF-Evol-Instruct 資料集,該資料集包含從語義到美學的 CoF 軌跡,用於建模生成過程。為了進一步提高品質並避免運動偽影,CoF-T2I 對每一幀都進行了獨立編碼。實驗表明,CoF-T2I 的性能顯著優於基礎視訊模型,並達到了具有競爭力的水平。
影片主要在介紹幾個最新的生成影音工具與功能,包括 PixVerse R1 即時「世界模型」視頻、Flux 2 Klein 圖像模型、Runway 的 Story Panels、Google Veo 3.1 更新,以及開源的 Wonder Zoom 專案。
影片主要在介紹幾個最新的生成影音工具與功能,包括 PixVerse R1 即時「世界模型」視頻、Flux 2 Klein 圖像模型、Runway 的 Story Panels、Google Veo 3.1 更新,以及開源的 Wonder Zoom 專案。

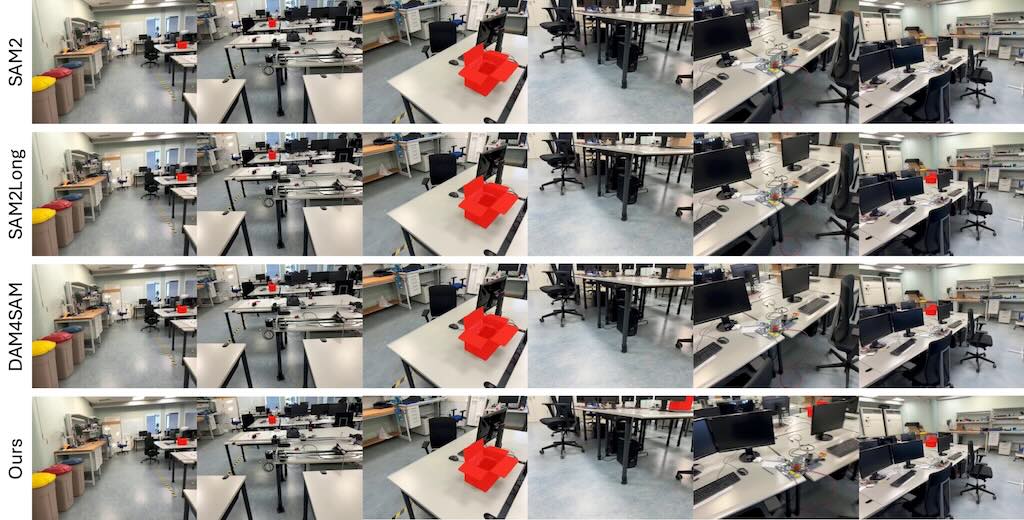
3AM 是一種結合了 2D 即時分割模型 SAM2 與 3D 幾何資訊的方法,目的是在影片或任意多視角圖像集合中,對同一物體保持一致的分割 mask。傳統的 2D 追蹤模型(如 SAM2)在觀點大幅變化時會因為只能依賴外觀特徵而失去目標,而早期的 3D 方法則需要提供相機位姿、深度圖或複雜的前處理,才能保證跨視角的一致性。 3AM 的創新在於在模型訓練階段,透過輕量的特徵合併模組把從 MUSt3R(一個多視角重建模型)學到的隱式幾何特徵與 SAM2 的外觀特徵結合,形成既能捕捉空間位置又能反映視覺相似度的表示。這樣的融合讓模型在推論時只需要原始 RGB 影像和使用者提供的提示(點、框、mask 等),就能在不同觀點之間追蹤物體,且不需要額外的相機資訊或前處理步驟。文章指出,這種做法在包含大量視角變化的基準測試集(如 ScanNet++、Replica)上,IoU 數值提升顯著,例如在 ScanNet++ 的 Selected Subset 上比 SAM2Long 高出約 15.9 個百分點。整體而言,3AM 在保持即時、可提示化的特性同時提升了跨視角的一致性,為後續的 3D 實例分割與多視角物體追蹤提供了一個更簡單、更有效的解方案。
3AM 是一種結合了 2D 即時分割模型 SAM2 與 3D 幾何資訊的方法,目的是在影片或任意多視角圖像集合中,對同一物體保持一致的分割 mask。傳統的 2D 追蹤模型(如 SAM2)在觀點大幅變化時會因為只能依賴外觀特徵而失去目標,而早期的 3D 方法則需要提供相機位姿、深度圖或複雜的前處理,才能保證跨視角的一致性。
3AM 的創新在於在模型訓練階段,透過輕量的特徵合併模組把從 MUSt3R(一個多視角重建模型)學到的隱式幾何特徵與 SAM2 的外觀特徵結合,形成既能捕捉空間位置又能反映視覺相似度的表示。這樣的融合讓模型在推論時只需要原始 RGB 影像和使用者提供的提示(點、框、mask 等),就能在不同觀點之間追蹤物體,且不需要額外的相機資訊或前處理步驟。文章指出,這種做法在包含大量視角變化的基準測試集(如 ScanNet++、Replica)上,IoU 數值提升顯著,例如在 ScanNet++ 的 Selected Subset 上比 SAM2Long 高出約 15.9 個百分點。整體而言,3AM 在保持即時、可提示化的特性同時提升了跨視角的一致性,為後續的 3D 實例分割與多視角物體追蹤提供了一個更簡單、更有效的解方案。
VINO 是個統一的視覺生成工具,能同時處理圖像和影片的創作與編輯,無需針對每種任務去找不同的模型。它的核心架構是把視覺語言模型和多模態擴散轉換器(MMDiT)結合起來,讓文字、參考圖片或影片都能以同一套條件流動的方式被傳遞給擴散過程。 這裡的「可學習查詢 token」扮演的角色是把使用者的簡短指令轉化成模型能理解的細節向量,並在訓練時一起調整,讓指令更精確、模型更穩定。另一個關鍵在於把參考影像或影片所產生的特徵與它在 latent 空間的對應向量用同樣的開始與結束標記包起來,這樣模型就能在語意層面和潛在層面都把同一個參考資源針對地辨識出來,減少身份混淆或屬性遺漏的問題。
VINO 是個統一的視覺生成工具,能同時處理圖像和影片的創作與編輯,無需針對每種任務去找不同的模型。它的核心架構是把視覺語言模型和多模態擴散轉換器(MMDiT)結合起來,讓文字、參考圖片或影片都能以同一套條件流動的方式被傳遞給擴散過程。
這裡的「可學習查詢 token」扮演的角色是把使用者的簡短指令轉化成模型能理解的細節向量,並在訓練時一起調整,讓指令更精確、模型更穩定。另一個關鍵在於把參考影像或影片所產生的特徵與它在 latent 空間的對應向量用同樣的開始與結束標記包起來,這樣模型就能在語意層面和潛在層面都把同一個參考資源針對地辨識出來,減少身份混淆或屬性遺漏的問題。
InfiniDepth 把傳統的深度圖想成一個可以在任何二維座標上即時查詢的隱式場(Implicit Field),而不是固定在像素格子裡。這樣的表示方式讓模型不再受到訓練解析度的限制,能夠直接輸出任意高解析度的深度圖,同時保留更細緻的幾何細節。
InfiniDepth 把傳統的深度圖想成一個可以在任何二維座標上即時查詢的隱式場(Implicit Field),而不是固定在像素格子裡。這樣的表示方式讓模型不再受到訓練解析度的限制,能夠直接輸出任意高解析度的深度圖,同時保留更細緻的幾何細節。