SemanticGen 加入語意生成影片

SemanticGen 首先在高層語義空間中生成視頻,然後在 VAE 潛在空間中細化細節。SemanticGen 的核心觀點是,鑑於影片中固有的大量冗餘訊息,視訊生成應首先在緊湊的語義空間中進行全局規劃,然後再添加高頻細節——而不是直接對大量的底層視訊標記進行建模。

SemanticGen 首先在高層語義空間中生成視頻,然後在 VAE 潛在空間中細化細節。SemanticGen 的核心觀點是,鑑於影片中固有的大量冗餘訊息,視訊生成應首先在緊湊的語義空間中進行全局規劃,然後再添加高頻細節——而不是直接對大量的底層視訊標記進行建模。

Categories: 香港中文大學, 影像處理

InfCam 攝影機 outpaint 控制

InfCam,一個無需深度資訊、攝影機控制的視訊生成框架,能夠實現高姿態保真度。該框架整合了兩個關鍵組件: 架構包含同次引導自注意力層(homography-guided self-attention),輸入源視頻、目標及變換潛在表示與相機嵌入,確保時間對齊與旋轉感知推理。 變換模塊處理旋轉後添加平移嵌入,將重投影簡化為相對於無限遠平面的視差估計,提升軌跡忠實度。 透過增強 MultiCamVideo 數據集生成 AugMCV,引入多樣初始姿態與焦距軌跡,解決現有 SynCamVideo 等數據集偏差。 實驗結果表明,在 AugMCV 與 WebVid 數據集上,InfCam 在相同/不同內參情境下,於姿態準確度與視覺保真度皆優於基準,尤其在真實世界數據泛化表現突出。

InfCam,一個無需深度資訊、攝影機控制的視訊生成框架,能夠實現高姿態保真度。該框架整合了兩個關鍵組件:

架構包含同次引導自注意力層(homography-guided self-attention),輸入源視頻、目標及變換潛在表示與相機嵌入,確保時間對齊與旋轉感知推理。 變換模塊處理旋轉後添加平移嵌入,將重投影簡化為相對於無限遠平面的視差估計,提升軌跡忠實度。

透過增強 MultiCamVideo 數據集生成 AugMCV,引入多樣初始姿態與焦距軌跡,解決現有 SynCamVideo 等數據集偏差。

實驗結果表明,在 AugMCV 與 WebVid 數據集上,InfCam 在相同/不同內參情境下,於姿態準確度與視覺保真度皆優於基準,尤其在真實世界數據泛化表現突出。

Categories: 開源, 視覺模型, 視頻模型, 影像模型, 影像處理

RePlan 圖像編輯框架

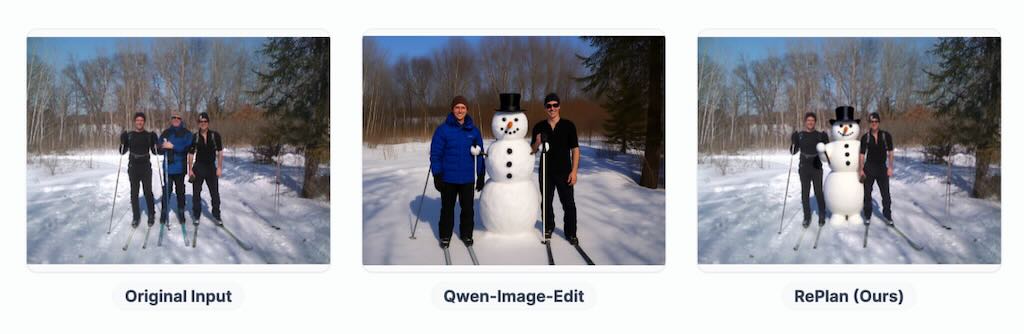
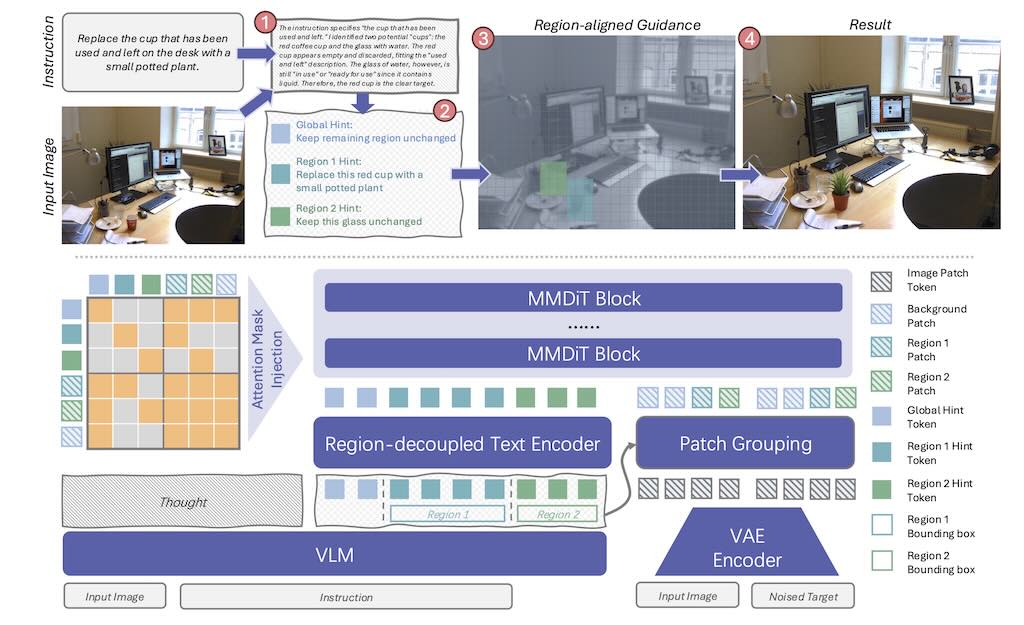
RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。 框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。

RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。

框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。

Categories: 開源, 香港中文大學, 香港科技大學, 騰訊, 影像模型, 影像處理, Python, 新聞

PersonaLive 安裝教學 (12G VRAM)

影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。

影片將一步步帶你上手 PersonaLive,教你如何使用 AI 即時角色變換,在直播或影片中實現即時變身效果,全流程免費。

用 AI 即時變身女神|免費
Categories: 開源, 數字人, 影像模型, 影像處理, Python

Qwen Image Edit 2511 教學

在本機用 ComfyUI 跑 Qwen Image Edit 2511,包含 BF16、FP8 和 GGUF 量化版本,以及 Lightning 4‑step LoRA 的完整實戰示範。

在本機用 ComfyUI 跑 Qwen Image Edit 2511,包含 BF16、FP8 和 GGUF 量化版本,以及 Lightning 4‑step LoRA 的完整實戰示範。

Qwen Image Edit 2511–Local Image Editing in ComfyUI | Multi-Reference Style Transfer & GGUF Workflow
Categories: 開源, 阿里巴巴, ComfyUI, 影像模型, 影像處理

輕鬆製作超逼真 AI 說話頭像影片

InfiniteTalk 完全免費、支援長影片,唇同步自然但需調參避免誇張;HeyGen 更親民但付費,兩者差異不大,InfiniteTalk 性價比高。 適合 IT 顧問用於快速製作教程或演示影片,節省攝影成本。

InfiniteTalk 完全免費、支援長影片,唇同步自然但需調參避免誇張;HeyGen 更親民但付費,兩者差異不大,InfiniteTalk 性價比高。 適合 IT 顧問用於快速製作教程或演示影片,節省攝影成本。

Create Realistic AI AVATARS That Look And Talk EXACTLY Like You! | FREE ComfyUI Tutorial
Categories: ComfyUI, AI productions, 數字人, 影像處理, Python

蘋果開源SHARP AI模型,將照片轉換為3D場景

Apple 開源的 SHARP 能讓你輸入單張 2D 圖片,輸出場景的 3D Gaussian 表示(3DGS),可以之後用 3D Gaussian splatting 實時渲染不同視角。這個推論過程在標準 GPU 上小於一秒完成。 SHARP 能產生的 3D 表示是有公尺尺度的 metric representation,所以可以支援具物理意義的相機移動,而不是純視覺特效式的視差

Apple 開源的 SHARP 能讓你輸入單張 2D 圖片,輸出場景的 3D Gaussian 表示(3DGS),可以之後用 3D Gaussian splatting 實時渲染不同視角。這個推論過程在標準 GPU 上小於一秒完成。

SHARP 能產生的 3D 表示是有公尺尺度的 metric representation,所以可以支援具物理意義的相機移動,而不是純視覺特效式的視差

Apple's SHARP Computer Vision Model - Install and Run Locally
Categories: 開源, 影像模型, 影像處理

Saber

Saber 由 Meta 開發,是一個「只用影片+文字資料就能做參考到影片生成」的零訓練框架,輸入幾張參考圖和一段文字,就能生出既長得像參考主體、又符合文字描述的影片。​(訓練和推理程式碼整理完畢後將會發布,敬請期待。) 一般 R2V (Reference to video)要「參考圖+影片+文字」三元組,資料很難蒐集也不易擴充。Saber 完全不收這種三元組,只吃大規模「影片+文字」。​ 訓練時,它把同一支影片中的某些幀「當成參考圖」,再加上遮罩,讓模型自己學會:怎麼在生成影片時保持主角長相一致、又能跟文字對齊。​ 技術做法(直覺理解)遮罩訓練:從影片抽幀,套上各種形狀與面積比例的二值遮罩,當作「動態參考圖庫」,讓模型看到超多種類的參考條件。​ 遮罩增強:對圖和遮罩一起做旋轉、縮放、平移、翻轉等變形,打亂空間對齊,避免模型學到「直接把參考貼上去」的作弊路線。​ 模型與注意力設計影片與參考圖先丟進 VAE 變成 latent,然後在時間維度把「影片 latent」和「參考 latent」串起來,一起丟進 Transformer 做擴散。參考 latent 不加噪音,保持條件乾淨。​ 自注意力裡用「注意力遮罩」限制:影片 token 可以互相看、也能看參考,但參考 token 只能看自己有效的前景區域,避免注意到背景干擾。​ 推論流程與能力推論時,會先用預訓練分割器(例如 BiRefNet)把參考圖的人或物分出來;如果想要用整張背景當條件,就不做分割而用全 1 遮罩。​ Saber 可以吃多張參考,支援多視角同一主體,也能多主體;在 OpenS2V-Eval 基準上,主體一致性與整體品質都比 Phantom、VACE、Kling1.6 等專門 R2V 模型更好。​ 限制與展望當參考圖過多(例如 12 張)時,模型有機會「崩壞」,把不同參考碎片硬湊在同一畫面,語義整合不足。​ 目前重心在身份保留與視覺自然度,對非常細緻的動作控制或複雜時序一致性仍不完美,未來方向包括更聰明地整合大量參考及更可控的動作與真實感。 官方 GitHub 儲存庫為 https://github.com/franciszzj/Saber,提供模型細節與訓練資訊。 論文《Scaling Zero-Shot Reference-to-Video Generation》發布於 arXiv (2512.06905)。

Saber 由 Meta 開發,是一個「只用影片+文字資料就能做參考到影片生成」的零訓練框架,輸入幾張參考圖和一段文字,就能生出既長得像參考主體、又符合文字描述的影片。​(訓練和推理程式碼整理完畢後將會發布,敬請期待。)


一般 R2V (Reference to video)要「參考圖+影片+文字」三元組,資料很難蒐集也不易擴充。Saber 完全不收這種三元組,只吃大規模「影片+文字」。​

訓練時,它把同一支影片中的某些幀「當成參考圖」,再加上遮罩,讓模型自己學會:怎麼在生成影片時保持主角長相一致、又能跟文字對齊。​

技術做法(直覺理解)
遮罩訓練:從影片抽幀,套上各種形狀與面積比例的二值遮罩,當作「動態參考圖庫」,讓模型看到超多種類的參考條件。​

遮罩增強:對圖和遮罩一起做旋轉、縮放、平移、翻轉等變形,打亂空間對齊,避免模型學到「直接把參考貼上去」的作弊路線。​

模型與注意力設計
影片與參考圖先丟進 VAE 變成 latent,然後在時間維度把「影片 latent」和「參考 latent」串起來,一起丟進 Transformer 做擴散。參考 latent 不加噪音,保持條件乾淨。​

自注意力裡用「注意力遮罩」限制:影片 token 可以互相看、也能看參考,但參考 token 只能看自己有效的前景區域,避免注意到背景干擾。​

推論流程與能力
推論時,會先用預訓練分割器(例如 BiRefNet)把參考圖的人或物分出來;如果想要用整張背景當條件,就不做分割而用全 1 遮罩。​

Saber 可以吃多張參考,支援多視角同一主體,也能多主體;在 OpenS2V-Eval 基準上,主體一致性與整體品質都比 Phantom、VACE、Kling1.6 等專門 R2V 模型更好。​

限制與展望
當參考圖過多(例如 12 張)時,模型有機會「崩壞」,把不同參考碎片硬湊在同一畫面,語義整合不足。​

目前重心在身份保留與視覺自然度,對非常細緻的動作控制或複雜時序一致性仍不完美,未來方向包括更聰明地整合大量參考及更可控的動作與真實感。

官方 GitHub 儲存庫為 https://github.com/franciszzj/Saber,提供模型細節與訓練資訊。 論文《Scaling Zero-Shot Reference-to-Video Generation》發布於 arXiv (2512.06905)。

Categories: 開源, 影像模型, 影像處理

OneStory – I2V 生成多鏡組合

現實世界的視訊敘事往往由多個鏡頭組成——這些鏡頭表面上不連續,但在語義上彼此關聯,共同構成完整且連貫的故事。然而,現有的多鏡頭視訊生成(Multi-Shot Video Generation, MSV)方法難以有效捕捉長距離的跨鏡頭語意關聯,主要因其依賴有限的時間窗口或單關鍵影格條件,導致在複雜敘事場景中表現受限。 為此,Meta 提出 OneStory,一種可同時建模全局語義與緊湊上下文的多鏡頭生成方法,實現一致且可擴展的長篇敘事生成。OneStory 將 MSV 問題重新定義為「下一鏡頭生成」任務,基於預訓練的影像轉影片(Image-to-Video, I2V)模型進行強視覺條件化,並透過自回歸方式生成鏡頭序列。

現實世界的視訊敘事往往由多個鏡頭組成——這些鏡頭表面上不連續,但在語義上彼此關聯,共同構成完整且連貫的故事。然而,現有的多鏡頭視訊生成(Multi-Shot Video Generation, MSV)方法難以有效捕捉長距離的跨鏡頭語意關聯,主要因其依賴有限的時間窗口或單關鍵影格條件,導致在複雜敘事場景中表現受限。

為此,Meta 提出 OneStory,一種可同時建模全局語義與緊湊上下文的多鏡頭生成方法,實現一致且可擴展的長篇敘事生成。OneStory 將 MSV 問題重新定義為「下一鏡頭生成」任務,基於預訓練的影像轉影片(Image-to-Video, I2V)模型進行強視覺條件化,並透過自回歸方式生成鏡頭序列。

Categories: 影像模型, 影像處理

Light-X 修正相片/影片光渲染及視角

Light-X 是個視訊生成框架,它能夠從視訊中實現可控渲染,並同時控制視角和光照。 Light-X 提出一種解耦設計,將幾何形狀和光照信號解耦:幾何形狀和運動通過沿用戶定義的相機軌跡投影的動態點雲來捕獲,而光照線索則由始終投影到相同幾何形狀的重新光照幀提供。這些明確的、細粒度的線索能夠有效地解耦,並指導高品質的光照。 為了解決缺乏配對的多視角和多光照視頻的問題,Light-X 引入了Light-Syn,這是一種基於退化和逆映射的流程,它利用自然場景下的單目視頻素材合成訓練對。此策略產生了一個涵蓋靜態、動態和 AI 生成場景的資料集,確保了訓練的穩健性。大量實驗表明,Light-X 在聯合相機光照控制方面優於基線方法,並且在文字和背景兩種條件下均優於以往的視訊重光照方法。

Light-X 是個視訊生成框架,它能夠從視訊中實現可控渲染,並同時控制視角和光照。

Light-X 提出一種解耦設計,將幾何形狀和光照信號解耦:幾何形狀和運動通過沿用戶定義的相機軌跡投影的動態點雲來捕獲,而光照線索則由始終投影到相同幾何形狀的重新光照幀提供。這些明確的、細粒度的線索能夠有效地解耦,並指導高品質的光照。

為了解決缺乏配對的多視角和多光照視頻的問題,Light-X 引入了Light-Syn,這是一種基於退化和逆映射的流程,它利用自然場景下的單目視頻素材合成訓練對。此策略產生了一個涵蓋靜態、動態和 AI 生成場景的資料集,確保了訓練的穩健性。大量實驗表明,Light-X 在聯合相機光照控制方面優於基線方法,並且在文字和背景兩種條件下均優於以往的視訊重光照方法。

httpv://www.youtube.com/watch?v=ui9Lg2H–0c
Categories: 開源, 香港中文大學, 影像處理

Page 14 of 22
1 … 12 13 14 15 16 … 22