GENEB 統整基因組模型評測:跨 100 個任務的統一比較框架

GENEB 以 100 個分類任務、13 個功能類別,統一評比 40 個基因組基礎模型的表徵能力,揭露排行榜不穩定、規模效益有限等關鍵發現。

Repository image for darlednik/GENEB

基因組機器學習近十年快速擴張,但模型之間的比較長期處於碎片化狀態。DARLEDNIK/GENEB 正是針對這項痛點設計的統一評測基準,收錄 100 個分類任務、橫跨 13 個功能類別,並透過線性探測(linear probe)方式,在完整、10-shot 與 1-shot 三種情境下評估預訓練模型凍結後的表徵品質。

這個項目最大的特色是統一了過往各家模型各自為政的評測協議。你只需在 harness/extractors/ 撰寫一個小型 embedding extractor,就能用 run_GENEB.py 在固定的 GENEB 任務資料上產生提交檔,並由 CI 自動驗證後合併到排行榜。提交的模型權重並不儲存在儲存庫內,僅保留評測結果與模型卡片,設計上兼顧了可重現性與第三方權重規範。

它可以支援訓練後的評估,例如你訓練完不同 genomic foundation models,拿 GENEB 來比較它們在多任務、多類別上的表現。

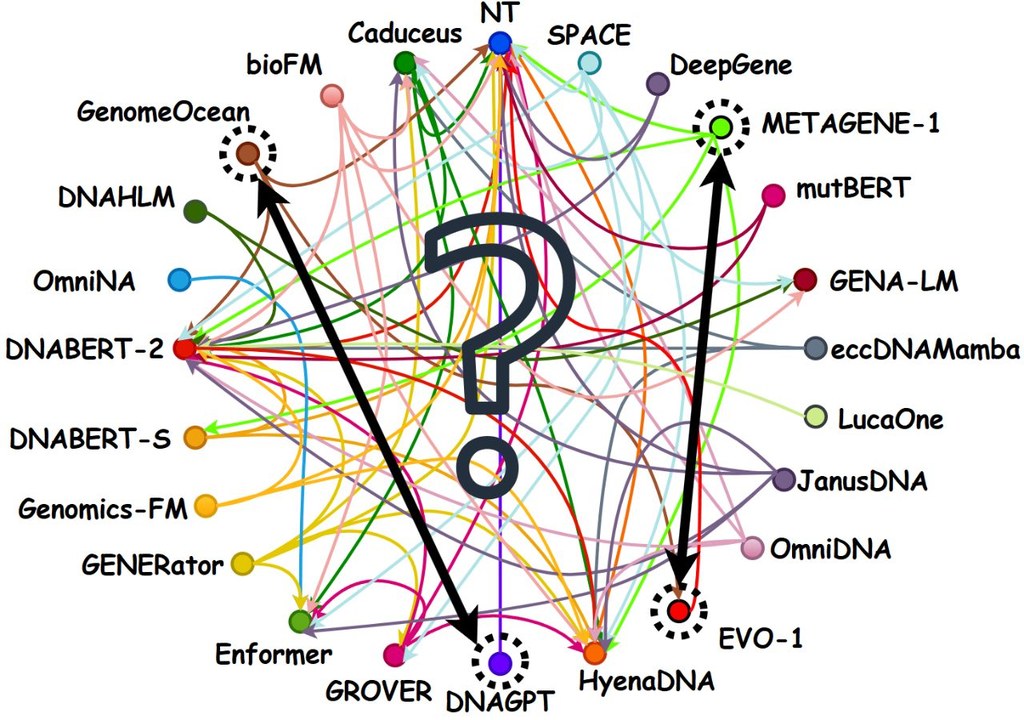
GENEB 對 40 個基因組基礎模型進行了系統性比較,包括 DNA-GPT、GENOMEOCEAN、EVO 等知名模型。研究發現,聚合排行榜其實相當不穩定:模型在不同任務類別的排名會大幅擺動,單一總分容易掩蓋細節差異。論文也指出,模型規模帶來的提升有限且不一致,架構與預訓練資料的對齊程度,往往比參數量更影響下游表現。這些結論對領域內「愈大愈好」的直覺提出了務實的提醒。

這個項目特別適合基因組學領域的研究者、模型開發者,以及需要為下游應用挑選合適表徵的工程團隊。對於想了解現有基因組模型相對強弱的人,Hugging Face Space 上的排行榜提供了 macro 分數與單任務分數兩種視角,方便依功能類別做選擇。

重點摘要:

  • 涵蓋 100 個任務、13 個功能類別,並支援 full、10-shot、1-shot 三種評測設定。
  • 採用線性探測協議,統一比較 40 個基因組基礎模型的凍結表徵。
  • 透過 embedding extractor 介面與 CI 流程,確保新模型提交的可重現性。
  • 論文分析顯示聚合排行榜不穩定,模型排名隨任務類別大幅變動。
  • 規模效益有限,架構與預訓練對齊對表現的影響往往大於參數量。

GitHub: https://github.com/darlednik/GENEB

項目: https://huggingface.co/spaces/darlednik/geneb-leaderboard
Categories: 開源, 框架, Medical醫學

SoCRATES:量度 LLM 調解能力的新基準

SoCRATES 用真實衝突場景測試 LLM 調解表現,重點看它能否因應情緒、背景與互動變化作出介入。

Data Intelligence System Lab

SoCRATES 是一個用來評估 Large Language Models(LLMs)在社會衝突中擔任主動調解者的 benchmark。它關注的不是單次答題表現,而是調解過程:兩方在對話中情緒、意圖與情境會不斷改變,模型需要判斷何時介入,以及應該說甚麼,並且不能偏幫任何一方。

現有測試環境太單一,很多只涵蓋少量由專家撰寫的場景,或者把每一句對話都拿去對照所有議題評分,令結果混入不相關訊號。SoCRATES 則以 agentic pipeline 把真實公開爭議整理成場景,覆蓋八個衝突領域,並沿五條 socio-cognitive axes 測試模型在不同條件下的調整能力。

評分部分採用 topic-localized evaluator,只會在真正推進某個議題的回合上計分,並以三個 metrics 量度調解貢獻,減少離題內容影響結果。

  • 以真實公開衝突建立場景,不限單一領域
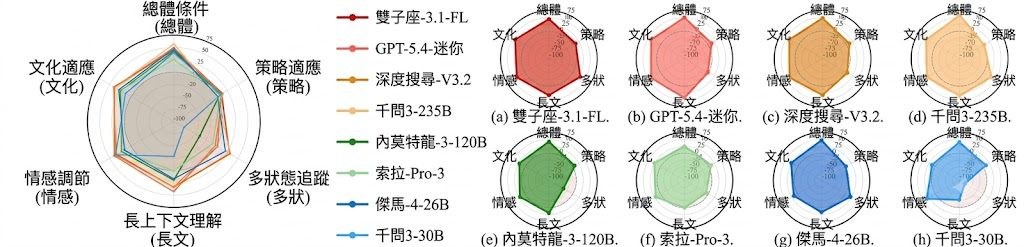
  • 測試 strategic posture、party composition、history length、emotional reactivity、cultural identity 五種變化
  • topic-localized evaluator 與人類專家的一致度達 0.82
  • 測試八個 frontier LLMs,最強模型亦只填補約三分一未調解時的共識落差

從目前結果看,SoCRATES 適合研究 LLM 調解能力、社會互動能力與多情境適應性的團隊使用,也適合用來比較不同模型在複雜對話任務中的穩定性。數據顯示,表現會因 socio-cognitive axis 明顯波動,說明這類項目的關鍵不只是語言生成,而是能否隨不同人、不同情緒與不同背景作出合適調整。

項目: https://disl-lab.github.io/SoCRATES/

Categories: 開源, 框架

DIRECT:可調 3D 角度的物件插令合成更自然

DIRECT 以 3D 代理配合分解式條件注入,讓物件插入既可控又自然。它同時兼顧姿態調整、外觀保留與場景融合。

DIRECT Logo

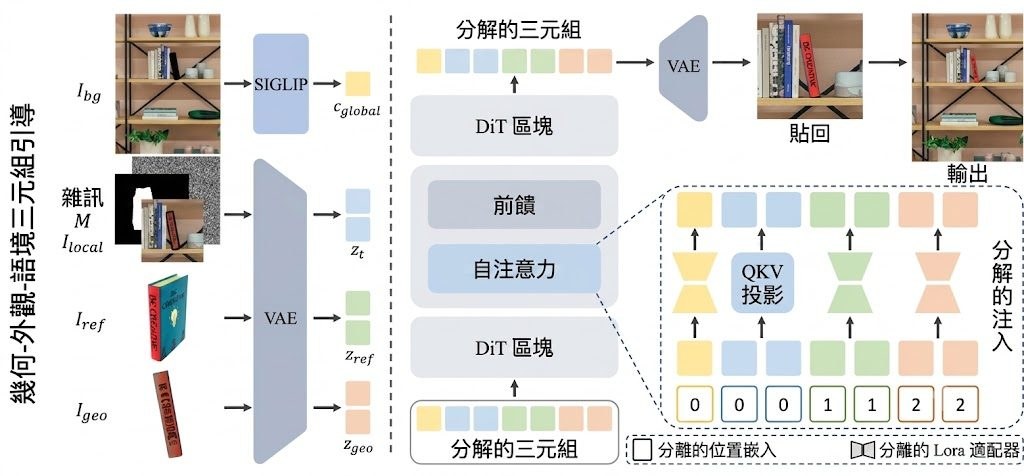
DIRECT(Decomposed Injection for Reference Composition and Target-integration)是一個用來把參考物件放入背景圖片的生成項目,重點不是單純補圖,而是加入明確的 3D 控制。網頁內容指出,現有 diffusion-based 方法多數把這類工作當成 2D inpainting,畫面雖然好看,但物件角度與空間位置較難精準控制。

DIRECT 先把參考物件提升成可互動的 3D proxy,讓使用者在目標場景內直接調整姿態,再把調整後的結果渲染成 geometry guidance。之後,生成器會同時接收參考物件的 appearance guidance、3D proxy 提供的 geometry guidance,以及背景圖片的 context guidance,合成最終插入效果。

它的核心創新在於 decomposed injection,把不同條件分開經由獨立路徑注入,而不是混在一起處理。這樣可減少 feature entanglement,較有機會同時保留原物件外觀、跟隨指定姿態,並令物件更自然融入目標場景。

重點可先留意以下幾點:
– 支援 pose-controllable object insertion,可直接調整物件姿態
– 以 reconstructed 3D proxy 提供明確幾何引導
– 把 appearance、geometry、context 三種訊息分開處理
– 附有 automated data construction pipeline,以提升訓練資料多樣性與質素
– 頁面表示在 geometric controllability 與 visual quality 上優於以往方法

這類項目特別適合影像合成、視覺生成、商品展示與內容製作等場景,當你需要指定物件朝向、位置感與場景一致性時會較有用。若你想跟進研究與重現結果,頁面已提供 Paper、Code,Model 與 Dataset 則標示為 soon。

GitHub: https://github.com/Gong1130/DIRECT

項目: https://gong1130.github.io/DIRECT/

Categories: 影像處理, 框架, 3D

Stream3D-VLM 把串流影片變成 3D

處理的不只是影片,而是邊看邊理解空間。Stream3D-VLM把串流畫面、幾何資訊與語言回應連起來。

Stream3D-VLM Logo

Stream3D-VLM 是一個 online 3D vision-language model,重點是直接從串流影片做即時空間理解,而不是等整段影片或整個場景收集完才分析。對想研究機械人、空間問答,或 3D 場景互動的人來說,這個項目處理的是「模型可否一邊看、一邊建立場景概念,再即時回答問題」這件事。

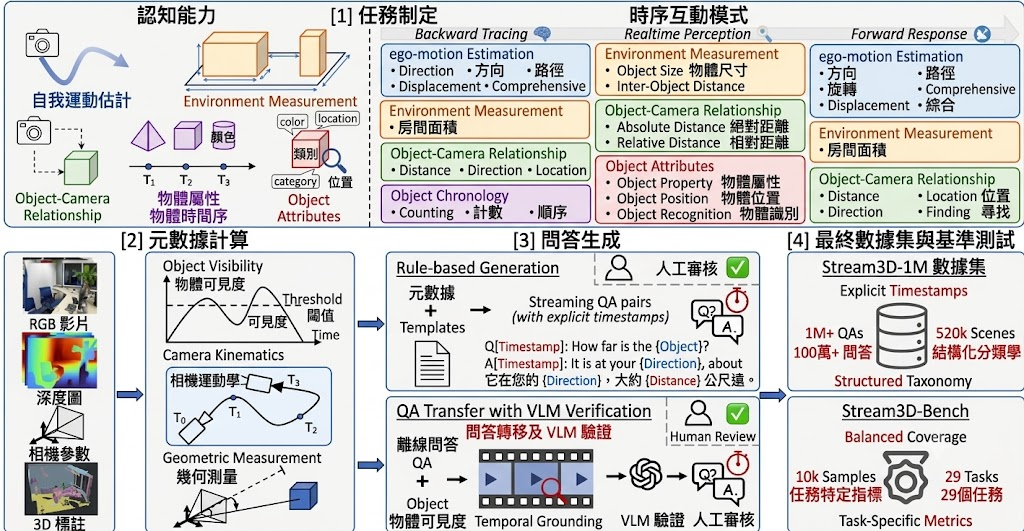
使用這個項目時,核心資源包括已公開的 Stream3D-VLM-4B 模型、Stream3D-1M Dataset,以及 Stream3D-Bench。資料方面未有直接釋出原始媒體,但有提供標註、GLB 與 RRD 等重建結果;GLB 可放入一般 3D viewer 逐步查看點雲,RRD 則可配合相機姿態與點雲記錄觀察完整重建流程。

Stream3D-VLM 加入 incremental geometry priors,令模型隨時間吸收對齊的 3D 幾何線索。項目亦提出 Visual-Spatial Feature Integration(VSFI)模組,以及 Geometry-Adaptive Voxel Compression(GAVC)模組,前者負責把幾何資訊逐步注入視覺串流,後者用 3D 結構去壓縮 visual tokens,減少長序列推理負擔。

團隊亦建立了可擴展的資料生成流程,整理超過 1M online spatio-temporal 3D QA pairs,並設計涵蓋 29 項任務的基準。項目聲稱在 online 與 offline 的 3D spatial understanding、reasoning、grounding 任務上,表現優於部分 proprietary 與 open-source models;不過文章未在這份資訊中列出完整數字,閱讀結果時仍要配合論文與實驗頁面一起看。

  • 解決痛點:傳統 3D Large Multimodal Models 多數依賴離線處理,這個項目改為面向 streaming video。
  • 主要方法:結合 autoregressive streaming control、VSFI 與 GAVC。
  • 資料與基準:提供 Stream3D-1M Dataset 標註及 Stream3D-Bench,涵蓋 29 項任務。
  • 可視化資源:支援 GLB 與 RRD,方便檢查增量重建與相機軌跡。
  • 相關模型:已公開 Stream3D-VLM-4B,可作為了解整體能力的主要入口。

整體來看,Stream3D-VLM 最適合用來觀察 3D 多模態模型如何由「看完整段再答」走向「邊看邊答」。它未必是一般開發者即裝即用的輕量工具,但對研究串流場景理解、3D 問答、空間推理流程的人,這個項目有相當清晰的方向與實驗野心。

GitHub: https://github.com/hanxunyu/Stream3D-VLM

項目: https://stream3d-vlm.github.io/

Categories: 香港科技大學, 騰訊, 模型, 視覺模型, 多模態模型, NVIDIA, Robotic

PhaseLock:用兩步鎖住影片物理感

這項目用免訓練方法,改善影片生成中的不合理動作,同時盡量保留高畫質。

yonsei emblem

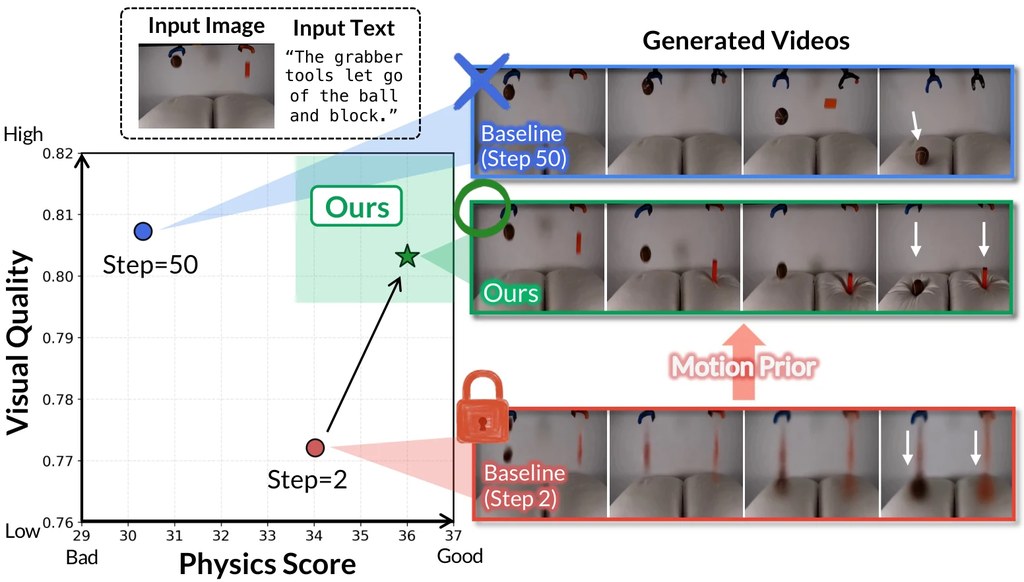
PhaseLock 是一個針對 Image-to-Video diffusion models 的方法,重點是修正影片生成中常見的物理錯誤。主要是針對 inference-time method / sampling strategy。模型在完整 50 步去噪時雖然畫面更細緻,但動作反而可能偏離物理規律;相對地,只做 2 步去噪時,動作先驗更可信,只是質感較粗糙。

項目的核心做法是兩階段流程,而且不需要額外訓練。它會先用 2 步去噪抽出 motion prior,文中以 Δ phys 表示,再在 50 步完整生成期間以 Latent Delta Guidance 重新注入,目標是在高保真畫面中保留較合理的動態結果。

例子很直觀,例如非磁性的網球不應被帶磁的籃子吸起。基線結果會產生違反常識的動作,PhaseLock 則較能維持物件應有的移動方式。這類情況很適合用於需要基本物理合理性的影片生成項目,例如物件互動、掉落、抓取或接觸場景。

重點可歸納為:
– 以 training-free 方式改善影片中的物理一致性
– 發現 2-step generation 的 physics 可能比 50-step output 更好
– 透過 Latent Delta Guidance 把早期 motion prior 鎖回最終結果
– 報告指出 physical consistency 平均提升 +6.2 points
– 額外成本相對有限,約 1.06× time、1.02× memory

如果你本身已在用影片擴散模型,這個項目的使用概念不算複雜:先跑短步數結果取出動作訊號,再配合完整步數生成。從現有內容看,PhaseLock 的價值不在於更換主模型,而是在同一模型之上補回被後期去噪「磨走」的動作先驗。文中提到測試用的模型包括 Wan 2.1。

GitHub: https://github.com/dnwjddl/phaselock

項目: https://dnwjddl.github.io/phaselock/

Categories: 開源, NVIDIA, Robotic, 框架

OmniDreams:NVidia 點樣重塑自駕模擬

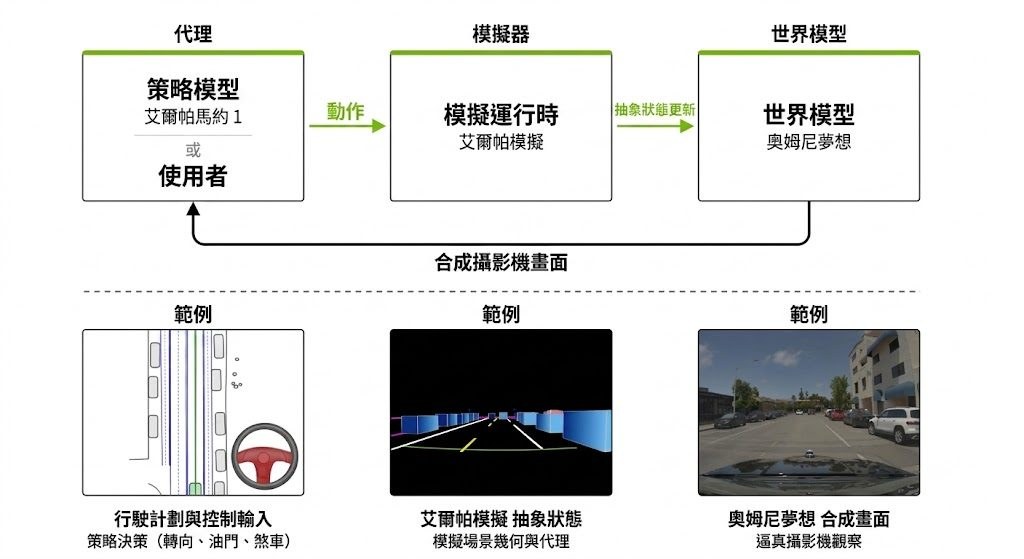
OmniDreams把單張畫面、文字提示與地圖軌跡結合,實時生成多鏡頭擬真影片。這類 world model,正改變自動駕駛模擬的可擴展性。

Repository image for nv-tlabs/omni-dreams

NVIDIA OmniDreams 是一個用於自動駕駛模擬的 world model,重點不在重播已錄好的路面片段,而是在系統提供條件後,持續生成多鏡頭、近乎寫實的影片畫面。它吃進一張真實 RGB 起始影像、文字提示,以及每幀的 coarse HD map image 和 trajectory poses,再以分段方式推進後續畫面。

這個項目想處理的核心問題,是傳統神經模擬器雖然可以很像真,但通常受限於原本拍到的資料,遇到少見天氣、突發交通行為或未見過的場景時,彈性不足。OmniDreams 走的是自回歸生成路線,會根據過往畫面、模擬器狀態與即時駕駛動作,繼續生成下一段感測畫面,較接近 closed-loop simulation 的需要。

從公開資料看,它的創新點在於把 Cosmos diffusion model 的視覺先驗,延伸成可即時反應動作的生成式 world model,並且支援 multi-camera photorealistic video。論文亦提到它曾在 21k 小時駕駛場景上做 mid-training 與 post-training,目標是覆蓋更多傳統模擬器難以刻畫的情境。

使用這個項目時,較適合把它視為研究與後訓練樣本發佈點;互動式推論與 live driving demo 則放在配套項目 FlashDreams。倉庫亦提供 post-training 樣本,圍繞 Cosmos2 SV-HDMap world model 微調,並提到 student-init、bidirectional teacher 與 self-forcing distillation 等訓練路線,但硬件門檻不低,官方列明最低為單個 8-GPU Ampere/Hopper 節點。

  • 可從單張真實畫面開始,生成連續多鏡頭影片
  • 輸入條件清晰,包括文字提示、HD map 與 trajectory poses
  • 重點場景是 closed-loop autonomous vehicle simulation
  • 相關模型與系統包括 Cosmos diffusion model、Cosmos2 SV-HDMap、FlashDreams、Alpamayo 1、AlpaSim、WAM
  • 論文初步結果指出,從 OmniDreams 後訓練出的 WAM 在 Physical AI Autonomous Vehicles NuRec 上表現不俗,且總參數量少於 VLA-based Alpamayo 1.5 的五分之一

整體來看,OmniDreams 不是一般開箱即用的消費級工具,而是面向自動駕駛研究、模擬平台與生成式 world model 開發流程的關鍵項目。對研究團隊、模擬系統工程師,或者想追蹤 NVIDIA 在 Physical AI 與 AV simulation 方向的人來說,這個項目很有參考價值。

GitHub: https://github.com/nv-tlabs/omni-dreams

項目: https://research.nvidia.com/labs/sil/projects/omnidreams-blog/

Categories: 開源, 世界模型, NVIDIA

StreamChar:長時間角色聲畫生成新路線

StreamChar 主打長時間串流角色聲畫生成。重點在於把語言調度、記憶機制與音視訊生成流程分開處理。

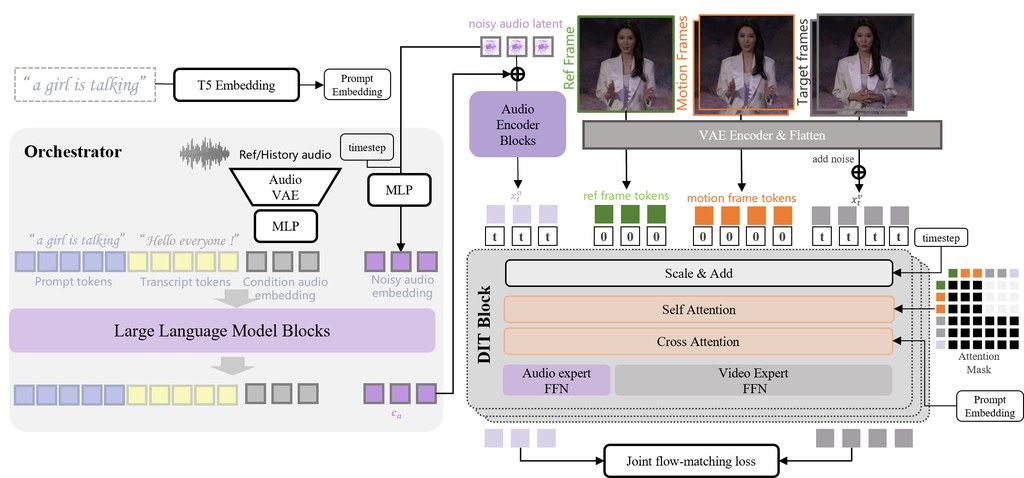
StreamChar architecture overview

StreamChar 是一個研究展示項目,聚焦 Long-Horizon Streaming Character Audio-Video Generation,也就是長時間、串流式的角色音訊與影片生成。從頁面可見,它的核心組合包括 Decoupled LLM orchestration、joint audio–video DiT denoising backbone、Sink-Chunk Memory,以及 Online Rollout Distillation。

這個項目要處理的重點,是角色聲畫內容在較長輸出過程中的連續性與穩定度。一般生成流程一旦拉長,容易出現內容斷裂、角色狀態不一致,或音訊與畫面節奏不同步;StreamChar 看來就是針對這類長序列生成問題而設計。

使用這個項目時,現階段較像觀看研究成果與示範,而不是直接提供完整產品化操作流程。頁面提供 Paper (arXiv) 與示範影片,適合先從 demo 觀察輸出效果,再配合論文理解整體方法與系統拆分方式。

它的技術方向幾個重點相當清楚:把 LLM 的 orchestration 與底層聲畫生成解耦、以 Streaming DiT Backbone 負責連續生成,並加入 Sink-Chunk Memory 支援長時間上下文。Online Rollout Distillation 則顯示團隊有針對串流生成過程做效率或穩定性上的訓練安排,但頁面摘要未提供更完整數字。

  • 聚焦 Long-Horizon Streaming Character Audio-Video Generation
  • 結合 Decoupled LLM orchestration 與 joint audio–video DiT denoising
  • 以 Sink-Chunk Memory 處理長序列上下文
  • 提供研究示範影片,輸出為 native resolution
  • 適合關注角色生成、串流生成與多模態研究的人

如果你是做生成式 AI、虛擬角色、數碼人或影片合成相關項目,這個項目有參考價值。至於性能和評估,頁面目前只見方法名稱、論文入口與 demo,未見明確基準分數;較穩妥的做法,是把它視為一條值得追蹤的研究路線,再到論文中查看完整實驗細節。

項目: https://humanaigc.github.io/StreamChar_page/

Categories: 阿里巴巴, 視頻模型, 影像處理

Magenta RealTime 2:即時生成音樂的開放模型

DeepMind 為 Apple 帶來即時音樂生成的桌面創作流程。由模型、推論庫到 DAW 插件示例都已準備好。

Repository image for magenta/magenta-realtime

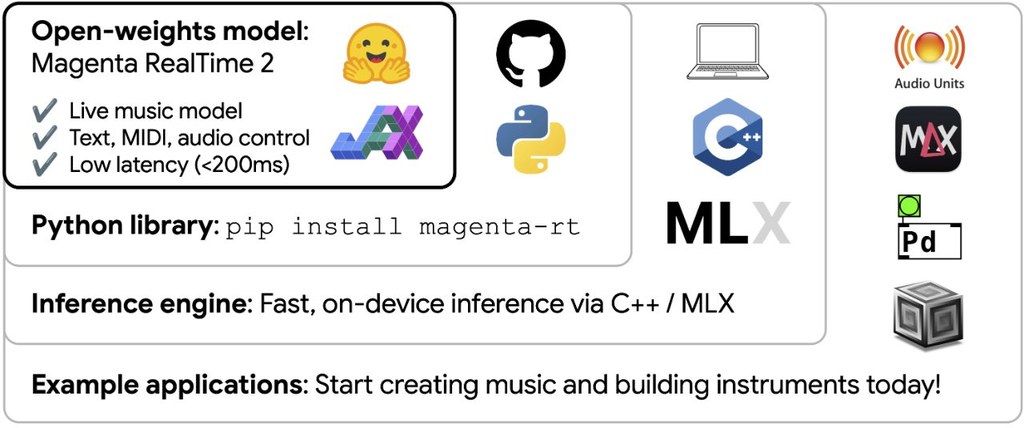
Magenta RealTime 2(MRT2)是個即時音樂生成的 open-weights model,重點不只是一個模型,還連同 Python 推論庫 magenta-rt、C++ 推論引擎 magentart::core,以及可直接延伸成應用程式的示例一併提供。對想將生成式音樂放入創作工具、互動程式或聲音實驗的人來說,這個項目比單純放出模型更完整。

不少音樂生成模型可以離線產出內容,但要做到邊播邊生成、能配合演奏或介面互動,系統延遲、串流效率與硬件限制都會變成關鍵。MRT2 直接針對 real-time streaming 設計,並且把 Apple Silicon MacBook 的串流音訊生成列為核心場景,令開發者較容易把模型接入 DAW、獨立 app 或其他音樂工具。

Magenta RealTime 2 可按需要選擇 Python 或 C++ 路線:想試模型行為,可用 magenta-rt 配合 JAX 或 MLX;想做較高效率的音訊串流,則可留意 magentart::core;要接近成品流程,儲存庫內亦有 AUv3 plugin、standalone macOS app、note control 與 prompt space 探索工具。這種由底層推論到示例應用都齊備的安排,對建立原型特別有幫助。

  • 提供兩個模型:mrt2_small(230M)與 mrt2_base(2.4B)
  • mrt2_small 可在多款 Apple Silicon Mac 即時運行,Air 系列亦可支援
  • mrt2_base 音質定位較高,但即時串流需 Pro Max 級別晶片
  • Python 路線支援 JAX、MLX,亦提到可在 NVIDIA GPU 做 offline inference
  • 內附 AUv3、standalone app 與互動示例,方便延伸成創作工具

性能資訊在這個項目中算是寫得具體:即時串流明確依賴 Apple Silicon(M 系列),而且不同晶片對 mrt2_base 的支援有清楚區分。從已公開資料看,mrt2_small 較適合大部分開發與測試場景,mrt2_base 則偏向追求更高品質、且手上有較高階 Mac 的用家。若你正在做音樂科技項目、DAW 擴充、互動聲音裝置,或者想研究生成模型如何接入即時工作流,這個項目相當值得留意。

GitHub: https://github.com/magenta/magenta-realtime

Categories: 開源, Google, 音樂, 蘋果

Stable-Layers:靠 VLM 評分強化學習,毋須配對數據也能改良圖層分離

Stability AI 提出 Stable-Layers 框架,利用 VLM 評分與 Flow-GRPO 微調圖層分解模型,解決配對數據不足的限制。

Hero image preview

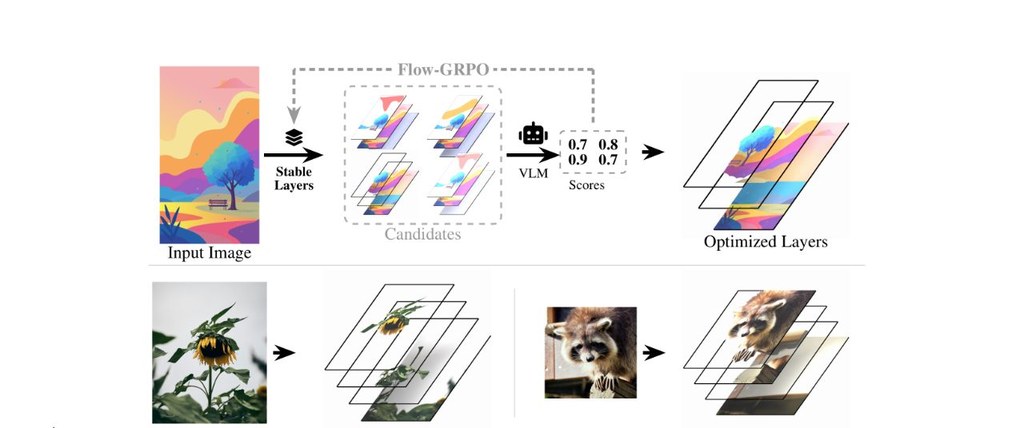
圖像圖層分解(image layer decomposition)是指把一張圖分成幾層可獨立編輯的 RGBA 影像,再合併回原本的畫面。這個技術是專業修圖與合成工作流的基本工序,但要訓練模型做這件事並不容易:同一張圖往往存在多種合理分層方式,而且品質好壞取決於下游是否好用,例如語意分層是否清晰、alpha 遮罩是否乾淨、是否有冗餘層,以及被遮擋的部分能否被合理填回。

傳統做法會用合成的配對數據集(即同一張圖同時提供「原圖」與「正確分層」)來監督模型學習,但這會帶來先天限制:當多種分層都同樣合理時,強迫模型擬合單一標準答案,等於懲罰了其他可行的解法。Stable-Layers 嘗試繞過這個限制,改用強化學習(reinforcement learning)讓模型直接朝「看起來品質好」的方向優化,監督訊號只來自一個視覺語言模型(vision-language model,VLM)。

具體而言,項目以 Qwen-Image-Layered 為起點,結合 Flow-GRPO 與 LoRA(Low-Rank Adaptation,低秩適應)微調,針對每張圖採樣多個候選分層,再用 VLM 評分,從群組相對優勢(group-relative advantages)來更新策略。當中最大的挑戰是設計可靠的獎勵訊號:VLM 單獨評分時容易把所有樣本擠進一個狹窄的分數區間,導致 GRPO 缺乏組內變化可以學習。為此,Stable-Layers 採用兩階段評估流程——先按五個編輯向標準逐項評分,再把所有候選並排放在標記好的比較網格上重新評分一次,藉此取得更細緻的相對校準。

Stable-Layers 重點摘要:

  • 毋須配對數據:在完全沒有標註的圖像上訓練,解決合成數據集帶來的偏誤問題
  • VLM 擔任評審:利用視覺語言模型就五個編輯標準打分,提供獎勵訊號
  • 兩階段評估:先獨立評分,再以比較網格重新校準,避免分數過度集中
  • 強化學習微調:結合 Flow-GRPO 與 LoRA,從 Qwen-Image-Layered 開始改良
  • 實測表現:在 Crello 數據集上,圖層分離度更高、空白或帶瑕疵的層更少、每層重建誤差也較低

適用場景與對象:這個項目適合做圖像編輯、合成或設計工具的研究者與工程師,尤其是手上沒有大量配對分層數據、又想提升分層品質的團隊。對強化學習應用於視覺生成感興趣的人,也能從它處理「組內變化不足」的設計中得到啟發。

效能與評估:團隊在 Crello 數據集上測試,結果顯示 Stable-Layers 相比基礎模型,圖層分離更明確、出現空白或帶雜訊的層更少,而且每層的重建誤差也更低。論文獲 NeurIPS 2026 接收(arXiv:2605.30257v1)。

引用的模型:Qwen-Image-Layered(基礎分層模型)、Flow-GRPO(強化學習算法)、LoRA(高效微調方法)、視覺語言模型評審。

項目: https://stability-ai.github.io/stable-layers.github.io/

Categories: 開源, 模型, 影像模型, 影像處理, 深度學習

Boson AI 開源 4B 參數語音模型 Higgs Audio v3 速覽

Boson AI 開源 4B 規模文字轉語音模型 Higgs Audio v3,支援自訂聲線與對話生成,適合多語言語音應用開發。

Og image

bosonai/higgs-audio-v3-tts-4b 是由 Boson AI 在 Hugging Face 上開源的一款文字轉語音(Text-to-Speech, TTS)模型,整個模型約有 40 億(4B)個參數。這個項目主打多語言語音合成,並可根據少量參考音訊複製說話者的聲線,亦支援多輪對話式的語音生成,常用於 AI 配音、對話機械人、有聲內容製作等場景。

模型以 transformers 框架發佈,頁面具備 chat_template_jinja 範本,方便整合到現有的對話系統中。開發者可以直接透過 Hugging Face Transformers 載入 tokenizer 和模型,並依官方範例程式碼生成 wav 音檔,整體流程對熟悉 Python 的使用者而言並不複雜。

Higgs TTS 3: Beyond Reading, Toward Real Speech

這個項目主要處理傳統 TTS 難以兼顧「自然對話感」與「聲線多樣性」的痛點。模型能根據文字內容自動調整語氣、停頓與情緒,讓合成結果更貼近真人發聲。

重點摘要:

  • 規模與定位:約 40 億參數的開源 TTS 模型,定位為輕量而功能完整的語音方案。
  • 核心功能:支援文字轉語音、聲線複製(voice cloning)以及多輪對話語音生成。
  • 多語言支援:可處理多種語言的合成任務,適合跨語言應用。
  • 使用門檻:需要 Python 環境與 Hugging Face Transformers 基礎知識,建議配備 GPU 以獲得順暢體驗。
  • 整合彈性:內建 chat template,方便接駁到聊天機械人或多輪對話流程。

這個項目較適合從事 AI 語音應用、虛擬助手、有聲書或遊戲配音的開發者與研究人員。如追求極低部署成本,亦可考慮使用雲端 GPU 或 Hugging Face Inference Endpoints 來運行。

項目: https://huggingface.co/bosonai/higgs-audio-v3-tts-4b

Categories: 開源, 數字人, 語音

Page 95 of 184
1 … 93 94 95 96 97 … 184