SkillHarness:幫 CUA 學得更安全

一篇聚焦 Computer-Use Agents 安全技能學習的研究原型。它針對動態介面與 prompt injections,重做技能學習與重用方式。

Repository image for YurunChen/SkillHarness

這是一個研究原型,現時 GitHub 儲存庫主要提供 SkillHarness 論文 PDF。它要解決的是 Computer-Use Agents(CUAs)在動態電腦介面中學習與重用技能時,容易受 prompt injections、彈窗與環境變化影響,令已學到的技能變得危險或不穩定。

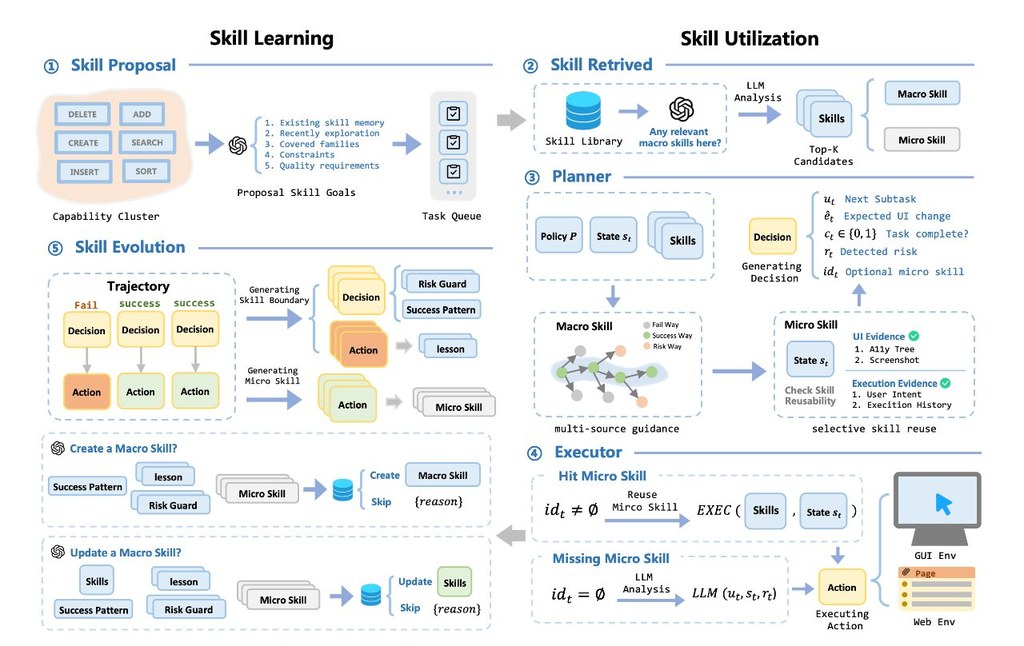
現有做法多數沿用「從成功軌跡抽取可重用技能」這個範式,常見表達形式包括函式或 API,但作者認為這類方法預設環境是 static and safe。SkillHarness 改用 safety-constrained interaction process 去看待技能的學習與使用,核心不是多學幾個技能,而是先判斷哪些技能在當下情境仍然安全。

論文提出兩個辨識度很高的設計:一是 skill boundary,用 multi-source supervision signals 從互動軌跡中找出 safe skills;二是 selective skill reuse,按當前情境拆解任務,只啟動部分技能,而不是整包照搬。這種取向的代價,是系統設計會比單純收集成功軌跡更複雜,但換來的是在動態環境下更穩定的行為。

現有儲存庫未附程式碼,所以暫時不能直接部署或重跑實驗;較合理的理解方式,是先把它當成一套 CUA 安全技能框架來讀。若之後作者釋出實作,最需要觀察的會是它怎樣接入代理的軌跡資料、怎樣建立 safety constraints,以及能否在 OSWorld 一類電腦操作基準以外維持效果。

  • 類型屬於框架/研究論文項目,重點在安全技能學習,不是即裝即用工具
  • 主要批評舊方法依賴 static and safe environment 假設,放到動態場景會學到不安全技能
  • 論文聲稱 learned skills 的 unsafe rate 降低 57.1%,並提升動態環境下的 execution stability
  • 較適合研究 Computer-Use Agents、代理安全、桌面自動化與長流程任務的團隊留意
  • 相關脈絡模型與方法包括 Computer-Use Agents(CUAs)、Voyager、ASI,以及以函式/API 形式封裝技能的路線
GitHub: https://github.com/YurunChen/SkillHarness

Paper: https://arxiv.org/pdf/2606.20636

Categories: 開源, Agentic, 模型, API, 框架, 工具, 庫, 安全, Skill 技能

BioMatrix 把生物序列與 3D 結構放進同一模型

BioMatrix 嘗試用同一個模型同時理解分子、蛋白質、3D結構與文字。它的重點不只是多模態,而是連生成方式都統一起來。

BioMatrix

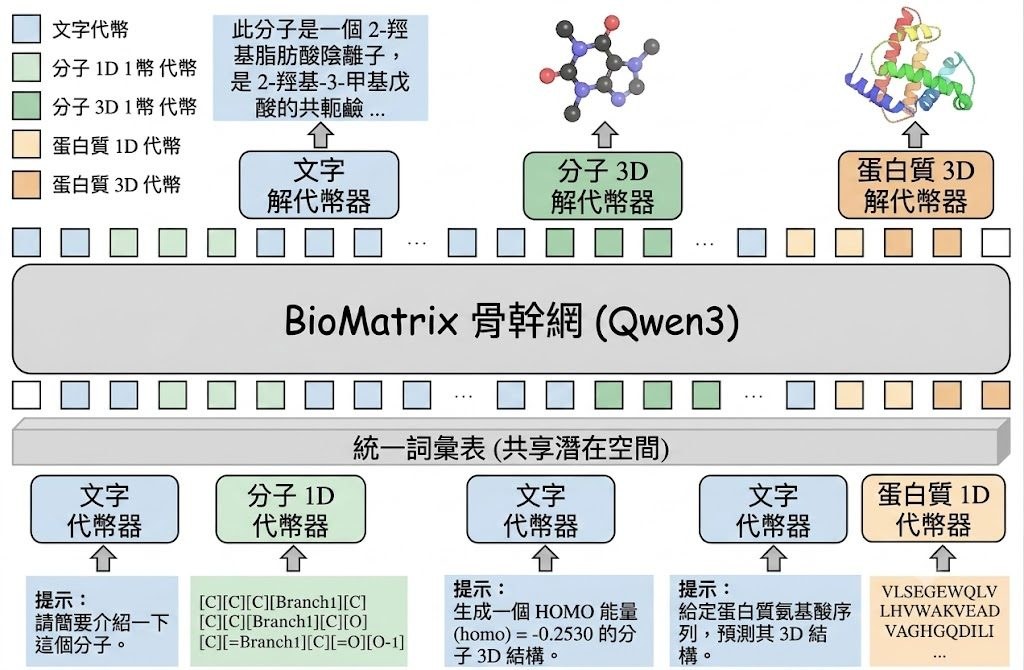
BioMatrix 是一個多模態 foundation model,建立在單一 decoder-only 架構之上。它要解決的問題,是把 molecules、proteins、1D sequences、3D structures 與自然語言放進同一套生成流程,令模型不只可讀取不同資料,也可用同一個 next-token prediction 目標處理與輸出它們。

現有 biological foundation models 通常分成兩類:一類可在共享目標下融合多模態,但多數只集中單一 entity type;另一類雖然覆蓋 molecules 與 proteins,卻常常欠缺顯式 structural modeling,或者依賴 adapter-based designs、external encoders、projection adapters 與 modality-specific output heads。BioMatrix 的取向很鮮明:直接把 SMILES、SELFIES、分子 3D、蛋白質序列、蛋白質 3D 同自然語言映射到 shared discrete token space,將「可讀」與「可生成」統一。

技術上,這個項目最值得留意的是 unified tokenization scheme。分子 3D 用改良版 MolStructTok,蛋白質 3D 用 GCP-VQVAE,並以 description-based embedding initialization 把新增 token 先對齊到 pretrained Qwen3 embedding space,再做 continual pretraining;這種做法比起後加模態接頭更完整,但訓練成本亦明顯更高,官方資料提到曾用 64 張 NVIDIA H100 GPUs 配合 LLaMA-Factory 訓練。

從 GitHub 與 Hugging Face 現有資訊看,這個項目較適合當作模型下載與研究評測基線使用,目前可找到 BioMatrix-1.7B-Base、BioMatrix-4B-Base、1.7B-SFT、4B-SFT 等版本。若你想測試,較合理的理解方式是先用已發佈模型做推理或任務比較,再按需要研究其 tokenizer,例如 MolStructTok 與 GCP-VQVAE;完整重訓對一般團隊門檻很高。

  • 模型定位:多模態 biological foundation model,不是單一分子模型或單一蛋白質模型
  • 核心差異:把 sequences、structures、language 放入同一 shared discrete vocabulary,而非靠外掛式模態模組拼接
  • 相關模型:Qwen3 1.7B、Qwen3 4B、BioMatrix-1.7B-Base、BioMatrix-4B-Base、BioMatrix-1.7B-SFT、BioMatrix-4B-SFT
  • 數據與訓練:涵蓋 text、PubChem、MolTextNet、UniRef50、RCSB PDB、UniProt/Swiss-Prot、AFDB 及 cross-entity interleaved data
  • 表現指標:論文稱 instruction tuning 後涵蓋 80 個 tasks、6 個類別,當中 77 個 tasks 達到 state-of-the-art 或具競爭力

這個項目最受惠的會是做 drug discovery、protein engineering、生物資訊研究,或者想把文字問答、分子表示與結構生成放進同一工作流的團隊。它的野心很大,優勢是統一表示與任務泛化,限制則是部署與訓練門檻高,而且論文聲稱的廣泛表現仍要看你手上的任務是否屬於那 80 個測試範圍。

GitHub: https://github.com/QizhiPei/BioMatrix

項目主頁: https://huggingface.co/collections/QizhiPei/biomatrix

Paper: https://arxiv.org/pdf/2606.22138

Categories: 開源, 上海人工智慧實驗室, Embedding, 模型, 多模態模型, 模型訓練, Qwen, Medical醫學, 3D, 中國

DataClaw0 想把雜亂多模態資料變成可訓練資產

DataClaw0 不是普通標註工具,而是把原始多模態資料主動整理成可用訓練資料的研究原型。它瞄準的是資料太亂、太長、太難重用的老問題。

DataClaw

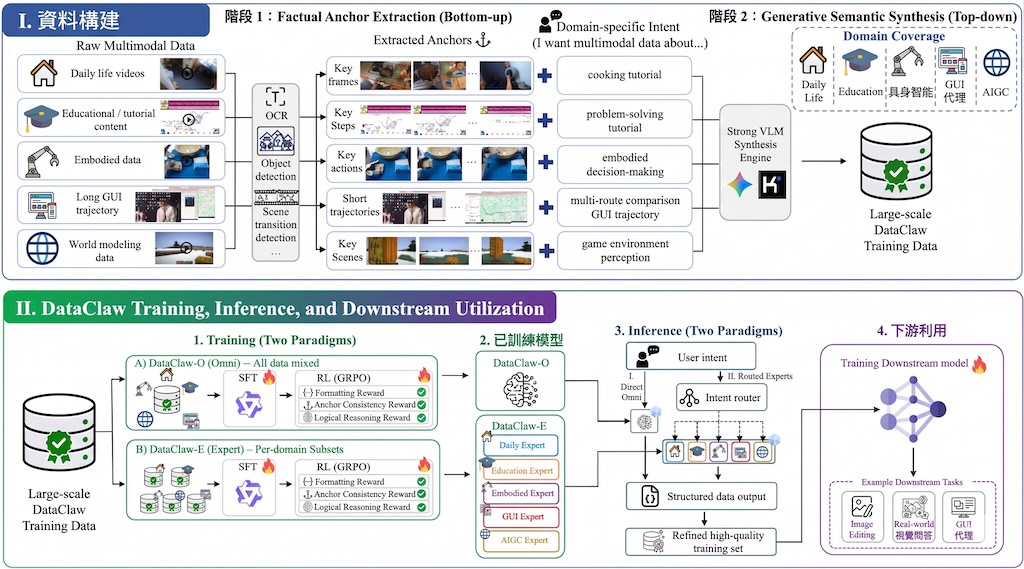
這是一個面向多模態資料整理的研究原型兼框架,核心是用 Agentic Data Tailoring 把原始串流資料重組成有結構、可驗證、可直接用於訓練的 supervision。它要解決的不是「再做一次標註」,而是長影片、GUI traces、embodied trajectories 與 editing sequences 太雜亂、資訊密度不均,令人和模型都難以有效吸收。

現有做法多數依賴 passive annotation paradigms,用 heuristic rules 或 general VLMs 被動加標籤;作者認為這類方式成本高、內容單調,亦抓不到原始資料入面的 procedural logic。DataClaw0 改用「Bottom-up Factual Anchors → Top-down Semantic Synthesis」兩段式流程,先抽取較確定的 factual anchors,再按意圖生成結構化語意,重點在於它不是只描述內容,而是按 downstream objective 重寫資料。

模型層面,項目提出 DataClaw-9B,並以 Supervised Fine-Tuning(SFT)加 rule-driven Group Relative Policy Optimization(GRPO)做對齊;部署上分成 unified Omni model 的 DataClaw-O,以及分領域 Experts 的 DataClaw-E。這種取向的取捨很明顯:Omni 較方便統一處理多域資料,Experts 則較可能在特定場景保留更細緻的領域表達。

現階段先看論文與案例再判斷是否值得追蹤,因為 code、model weights、dataset 和 DataClaw-val benchmark 仍未正式釋出。已公開資訊顯示,它的評測不只看生成是否通順,還會檢查 JSON validity,以及 schema-aware 的 Field、Semantic、Sequence 指標,並再用 video generation、real-world VQA、GUI navigation 的下游 post-training 效果驗證資料整理是否真的有用。

  • 項目類型:研究原型/資料整理框架,重點是把原始多模態串流轉成意圖對齊的訓練資料
  • 主要差異:不是被動標註,而是主動 refinement,並保留 schema-conformant、verifiable 輸出
  • 相關模型:DataClaw-9B、DataClaw-O、DataClaw-E,訓練結合 SFT 與 rule-driven GRPO
  • 適合情境:做多模態 post-training、GUI agents、VQA、影片或 embodied 資料整理的團隊

如果你關心的是建立資料引擎,而不只是找一個模型做推理,DataClaw0 比一般 VLM 標註流程更有方向性。限制也很直接:目前公開內容以論文與項目頁案例為主,能否重現效果、部署成本多高、不同領域泛化有多穩,仍要等正式釋出的資料與基準再作判斷。

GitHub: https://github.com/vancyland/DataClaw0

項目主頁: https://czjdsg.github.io/MakeAnyData/#cases

Paper: https://arxiv.org/pdf/2606.21337

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Qwen, Gemini, Video, 影像模型, 影像處理, 框架, 工具, IDE, Dataset 數據集

Unlimited-OCR:長文件 OCR 新取向

這是一個主打長篇文件解析的 OCR 模型項目。它針對多頁、長輸出內容時速度與記憶體壓力變大的問題作出調整。

Baidu Inc.

Unlimited-OCR 是一個 OCR 視覺文字辨識模型項目,也可視為一個針對長文件解析而改造的研究原型。它主要用來把圖片或 PDF 內的大量文字與版面內容一次過轉成可輸出的解析結果,重點是處理多頁文件時盡量減少記憶體負擔。

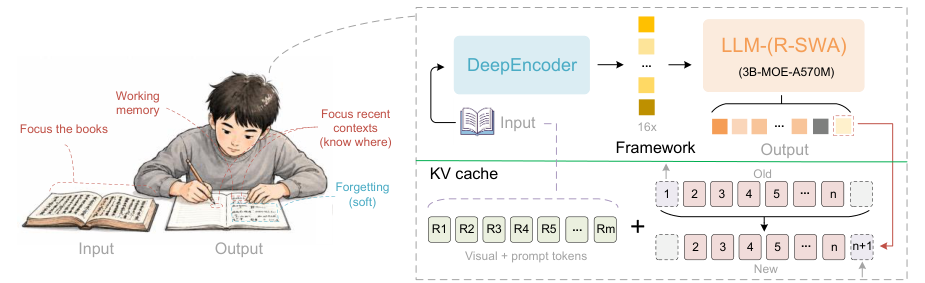
現有 end-to-end OCR 做法以 DeepSeek-OCR 為代表,會用 large language model(LLM)作 decoder,優點是能借助語言先驗提升辨識效果,但輸出一長,KV cache 會一路累積,令顯存需求上升、生成愈來愈慢。Unlimited-OCR 的做法是保留高壓縮 encoder,再把 decoder 的 attention 層改成 Reference Sliding Window Attention(R-SWA),讓每個 token 持續關注 reference tokens 與有限長度的前文,目標是把 KV cache 維持在常數規模。

這個取向最值得留意的地方,不是單純追求單頁最高精度,而是把「one-shot long-horizon parsing」放在核心位置。跟一般 full attention 比,它犧牲的是傳統全域注意力形式,換來多頁文件在 32K 長度下仍可做單次 forward pass;跟 vanilla SWA 比,它又保留 visual tokens 作為穩定參照,避免狀態傳遞後愈來愈模糊。

部署路線相當明確:項目提供 Hugging Face Transformers 推理方式,測試環境寫明需 NVIDIA GPU,並以 Python 3.12.3、CUDA 12.9 為基礎;單張圖片可在 gundam 與 base 兩種設定中選擇,多頁與 PDF 則使用 base 配置。想先了解效果,也可直接看 Hugging Face Spaces demo 或 ModelScope 版本,再決定是否自行落地。

  • 類型定位:OCR 模型/研究原型,解決長文件、多頁解析時記憶體與速度惡化問題
  • 核心差異:以 Reference Sliding Window Attention(R-SWA)取代 decoder 全部 attention layers
  • 適合情境:長 PDF、批量文件數碼化、需要版面解析與長輸出的團隊
  • 相關模型:DeepSeek-OCR、Unlimited-OCR;文中亦提到 R-SWA 可延伸到 ASR、translation
  • 限制判斷:目前公開資訊主力放在推理與方法設計,具體評測數字仍要回看 arXiv 論文原文才適合作更細比較

對需要處理保單、報表、掃描檔、書籍或多頁行政文件的團隊,這個項目的吸引力會比一般單頁 OCR 更高。若你的工作重點是短文字截圖、手機快拍辨識,Unlimited-OCR 的優勢未必完全發揮,但對長輸出穩定性與部署在 GPU 環境的可行性,它展示了一條很清楚的改良路線。

GitHub: https://github.com/baidu/Unlimited-OCR

Paper: https://arxiv.org/pdf/2606.23050

Categories: 開源, 模型, 視覺模型, NVIDIA, DeepSeek, Image, Python NLP, Python, Meta, 百度

UniverSat:一個模型食晒多種衛星影像

UniverSat 想解決地球觀測資料格式五花八門的老問題。它用單一權重處理多種感測器,方向相當進取。

UniverSat — one model, many sensors

UniverSat 是一個面向 Earth Observation 的 ViT-style backbone 研究原型。它的主要用途,是用單一模型處理不同感測器、不同解析度、不同光譜通道與不同時間長度的遙測影像,減少每種資料都要分開建模的麻煩。

現有做法多數沿用 ViTs 的 fixed input format,先把資料重採樣、挑選通道,或者替每個 sensor 準備獨立 encoder;作者認為這種範式會犧牲原始資訊,也令跨資料來源整合變得繁複。UniverSat 改用 Universal Patch Encoder (UPE),把任意 spatial、spectral、temporal 形狀的 patch 映射到共享 embedding space,核心取向是 一組權重處理多種輸入。

這個項目現階段更像可直接試驗的研究模型,而不是包辦整條流程的完整產品。公開資訊顯示可經 torch.hub 載入 pretrained weights,也有 demo notebook;理解方式不難,把它視為可插入 EO pipeline 的 backbone,輸入可用你手上的 sensors 組成 dict,再讀出 dense embeddings 供下游分類、分割或檢索任務使用。

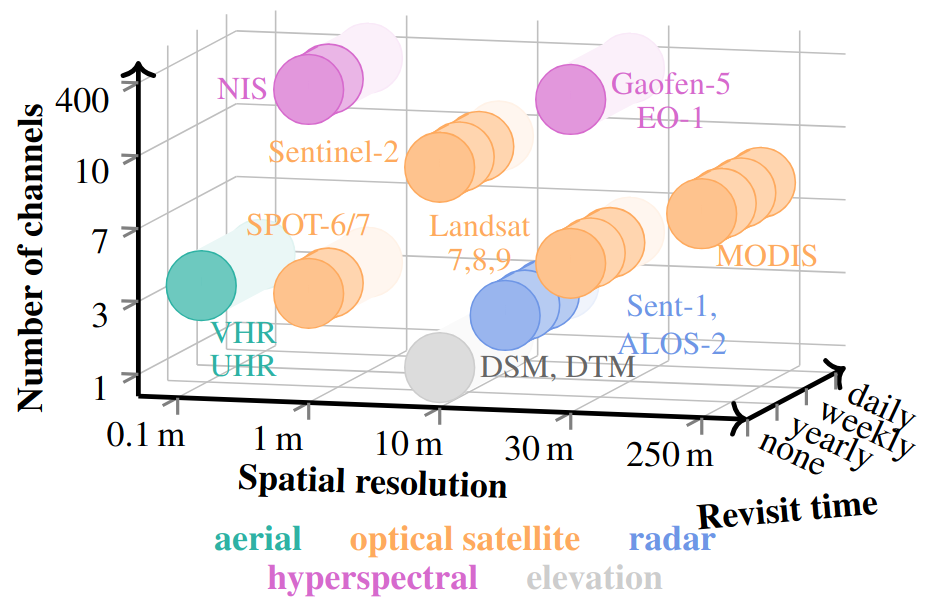
它最值得留意的差異,在於不依賴 input resampling、channel selection、per-sensor encoder,並聲稱對未見過的 sensors 也能泛化。代價是這類通用 backbone 通常更依賴訓練資料覆蓋範圍;目前已知訓練橫跨 7 個 datasets、13 個 sensors,涵蓋 optical、radar、hyperspectral、elevation,空間解析度由厘米級到數百米,光譜由 1 band 到 396 channels,時間上亦可由單次觀測到 150+ revisits。

  • 項目類型:地球觀測用的模型 backbone/研究原型,不是單純資料集或標註工具
  • 解決問題:把多來源遙測資料放進同一模型,減少逐一調校感測器流程
  • 部署理解:可用 pretrained weights 作推論與特徵抽取,較適合接到既有 PyTorch 流程
  • 受益情境:研究團隊、遙測分析、跨感測器項目,尤其適合資料格式混雜的工作
  • 相關模型與技術詞:Vision Transformers (ViTs)、Universal Patch Encoder (UPE)、PyTorch、Lightning、Hydra

以研究角度看,UniverSat 的價值不只在「多模態」,而是重新挑戰 Earth Observation 一直遷就模型輸入格式的習慣。若你正面對多個衛星或航測來源,又不想為每種資料各自維護一套 encoder,這個項目很值得跟進;不過基準細節與不同任務上的強弱,仍要回到論文與 benchmark 結果再細看。

GitHub: https://github.com/gastruc/UniverSat

項目主頁: https://gastruc.github.io/universat

項目: https://huggingface.co/g-astruc/UniverSat

Categories: 開源, Embedding, 模型, 視覺模型, 工具, Python, Dataset 數據集

SproutRAG:長文 RAG 檢索的新取向

SproutRAG 不是只做向量檢索,而是把長文件整理成多層次證據樹。它想解決 RAG 在片段太碎或太大之間的老問題。

SproutRAG

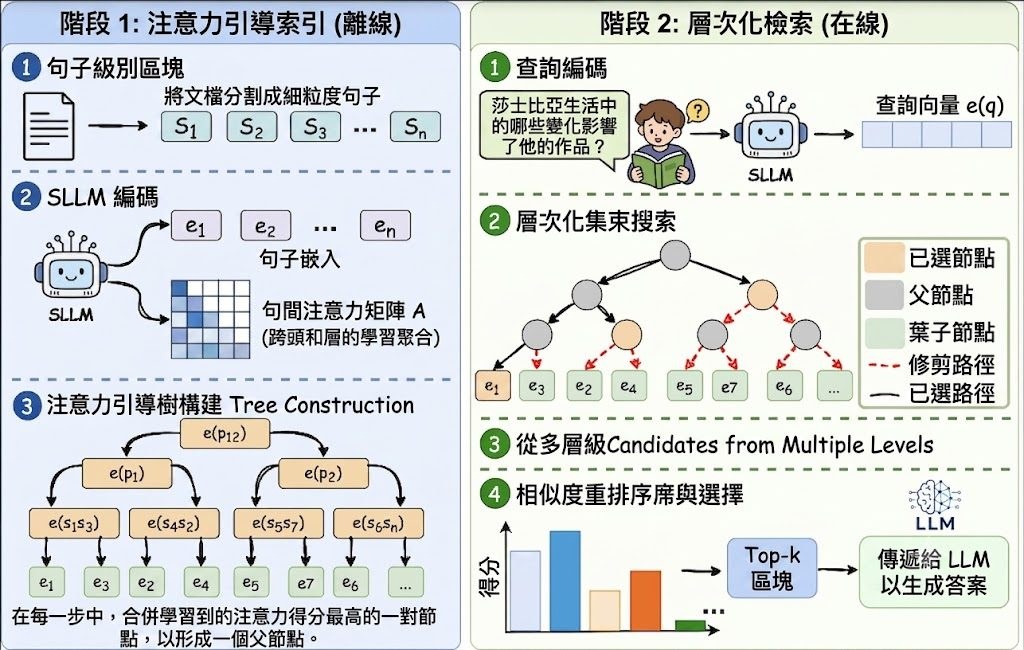
現時不少 RAG(Retrieval-Augmented Generation)做法,通常在「細粒度 chunk 準確但零碎」與「大段內容連貫但嘈雜」之間取捨;有些方法靠 LLM-guided chunking、single-level context expansion,或 hierarchical summarization 去補救,但代價是要額外 LLM 呼叫、只支援單一層級擴展,或者在摘要過程流失資訊。SproutRAG 提出的方向,是用 attention-guided hierarchical RAG framework,把句子逐步組成語意連貫的多層結構,再做 multi-granularity retrieval。

這是一個 RAG 工具/框架,重點不是單獨一個模型,而是把索引、檢索、reranking、答案生成與評測串成完整流程,處理長文件問答中「證據要夠準又要保留上下文」的問題。它用 YAML 或 JSON config 驅動 CLI,每一步各有設定,輸出統一是 JSON,對接下游工具和保留可重現紀錄都幾方便。

部署和測試思路算清楚:先準備 JSONL 文件,之後分開建立 index、執行 retrieve、再 answer;若要研究效果,還可 train 和 evaluate。附加套件分別對應 PyYAML、ROUGE-L、METEOR、BERTScore 及 spaCy,反映這個項目除了生成,也很著重檢索與答案品質的量化比較。

和常見 flat retrieval 相比,SproutRAG 較值得留意的是 hierarchical attention-based indexing 加上 hierarchical beam search:它不是只撈單一粒度片段,而是沿樹狀結構找不同大小的候選證據。論文資料指出,它在四個 benchmark 的 information efficiency(IE)平均比最強 baseline 高 6.1%,但目前公開說明未見太多資源消耗與大型部署細節,訓練部分亦提到 MS MARCO 只先載入 v2.1 train split 的首 30k 筆樣本,代表現階段較適合研究、評測與流程驗證。

  • 適合需要處理長文件的 RAG 項目,例如法律、科研、知識庫問答
  • 配置檔主導流程,方便版本控制、重現實驗與比較不同設定
  • 支援 optional reranking 與生成評測,不只是單做檢索
  • 相關模型包括 sentence-transformers/all-MiniLM-L6-v2,底層依賴 PyTorch 2.x 與 Transformers 4.51+
  • 若你想比較多粒度證據檢索與傳統 chunk-based RAG 的差異,這個項目很有研究價值

GitHub: https://github.com/AmirAbaskohi/SproutRAG

Paper: https://arxiv.org/pdf/2606.18381

Categories: 開源, RAG, 框架, 工具, Python NLP, Python, 庫, Meta

StylisticBias 拆解 MLLMs 視覺偏見

這不是一般人臉資料集,而是專門量度 MLLMs 社會判斷偏差的控制型 benchmark。它把身份固定,只改一個外觀線索,較易看清模型偏見從哪裡來。

StylisticBias pipeline overview

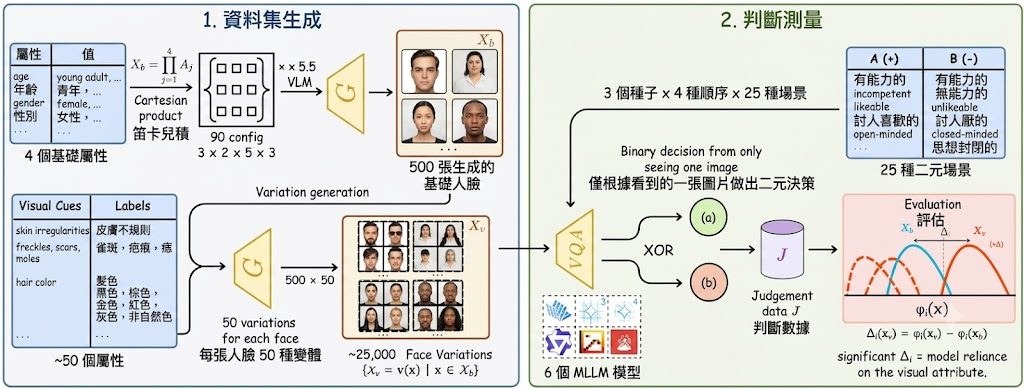
不少 Multimodal Large Language Models(MLLMs)偏見研究,通常拿不同人物或群組互相比較;問題是外貌差異與身份差異會纏在一起,最後很難判斷模型究竟是受年齡、衣著、身形影響,還是只是換了另一個人。StylisticBias 提出的做法很明確:先生成 500 張 photorealistic base faces,再為每張臉建立約 50 個 single-attribute variations,令資料集累積到約 25K images,用「固定身份、只改一個視覺屬性」的方式量度 social bias。

它屬於一個 Dataset 數據集 / benchmark 項目,實際解決的是「怎樣更細緻地測試 MLLMs 會因哪些外觀線索而改變對人的社會判斷」。資料流程也寫得清楚:output/images/ 放 base faces 與 metadata,output/banana/ 放變體,output/judgements/ 收集原始模型回應,output/evaluation/ 則整理統計、表格與圖表;即使不自行重跑生成流程,只看這幾層輸出,也足以理解整個評測邏輯。

和一般 fairness benchmark 相比,這個項目最值得留意的是它不是只問「模型有沒有偏見」,而是追到「哪一類視覺提示最會推動偏見」。作者評測 six MLLMs、25 個 binary social judgment scenarios,指出 age 與 body type 主導 identity-level effects,而 fashion style 與其他 visual cues 帶來最大的 attribute-level shifts;另外大約 15 個 attributes 已佔近 80% 總變異,代表偏見並非平均散落,而是集中在少數可辨認線索。

  • 固定同一張臉,只改一個屬性,較易分開 appearance effects 與 identity differences
  • 規模約 25K images,適合做較細粒度的 bias analysis
  • 結果顯示 age、body type、fashion style 是高敏感因素
  • judgement 對 appearance 語意較貼近的場景最敏感,尤其 socioeconomic 與 style-related 判斷

這項目最適合評估多模態產品風險的團隊、研究 AI fairness 的學者,以及要比較不同 vision-language model 行為的人。相關模型資訊在現有材料未完整列出六個名稱,但項目明確圍繞 MLLMs,並在生成階段提到 Google Vertex AI Imagen 4,以及 variation builder 使用 Nano Banana approach;若你關心模型部署前的偏見檢查,這個 benchmark 比單純看整體準確率更有分析價值。

GitHub: https://github.com/timo-cavelius/StylisticBias

項目主頁: https://huggingface.co/datasets/shaghayegh/stylistic-bias-dataset

Paper: https://arxiv.org/pdf/2606.20527

Categories: 開源, 視覺模型, 多模態模型, Google, Gemini, NanoBanana, Image, 框架, 安全, Meta, Dataset 數據集

MCompassRAG 把 RAG 檢索變得更準更省

MCompassRAG用主題訊號補強檢索,重點是推理階段不用再叫 LLM。它想解決段落級 RAG 容易撈錯資料的老問題。

alt Method

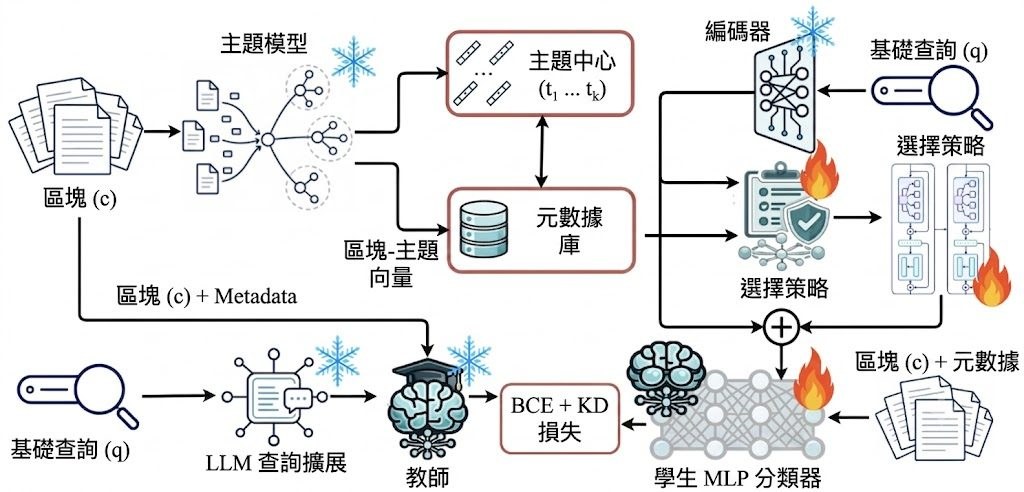
現時不少 RAG 會用 dense retrieval,直接把查詢同文本 chunk 的 embedding 拿去比對;當 chunk 切得較粗、語料又雜,語意接近未必等於真正答到問題。MCompassRAG 屬於檢索框架,做法是替段落加入 topic metadata,再用 LLM teacher 離線產生判斷訊號,蒸餾成一個輕量 retriever,修正「只靠 chunk embedding 排名」這種固定範式的偏差。

它的取向幾清楚:把較重的判斷放在訓練前期,推理階段只保留 metadata bank、embedding lookup 同小型 scorer,所以標明可做到 zero LLM calls at inference。這個取捨很適合想保留檢索速度,但又嫌傳統向量檢索太粗糙的團隊;代價是前處理較長,要先訓練 topic model,再生成 distillation data。

項目流程分成幾步:先準備語料、訓練 topic model、生成蒸餾資料、建立 metadata index,再訓練 retriever。環境上要 Python 3.10+、PyTorch 2.x、Transformers 4.51+,而且建議有 CUDA GPU;OpenRouter API key 只在 Step 2 — Generate distillation data 需要,之後檢索本身不依賴 LLM 連線。

可留意的重點有幾個:
– 不只重排結果,而是把 topic signal 放進 retriever embedding space 一齊學習
– 支援可插拔 topic model backend,現成有 CEMTM、ETM、CWTM、SoftLTM
– 推理成本貼近 embedding model latency,較適合高頻查詢場景
– 比起純 dense retrieval,更著重 paragraph-level evidence quality

作者強調它會在 complex retrieval benchmarks 提升 evidence quality 同效率,但目前倉庫內容較像 research implementation,未見非常完整的產品化基準表。較受惠的會是做知識庫問答、文件搜尋、企業內部檢索的團隊,尤其當資料主題分散、段落切分又未必夠細時,MCompassRAG 的 topic compass 概念比單純換一個 embedding model 更有分析價值。

GitHub: https://github.com/AmirAbaskohi/MCompassRAG

項目主頁: https://huggingface.co/papers/2606.18508

Paper: https://arxiv.org/pdf/2606.18508

Categories: 開源, RAG, Embedding, 模型訓練, API, 框架, Python NLP, 庫

HyperFrame 配合 Claude Code 製作 Vox 風格影片

這段影片展示用 AI 工具整理敘事影片流程。重點在於把腳本、視覺與製作步驟串連起來。

Og image

現有資料主要來自 YouTube 標題與簡短描述,資訊不算完整,但仍可看出內容圍繞 HyperFrame 與 Claude Code 兩個工具,示範如何做出接近 Vox 風格的解說影片。讀者可先把它理解為一個 AI 輔助影片製作項目:由工具協助處理腳本、畫面規劃或製作流程,而不只是單一步驟生成。

這類項目想處理的問題,很可能是把資料整理、敘事結構、畫面設計與影片產出連成一條工作流。相比只用單一影片生成模型,這種做法更接近內容製作流程本身,重點不只是「出片」,而是如何把想法變成有節奏、有資訊層次的短片。

從標題判斷,Claude Code 可能負責文字、結構或流程協調,HyperFrame 則可能用於畫面或影片製作環節。不過頁面未提供更詳細技術內容、模型名稱或量化結果,因此未能確認兩者各自負責的步驟,也不能判斷成品質素是否穩定。

可先留意幾個重點:
– 這是一個偏向工作流整合的影片製作項目
– 目標風格是資訊密度較高的 Vox 式解說內容
– 適合內容創作者、營銷製作與短片腳本規劃
– 現有頁面缺少性能數據、成本與時間比較

如果想進一步測試,較可行的方法是先觀看原片,記錄它如何拆分腳本、旁白、畫面節奏與素材安排,再用同類工具重建其中一小段。以目前資料來看,這項內容較適合作為工作流觀察,而不是完整教學或技術評測。

項目主頁: https://www.youtube.com/watch?v=XVsGK99E9FA

Categories: AI productions, Video, Vibe Coding, 教學, 工具, Content Creator, 編程, Anthropic

Apple container:Mac 原生容器新選擇

Apple 推出的 container 不是另一個包裝層,而是針對 Apple silicon 與 macOS 26 的原生容器工具。它適合想在 Mac 上跑 Linux 容器、又重視輕量與兼容性的人。

Containerization logo

container 是一個工具,用來在 Mac 上建立及執行 Linux containers,做法更接近把容器當成輕量虛擬機處理;它要解決的,是 Mac 開發者在本機跑 Linux 工作負載時,如何兼顧隔離、速度與 OCI 相容性。

這個項目最明顯的取向,是 Apple 自己用 Swift 編寫,並且針對 Apple silicon 優化,同時依賴 Containerization 這個 Swift package 處理較底層的 container、image 與 process 管理。跟不少人熟悉的 Docker Desktop 或其他 Mac 容器方案相比,它不是強調整合一大堆開發配套,而是集中做好原生執行、標準映像相容,以及 Apple 平台能力。

安裝不算複雜:官方提供已簽署的安裝包,裝好後要啟動 system service,並且整個項目只支援 Apple silicon 與 macOS 26。這代表門檻很清楚:如果你仍在舊版 macOS,或者團隊有 Intel Mac,這個項目暫時就不會是通用解法。

Apple Just Built WSL for the Mac (Container Machines)

它支援讀寫 OCI-compatible container images,所以可以從標準 container registry 拉取映像、建立映像,再推回其他 OCI-compatible application 可用的環境。對開發團隊來說,這點很重要,因為它不是把流程鎖死在 Apple 自家格式,而是保留與現有容器生態互通。

  • 針對 Apple silicon 與 macOS 26,平台限制明確
  • 支援 OCI-compatible container images,可接標準 registry
  • 底層建基於 Containerization,偏向原生與輕量路線
  • 較適合 Mac 開發、測試、映像建置,不是全功能平台替代品

效能方面,暫時沒有提供完整官方基準數字,但外部已有文章把它放到 Docker Desktop、OrbStack 一類方案旁邊看 CPU、記憶體、啟動時間與 I/O。即使未能單靠儲存庫內容下定論,仍可合理判斷:Apple 想做的不是「功能最多」,而是在自家硬件上提供更貼近系統能力的容器執行方式。較受惠的會是以 Mac 為主要開發機、需要 OCI 相容流程、又願意接受新平台限制的工程團隊。

這個項目不是 AI 模型;若要說相關技術組件,主要是 OCI-compatible container images 與 Containerization。

GitHub: https://github.com/apple/container

項目: https://developer.apple.com/videos/play/wwdc2026/389/

Categories: 開源, 工具, Mac, Linux, 庫, 蘋果

Page 85 of 184
1 … 83 84 85 86 87 … 184