ATAS 以持續世界記憶改善長片生成一致性

ATAS 讓每個鏡頭共享可回訪的世界狀態,減少長片生成中人物、場景與事件難以保持連貫的問題。

ATAS: Any Time, Any Space

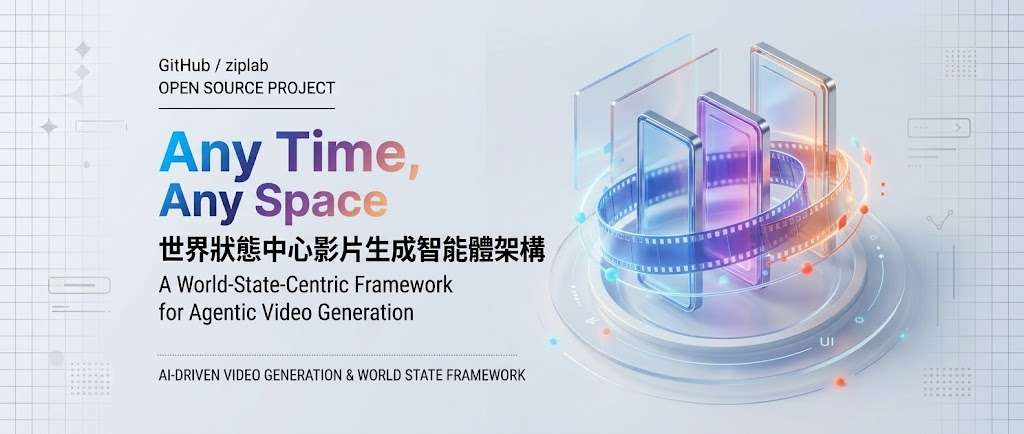
長片生成最難處理的不是單一鏡頭是否漂亮,而是角色重返同一地點、事件在不同時間再次出現時,畫面能否維持一致。ATAS(Any Time, Any Space)屬於 agentic video generation 框架,將劇本拆成包含場景、鏡頭、時間及事件的 shot request,再以持續更新的世界狀態支援後續生成。

ATAS 沒有只把上一個鏡頭或提示詞傳給下一次生成,而是分開保存兩類記憶:Scene Memory 記錄已註冊的靜態幾何,Event Memory 則按場景、事件和時間索引動態觀察。新片段生成後會被重建、註冊及檢查,只有通過審核和狀態驗證的內容才會更新記憶;影片交付則不受記憶是否接納影響,減少錯誤觀察污染後續鏡頭的風險。

• 將劇本編譯成具體的場景、相機和事件時間要求
• 支援從不同視角回訪同一場景
• 可重現較早時間點發生過的事件
• 生成後進行註冊、審核及世界狀態檢查

項目展示的差異,在於把跨鏡頭一致性視為世界狀態管理問題,而不是單純延長上下文或串接最近畫面。這會增加記憶建立、片段重建和驗證所需的計算與流程複雜度,但更適合長片、分段製作及需要角色與場景持續連貫的內容工作流。

研究結果涵蓋四個影片生成器;ATAS 在報告的跨鏡頭一致性指標均有改善,並在每個 backbone 取得最高綜合 benchmark 分數。它亦在目標影像空間回訪、三項事件重現指標及六項人工評分準則中領先比較的 agents 和 3D-guided methods。儲存庫目前主要提供研究程式碼、技術資料及示範,使用者需要按項目頁面的環境與模型依賴自行重現流程。
項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, 模型, 視頻模型, Video, Image, World-Action Model, 提示詞, 框架, 3D, 庫, Dataset 數據集

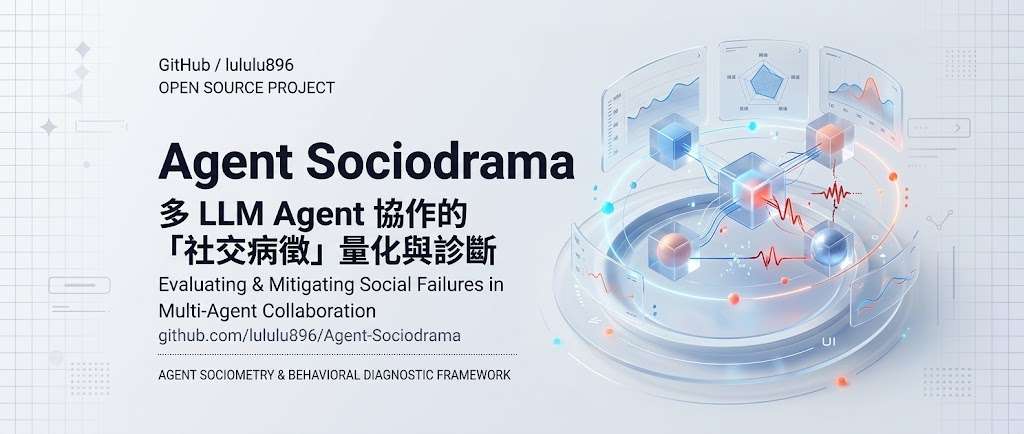
Agent Sociodrama:以社交方式強化 Agent

北航與南洋理工團隊提出 Agent Sociodrama,追蹤多智能體對話中的情緒與關係演變,再以 Trajectory-Guided Persona Recasting 重新分配角色,部分場景準確率提升達 83.3%。

Repository image for lululu896/Agent-Sociodrama

多個 LLM agent 組隊做任務時,常出現一些尷尬的社交故障:掌握關鍵資訊的角色不發言、意見領袖把答案鎖死在錯處、有人越界卻無人制止。北京航空航太大學與南洋理工大學的合作研究 Agent Sociodrama,正是要把這些「社交病徵」量化,再對症下藥。

這個項目的核心做法是把每一次對話拉成兩條可追蹤的軌跡:每個 agent 的情緒狀態 S,以及彼此之間有向、不對稱的關係 R。系統在六款主流骨幹模型、五個社會情境中重播這些軌跡,檢驗它們是否符合社會學經典模式,並比對人類評審的判斷。當軌跡顯示團隊運作出現結構性偏差,便啟動 Trajectory-Guided Persona Recasting(TPR)診斷失敗根源,重新調整各 agent 的人格設定再重跑任務。

四個協作基準測試中,TPR 在異質與隨機初始的團隊組合上皆有改善,準確率最高提升 83.3 個百分點;在分散資訊合作及混合動機議題類任務中,三個場景擊敗 SOTOPIA 與 AgentVerse,Pareto 比率領先最多 37.5%。對於需要模擬談判、群體決策或角色扮演的研究團隊,這套框架把「為何對話走偏」變成可分析的數據,而非只能靠事後觀察。

目前已公開 fidelity 與 recasting 兩組實驗的處理結果、重算表格的腳本,以及 Tavern 繼承糾紛與 Lost at Sea 兩個完整對話範例;模擬引擎與 TPR 控制器則待論文獲接收後釋出。要快速理解這套方法,可以直接看 fidelity_tavern 資料夾內 Claude Sonnet 4.6 驅動的五位 agent 九輪對話,逐輪檢視 S 與 R 的更新。

  • 追蹤情緒狀態 S 與有向關係 R,建立可量化嘅多 agent 社交軌跡
  • 以社會理論模式同人類評審交叉驗證社交保真度
  • TPR 自動診斷團隊失敗並重塑人格,喺四個基準平均顯著提升表現
  • 已釋出數據、重現腳本同完整對話範例,方便本地分析

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, World-Action Model, 框架, Anthropic

GroundingPI 以 4B 視覺基礎模型連接感知與機械控制

GroundingPI 把視覺定位轉成可供機械系統使用的點和框,主打複雜場景下的精準感知與控制效率。

GroundingPI

要讓自動駕駛或機械人準確知道「要處理哪件物件、位置在哪裏」,單靠一般視覺語言模型仍可能在雜亂畫面和細小物件上失準。GroundingPI 屬於視覺 grounding foundation model,以 4B 參數模型處理定位問題,輸出可供後續控制使用的視覺結構。

模型以 visual primitives 為核心,將點和框表示成 shared vocabulary 中的 quantized coordinates,再配合 vision-language model、tokenizer、processor 和 custom model code。這種做法針對 VLA(vision-language-action)及 WAM(world-action models)常見的感知瓶頸,並讓 perceptual foundation 可以轉移到 autonomous driving 和 robotic manipulation。

  • 定位方式:同時支援點與框,適合指定目標及描述空間位置。
  • 模型規模:4B 參數,目標是在能力與運算成本之間取得平衡。
  • 評測結果:涵蓋 34 個 grounding benchmarks、11 種感知能力,對比 44 個基準模型平均達 73.68%,高於 GPT-6 Astra 的 71.54%。
  • 轉移價值:在 ID 和 OOD 評估,以及 action-data efficiency 方面,展示對自動駕駛和機械人操作的幫助。

對研究團隊而言,GroundingPI 不只是單次定位模型,亦可作為 System-1 foundation-model 的感知層,補足未必擅長精準 grounding 的通用視覺模型。項目提供 Hugging Face 模型及 Demo,並列出 vLLM、Transformers backend、OpenAI-compatible API 和 JSONL batch annotation 工作流;不過提供的儲存庫資料未交代完整硬件需求,部署前仍需按文件確認環境。

研究重點同時放在 pretraining scale 和 data composition 如何影響 grounding 及轉移效果。需要即時視覺定位、閉環控制或希望減少 action data 的自動駕駛、機械人及 embodied AI 團隊,會較容易從這個模型的感知能力受益;純文字或一般影像分類工作則未必能直接發揮其價值。

項目主頁 · GitHub · 模型

Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 多模態模型, 模型訓練, API, Image, VLA, World-Action Model, Robotic, 香港, 庫, Tokenize

Representation Guidance(RG):以低維引導 Pixel Diffusion Transformer 生成影像

Representation Guidance 把生成所需資訊壓縮到低維表示,再直接引導像素生成,為大型 pixel diffusion Transformer 提供更有效率的改良方向。

Samples generated by RG

由像素直接生成高質素影像,往往要在語義理解、空間細節與模型計算量之間取捨。Representation Guidance (RG) 屬於影像生成模型方法,針對 pixel diffusion transformers 加入可被生成流程主動利用的內部表示,同時保留 plain Transformer 架構,處理表示學習與像素合成未能有效銜接的問題。

RG 先用 low-dimensional bottleneck 將與生成相關的資訊集中到緊湊表示,再按照該表示帶來的 prediction offset,修改 flow-matching target,直接引導 decoder 生成。它沒有依賴外部 autoencoder 預先建立 representation space,而是由 raw pixels 端到端學習;相較加入專用 pixel decoder 的架構,RG 嘗試避免只重新分配語義及空間建模工作,並以較簡單的 Transformer 結構擴展。

在 ImageNet 256×256 測試中,RG-L/16 使用 459M 參數,在 600 epochs 達到 1.79 FID;RG-XL/16 以 724.9M 參數取得 1.55 FID、293.8 IS。項目亦報告 512×512 的 1.74 FID,並延伸至 text-to-image,在 GenEval 取得 0.89、DPG-Bench 取得 87.1;這些結果顯示方法適合研究高解析度像素生成及文字生圖,但較大型模型仍需要相當計算資源。

你可從以下幾點理解它的實際價值:
– 低維 bottleneck 將生成相關資訊集中,減少表示與生成流程各自學習的落差。
– RG-L/16 以較少參數超越更大型的 pixel diffusion transformers。
– plain Transformer 方便研究內部表示如何形成及影響像素合成。
– 項目資料提供結果與模型規模,但未交代完整安裝、下載或推理流程,測試前仍需查看 Project Page 或後續程式碼。

較適合研究 pixel diffusion、生成式表示學習,以及希望比較 flow matching 架構的團隊。它的價值不在於提供即時可用的生圖工具,而在於把「學到表示」與「利用表示生成」放入同一個訓練機制;模型參數和 GFLOPs 仍然偏高,未必適合資源有限的個人電腦。

項目主頁 · GitHub

Categories: 開源, 香港大學, 阿里巴巴, 模型, 模型訓練, Image, World-Action Model, txt2img, 香港, 工具

StereoBind 讓生成聲音跟隨畫面移動

StereoBind 不只同步影片與聲音,還嘗試讓聲音方向跟隨畫面中的發聲物體移動,為沉浸式生成補上空間感。

StereoBind logo

當畫面中的車輛、人物或物件移動,聲音不應只在時間上同步,還要讓聽者感覺聲源位置一同改變。StereoBind 屬於聯合影片與音訊生成模型的研究項目,處理的正是立體聲與可見聲源之間的動態空間對應問題,面向 AR/VR、互動遊戲及沉浸式內容製作較有價值。

StereoBind 在預訓練的 joint audio-video generator 上加入視覺來源的 motion tracks,將畫面中的移動軌跡傳給音訊生成流程。Simple Summary Tokens 壓縮來源內容與動態資訊;Spatial Track Encoder(STE)編碼每個時間點的標準化 2D 位置;ResidualTrackRoPE 則把相對軌跡變化加入 temporal attention,令模型同時理解聲源所在位置及移動方向。

  • 以軌跡連接視覺來源與 stereo audio
  • StereoWorld-29K 提供附帶 motion tracks 的立體聲影音資料
  • StereoWorldBench 用來量度聲音是否跟隨可見聲源
  • 目標是改善空間對齊,同時保留整體影音品質

StereoWorld-29K 不只是訓練資料,亦包含由真實影片及軌跡控制合成場景整理而成的幾何監督;StereoWorldBench 則針對聲音與畫面來源在時間上的空間一致性作評估。項目資料稱實驗能大幅改善立體聲生成的空間對齊,但目前提供的資訊未列出具體分數、基準模型或延遲數據,因此未能判斷它在不同場景的實際優勢幅度。

GitHub 儲存庫目前仍屬公開發布前狀態,inference code、training code、設定檔、checkpoints、StereoWorld-29K 及評估套件尚未提供,亦沒有可照做的安裝流程。研究團隊、影音生成模型開發者,以及需要聲音方向隨畫面移動的 AR/VR 和遊戲製作流程,可以先把它理解成一套待公開的 trajectory-conditioned 聯合生成框架;現階段較適合閱讀研究概念及等待後續資源,而不是立即部署。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, Video, World-Action Model, Audio, 框架, 庫, Dataset 數據集

RobotWorld:把多模態智能體放進機械人世界測試

想比較多模態模型控制不同機械人的能力,RobotWorld 提供 84 項模擬任務及隱藏評測。

Watch RobotWorld in 45 seconds

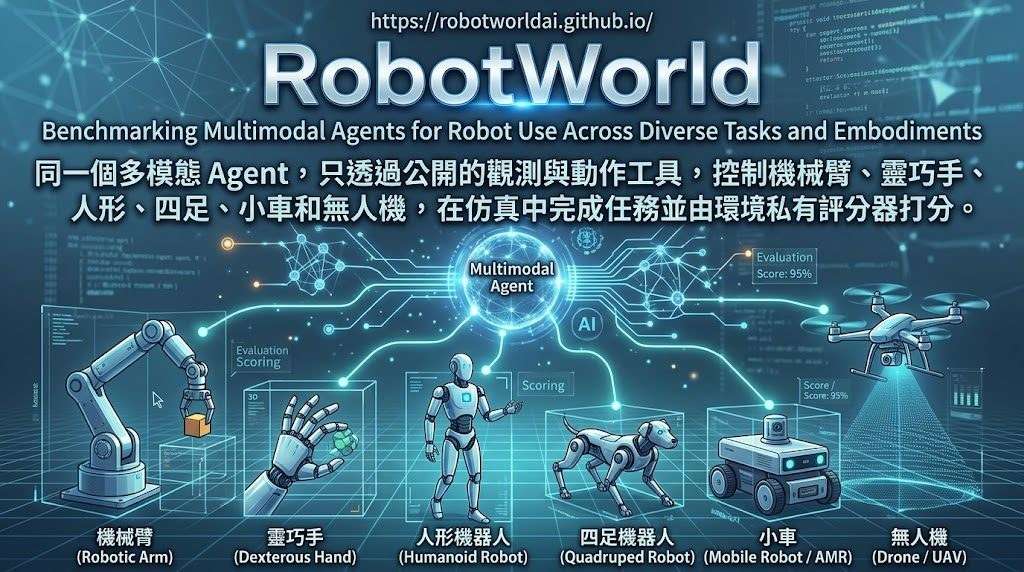
想測試模型能否由影像和狀態資訊控制機械人,而不只是回答完成任務,RobotWorld 提供一套跨模擬器的機械人基準測試項目。它屬於具身智能體評測框架,讓多模態代理透過觀察與動作介面控制機械臂、靈巧手、人形機械人、四足機械人、汽車及無人機,處理 84 項任務和 20 個 benchmark integrations。

代理只能讀取允許的相機影像、關節及任務狀態,再發出受限制的控制指令;環境會回傳執行收據和新觀察,讓代理修正下一步。任務結果由代理看不到的 hidden evaluators 判定,避免模型自行聲稱成功而取代環境驗證,亦能揭示物件狀態遺失、子目標停滯和錯誤完成判斷等失敗原因。

  • 評測方式:預設每項任務進行三次 rollout,並停用 environment-side code control。
  • 涵蓋範圍:由 manipulation、locomotion 延伸至 driving 和 flight。
  • 執行流程:需要還原 source、準備指定 assets、建立 Docker images、編譯 runtime,以及設定模型 API credentials。
  • 限制:已註冊任務不代表全部都有已驗證的成功軌跡,部分依賴和受限制資料集仍需另行取得。

相比只測文字答案或單一機械人的方法,RobotWorld 把模型推理、感知、控制和環境回饋放入同一條閉環,較適合研究團隊比較不同多模態模型、重現評測流程,或為新任務和新 embodiment 擴充測試。代價是安裝和資源準備較複雜,結果亦會受模擬器、模型設定及每項任務預算影響。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, API, Image, World-Action Model, Robotic, 框架, Anthropic, Dataset 數據集

MiniCorp 以模擬企業填補 AGI 代理數據缺口

企業代理要學識做決策,欠缺的往往不是模型,而是真實、連續又可重演的商業數據。MiniCorp 嘗試用虛擬公司補上這個缺口。

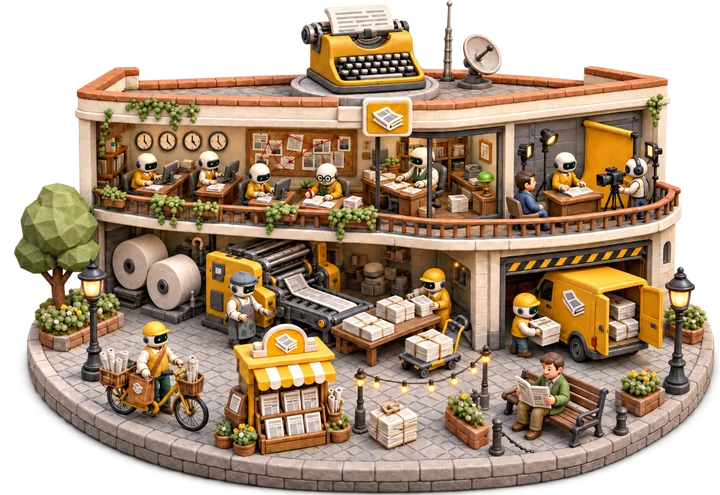
The MiniCorp simulation core

企業代理要處理日常工作、作出商業決策,卻難以取得足夠真實而且可長期追蹤的企業資料。MiniCorp 以 Office Simulators for Enterprise AGI 為核心,建立可讓 autonomous enterprise agents 運作的高擬真虛擬公司環境,藉此研究 AI 管理企業的方式。

這些模擬公司涵蓋醫院、航空公司、對沖基金、報紙、電子商貿及高科技企業等場景。代理可以在連續運作的環境中執行工作,研究團隊亦能生成 longitudinal enterprise data,以及比較不同決策後果的 counterfactual enterprise data,減少依賴受私隱限制、價格昂貴或需要專家標註的真實企業檔案。

MiniCorp 處理虛擬企業讓研究者重播情境、改變決策條件,再觀察代理長期表現,適合用於訓練、測試及分析企業級 AI agent。

目前項目提供研究資料、GitHub、arXiv 及 Hugging Face 入口,互動示範仍標示為準備中。使用者可先把它理解成研究企業代理的模擬場,而不是可直接接管真實公司的現成產品。

  • 建立醫院、航空、金融及電子商貿等企業場景
  • 產生可長期追蹤的企業運作數據
  • 支援反事實決策比較與代理研究
  • 針對企業級 autonomous agents 的訓練和測試
  • 互動 Demo 尚未正式推出

項目主頁

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, World-Action Model, Robotic, 安全, AGI

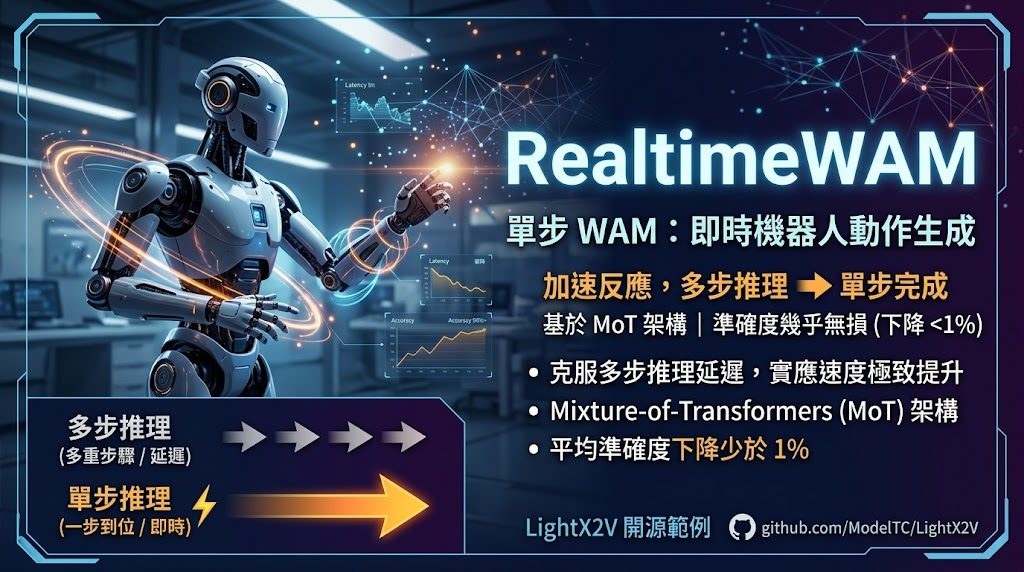
RealtimeWAM 讓世界動作模型走向即時生成

LightX2V 的 RealtimeWAM 以單步生成降低延遲,嘗試保留多步模型的表現,讓機械人動作反應更接近即時。

Og image

機械人需要根據畫面快速產生下一個動作時,多步推理帶來的延遲會直接影響反應速度。LightX2V 的 RealtimeWAM 範例針對這個取捨,提供面向即時推理的 World Action Models (WAM) 方法,將動作生成壓縮至單步完成。

RealtimeWAM 建立在 Mixture-of-Transformers (MoT) 架構的 WAM 之上,主張在減少推理步驟的同時,盡量維持原有模型的準確度。項目 README 將它描述為首個單步 WAM,並指出相較多步版本,跨多個基準測試的平均準確度下降少於 1%。

項目列出的測試包括 RoboTwin 2.0 和 LIBERO,涵蓋機械人操作相關場景。這代表它較適合需要低延遲動作決策的研究者、機械人控制工作流,以及希望在既有 MoT-based WAM 架構上探索即時生成的開發者;不過,實際效果仍會受模型、硬件和測試任務影響。

  • 單步生成,降低多步推理造成的延遲
  • 兼容以 Mixture-of-Transformers 為基礎的 WAM 架構
  • README 聲稱平均準確度下降少於 1%
  • 提供 RoboTwin 2.0 和 LIBERO 等評估參考
  • 以 LightX2V 框架形式呈現即時 WAM 範例

項目主頁

Categories: 開源, Agentic, MCP, 模型, 世界模型, World-Action Model, Robotic, 框架, 安全, Skill 技能

NAVA-WAM 讓機械人從影片學會直接行動

NAVA-WAM 從無動作標註影片學習機械人策略,減少視覺表徵與潛在動作之間的轉換限制。

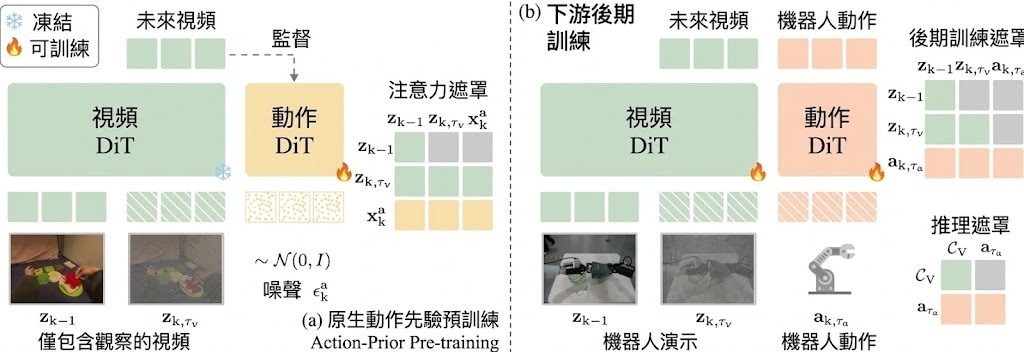
Overview of NAVA-WAM: action-free pre-training and downstream post-training.

機械人只看過人類操作影片,未必需要先建立中間視覺表徵或獨立的潛在動作模型,便能學習下一步應怎樣移動。NAVA-WAM(Native Action-Prior Learning from Videos for World Action Models)是一個 World Action Models(WAM)項目,直接從 observation-only videos 預訓練 action policy,處理動作標註機械人軌跡不足的問題。

訓練分為兩個階段:第一階段利用影片中的未來視覺變化作 flow-matching supervision,透過 transition-structured joint attention 將與動作相關的資訊傳入 Action-DiT;第二階段再加入動作資料,讓策略對應到機械人控制。這種做法避開先學視覺、再轉換成控制訊號時可能出現的落差。

實驗把經 DROID 訓練的策略直接放到實體 Franka FR3,沒有針對個別任務再微調。在三項任務共 15 次測試中,NAVA-WAM 平均成功率為 93.3%,DreamZero 為 66.7%,π0.5 為 53.3%;伺服器端每次 policy call 為 379.2 毫秒,按每次重新規劃實際執行的動作數計算,每個動作約 15.8 毫秒。

• 從 observation-only videos 直接學習 action policy
• 不依賴中間視覺表徵或獨立 latent-action model
• 在空間關係任務中,NAVA-WAM 成功 4/5 次,兩個基線均為 0/5
• 已在實體 Franka FR3 上測試,未作任務專屬微調

T1 要求把方塊放到碗的左側,基線模型雖能正確定位和抓取方塊,卻未能理解指令中的空間關係;NAVA-WAM 則較能將視覺互動經驗連接到具體控制行動。項目的限制是訓練仍需要第二階段的動作資料,並非完全脫離機械人示範,因此更適合用作擴充動作先驗,而不是取代所有實體機械人資料。

項目主頁

Categories: AI productions, 模型, 模型訓練, Video, World-Action Model, Robotic, Meta

Awesome-Video-Generation-Post-Training:影片生成後訓練研究,一個持續更新的索引

影片生成模型的競爭已延伸到後訓練與對齊,這項目把論文、數據集及評測基準集中整理。

timeline

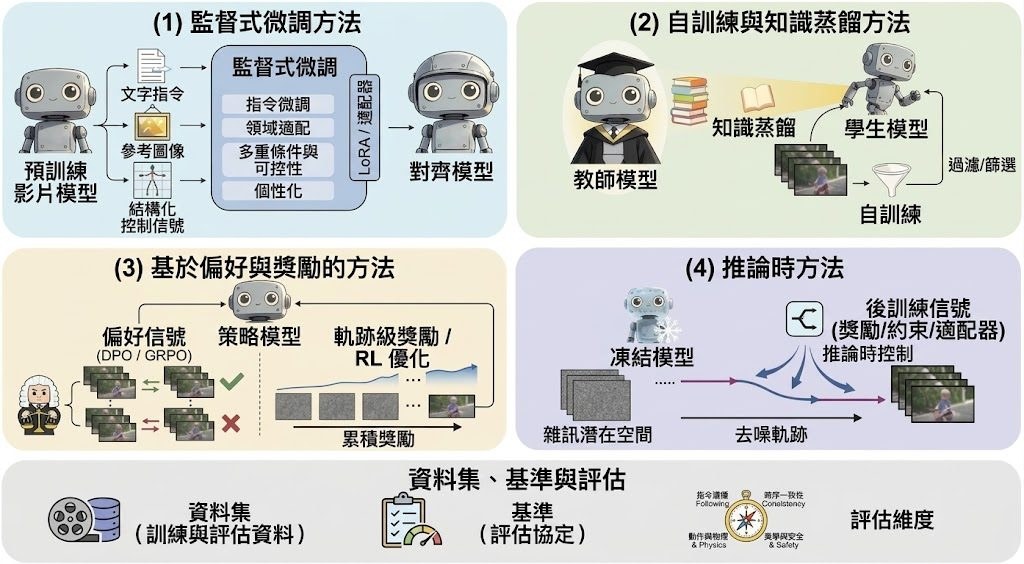
當影片生成模型由「能夠生成」走向「更符合指令、更穩定、更易評估」,研究者需要追蹤的不只是預訓練架構。Awesome-Video-Generation-Post-Training 是一個研究資料整理項目,集中收錄影片生成的 post-training、alignment、相關數據集及 evaluation benchmarks,亦配套一篇 Video Generation Models: A Survey of Post-Training and Alignment 綜述論文。

它不提供可直接執行的生成模型,主要在於縮短研究資料搜尋時間。你可按分類閱讀近期論文、對照不同後訓練方法,再沿着數據集與評測基準追查研究如何衡量影片品質、指令遵從及對齊效果;項目內容會持續更新,亦接受透過 pull request 補充論文、修正資料或建議分類。

  • 資料範圍:聚焦影片生成的 post-training 與 alignment 研究
  • 配套資源:整理相關 datasets 及 evaluation benchmarks
  • 閱讀方式:適合由綜述論文入門,再按分類深入原始研究
  • 參與方式:可提交 pull request,補充或修訂索引內容

對研究生、影片模型開發團隊及需要整理文獻的工程師而言,這項目比零散搜尋更方便建立研究地圖。它的限制亦很清楚:索引本身沒有統一跑分、推理介面或安裝後即可測試的模型,性能判斷仍要返回各篇論文查看實驗設定與指標。

GitHub

Categories: 開源, AI productions, 模型, 視頻模型, 模型訓練, Video, World-Action Model, Dataset 數據集

Page 2 of 4
1 2 3 4