TBSM 想把一步生成變得更實用

想要快,但又唔想靠冗長採樣或額外教師模型,TBSM正正瞄準呢個矛盾。它用一步生成處理影像與 text-to-image,取向相當鮮明。

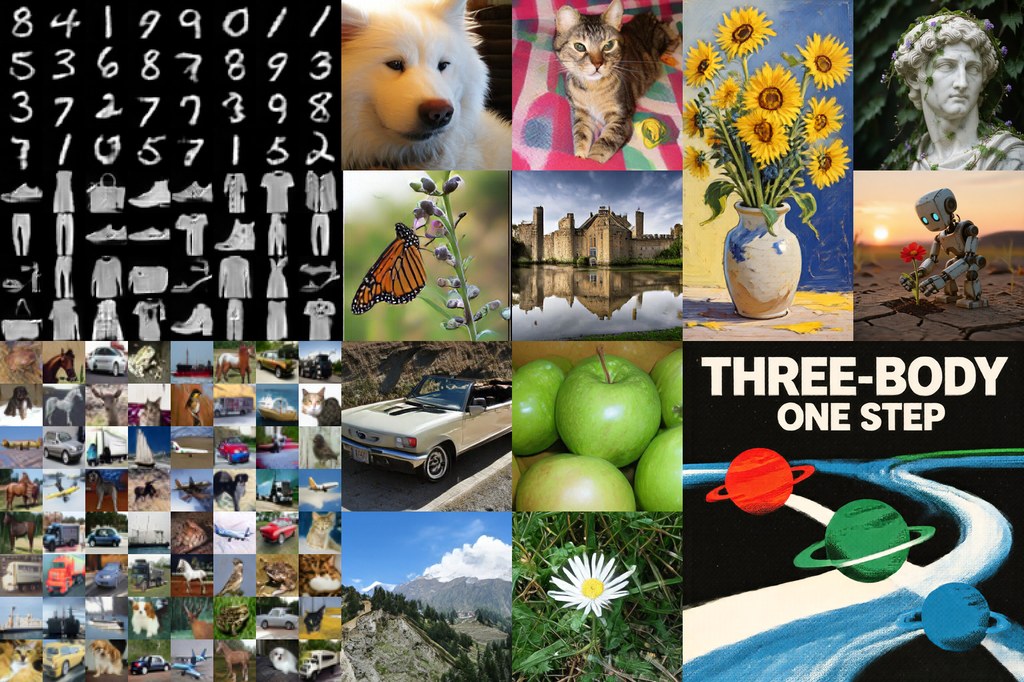
TBSM one-step samples across handwritten digits, fashion items, CIFAR-10, ImageNet, and text-to-image generation.

生成模型一路追求更快出圖,但速度一提升,訓練往往就變得更複雜。TBSM 把焦點放在one-step generation,而且唔係靠 adversarial critic、teacher queries,亦唔需要 batch-wide all-pairs field 去撐住整個流程;它屬於生成模型方法,處理的是怎樣用較直接的監督,把一次生成做得可訓練又可擴展。

這個項目的判斷重點,在於它不只是講快,而係試圖避開幾條常見路線的代價:GANs 容易受 adversarial min-max objective 影響,AR / Diffusion 要逐步解碼或反覆採樣,Drifting Models 會受 batch 規模拖高成本,diffusion distillation 又常常連帶額外模型、loss 或訓練技巧。TBSM 用 three-body scattering 連到 distributional energy,目標是把分佈層面的學習,壓成 sample-level supervision,令一步生成唔使再背住咁重的系統負擔。

它已展示多種資料與輸出空間,包括 handwritten digits、fashion items、CIFAR-10、ImageNet,以及 1024×1024 的 text-to-image。這代表它較像研究型項目而唔係即裝即用產品:你會先從 paper、示意圖與 quick start 去理解訓練與生成流程,再按資料集或任務類型測試效果,較適合有模型訓練環境的研究團隊、影像生成項目,或者想研究 one-step generation 取捨的人。

  • 核心賣點是一跳生成,不靠多步採樣換品質
  • 設計上避開 adversarial critic、teacher model 同 batch 全配對成本
  • 已展示多個資料集與 text-to-image,覆蓋面比純玩具示範更廣
  • 現階段更接近研究實驗框架,部署前要先消化方法與訓練設定

它吸引人的地方,在於把「生成速度」同「訓練系統複雜度」一齊拉入取捨表,而不只是追某個指標。現有資訊未見完整效能數字與部署細節,表示讀者現階段應把它看成值得追蹤的生成模型研究方向:概念清晰、定位明確,但要判斷是否適合生產環境,仍然要等更完整的評測與開源內容。
GitHub

Categories: 開源, Qwen, Image, txt2img

JoyAI-Image 想做懂空間的影像模型

JoyAI-Image唔只想生圖,仲想令模型真正理解畫面入面物件點擺位、點互相關聯。對要做指令修圖、排版生圖同多視角內容的人,呢個方向幾有參考價值。

Repository image for jd-opensource/JoyAI-Image

改圖最怕模型聽得明文字,卻改壞原本場景結構;生圖亦常見字排得唔準、物件關係走位。JoyAI-Image就係朝住呢個痛點落手,定位屬於多模態基礎模型,把影像理解、text-to-image 生成同指令式編輯放入同一個模型家族,重點處理空間理解不足帶來的失真與失控。

唔係把理解模型同生成模型鬆散拼埋,而係用 8B Multimodal Large Language Model (MLLM) 配 16B Multimodal Diffusion Transformer (MMDiT),強調理解、生成、編輯之間的閉環協作。換句話說,模型唔只讀圖後再畫圖,仲會利用視角變換等生成結果反過來補強空間推理,呢點令它在 grounded generation、關係定位同可控編輯上有更鮮明方向。

現有公開內容顯示,部署路線算完整,已提供 Hugging Face 權重、Diffusers 版本、ComfyUI 原生支援,同埋可直接參考的 workflow;另外亦有 Spatial Edit 同 General Edit 示範空間。對內容製作、電商視覺、設計流程或者研究多模態編輯的人,較值得留意的是它不只處理單次修圖,仲想處理長文字排版、版面忠實度、多視角生成,以及「指定物件移去指定位置」呢類容易出錯的操作。

JoyAI Image Edit Plus in ComfyUI - How Does it Compare?
  • 把理解、生成、編輯整合到同一條多模態流程
  • 核心賣點係較強的 spatial intelligence,而不只是畫面更靚
  • 已有 Diffusers 與 ComfyUI 兩條使用路線,測試門檻較研究原型低
  • 延伸到 OpenSpatial data engine 同 OpenSpatial-3M dataset,反映它連資料與訓練配方都一併公開

效能方面,儲存庫描述集中在能力展示與訓練設計,現階段較適合把它理解成一個方向清晰、工具鏈逐步成熟的開源影像模型項目。最吸引之處唔係單一指標,而係它把空間理解當成生成與編輯的核心能力,對需要更穩定版面、關係同位置控制的工作流,確實比單講畫質更實用。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, 視覺模型, 多模態模型, Qwen, Image, txt2img, Dataset 數據集

Sana 把高解像生成壓到快 100 倍

想做高解像圖片或影片生成,又唔想計算成本高得難以落地,Sana 提供了一條幾實際的路。它把訓練、推理到不同變體放在同一套代碼庫,重點放在速度與畫質之間的平衡。

logo

高解像圖片同影片生成最常見的卡位,不是效果做不到,而是算力、延遲同部署成本太難接受。NVlabs/Sana 屬於生成模型代碼庫,集中處理這個矛盾:在維持高解析輸出的前提下,把訓練與推理做得更省、更快,並且一路延伸到圖片、影片、世界模型等多條分支。

這個項目唔係單一模型,而是一個家族。SANA 主打最高到 4K 的 text-to-image,README 直接給出「比 Flux-12B 細 20 倍、快 100 倍」的定位;SANA-1.5 進一步處理訓練期與推理期的 compute scaling;SANA-Sprint 則把重點放在 one/few-step 生成,官方數字提到 H100 上 1024px 圖片可做到 0.1 秒級。取向很清楚:不是一味追最大模型,而是用效率換取更可部署的生成流程。

影片部分同樣值得留意。SANA-Video 與 SANA-Video 2.0 把焦點放在 720p 長序列生成,做法上用 hybrid linear attention 配合 Attention Residuals,目的是減少 full-softmax attention 的成本,同時盡量保住畫質與長序列表達能力。公開資料提到 SANA-Video 2.0 在單張 H100 上,720p/5 秒影片可做到 13.06 秒,VBench 總分 84.30,也強調比 Wan 2.2 14B 有大幅速度優勢,但這類數字仍要連同硬件、步數與設定一齊理解。

  • 同一庫內含 SANA、SANA-1.5、SANA-Sprint、SANA-Video、SANA-WM、SANA-Streaming、Sol-RL
  • 提供完整 training 與 inference pipeline,唔止展示模型效果
  • 可透過官方 demo、Hugging Face、ComfyUI 整合去理解生成表現與部署方向
  • 重點不是極限參數量,而是高解像生成的速度、成本同可擴展性

部署與測試路線相對清晰:已有官方文件、網頁 demo、Hugging Face 集合,亦見到 ComfyUI、SGLang、Replicate 等接點,代表它較適合研究團隊、影像工作流開發者,以及想把高解像生成放進產品流程的人。 SANA-WM 的 2.6B controllable world model、6-DoF camera control,同 Sol-RL 的加速收斂能力,則顯示這個項目不只做靜態出圖,而是朝更完整的生成系統推進。

項目主頁 · GitHub

Categories: 開源, ComfyUI, AI productions, 世界模型, 模型訓練, NVIDIA, Stable Diffusion, Video, Image, txt2img

Facial-Expression-Prompting:幫 AI 影片角色演得更可信的提示詞 Skill

想拍角色反應戲,但提示詞只寫到情緒名?這些 Skill 會把動機、微表情同鏡頭節拍補完整,令 AI 影片生成更似一場表演。

Repository image for zhouwei713/facial-expression-prompting

情緒寫得太粗,AI 影片角色往往只會交出一個「表情」,而唔係一段有起伏的反應。呢個 GitHub 項目定位好明確:它係一個為人物表演而設的提示詞 Skill,專門把模糊情緒拆成可拍、可生成、可放入文生視頻與圖生視頻模型的演出指令,處理的是角色點樣由看到事件、壓住反應,再慢慢洩露情緒。

最有用的地方不只是擴寫字數,而係先補足角色點解會有反應。它用五個問題建立因果鏈,再把眼神、眼瞼、眉間、嘴角、下顎、呼吸、姿態同聲音排成時間軸,連鏡頭、光線、時長同負面約束都一併整理。對 Seedance、Kling、Runway、Veo 呢類模型來講,呢種寫法比單一句「她很傷心」更容易生成連貫畫面。

同類做法常見是堆情緒形容詞,或者直接放大表情強度;呢個項目反而重視克制、遞進同角色自我控制,所以特別適合特寫、關係戲、對白反應同微表情場景。代價亦好清楚:它偏向劇情演出導向,唔係追求高速出稿的萬用提示詞模板,使用者最好本身知道角色處境,先能發揮得更準。

  • 支援完整視頻模式同表演片段模式,前者補全整段提示詞,後者可插入既有腳本
  • 適合 Seedance、Kling、Runway、Veo 等 AI 視頻模型
  • 重點唔在誇張表情,而在可見的情緒轉折、微表情同鏡頭配合
  • 會按表演節拍決定時長,而唔係固定把每段反應寫成同一秒數

這個 Repo 可理解成一個可直接複用的 Agent Skill/提示詞模板項目,而唔係獨立模型或推理服務。它較適合內容創作者、短片導演、角色動畫設計者,或者要反覆修改人物反應戲的團隊;當目標係令 AI 生成的角色「有心事」而不只是「有表情」,呢個項目的取向相當實用。

GitHub

Categories: 開源, Agentic, AI productions, Video, txt2img, 提示詞, Skill 技能

SpectraReward:用 MLLM 反讀圖片做文生圖獎勵

想提升文生圖結果,但又唔想另外訓練獎勵模型,SpectraReward提供了一條更直接的路。它用預訓練 MLLM 反過來讀圖還原提示詞,作為生成好壞的依據。

Og image

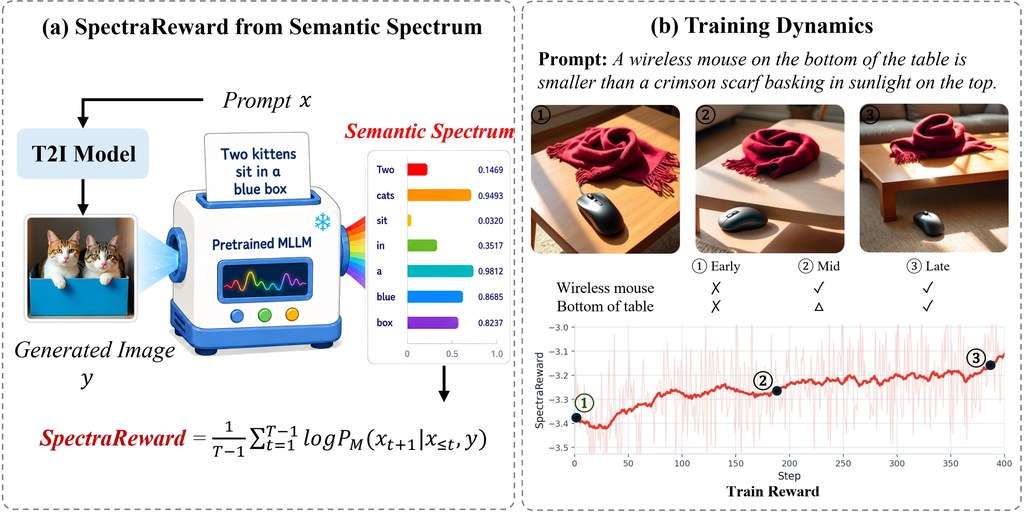
文生圖訓練最麻煩的一環,往往不是生成本身,而是怎樣穩定判斷圖片有冇跟足提示詞。SpectraReward 屬於影像生成 reinforcement learning 的獎勵方法,處理的正是這個問題:它不靠人工偏好標註,也不用再微調 reward model,而是借用預訓練 Multimodal Large Language Models(MLLMs)本身已有的圖文對齊能力,直接替生成結果打分。

核心做法很直觀:先讓 MLLM 看生成出來的圖片,再檢查它能否把原本的 prompt「讀返出嚟」。SpectraReward 用一次 image-conditioned、teacher-forced forward pass,計算 prompt 的平均 log-likelihood,數值越高,代表圖片越能還原文字意圖。相比常見做法要模型直接評分、回答拆解後的驗證問題,這個方法少了額外訓練步驟,也減少了設計評分流程的負擔。

項目亦提出 Self-SpectraReward,對 BAGEL 這類 unified multimodal models(UMMs)尤其有意思。做法是讓同一個模型的 understanding branch,為 generation branch 產生的樣本評分,形成 self-reward。這種安排的重點不在模型愈大愈好,而在 reward 與 policy 是否真正對齊;資料指出,這種內部對齊效果有時可追平,甚至超過更大型的外部 MLLMs。

  • 不需要 preference labels,也不需要 reward-model fine-tuning
  • 只用一次 MLLM forward pass,就可計出 training-free reward
  • 把「圖片能否還原 prompt」變成可量化的獎勵訊號
  • Self-SpectraReward 適合 BAGEL 類 unified multimodal models(UMMs)

從結果描述來看,reward 提升時,複雜場景生成質素也同步改善,表示這個訊號不只理論上合理,亦能推動可見的畫面進步。對正在做 text-to-image generation、影像模型強化學習,或想減少外部獎勵模型依賴的讀者來說,SpectraReward 提供了一種更省步驟、但仍保留語義判斷能力的路線。文中提到的模型包括 MLLMs,以及 BAGEL 這類 unified multimodal models。

項目主頁 · GitHub

Categories: 香港大學, 北京大學, 字節跳動, 多模態模型, 模型訓練, Image, 影像模型, txt2img, 香港

[技術文章] Xiaomi-Robotics-U0 小米用世界模型打通機械人

同一個模型兼顧場景生成、影像編輯同機械人操作資料合成,重點唔只係畫面靚,而係多視角一致同可直接餵去訓練策略。

smileybones small

當世界模型式的影像與影片生成能力要落到機械人場景,難題唔止係出圖或出片,而係同一個場景喺多個視角下都要合理,物件幾何要一致,仲要符合唔同 robot embodiment 嘅操作限制。

Xiaomi-Robotics-U0 屬於 world foundation model 路線,針對的正是這類 embodied synthesis 工作:一邊保留大型 image and video generation model 已學到的視覺知識,一邊補上機械人資料需要的可控性與一致性。

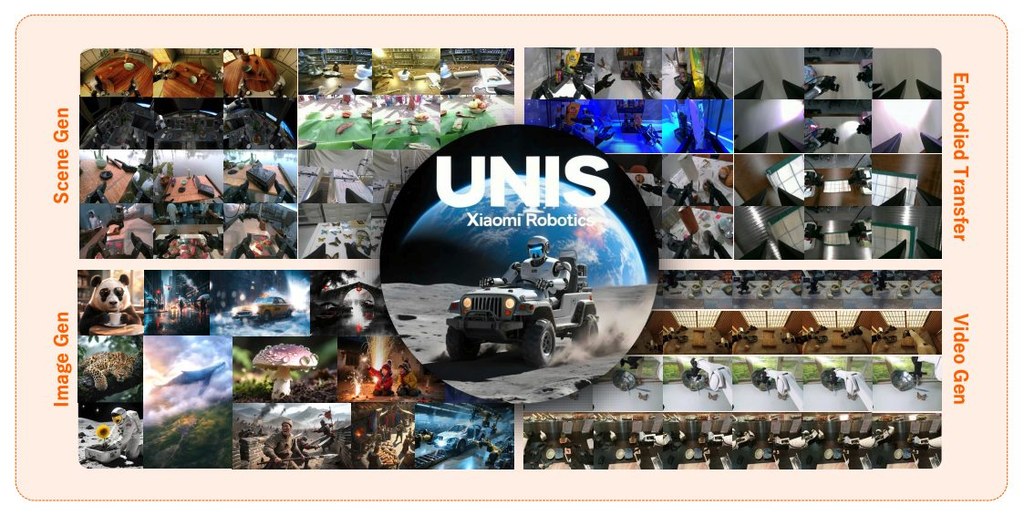
常見做法通常係用有限的機械人資料去微調 foundation model,但作者認為呢種範式容易犧牲大規模預訓練帶來的泛化能力。Xiaomi-Robotics-U0 改用 unified embodied synthesis 設計,把 text-to-image generation、image editing、embodied scene generation、embodied transfer 同 embodied video generation 放入同一個 38-billion-parameter multimodal autoregressive model 聯合優化,將 embodied generation 視為 foundation image and video generation 的延伸,而唔係另一條割裂的任務線。

呢個項目最有用的地方,在於它不只生成好看的資料,而是生成可拿來支援機械人學習的資料。文中提到它首次支援跨多種 robot embodiments 的高品質 multi-view scene generation,亦加入 structured、controllable embodied transfer,做細緻編輯時仍可保留 multi-view consistency 同 interaction dynamics,對要做模擬資料擴增、場景改寫、操作軌跡配套生成的工作流幫助較大。

  • 聯合處理多種任務,減少每個場景各自做模型適配的割裂流程
  • 核心差異在於保住 pre-trained world foundation model 的泛化,同時加入 embodied constraints
  • 支援 multi-view scene generation 與 embodied transfer,重點放在幾何一致性與互動連貫性
  • 生成結果可作為 scalable data engine,服務後續 policy training

效能上,Xiaomi-Robotics-U0 在 single-step 與 sequential generation 任務都做到 state-of-the-art,human evaluations 中於 embodied scene generation 同 transfer 超過 GPT-Image-2.0,embodied video generation 在 World Arena 排名第一。更實際的指標來自真實操作任務:它把 π 0.5 \pi_{0.5} 在 out-of-distribution 情況下的 success rate 由 36.9% 提升到 63.2%,說明這類 world model 不只是內容生成工具,亦開始成為 embodied intelligence 的資料引擎。

文中亦提到完整流程涵蓋 dataset curation、unified annotation pipeline、single-step training、sequential training,以及配合 FlashAR 與 vLLM Integration 的 inference 設計。整體訊息很清楚:作者想證明 foundation world models 可以同時扮演 embodied world models 與合成資料基建,讓機械人訓練不再只依賴昂貴而稀缺的真人示範。

Paper

Categories: 模型, 多模態模型, 視頻模型, 世界模型, 模型訓練, Video, Image, 影像模型, txt2img, Robotic, 軟件, Dataset 數據集, 小米-Xiaomi

Latent-Identity Tuning 人像身份細緻微調

人像生成最怕改少少就變成另一個人。Latent-Identity Tuning 嘗試把臉部特徵拆得更細,令同一身份可在不同提示詞下保持一致。

teaser site

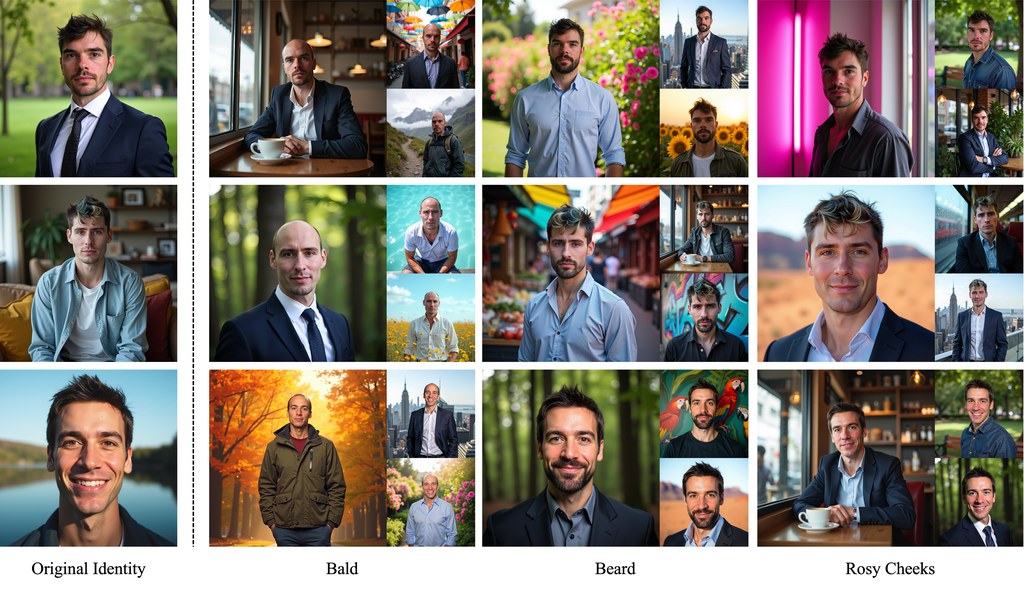
想修改鼻形、加鬍鬚或雀斑,同時又保留同一個人的辨識度,對 text-to-image (T2I) 個人化生成來說一直很難。Latent-Identity Tuning in Text-to-Image Personalization Models 聚焦在這個卡位:不只是改一張圖,而是調整某個人的身份表示,之後可在不同場景中生成同一個經過微調的人。

做法上,輸入人像會先經由預訓練 personalization encoder 轉成一組 identity tokens。研究發現,不同 token 會偏向捕捉眼、鼻、口、頭髮等不同區域或語義特徵,因此可以在這個 identity space 入面尋找有意思的方向,例如鬍鬚、捲髮或其他面部屬性,再沿着方向調整。

  • 直接微調 identity tokens,而不是只在單張圖片上修圖
  • 可做局部、細緻,而且語義較一致的人臉改動
  • 修改後的身份可配合不同 prompts 生成新圖
  • 透過 attention maps 觀察 token 與臉部區域的關係
  • 使用定性與定量實驗檢查局部編輯及跨圖身份一致性

和常見 image editing 相比,這個方法的差異在於它處理的是「身份的潛在表示」。換言之,改動不是鎖死在原圖姿勢、背景或光線,而是把編輯後的身份交給 T2I 模型,在新場景、新描述下仍盡量維持同一個人。

這類方法會較適合需要穩定角色形象的創作者、視覺設計工作流,以及研究人像個人化生成的人。限制上,資料未交代可直接使用的產品化介面或完整模型名單;引用模型方面,內容只提到預訓練 personalization encoder 與 text-to-image model,未列明具體基礎模型名稱。

項目主頁 · Paper

Categories: 數字人, Image, txt2img, 框架

ReChannel:用生成模型做密集預測

同一張圖直接讀出深度、法線、去背甚至文字指向分割,ReChannel把 text-to-image 模型變成實用視覺讀取器。它吸引人的地方,不在於加大模型,而是幾乎只靠輕量 LoRA 與線性頭完成轉向。

demo

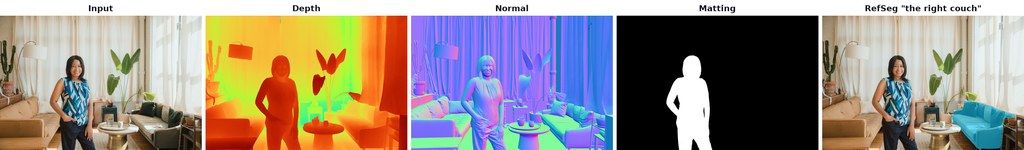
一張 RGB 圖像想同時拿到深度、surface normal、matting 同 referring segmentation,通常意味住要換幾套模型;ReChannel偏偏反其道而行,將預訓練 text-to-image DiT 的空間 token 直接改作密集預測讀出。這不是完整訓練流程釋出,而是偏向 inference/質性展示的 GitHub 項目,定位很清楚:展示 FLUX-Klein 骨幹除咗生圖,亦可以做 pixel-space dense prediction。

它的類型更接近研究型模型讀出方法+推理示範工具,實際解決的是「可否沿用生成模型已有的空間表示,避免為每個密集任務重建一套重型解碼器」。做法上,骨幹維持 frozen,只為每個任務加 LoRA,再配一個 token-local linear head;標量任務頭部大約 33K 參數,surface normals 約 99K,沒有 convolution、沒有 upsampling,也沒有 target-side VAE decoder。

同類方法很多會把功夫放在額外解碼器或多尺度結構,ReChannel的取向剛好相反:盡量把空間結構留在 DiT token field 內,最後只做通道重映射。這種設計夠輕,但取捨亦直接,現有儲存庫沒有完整 benchmark pipeline,姿態估計亦未放入最小示範,所以更適合用來理解方法潛力,而非直接拿來做嚴格橫向比較。

  • 支援單張圖片推理,可輸出 depth、normal、matting、refseg,refseg 需要輸入文字描述
  • 依賴 CUDA GPU,首次執行會自動下載 black-forest-labs/FLUX.2-klein-base-4B 與對應 LoRA、線性頭權重
  • depth、normal、matting 會保留長寬比並可用 horizontal-flip TTA;refseg 固定在 512² 單次前向
  • 已公開的是 demo/inference 版本,不是論文表格所用的完整評測流程

受益最大的人,會是研究 dense prediction、生成模型再利用、或者想測試 LoRA 能否把同一骨幹轉成多任務視覺讀出的團隊。相關模型核心是 black-forest-labs/FLUX.2-klein-base-4B,再疊加每任務 LoRA adapters;對想研究生成模型表示能否外借到視覺理解工序的人,這個項目相當值得留意。

GitHub

Categories: 開源, 香港科技大學, NVIDIA, Stable Diffusion, Image, 影像處理, txt2img, Dataset 數據集

Qwen-Image-Bench:難分高下的是細節

生成圖像模型愈做愈靚,真正難分高下的是細節表現。Qwen-Image-Bench 把評分拆得更細,較容易看清模型在哪些創作場景會失手。

Qwen-Image-Bench dimension framework and representative model outputs

只看一張圖夠唔夠靚,已經不足以判斷 text-to-image (T2I) 模型值唔值得放入創作流程。Qwen-Image-Bench 把焦點放到更貼近創作工作的檢查方式:它屬於評測工具包,同時連同 benchmark dataset 同 judge model,一併處理生成圖像模型難以客觀比較的問題。

這個項目的可取之處,在於它唔係只計語意對齊或整體畫質,而是用 fine-tuned 的 Q-Judger(Qwen3.6-27B)按 5 個階層維度評分,包括 Quality、Aesthetics、Alignment、Real-world Fidelity、Creative Generation,並細分到 56 個 facets。對做品牌視覺、遊戲美術、漫畫分鏡或者要處理文字渲染的人來說,呢種拆法比單一總分更有參考價值,因為你會直接見到模型係構圖、真實感、創意約束,定係文字生成出問題。

部署理解上,它唔係即開即用的網頁服務,而是偏研究與團隊驗證流程的 Python 工具。你要準備好虛擬環境、PyTorch,同埋包含 prompt、image_path、ID 的 CSV/JSON/JSONL 輸入,再透過 judge.py 跑 Qwen/Qwen-Image-Bench;另一條路線是直接用已公開的 benchmark responses 重現排行榜分數。底層推理沿用 ms-swift,跟釋出 benchmark 結果時的設定一致,這點有助減少評測流程前後不一。

  • 支援替任何 T2I 模型打分,較適合做橫向比較
  • 分數結構比一般 benchmark 細,方便定位失誤位置
  • 可重現公開資料集結果,適合研究或團隊內部驗證
  • 使用門檻偏技術向,需要本地推理環境與整理輸入格式

它的取向也很清楚:重點不是提供生成能力,而是提供一把較細緻的尺。代價是評測仍依賴 judge model,本身並不是人手審稿,也未必完全等同最終用戶審美;但對需要批量比較模型、整理回歸測試、追蹤版本變化的團隊,這種一致而可重跑的框架反而更實用。相關模型與資源包括 Q-Judger(Qwen3.6-27B)、Hugging Face 上的 Qwen/Qwen-Image-Bench,以及配套 benchmark dataset。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Qwen, Image, txt2img, 工具, Python, Dataset 數據集

RDM:一步生成影像的新取向

RDM 係一個一步式影像生成研究項目,目標係用一次網絡推理,做出接近多步模型質素的圖像。

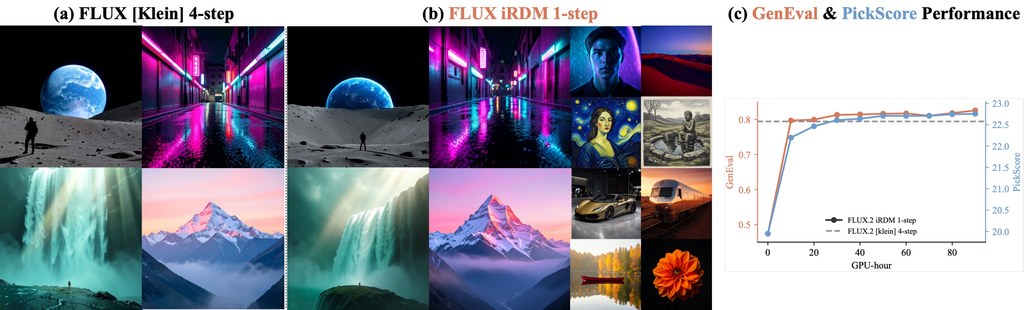
iRDM post-trains four-step FLUX.2 [klein] into a one-step generator at matched quality; GenEval and PickScore climb past

RDM 是一個一步式影像生成研究項目,也是面向 one-step visual generation 的訓練方法。它要解決的問題很直接:把原本需要多次採樣的生成流程,壓縮成一次 network evaluation,仍然盡量保住影像質素。

現有做法通常會依賴 online teacher、adversary,或者追蹤 trajectory 來蒸餾多步生成器;作者認為這類範式訓練成本高、流程複雜,亦容易被單一訊號牽著走。RDM 改用 Representation Distribution Matching,把生成圖與真實圖在多個 frozen pretrained encoders 之下的特徵分佈對齊,核心比較方式是 squared MMD with a Gaussian kernel,同時配合 Nyström attraction、within-batch repulsion,以及 joint image-text law。

這個取向和同類方法的差異,在於它不靠 online teacher、no adversary、no trajectory,訓練邏輯更像直接校準「生成分佈是否接近真實分佈」。作者亦刻意不用單一 encoder,而是用一組 frozen encoders(10 train + 4 held out),再用 proportional Lagrangian controller 平衡各個表示空間,這個設計明顯是想減少模型只迎合某一種評分器的問題。

README 已交代基本理解方式:安裝後可用 ImageNet-256 影像樹做訓練與驗證,也可沿 FLUX text-to-image 路線配合 COCO、GenEval、Pick-a-Pic 做評測;另有 Hugging Face demo 與 checkpoints,可直接看輸出效果。部署上它較像研究型訓練框架,不是即開即用的終端應用,較適合有 GPU 資源、想重現論文結果或做後訓練實驗的團隊。

性能數字有辨識度。RDM 報稱達到 one-step ImageNet state of the art,SW_r14 為 1.30;在 FLUX.2 [klein] 的 post-training 路線中,one-step 模型於 GenEval 達到 0.826,高於 four-step teacher 的 0.794,PickScore 亦升到 22.76,高過 teacher 的 22.58。相關模型與組件包括 FLUX.2 [klein]、open_clip、DreamSim,以及多個 frozen pretrained encoders;整體更適合關注模型訓練、生成效率與影像評測方法的研究或產品項目。

  • 項目類型:研究型訓練方法/框架,重點在一步式影像生成
  • 核心差異:不用 online teacher、adversary、trajectory,改做分佈匹配
  • 測試方式:可用 ImageNet-256、COCO、GenEval、Pick-a-Pic 驗證結果
  • 主要取捨:流程更乾淨,但仍需要資料準備、GPU 資源與完整評測環境
  • 受益情境:想把多步生成器壓成單步模型的研究團隊與影像生成項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型訓練, Stable Diffusion, Image, 影像模型, txt2img, 框架, Dataset 數據集

Page 2 of 3
1 2 3