MrFlow:文字生成圖片提速新路線

MrFlow 用分階段取樣加速 flow-matching 圖像生成,重點是唔使重新訓練模型。它追求高倍提速,同時盡量守住畫面細節。

MrFlow framework

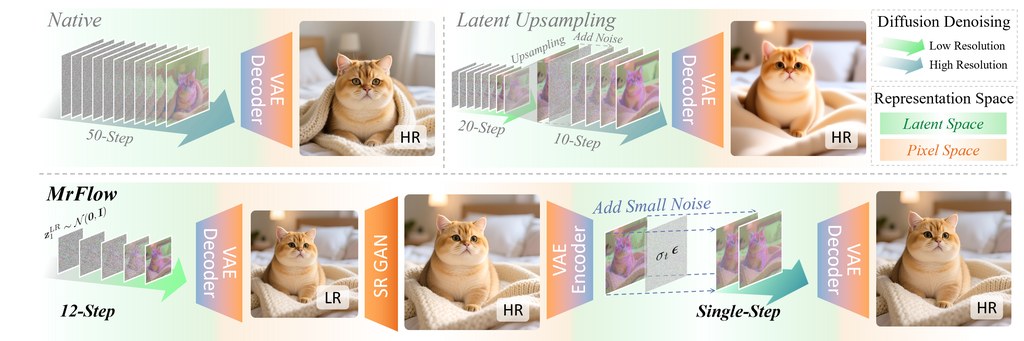
MrFlow 是一個訓練免除的圖像生成加速方法,屬於針對 flow-matching text-to-image diffusion models 的研究原型與實作。它要解決的問題很直接:高解析度出圖太慢,因此先在低解析度完成大部分生成,再用較短的高解析度修補流程補回細節。

現有多解析度加速方法,通常會在 latent space 做上採樣,或者只改動部分區域;作者認為這種固定範式容易帶來模糊感與 artifact。MrFlow 改用 pixel space 的 Real-ESRGAN 做超解析度,之後重新編碼、注入與 scheduler 一致的低強度雜訊,再做短步數 refinement,將昂貴的高解析度 denoising 成本,大幅轉移到較便宜的低解析度階段。

這個項目的取向相當務實,因為它不要求 finetuning、learned upsampler,亦唔需要 model-specific retraining 或 custom kernels,直接建立在 PyTorch、Diffusers 與既有 scheduler 控制之上。部署理解上,它比較像一條可插入現成模型流程的 sampling pipeline:先準備 Diffusers 相容環境、對應的預訓練模型權重,以及 Real-ESRGAN 的 x2 權重,再把 README 內示例腳本的 checkpoint 路徑換成本地設定即可。

效能數字是這個項目的核心賣點。資料指出,MrFlow 在 Qwen-Image 可做到超過 10x end-to-end speedup,論文亦提到相對加速前的 OneIG 差距可控制在 1% 以內;再配合 timestep-distilled models,例如 Pi-Flow 與 FLUX-schnell,整體加速可進一步去到 25x。這種設計也已展示可轉移到 Qwen-Image、FLUX.1-dev、FLUX.2 Klein 與 Z-Image family,代表它不是只綁死單一模型。

  • 類型定位:訓練免除的 staged sampling 加速方法,唔係新底模本身
  • 主要差異:避開 latent space 上採樣路線,改用 pixel space 超解析度加短程高解析度修補
  • 部署重點:依賴 PyTorch、Diffusers、Transformers、Real-ESRGAN,並需自行配置模型與權重路徑
  • 適合場景:要保留畫質、又想縮短生成時間的圖像生成團隊與研究人員
  • 相關模型:Qwen-Image、FLUX.1-dev、FLUX.2 Klein、Z-Image、Pi-Flow、FLUX-schnell

MrFlow 最適合放在已有文字生成圖片流程的項目之中,作為加速層而不是完整替代品。它的限制亦很清楚:仍然依賴外部超解析度模型與既有 backbone 品質,重點在於重新分配算力成本,未必等於所有提示詞、所有畫風都能無代價複製原本高解析度長步數生成的結果。
GitHub · Paper

Categories: 開源, Qwen, NVIDIA, Stable Diffusion, Image, txt2img, Python, 中國

OpenMontage:AI 代理拍片流程

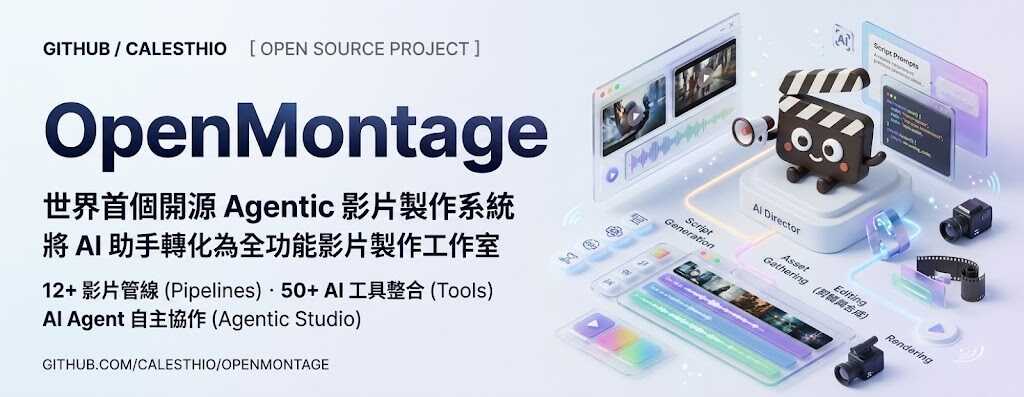
OpenMontage 想把 AI coding assistant 變成自動化影片製作流程。它重點不只生圖做片,亦會搜集真實動態素材再完成剪輯。

影片製作最花時間的,往往不是按下生成按鈕,而是串接研究、腳本、素材、配音與剪接。OpenMontage Studio 是一個由 AI agents 驅動的創意工作空間,處理影片、圖片、音訊、動畫與 3D 內容,亦可從既有素材開始完成單一任務。

它把製作拆成 8 個階段及 1 個審批關卡:Brief、Research、Script、Scene Plan、The Gate、Narration、Music、Compose 與 Render。系統會先整理受眾、时长、語氣與訊息,再研究產品畫面、參考影片及競爭對手,繼而產出附旁白與 B-roll 指示的劇本。The Gate 會列出將使用的素材、模型、旁白及音樂,待確認或修改後才繼續製作。

  • 研究與定位資料會寫入 decision log,保留決策依據。
  • 場景可混合採用現有素材、素材庫、Stock 素材或生成內容。
  • 旁白可按句子加入修改意見,不必重寫整篇內容。
  • 音樂可按氣氛、每分鐘拍數及能量配對,亦可另行生成。
  • 製作可在 OpenMontage Studio、Claude Code 或 ChatGPT Codex 進行。

這種做法適合已有品牌資料、產品錄影或商品素材的團隊,可由一個構思直接建立完整短片,也可只處理配音、音訊清理或視覺生成。代價是製作仍需經過 The Gate 審批,AI 的研究、定位與場景選擇亦不代表最終成品必然準確;創作者仍要核對品牌訊息、素材授權及輸出質素。

GitHub

Categories: 開源, Agentic, 微軟, Video, Image, txt2img, Content Creator, IDE, Anthropic

DanceOPD:多能力影像生成的場景蒸餾框架

DanceOPD 提出 on-policy 生成場景蒸餾方法,將不同影像能力整合到單一模型,同時保持 T2I 與編輯表現。

ByteDance Seed

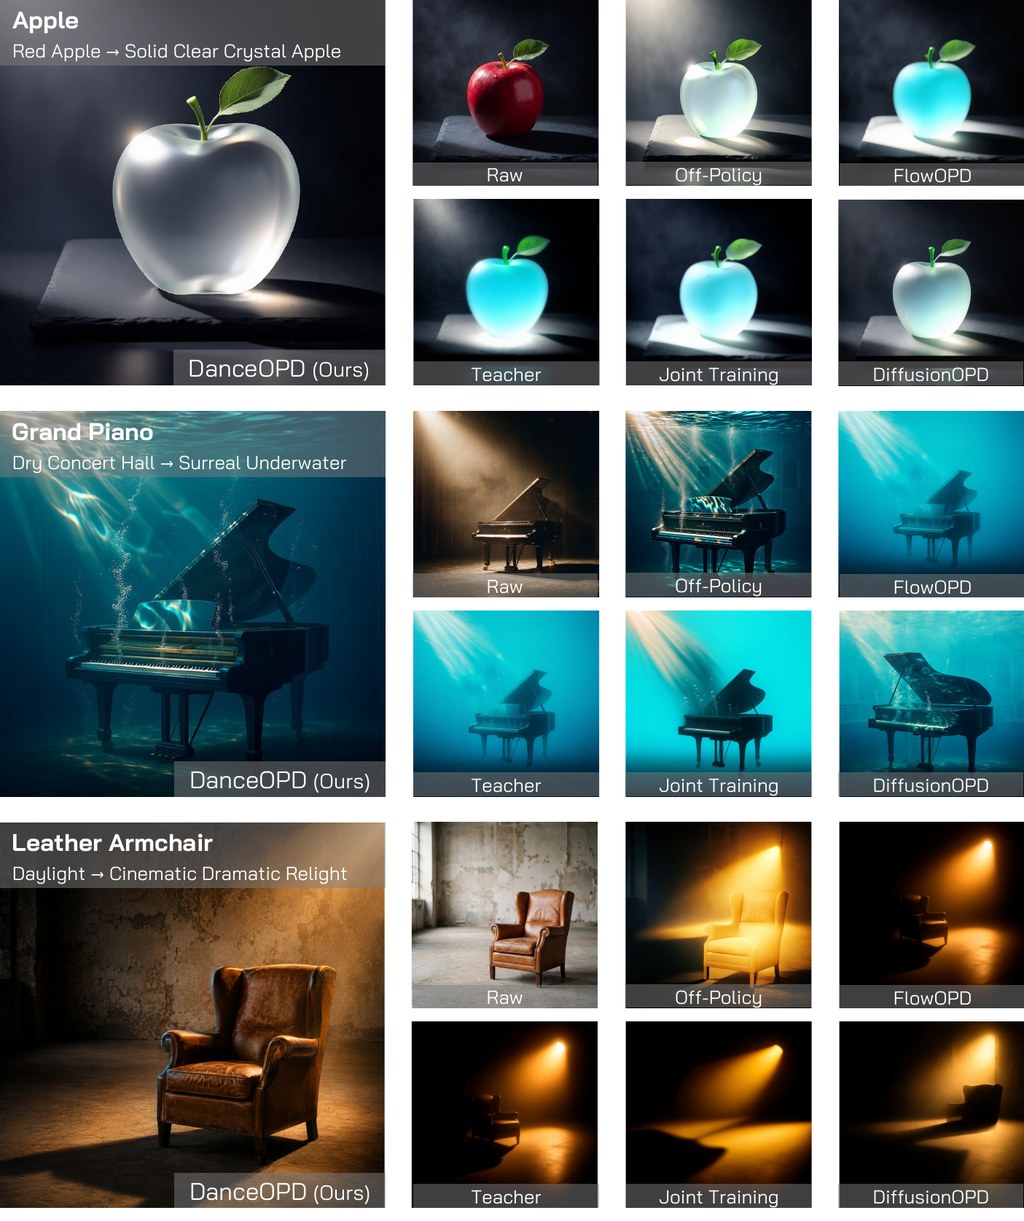
DanceOPD 是一個針對 flow-matching 模型設計的 on-policy 生成場景蒸餾框架,目標是讓單一影像生成模型同時具備文字生成影像(T2I)、局部編輯與全域編輯等多種能力。核心做法是將每個來源能力視為一個速度場(velocity field),然後在學生模型自己產生的 on-policy 狀態上查詢這個場景,再以簡單的速度 MSE 損失進行訓練。

這套方法最值得留意的差異在於 hard-routed 設計:每個樣本只被路由到一個被選中的能力場,並且只查詢一個低噪聲的語義側狀態(semantic query),避免了對多個來源場景做平均而模糊語義身份的問題。同一套框架也能吸收 operator-defined fields,例如 classifier-free guidance,讓引導機制自然融入訓練。

在評估方面,DanceOPD 報告了多項指標,包含 GEditBench-avg 在 T2I + Edit Composition 上達到 5.347、GenEval Overall 達到 0.849 同時保持 T2I 表現,以及 Local + Global Edit Composition 的 5.498、CFG 吸收診斷中 5.833 的最佳值。

這項工作適合關注多能力影像生成整合、蒸餾方法以及 flow-matching 模型研究的開發者與研究者。由於 Code 標示為「Soon」,目前尚未提供源碼或模型下載,因此暫無可對應的安裝或使用步驟可分享。

主要重點:

  • 核心定位:flow-matching 模型的 on-policy 生成場景蒸餾框架
  • 方法差異:hard routing 單一能力場景加單一低噪聲語義查詢,避免場景平均造成的語義模糊
  • 支援能力:T2I、局部編輯、全域編輯,並能吸收 classifier-free guidance 等 operator-defined fields
  • 評估數字:GenEval 0.849、GEditBench T2I+Edit 5.347、Local+Global 5.498
  • 現有狀態:論文可在 arXiv 瀏覽,原始碼尚未公開

項目主頁: https://danceopd.github.io/

Paper: https://arxiv.org/pdf/2606.27377

Categories: 開源, 字節跳動, 模型, 模型訓練, Image, 影像模型, txt2img, 框架, 教學, Content Creator, 深度學習

DiffusionBench:擴散模型評測框架

DiffusionBench 透過統一的 NanoGen 框架,橫向比較 25 種 DiT 方法在 ImageNet 與文字生成圖像的表現,挑戰僅靠 FID 評估擴散模型的舊範式。

DiffusionBench logo

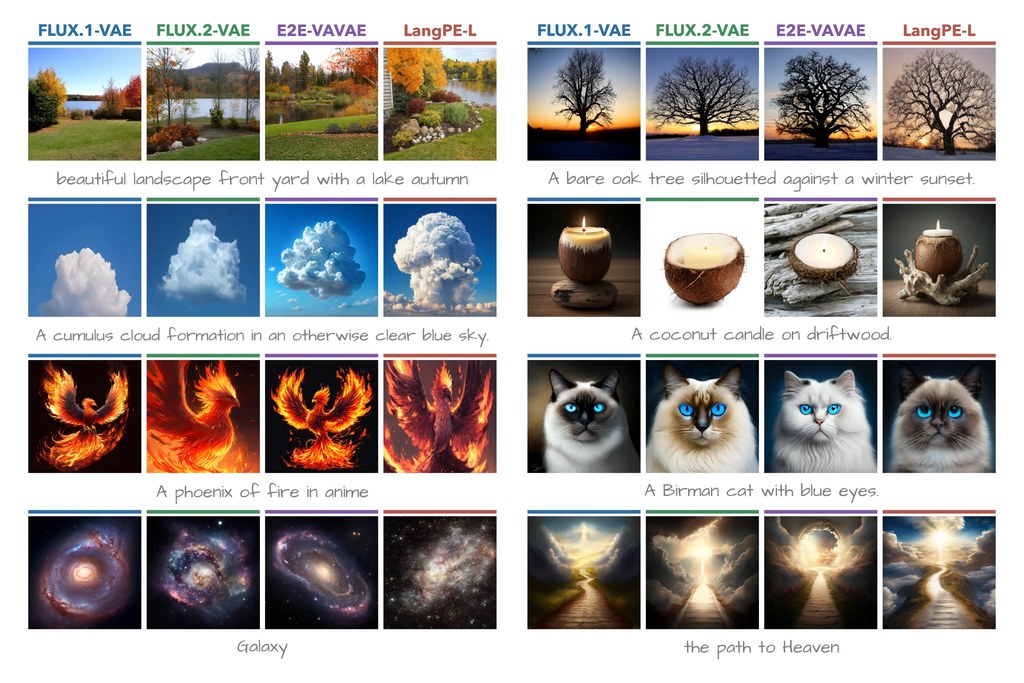
這是一個針對擴散 Transformer(Diffusion Transformers, DiT)研究的基準測試項目(benchmark),核心目的是在 ImageNet 與文字生成圖像(T2I)兩種場景下,對擴散模型進行統一的訓練與橫向評測。舊有做法普遍以 ImageNet 的類別條件生成(class-conditional generation)為單一評測標準,作者批評這種範式已經難以反映生成模型的真實進展,因為 T2I 雖然更貼近實用,卻常被視為過於昂貴或不便而跳過。為此,項目推出 NanoGen 統一訓練框架,並以 DiffusionBench 重新組織評測結構,把 ImageNet 與 T2I 納入同一比較基準。

  • 統一訓練介面:NanoGen 只需約 12 行的配置更改,就能在 ImageNet 與 T2I 之間切換。
  • 跨任務方法比較:系統性收錄並比較 25 種 DiT 方法。
  • 多維度評測指標:涵蓋 FID 等多項 ImageNet 與 T2I 指標。
  • 研究成果已收錄 arXiv 論文(2606.24888),對應的模型權重同步上載至 HuggingFace。
  • 目前版本為 v0.1,作者明確標示仍處於初步階段,並積極招募社群貢獻者。

與單獨的 ImageNet 評測相比,DiffusionBench 的關鍵差異在於同時納入 T2I 任務,藉此揭示方法排名在兩類任務之間並無強相關(no strong correlation),這意味著 ImageNet 上的 FID 提升未必代表 T2I 生成品質同步改善。框架支援 VAE、RAE 與 Pixel space 等不同潛在空間(latent space)的訓練,技術上整合了 REPA-E 與 iREPA 等對比方法,適合 DiT 研究團隊、生成式模型工程師,以及關心基準公正性的學術工作者使用。受惠最大的,是需要評估自家方法在多任務泛化能力的團隊,以及希望避免單一指標誤導的審稿人與研究者。

GitHub: https://github.com/End2End-Diffusion/diffusion-bench

項目主頁: https://end2end-diffusion.github.io/diffusion-bench/

Model: https://huggingface.co/diffusion-bench/diffusion-bench

Categories: 開源, 模型, 模型訓練, Image, 影像模型, txt2img, 框架, 深度學習

CF-World 評測:揭穿文生圖模型的「歸納火雞」盲點

CF-World 以三層反事實框架,測試 T2I 模型是否真正理解因果,而非僅靠記憶統計關聯。

Repository image for jylei16/CF-World

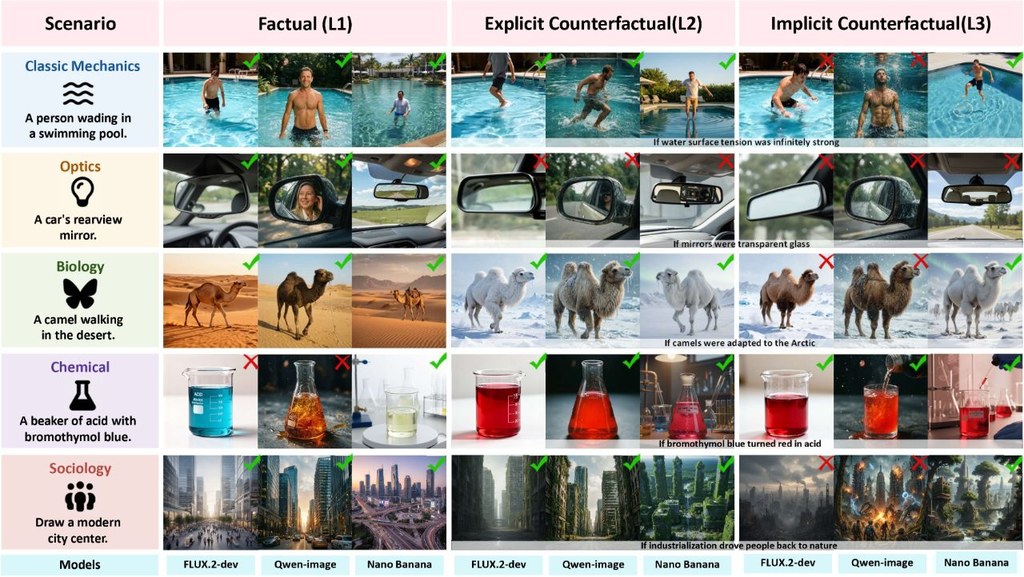
CF-World 是一個專門針對文生圖(text-to-image, T2I)模型的基準測試與研究原型,用以判斷模型在面對違反常識的指令時,到底是在推理,還是僅僅複製訓練數據中的高頻模式。現有的 T2I 模型在日常語境下表現出色,但只要物理法則被刻意改寫,例如要求它們生成「重力反轉」或「光線反向折射」的畫面,便會出現明顯崩潰。CF-World 採用三層遞進設計來暴露這種落差:L1 為事實生成,要求模型按真實世界知識作畫;L2 為顯式反事實(Explicit Counterfactual),同時提供反事實前提與指定的視覺結果,測試模型能否依指令調整;L3 為隱式反事實(Implicit Counterfactual),只給出反事實條件,要求模型自行推導應有的視覺呈現,從而考驗真正的因果推演能力。

為了量化這種落差,項目引入兩項指標:PRR(Prior Resistance Rate,先驗抵抗率)衡量模型擺脫既定視覺慣性的能力,RRR(Reasoning Retention Rate,推理保留率)則檢驗模型在多步驟指令下能否維持邏輯連貫性。儲存庫還包含因果解耦(Causal Decoupling)、屬性解耦(Attribute Decoupling)與去範式化(De-nominalization, De-norm)三條專門評測線,協助研究者區分失敗究竟源自因果變量無法分離,還是源自語言先驗的「概念鎖定」。

在評估對象方面,CF-World 涵蓋 FLUX.2-dev、Qwen-image、Nano Banana 等近期模型,結果顯示 L1 表現良好的模型在 L3 場景中普遍出現一致性急劇下降,說明高維統計先驗正在壓制真正的因果推理。代碼庫結構清晰:eval_questions 收錄預先生成的評測題目,prompt 存放基礎提示詞與反事實規則,scripts 則涵蓋題目生成及基於 VLM 的自動評分(支援 Gemini 與 Qwen3-VL)。對從事多模態模型評測、視覺推理研究或關心模型安全邊界的團隊而言,這個基準提供了一個可重現且分層細緻的測試平台,有助於定位「模型究竟卡在哪個環節」。

📂 Repository Structure

The repository is organized into prompts, pre-generated evaluation questions, and execution scripts:

├── eval_questions/        # Pre-generated evaluation questions (categorized by discipline)
│   ├── physics/           # Physics sub-disciplines (Astronomy, Mechanics, etc.)
│   └── ...
├── prompt/                # Raw base prompts and counterfactual rules
│   ├── physics/
│   └── ...
└── scripts/               # Core execution scripts
    ├── generate_eval/     # Scripts to generate evaluation questions
    │   ├── gemini.py      # Generates standard CF-World questions via Gemini
    │   └── rule_decouple.py # Generates questions for the Causal Decoupling experiment
    └── score/             # Automated VLM-based scoring scripts
        ├── gemini.py      # Standard multi-dimensional scoring using Gemini
        ├── qwen3vl-235b.py# Standard multi-dimensional scoring using Qwen3-VL
        ├── rule_decouple.py # Scoring for the Causal Decoupling experiment
        ├── attribute_decouple.py # Scoring for the Attribute Decoupling experiment
        └── denorm.py      # Scoring for the De-nominalization (De-norm) experiment

GitHub: https://github.com/jylei16/CF-World

項目主頁: https://jylei16.github.io/CF-World.github.io/

Paper: https://arxiv.org/pdf/2606.24548

Categories: 開源, 香港中文大學, 上海人工智慧實驗室, 阿里巴巴, Image, txt2img, 提示詞, 框架, 香港, 安全

n8n 與 ComfyUI 自動化生成本地 AI 視頻

教程展示了AI工具鏈整合的未來趨勢,將碎片化任務轉爲端到端自動化系統,適合想提升創作效率的技術型用戶。若需實作細節,可參考影片中的Docker指令與節點配置截圖。

教程展示了AI工具鏈整合的未來趨勢,將碎片化任務轉爲端到端自動化系統,適合想提升創作效率的技術型用戶。若需實作細節,可參考影片中的Docker指令與節點配置截圖。

n8n with ComfyUI AI Video Automation Local Setup Walkthrough
Categories: ComfyUI, 影像模型, 影像處理, txt2img, 教學

WAN 2.1 VACE 模型的原生支援

1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。 影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)

1.3B 模型採用 Creative Commons 非商業授權,14B 模型則為 Apache 2 授權。

影片詳細展示如何在ComfyUI中下載、載入不同模型,根據顯存選擇合適的模型版本,並調整參數以優化生成效果(如步數、強度等)

  • ComfyUI現在原生支援WAN 2.1 VACE模型,提供1.3B(適合低顯存顯卡)和14B(適合高顯存顯卡)兩種模型。
  • 多種 AI 影片生成工作流程:
    • 文字轉影片(Text-to-Video)
    • 圖像轉影片(Image-to-Video)
    • 影片控制(Video Control)
    • 影片外延(Video Outpainting)
    • 首尾影格生成(First Frame/Last Frame)
Amazing AI Video Natively in ComfyUI - An Introduction to WAN VACE
Categories: 開源, ComfyUI, 數字人, 影像模型, 影像處理, txt2img

MV-Adapter 多視角影像生成

Categories: 開源, 模型, txt2img, 3D

Flux Redux 統一風格 AI 角色教學

利用 Flux Redux 及其相關工具,製作一致風格AI角色同背景教學。重點是藉 Flux LoRa 訓練保持角色面部一致性。教學詳細講解如何使用 Redux Advanced Custom Nodes 控制圖像生成,透過調整 downsampling factor 控制風格變化,並利用 mask 參考圖像控制角色服裝及背景風格。最後,示範咗點樣將生成嘅圖像導入AI影片生成工具,製作動畫短片,實現角色風格一致但服裝同背景多樣化嘅效果。 整個過程強調簡潔易用,並提供實際案例同操作步驟。

利用 Flux Redux 及其相關工具,製作一致風格AI角色同背景教學。重點是藉 Flux LoRa 訓練保持角色面部一致性。教學詳細講解如何使用 Redux Advanced Custom Nodes 控制圖像生成,透過調整 downsampling factor 控制風格變化,並利用 mask 參考圖像控制角色服裝及背景風格。最後,示範咗點樣將生成嘅圖像導入AI影片生成工具,製作動畫短片,實現角色風格一致但服裝同背景多樣化嘅效果。 整個過程強調簡潔易用,並提供實際案例同操作步驟。

Flux Redux Consistent Style Character And Background Easily In For AI Characters
Categories: ComfyUI, txt2img, 教學

Switti 高速 text2img 模型

Categories: 模型, txt2img

Page 3 of 3
1 2 3