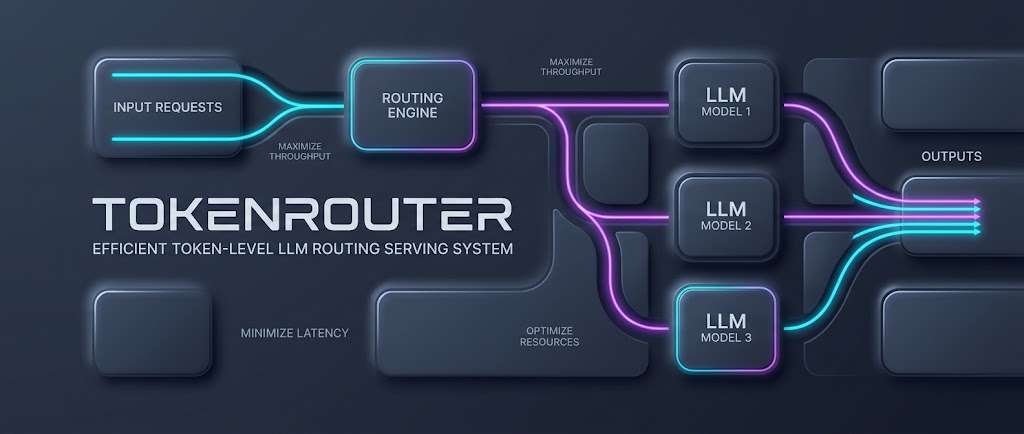
同一個回答需要小型模型快速生成,亦要大型模型處理指定 Token 時,服務系統要同時應付模型切換、不同步解碼和不規則請求。TokenRouter 屬於開源 serving system,專門處理 token-level LLM routing,讓多個模型在單次回應內協作。
開發者只需透過 route()、send() 和 receive() 描述路由邏輯,系統便負責請求交接、Tokenization、Detokenization、批次調度及模型執行。它採用獨立 subserver、非同步 model-centric execution 和 delayed batching,讓快模型繼續解碼,慢模型處理被路由的 Token;Python 3.10、YAML 配置、OpenAI-compatible chat completions 和 Python engine 則提供了較直接的測試入口。
- 支援同一回應內按 Token 或片段切換模型
- 內置 scheduler、model executor 及 CUDA graph 支援
- 可用單機或跨節點配置不同模型
- 涵蓋五種路由算法、三類工作負載及多組模型配對
測試結果顯示,TokenRouter 在不同算法、工作負載和模型配對下,解碼吞吐量較現有系統高 2.01–64.15 倍。這個差距會受硬件、批次規模、路由頻率及模型組合影響,不能直接視為所有場景的固定提升;項目提供的 Qwen3-0.6B 與 Qwen3-32B 配置,較適合用來理解小型與大型模型協作的流程。
需要研究 token-level routing、測試推理工作流,或營運多模型服務的團隊會較容易受益。TokenRouter 把路由策略與執行引擎分開,保留較大彈性,但亦意味着使用者仍要自行設計算法、準備模型節點和調校分散式通訊,並非即插即用的模型服務平台。