SSync 用選擇式蒸餾改善影片物件分解

SSync 針對影片物件分解常見的對齊成本高、訊號互相拖累問題,提出更精準的學習方式。它不是改整套架構,而是補強 slot-based 方法的弱點。

SSync

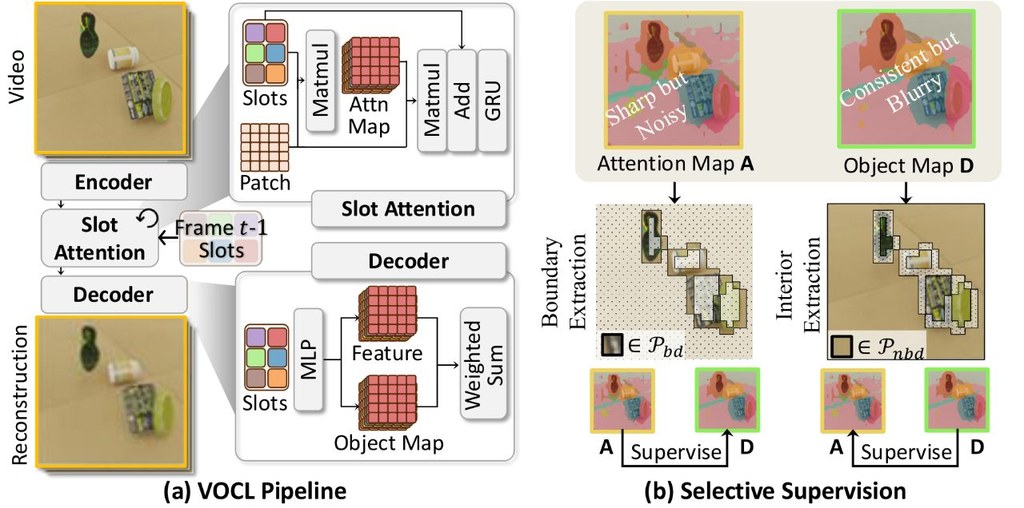
現有的 video object-centric learning(VOCL)多數沿用 slot-based frameworks,通常建基於 reconstruction-driven encoder–decoder architectures:encoder 產生 attention maps,decoder 產生 object maps,再嘗試把兩者對齊。近年的 dense alignment strategy 會對所有 spatio-temporal patches 做 contrastive learning,但這種全對全對齊會把 encoder 的雜訊和 decoder 的模糊邊界一併放大,計算量亦會升到 quadratic complexity,影片一長就更難擴展。

SSync(Selective Synergistic Learning)屬於一個可插入現有流程的 PyTorch 學習模組,目標是改善影片中的物件分解質素。它不是強迫所有 patch 全面一致,而是只挑選較可信的訊號做 mutual-distillation:用 encoder 幫手修邊界,用 decoder 清理物件內部雜訊,方向相當明確。

這項目把「全部都對齊」改成 selective distillation,並透過 pseudo-labeling 把成本降到 linear complexity。作者亦加入 transitive pseudo-label merging,處理 slot redundancy,將時序上反覆重疊的 slots 合併,減少模型把同一物件拆成多份的偏差。

如果你本身有研究 Slot Attention、影片分解、無監督物件發現,這項工作相當值得細看;如果你只是想快速試概念,亦可直接留意作者提供的 PyTorch implementation、Hugging Face 權重和 project page。它屬於 plug-and-play module,較適合已有 VOCL 基礎模型的人接入比較,而不是給完全零基礎讀者當成獨立應用程式。

  • 核心問題:dense alignment strategy 計算昂貴,亦會傳播 encoder 與 decoder 各自的錯誤
  • 核心方法:Selective Synergistic Learning 只蒸餾可靠線索,分開處理 boundary refinement 與 interior denoising
  • 結構補強:加入 transitive pseudo-label merging,減少 slot redundancy
  • 論文聲稱:可提升 decomposition quality,並對 slot configurations 有較強 robustness
  • 相關技術詞:VOCL、slot-based frameworks、Slot Attention、mutual-distillation、pseudo-labeling

整體來看,SSync 的價值不在於另起爐灶,而是在既有 slot-based video learning 範式上,直接指出 dense patch alignment 的兩個痛點:錯誤傳播與計算擴張。對研究型讀者而言,這比單純再堆模型容量更有意思;對工程導向團隊而言,它也提供了一個較容易插入現有項目的改良方向。
GitHub: https://github.com/wjun0830/SSync

項目:https://wjun0830.github.io/SSync/

Categories: 開源, 模型, 視覺模型, Video, 框架, IDE, Python, 編程, 深度學習

MiniMax-M3:開源多模態模型新選擇

MiniMax-M3 已在 Hugging Face 上公開下載。這模型聚焦多模態輸入與模型部署整合。

Og image

MiniMax-M3 是 MiniMaxAI 放上 Hugging Face 的模型。主要提供模型推理,image、video、tool_call 及 think 等標記,顯示它很可圍繞多模態互動、工具調用與對話生成能力而設計。

這項目的用途是把文字、圖片或影片訊息放進同一套模型流程中處理。

值得關注的在於它不只像傳統文字模型那樣處理純文字,還預留了工具調用與多種內容標記格式。對開發 Agentic workflow、聊天助理、內容理解流程的人來說,這類設計可減少自行定義輸入格式的工夫,亦方便把不同媒體資料放進同一條處理鏈。

重點可先看以下幾點:
– 支援 image、video 等多模態標記
– 具備 tool_call 結構,適合工具調用場景
– 可用於聊天、內容理解與自動化互動流程

若你是開發者、研究者,或想找可整合多模態能力的模型,MiniMax-M3 有一定參考價值。至於效能、模型尺寸、硬件需求與基準測試,暫時未有完整列出,使用前宜先核對 Hugging Face 頁面的更新資訊。

項目: https://huggingface.co/MiniMaxAI/MiniMax-M3

Categories: 開源, 模型, 多模態模型, Video, Image, MiniMax

ActWorld 讓世界模型學懂互動

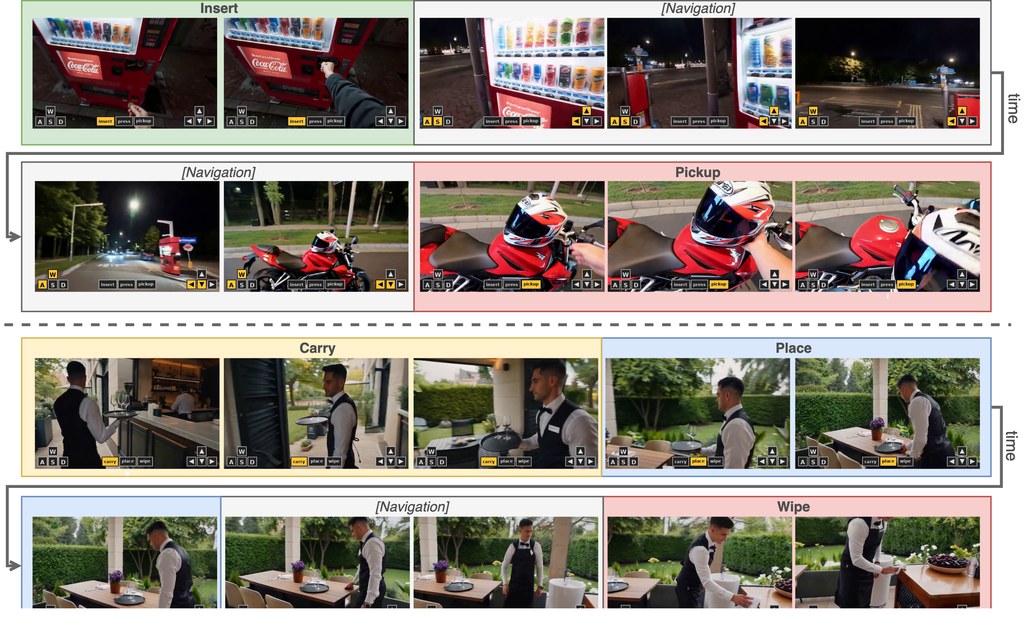
ActWorld不只可移動視角,亦能在生成過程中操作物件。它把導航與互動放入同一個 Interactive World Model。

Og image

ActWorld 是一個 Interactive World Model,目標是把「可四處觀看的世界」推進到「可以即時操作的世界」。以往不少世界模型主要支援移動、轉向、環視等導航動作,對場景中的物件互動支援有限;這個項目則加入中途操作物件的能力,例如拾取、搬運、放置,令同一次 rollout 不只是在場景中行走。

這個項目想處理兩個核心問題:一是缺少高質素的人與物件互動數據,二是模型容易忘記早前發生、但會影響之後物件狀態的關鍵畫面。為此,團隊建立了 100K interaction video dataset,並以 chain-of-thought reasoning 產生 per-chunk captions;同時提出 hierarchical action-aware memory 和 persistent memory bank,讓模型按互動重要性保留歷史資訊,減少 action-forgetting。

使用時,讀者可先從項目頁面的 Paper、Code、Video 和 Comparisons 了解能力範圍。從內容描述判斷,ActWorld 適合研究 Interactive World Model、Computer-use agents(CUAs)相關模擬環境、機械人互動、或需要長時序場景生成與控制的團隊參考。

  • 在單一模型內同時處理 long-horizon navigation 與 object interaction
  • 透過 100K interaction video dataset 補足互動數據不足
  • 用 hierarchical action-aware memory 保留較重要的互動歷史
  • 以 persistent memory bank 追蹤事件更新與物件身份

按頁面說明,實驗結果顯示它在不犧牲 viewpoint control 的情況下,interaction fidelity 明顯優於只做導航的 baseline。現階段公開資訊以研究展示為主,若想深入理解效果,最應留意 Comparisons 及論文中的評測設定與限制。

項目: https://interactwm.github.io/ActWorld/

Categories: 開源, 騰訊, Agentic, AI productions, 模型, 多模態模型, 世界模型, Video, Dataset 數據集

Dataset:EgoCS-400K 補足遊戲世界模型數據缺口

這是一個為 World Models 準備的大型第一身遊戲數據集,重點是把影片、操作、狀態與文字描述對齊。

EgoCS-400K dataset overview

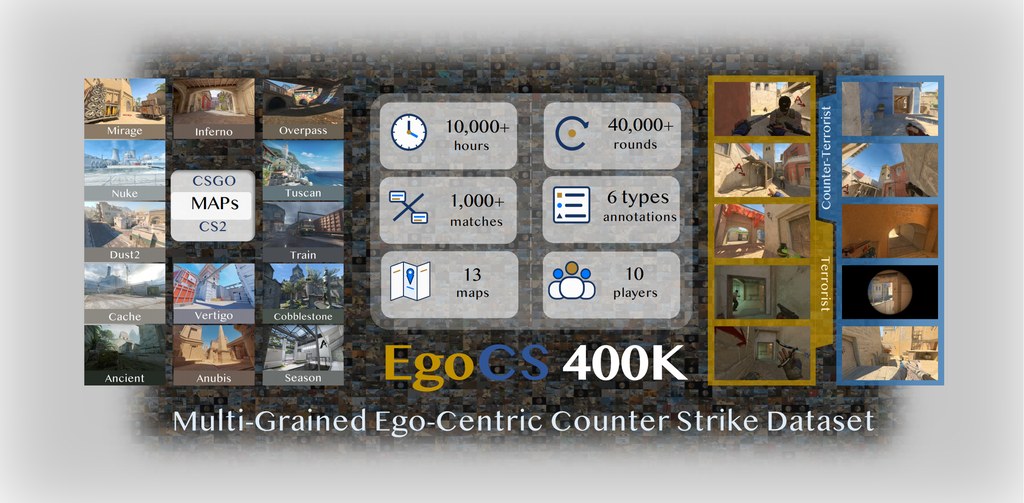
現有做法多數依賴 captioned videos、機械人數據,或模擬器軌跡來訓練 World Models,但前者缺少可執行動作與可靠狀態,後者又常受成本、場景規模或真人互動不足限制。EgoCS-400K 就是針對這個缺口而設的 Dataset 數據集,用公開的 Counter-Strike / CS2 demo 重建第一身視角,將影片、控制輸入、遊戲狀態與語言描述同步整理。

這個項目最核心的價值,不只是「有很多影片」,而是把 replay-grounded 資料做到 tick-level telemetry 對齊。資料同時包含 keyboard/mouse inputs、atomic actions、protected action chains、DP-based temporal segments,以及 multi-grained video-language captions,令模型不只看到畫面,還能追蹤玩家當下做了甚麼、為何畫面會變。

官方資料顯示,它涵蓋超過 400,000 段 first-person videos、10,000 小時以上 gameplay、1,000 多場比賽、40,000 rounds、13 張地圖,規模相當大。它支援的任務亦很明確,包括 action-conditioned future prediction、state- and event-aware scene rollout、replay-grounded captioning,以及 agent egocentric action understanding。

想了解內容,可先用公開 viewer 直接查看樣本,再按需要處理影片;若要生成 VLM captions,才需要 API key。較適合研究 World Models、Gaming Agent、Computer-use agents(CUAs)相鄰方向、影片理解,或想研究人類決策與視角變化如何連動的開發者。

  • 類型屬於 Dataset 數據集,主要解決互動式 World Models 缺乏高質素「影片-動作-狀態-語言」對齊資料的問題
  • 舊範式依賴 web video、robotics data 或 simulator traces,各自欠缺狀態、規模或真人軌跡
  • 辨識度最高的設計,是 replay-grounded、tick-level telemetry 與多粒度標註放在同一條時間線
  • 適合做未來畫面預測、事件感知生成、第一身動作理解與 captioning 研究
  • 相關方向與模型包括 World Models、vision-language-action models、video generation models、Gaming Agent

如果你只想找一般遊戲影片數據,EgoCS-400K 可能顯得偏研究型;但若你在意動作如何驅動畫面與事件,這個項目的資料結構明顯比普通影片庫更有分析價值。它未必直接等於完整訓練方案,但作為高對齊、高時間解析度的基礎數據,定位相當清晰。

GitHub: https://github.com/EgoCS-400K/Dataset

Paper: https://arxiv.org/pdf/2606.18180

Categories: 開源, 香港城市大學, Agentic, 多模態模型, 世界模型, 模型訓練, API, Video, Robotic, IDE, , 動畫, Dataset 數據集

Memento:把長片段角色一致性補回來

Memento 針對多鏡頭長影片的角色走樣問題,改用記憶重建去約束生成。它把連貫性和身份一致性一起處理,適合故事式影片生成。

Teaser

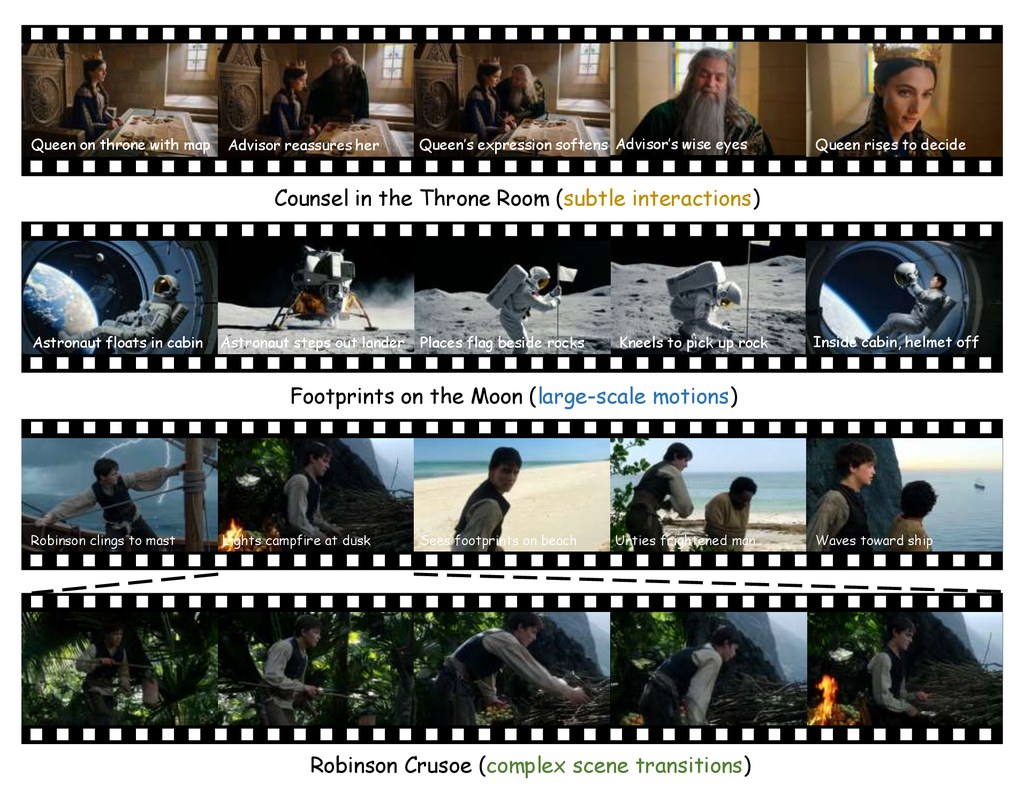
Memento 是一個影片生成框架,重點解決長篇、多鏡頭故事影片中角色外觀容易前後不一致的問題。傳統做法多半只顧下一段鏡頭看起來合理,Memento 則把「能否從記憶重建角色」當成身份是否被保留的檢查方式。

它的做法是把全局故事描述、每個 shot 的文字提示,連同歷史記憶一起送入生成流程,逐鏡頭自回歸地產生影片。使用時可準備對應格式的 JSON 故事腳本,再配合提供的權重與基礎模型做推理;項目也支援訓練與輸出完整影片。

GitHub: https://github.com/ernie-research/Memento

項目: https://ernie-research.github.io/Memento/

Categories: 開源, Agentic, 模型, 視頻模型, 模型訓練, Video, 框架, , 百度

JoyAI-VL-Interaction 把影像助手變主動

這不是等你發問的聊天模型,而是持續看畫面、自己判斷何時出聲的互動項目。

JoyAI-VL-Interaction overview

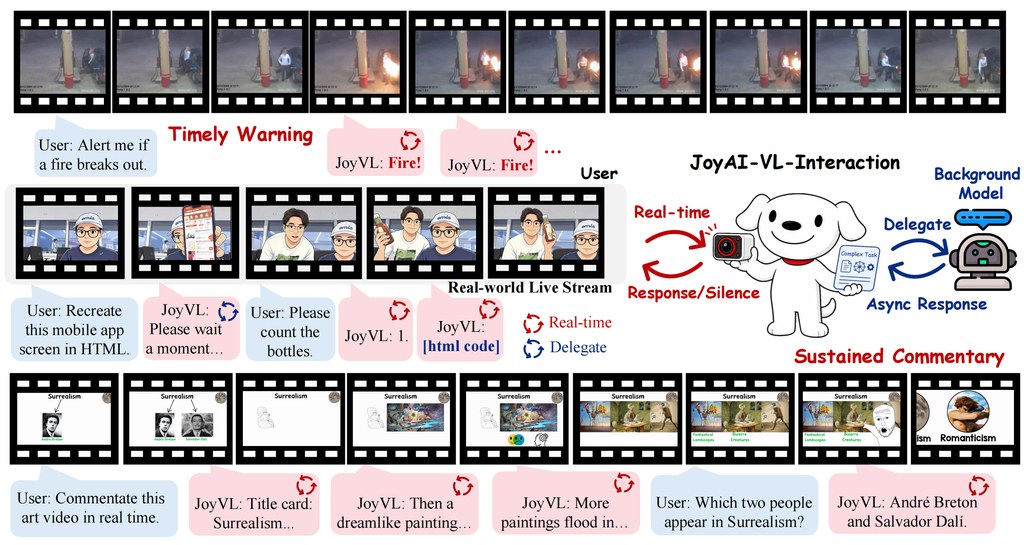
現時多數視覺語言模型仍然沿用 turn-based 問答範式:用戶問一句,模型答一句;就算放進視像通話或直播介面,底層仍是被動回應。JoyAI-VL-Interaction 直接挑戰這個做法,改成持續觀看、按秒判斷要沉默、回應,還是把難題交給背景模型處理,目標是把 VLM 從「被問先答」推向即時互動。

這是一個多模態模型可部署系統項目,想解決的不是普通問答,而是「畫面中的關鍵一刻不會等人發問」這個問題。技術報告提到它是 8B vision-first 模型,支援 real-time video-language interaction,並配合 time-aligned interaction data、training recipe 與完整系統,重點放在時間感、主動觸發與持續在線。

如果你想理解它是否適合自己,最容易的測試場景是把 webcam、直播畫面或監控串流接入,觀察它會否在有事件時主動開口,而不是每次都等指令。這種模式較適合直播助理、居家提醒、遠端看護、商務示範,甚至要一邊看影像一邊調用 API 或 agent 的流程。

  • 核心改動是由問答式互動,轉向 watch-and-do 式互動
  • 模型每秒自行決定沉默、回應或 delegation
  • 系統可接駁 ASR、TTS、memory、API 與其他 agent
  • 報告稱可長時間處理連續影片,延遲維持在 sub-second
  • 人工評分比較中,對 Doubao 與 Gemini 的質量與時機掌握都有明顯優勢

創新位不只在模型本身,也在整個開放堆疊一起釋出:模型、數據、訓練方法與部署系統放在同一個項目脈絡,方便研究者與開發者沿原路線延伸。相關模型與組件包括背景大模型、API、agent,以及文中對比的 Doubao、Gemini;若完整開源內容如期提供,這個項目會對即時多模態互動研究有相當高參考價值。

GitHub: https://github.com/jd-opensource/JoyAI-VL-Interaction

項目:https://joyai-vl-video-future-academy-jd.github.io/JoyAI-VL-Interaction/

Categories: 開源, 字節跳動, 文字轉語音, Agentic, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, OpenAI, Gemini, API, Video, Image, 工具, IDE, 語音

MiniMax Mavis:多 Agent 協作處理長任務

MiniMax 將 Agent 升級為 Mavis,主打多 Agent 團隊協作。它瞄準長時間、步驟多、需要覆核的工作流程。

Og image

MiniMax 把原有 Agent 升級並命名為 Mavis,重點是加入 Agent Teams,讓多個 Agent 在桌面版同時運行,並以不同角色分工合作。這個方向主要處理單一 Agent 面對長任務時容易同時做執行者與裁判、資料整理與事實核對混在一起的問題。

過去把一個複雜要求直接交給單一 AI assistant,回覆速度可以很快,但當內容需要最新資料、來源整理、格式輸出與結果驗證時,流程便容易失焦。Agent Team 的做法是把任務拆成前台與後台、有驗收、有記憶的工作流;用戶仍然只需輸入一個要求,系統再判斷是否拆解、哪些角色可並行、哪些結果需要覆核。

對一般用戶而言,這項目最易理解的用法,是把它視為一個可分工的 AI 工作團隊。若你要處理長篇內容整理、跨格式輸出,或需要連續跟進的知識工作,Mavis 會比單一 Agent 更合適;如果只是一次性的小任務,官方亦暗示未必需要動用 Agent Team。

  • 支援多個 Agent 並行,適合長時間與複雜任務
  • 可建立不同角色分工,提升整理、驗證與交付流程
  • 用戶只需提供一次指令,系統會自行判斷是否拆解任務
  • 整合 TokenPlan 與 Agent Plan,CLI、API、Agent 共用訂閱與 credits

另一個更新是把 TokenPlan 與 Agent Plan 合併成單一訂閱,涵蓋 CLI、API、Agent,以及 M2.7、music、video、voice 等能力,credits 亦可共享。對已同時訂閱兩個計劃的用戶,官方表示會補送一個月會籍。這次內容未見具體跑分或量化基準,重點更偏向產品工作流與使用體驗的重整。

項目: https://www.minimax.io/blog/minimax-agent-team-long-running-1779893953

Categories: Agentic, AI productions, API, Video, 工具, 線上服務, IDE, MiniMax

MiniMax Hub:本機優先的多模態創作工作站

MiniMax Hub把文案、影像、影片與配音流程放進同一個創作畫布。重點是本機優先,素材可留在自己電腦。

MiniMax Hub

MiniMax Hub 是一個 Multimodal Creative Agent,定位像 AI 創作工作站,不只是聊天工具。它把 Copy Generation、Image Creation、Video Editing、Audio & Voiceover、Auto Packaging 與 Multi-format Export 整合在同一個流程,讓用家由想法到成片可在一處完成。

它支援 macOS 與 Windows 下載,輸入簡報、文字想法,或直接加入本機素材後,主代理會先理解創作目標,再做 Smart task decomposition,之後交由多個 agents 並行處理文案、視覺與音訊。用家仍可手動選模型,亦會在關鍵節點收到確認,避免流程完全黑箱。

這個項目在於把創作流程保存成可重用的 Skills。系統會隨工作過程累積你的做法與風格,之後可重複套用;如果需要,也可從 MiniMax Skills Market 啟用現成 Skills 或外掛。對經常製作短劇、電商內容、品牌 TVC 與廣告素材的團隊來說,這類流程重用能力相當實用。

  • 本機優先設計,頁面明確指出 local files stay on your machine
  • 單一畫布整合腳本、分鏡、影片、音樂與剪輯流程
  • 支援資產管理與 batch generation,可一次產出多個版本
  • 代理會自動分解任務,並在關鍵步驟要求人工確認
  • 可把工作流程沉澱成 Skills,逐步累積個人或團隊方法

MiniMax Hub較著重工作流編排與創作協作,而不是單一模型能力展示。網站未列出具體性能分數或公開評測結果,因此較適合把它理解為面向內容製作的本地化 AI 工具平台。文中未提供明確模型清單,只提到會自動匹配最合適模型。

項目: https://hub.minimax.io/

Categories: Agentic, AI productions, 模型, 視覺模型, 多模態模型, 視頻模型, Video, Image, Audio, 軟件, Mac, 語音, Win, 音樂, Skill 技能

Nemotron:NVIDIA 打造 Agentic AI 模型家族

Nemotron 不只是單一模型,而是一套面向 agentic AI 的開放模型與訓練資源。由邊緣裝置到資料中心,都有對應版本。

Watch the Nemotron Overview

Nemotron 是一個面向 agentic AI 的模型家族加開發資源項目,重點不是只放出權重,而是連 training recipes、deployment guides、資料準備與 use-case examples 一併提供,目標是縮短由研究到部署的距離。對想建立 AI agents 的團隊來說,這種整理方式比單獨下載模型更實用。

這個項目最實際的看法,是它把不同算力環境分得很清楚:Nano 針對 edge 和 PC,Super 主打單 GPU 高吞吐,Ultra 面向 multi-GPU datacenter applications。若你想先試概念,可由 Hugging Face 上的 Nemotron 模型開始,再按項目內的指引查看對應版本的訓練與部署資料。

創新點在於它不只講文字模型。Nemotron 3 Nano Omni 是 30B-A3B hybrid Mamba-Transformer MoE,原生支援 text、image、video、audio,定位為 agentic AI 的 multimodal perception sub-agent。這代表它較像多模態代理系統中的感知核心,而不只是一般聊天模型。

項目內容亦涵蓋 curate/、data prep/、sdg/ 和 translate/,即是連資料整理、Synthetic Data Generation (SDG) 與 corpus translation 都納入流程。這種由數據到模型再到部署的完整鏈條,對企業、研究團隊,以及想建立可重複流程的開發者尤其有吸引力。

  • 提供 Nemotron Nano、Super、Ultra 等級,對應不同硬件規模
  • 涵蓋 training recipes、deployment guides、資料處理與 SDG
  • Nemotron 3 Nano Omni 支援文字、影像、影片、音訊多模態輸入
  • 可配合 TensorRT-LLM 與 NIM microservices,部署彈性較高
  • 適合 agentic AI、Computer-use agents、企業內部 AI workflow 測試

如果你想找的是一個可直接抄答案的成品,Nemotron 未必是最快捷的選擇;但若你需要一套可追溯、可調整、可延伸的開放模型項目,它的結構相當完整。現有資料顯示它更偏向給認真做產品化或研究驗證的人使用,而不是單次玩票式體驗。

GitHub: https://github.com/NVIDIA-NeMo/Nemotron

Categories: Agentic, AI productions, 模型, 多模態模型, 模型訓練, NVIDIA, Video, Image, Audio, 工具, Anthropic, AGI

VisualClaw:會進化的視覺代理

VisualClaw 不只是接駁模型的工具,還把記憶、技能與影片處理串成可持續改良的代理系統。

VisualClaw icon

現時不少 vision-language agents 主要靠固定提示、整段影片送入模型,或者一次性工具調用去完成任務;作者認為這種 fixed scaffold 容易令延遲、成本同提示長度一齊上升,而且部署後幾乎唔會自己累積經驗。VisualClaw 因而提出一個 modular multimodal agent system,夾在 Claude Code、Codex、OpenClaw 同上游 LLM providers 之間,加入 retrieved memory、skill bank、self-evolution、video processing 同 evaluation hooks。

這個項目屬於框架兼工具型基建,重點唔係再訓練一個新模型,而係幫 Computer-use agents、tool-using vision-language agents 更有效處理影片、工作空間同多輪任務。配套的 VisualClawArena 則是獨立 benchmark/data release,收錄 200 個 scenario,要求代理真正在 workspace 內用影片證據、文件、動態更新與 executable checks 解題,補回一般 video-QA benchmark 對工具使用情境測試不足的缺口。

把它當成 gateway proxy,用熟悉的 OpenAI 或 Anthropic 相容介面接到現有 agent workflow,再逐步打開 skills、memory、video cascade 等模組。對已經在用 Claude Code 或 Codex 的團隊,這種接法尤其實用,因為毋須由零重寫整個代理流程。

  • 核心結構清楚:gateway design 加上 pre/post hooks,方便在提示前後插入技能、記憶與評測。
  • 創新位具體:以 hybrid encoding 處理 streaming video,配合 cascaded gate、keyframe context、hot/cold top-k injection,目標是壓低成本而保留關鍵視覺證據。
  • 會累積經驗:self-evolution 會根據失敗回合與成功記憶更新 skill bank,唔係每次都由同一套靜態提示開始。
  • 評測唔只看答對:VisualClawArena 把多輪問題、影片、workspace 操作同評估輸出綁埋一齊,更接近真實代理任務。

在 4 個 video-QA benchmarks、2 個 VLMs(Gemini 3 Flash、GPT-5.2)上,VisualClaw 對 full-frame upload 的每題 API 成本平均可減 98%,相對 offline uniform 8 frame baseline 亦再降 25.9%,同時多數設定下準確率有提升。到 VisualClawArena,配合 Codex(GPT-5.5)與 Claude Code(Sonnet 4.6)等 backend,macro accuracy 分別提升 2.9% 同 3.2%;如果你關心的是可插拔代理基建、多模態工作流,或者想為 live vision 與影片任務加上可持續進化能力,這個項目比單純模型包裝器更有研究同落地價值。

GitHub: https://github.com/UCSC-VLAA/VisualClaw

項目: https://ucsc-vlaa.github.io/VisualClaw/

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, OpenAI, Gemini, API, Video, 框架, Vibe Coding, 工具, IDE, Mac, 編程, OpenClaw, Anthropic, Skill 技能

Page 18 of 21
1 16 17 18 19 20 21