從影片創建 4D(動態 3D)場景 CAT4D 利用各種資料集組合上訓練的多視圖視訊擴散模型,以任何指定的資訊和時間下實現新的視圖合成來實現穩健的 4D 重建。
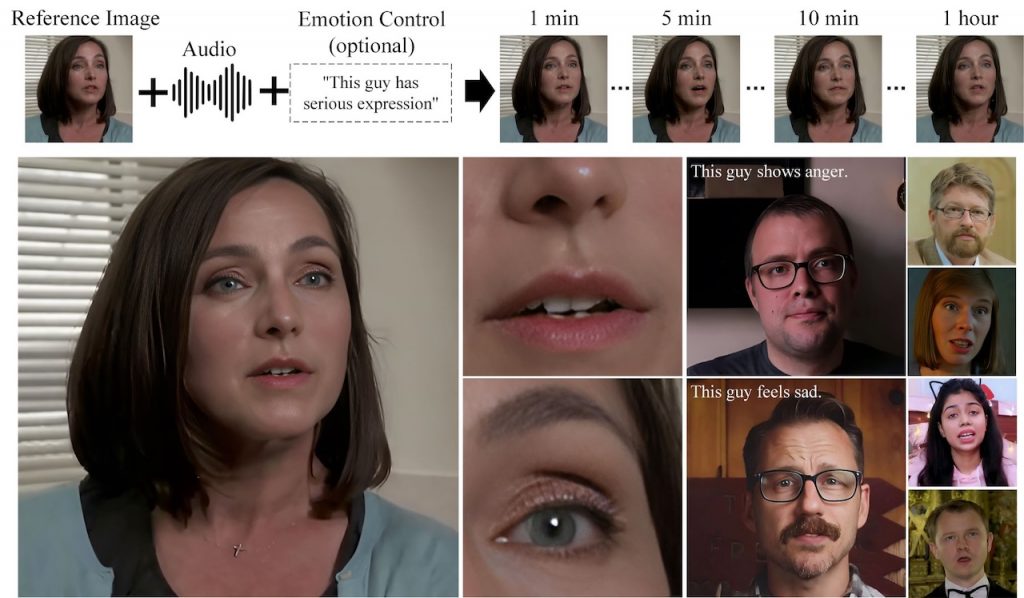
GitHub - fudan-generative-vision/hallo2: Hallo2: Long-Duration and High-Resolution Audio-driven Portrait Image Animation Hallo2: Long-Duration and High-Resolution Audio-driven Portrait Image Animation - fudan-generative-vision/hallo2
DH-Live实时直播数字人,全新商用项目开源,超低显存占用,人人可用!

DiffSynth Studio 是個擴散引擎 重構了文字編碼器、UNet、VAE等架構,保持與開源社群模型的相容性,同時增強運算效能。
GitHub - THUDM/CogVideo: Text-to-video generation: CogVideoX (2024) and CogVideo (ICLR 2023) Text-to-video generation: CogVideoX (2024) and CogVideo (ICLR 2023) - THUDM/CogVideo
免費計劃 - 每月 30 調短片 Dream Machine 可根據 Luma AI 的文字和圖像快速製作高品質、逼真的視頻
Stable Diffusion Comfy-UI 為基礎 一種突破性的技術已經出現,它有望徹底改變我們處理視訊動畫和視覺效果的方式。

PromeAI – 使用終極 AI 藝術生成器釋放您的創意潛力。將草圖轉換為逼真的照片和高品質影片。從草圖、照片或文字生成令人驚嘆的 AI 藝術、3D 渲染、插圖、繪畫、標誌、動漫、逼真照片和影片。

PromeAI – 使用終極 AI 藝術生成器釋放您的創意潛力。將草圖轉換為逼真的照片和高品質影片。從草圖、照片或文字生成令人驚嘆的 AI 藝術、3D 渲染、插圖、繪畫、標誌、動漫、逼真照片和影片。
PromeAI – Free AI art generator : Bring creativity to life
PromeAI – Unleashing Your Creative Potential with the Ultimate AI Art Generator. Transform sketches into realistic photos and high-quality videos. Generate Stunning AI Art, 3D Renderings, Illustrations, Paintings, Logos, Anime, Realistic Photos, and Videos from Sketches, Photos, or Text.
【零門檻】1個AI工具,解放設計❗️|建築設計/室內設計/電商設計/遊戲設計|AI TOOLS FOR DESIGNERS

FMA-Net: Flow-Guided Dynamic Filtering and Iterative Feature Refinement with Multi-Attention for Joint Video Super-Resolution and Deblurring Joint Video Super-Resolution (SR) and Deblurring.
「MS- Video-to-Video」係一種深度學習模型,可以將一段視頻轉換成另一種風格、場景轉換、動作等操作。例如,可以將一段日本動畫轉換成中國水墨畫風格,或者將一段街頭表演轉換成動畫風格。 MS-Vid2Vid-XL 和 Video-to-Video 第一階段相同,都是基於隱空間的視頻擴散模型(VLDM),且其共享相同結構的時空UNet(ST-UNet),其設計細節延續我們自研 VideoComposer,具體可以參考其技術報告。
國產 ModelScope 模型
本項目MS-Vid2Vid由達摩院研發和訓練,主要用於提升文生視頻、圖生視頻的分辨率和時空連續性,其訓練數據包含了精選的海量的高清視頻、圖像數據(最短邊>720),可以將低分辨率的(16:9)的視頻提
「MS- Video-to-Video」係一種深度學習模型,可以將一段視頻轉換成另一種風格、場景轉換、動作等操作。例如,可以將一段日本動畫轉換成中國水墨畫風格,或者將一段街頭表演轉換成動畫風格。
MS-Vid2Vid-XL 和 Video-to-Video 第一階段相同,都是基於隱空間的視頻擴散模型(VLDM),且其共享相同結構的時空UNet(ST-UNet),其設計細節延續我們自研 VideoComposer,具體可以參考其技術報告。