GenCeption 單一模型多種視覺任務

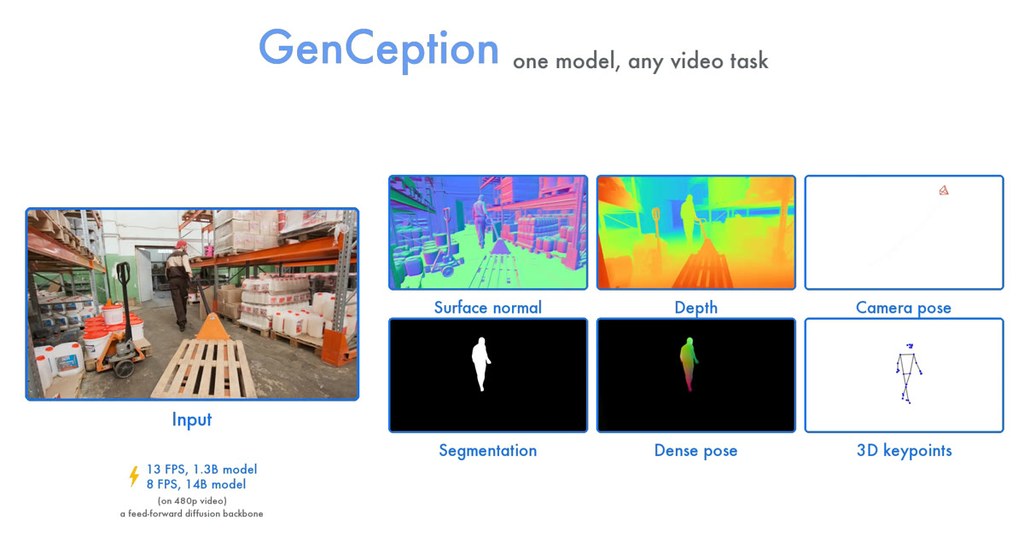
同一個模型就想處理深度、分割、姿態同關鍵點。GenCeption 把影片生成預訓練轉成通用視覺能力,方向相當清晰。

Og image

做影像理解時,很多人最頭痛的不是單一任務做唔到,而是每做一種任務就要換一套模型。GenCeption 屬於通用視覺模型,目標是把深度估計、法線、相機姿態、分割、2D/3D 關鍵點甚至 4D grounding 放入同一個流程,並且用文字指令控制輸出。

它處理的核心問題,是電腦視覺長期依賴任務專用模型,工作流容易分散、訓練與部署成本亦高。GenCeption 的做法,是先用 video generative diffusion model 做預訓練,吸收空間與時間上的 world priors,以及原生的 vision-language alignment,再經過 multi-task post-training,把原本偏生成式、多步驟的骨幹,改造成單步 feed-forward 推理模型。

這種路線跟常見做法最大分別,在於它不是為每個任務各自砌一個模型,而是用單一、task-agnostic architecture 應付 dense 與 sparse vision tasks。資料上亦以 synthetic data 為主,重點放在學習效率、sim-to-real transfer,以及遇到 out-of-distribution 物件類別時的泛化能力。

  • 支援多種視覺任務,包含 depth、surface normal、camera pose、segmentation、2D/3D keypoint prediction
  • 透過文字指令切換任務,保持同一模型介面
  • 把影片生成預訓練轉成 feed-forward 視覺推理,而不是停留在多步生成流程
  • 官方描述指它在多個任務上可與專用 SOTA 模型競爭,對比對象包括 DepthAnything3、D4RT、VGGT-Ω、SAM3、Sapiens、DAVID

對研究多模態模型、通用機械視覺,或者想整合複數感知任務的人來說,GenCeption 值得留意。現時公開內容仍以研究展示為主,Code 亦標示為 TBA,所以較適合先理解方法方向與能力邊界,再觀察後續開源與可重現程度。
項目主頁

Categories: 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Google, Video, 影像處理, 3D

ABot-World 把互動世界模型帶上桌面 GPU

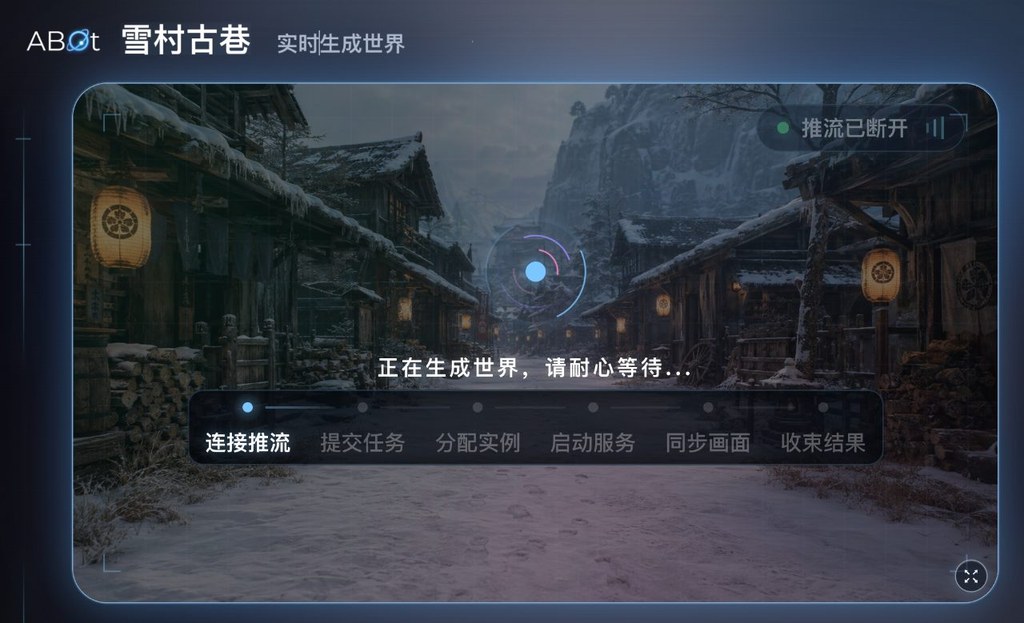
ABot-World想解決的,不是再做一段更長影片,而是讓生成世界可以持續回應操作。你可以把它理解成一個開始接近可玩狀態的互動式世界模型示範。

ABot World 0

影片生成做到流暢並不罕見,但能一邊接收操作、一邊把世界延伸落去,門檻就高得多。ABot-World定位屬於模型加示範工具,核心處理的是 action-conditioned world rollout:用戶輸入動作之後,系統持續生成可探索的世界,而唔係播完就停的被動片段。

呢個項目的取向相當鮮明:它唔係先追求超高畫質,而是把「可互動、可持續、可在單張桌面顯示卡跑起來」放到前面。官方公開的數字是單張 NVIDIA RTX 5090 可在 720P、16 FPS、1.2 秒延遲、19GB GPU 記憶體下運行,配合 LongForcing training 減少 scene lock-in,令 rollout 期間可以擴展新場景同動態,唔使靠 prompt switching 硬接續。

測試方式算直接:項目已提供本地 gradio demo,同時有線上版 ABot World Studio;想自己部署,它在 Ubuntu 22.04、CUDA 13.3、NVIDIA RTX 5090 環境驗證過,並要先下載 ABot-World-0-5B-LF checkpoint。換句話說,現階段較適合把它理解成高階桌面 GPU 上的研究型互動系統,而唔係一般消費級硬件都能順手跑的輕量工具。

幾個重點值得留意:
ABot-World-0-5B-LF 已公開,屬於 causal student model
– 互動重點在連續探索,不是固定長度 video generation
– 本地推理與線上 playground 都已提供,驗證路徑清楚
– Bidirectional Teacher Model 仍未釋出,生態暫時未算完整

適合研究 world model、interactive video generation、Agentic 模擬環境,或者想為遊戲原型與具身智能測試場景找參考的團隊。現階段的吸引力在於它把「無限 rollout」和「單桌面 GPU 即時推理」放到同一個項目內。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視頻模型, 世界模型, 模型訓練, Google, NVIDIA, Video, Linux, 蘋果

LongE2V 把事件流變成穩定長影片

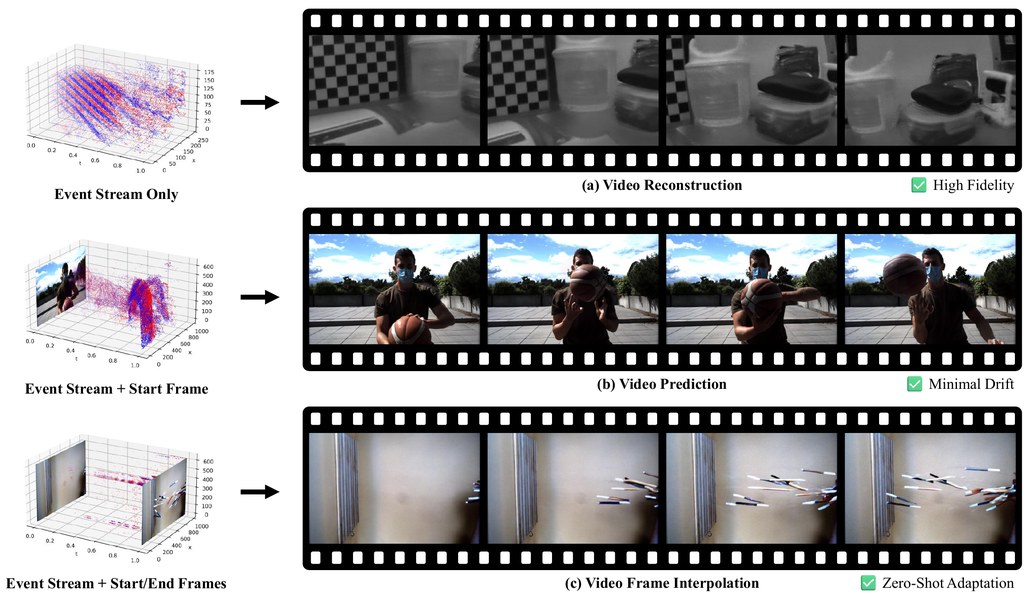
LongE2V 針對事件相機最難處理的長時序穩定度落手,想同時做好重建、預測與補幀。你可以把它理解成一套用 video diffusion model 補回連續畫面的研究型框架。

Logo

事件相機資料本身又稀疏又碎,畫面一拉長,很多方法不是紋理發糊,就是前後段落開始飄。LongE2V 走的是研究型模型/框架路線,目標不是只修一段短片,而是把 sparse event streams 轉成較穩定的長影片,並且同時處理 reconstruction、prediction 同 frame interpolation。

同類做法常見兩條路:一類用 regression methods,速度直接但容易損失細節;另一類雖然有 generative models 的畫質優勢,長序列又容易出現 temporal drift。LongE2V 把 pre-trained video diffusion priors 拉進 event-based video 任務,再加上 Autoregressive Unrolling、Adaptive Context Switching,以及插幀用的 Reencoding Alignment with Cross Residual Correction,核心取向很清楚:接受系統更複雜,換取較長時間的一致性同感知品質。

部署環境以 Python 3.10 為基礎,Linux 加 NVIDIA GPU,同時依賴整理好嘅資料結構;訓練要每段 sequence 準備 images/.png、voxels/.npz 同 cogvlm_prompts.txt,推理前亦要確保 voxel 檔名、數量同資料夾完全對齊,因為多一個或少一個 voxel 檔,都會改變事件切塊方式,直接影響訓練同推理結果。

重點整理如下:
– 同一套框架覆蓋 reconstruction、prediction、frame interpolation,減少每個任務各自維護一套模型的割裂情況
– reconstruction / prediction 以 ECD、MVSEC、HQF 為主,interpolation 用 BS-ERGB 同 HQF
– 空事件區間會寫入 zero voxels,避免時序長度對不上
--reverse-time --reverse-polarity 產生的 voxels_reverse 只供 interpolation 測試使用,唔需要帶入 reconstruction、prediction 或訓練
– 在 real-world benchmarks 上優於多個 state-of-the-art 方法,並強調 temporal coherence 同 zero-shot generalization

相關模型包括 E2VID、FireNet、ET-Net、SPADE-E2VID、SSL-E2VID、HyperE2VID、VDM-EVFI、CBMNet-Large 同 TLXNet+。LongE2V 較適合做事件相機、視覺生成、機械感知或學術重現的團隊參考;它吸引之處在於把三類任務收進同一個 video diffusion framework,但代價是資料前處理要求嚴格、硬件門檻偏高,整體更像面向研究與實驗室工作流。

項目主頁 · GitHub · Paper

Categories: 開源, 模型, NVIDIA, Video, 框架, Linux, Python

Video-Oasis 想重做影片理解評測

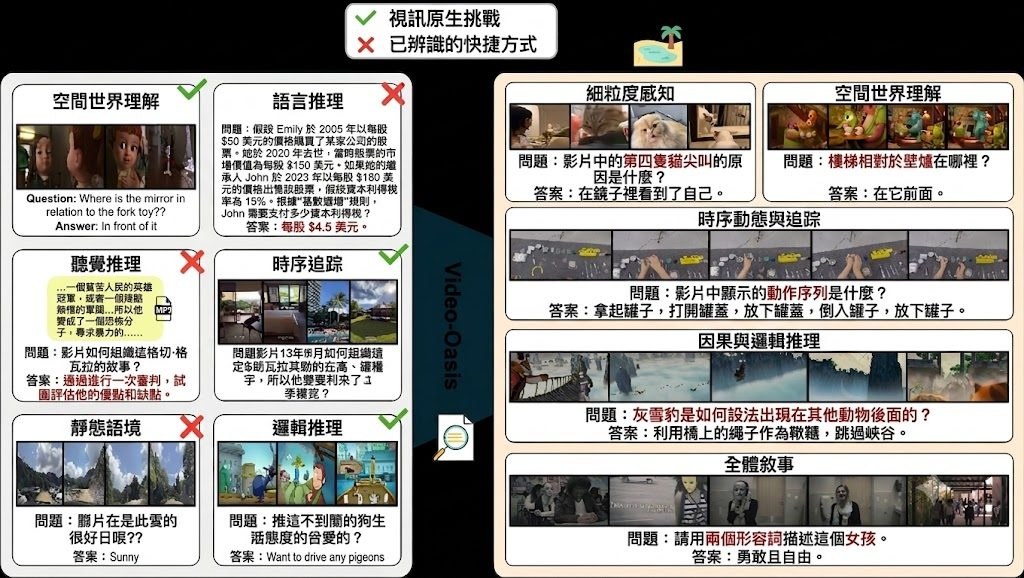
不少影片 benchmark 分數看似漂亮,其實未必真係考到影片理解。Video-Oasis 把焦點放回評測本身,專門拆解捷徑題與真正需要時序證據的題目。

video native challenges

高分未必代表模型真係睇得懂影片,呢個項目正正針對呢個落差。Video-Oasis 屬於資料集與評測項目,重點不是再加一份題庫,而是重新檢查現有 video benchmark 到底有幾多題目真的需要 visual grounding 與 temporal reasoning,避免模型只靠文字線索、單幀畫面或靜態背景就答中。

普遍做法是把不同影片問答 benchmark 直接合併比較,作者認為這種固定範式忽略了「是否真係需要影片」這個前提。Video-Oasis 先整理 14 個 benchmark、24,416 個 QA samples,再用共享的 visual 與 temporal criteria 審視題目,結果指出約 55% 樣本可被 non-video shortcuts 解開,之後再萃取出 11,033 個較具代表性的 Video-Native 挑戰。

它和同類 benchmark 最大分別,在於不是追求覆蓋更多題型,而是先清理評測污染。官方資料提到五類 video-native challenges 才是核心難點,而現時模型在這部分表現仍然偏弱,最佳模型 Gemini-2.5 Pro 只有 46.7%,接近 chance 25.63% 之上不遠,說明這套評測更能拉開「答得中」與「真理解」之間的差距。

  • 涵蓋 14 個 benchmark,任務由 perception 延伸到 reasoning,片段長度由幾秒到數小時
  • 以 shared visual and temporal criteria 重新審核題目,不是單純拼接舊 benchmark
  • 約 55% QA samples 可用 non-video shortcuts 解答,真正 video-native 部分約佔 45%
  • 評測流程建基於 lmms-eval,並支援透過 huggingface_hub 下載模型
  • README 已提供資料下載、影片修復與目錄整理方式,但完整程式碼仍標示為 coming soon

部署理解上,它較像一個研究型 benchmark workflow:你要先準備 Python 3.12、CUDA-compatible GPUs、torch、vllm 0.11.0 與 transformers 4.57.0,再下載各 benchmark 影片、用 ffmpeg 腳本修復損毀檔案,之後透過內建 lmms-eval 跑 vqa_total 或 v_oasis 任務。現階段較適合做模型評測、研究比較,或者幫團隊檢查自家 video model 是否只是在 benchmark 上「識考試」,未必適合作為即裝即用的應用工具。

項目預設支援可由 huggingface_hub 下載的模型,示例提到 Eagle2.5-8B;成績說明中則點名 Gemini-2.5 Pro 為目前最佳表現者。整體來看,Video-Oasis 最有價值的地方不是再造一個排行榜,而是把影片理解評測裡最容易被忽略的捷徑問題公開化,令後續模型比較更可信。

項目主頁 · GitHub · Paper

Categories: 開源, AI productions, 視覺模型, 視頻模型, NVIDIA, Gemini, Video, Python, Dataset 數據集

CineMobile 點樣把電影運鏡搬上手機

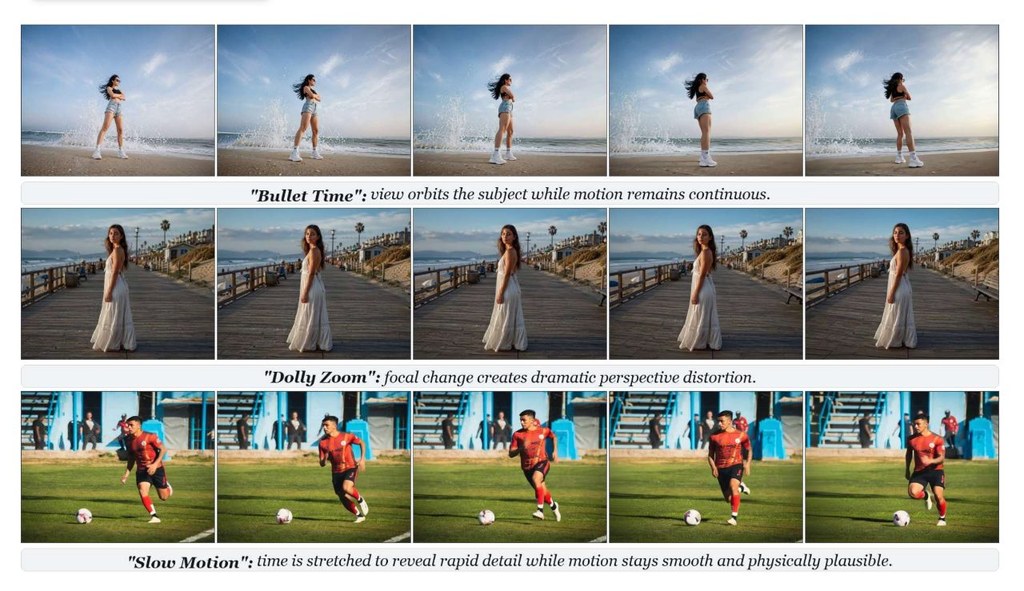
想用一張相做出 bullet time 或 dolly zoom,CineMobile 瞄準的正是手機端生成速度與畫質之間的拉扯。它把大型影片擴散模型壓縮到可落地的體積,同時盡量保住電影感運鏡。

Hugging Face

由 Wan 2.1 架構的 teacher model 壓縮而來,CineMobile 針對 image-to-video diffusion 而設,重點唔係追求最大全能,而係讓 bullet time、dolly zoom、slow motion 這類電影感鏡頭可以在手機晶片上跑得動。對一般使用者來說,最大差異是它把原本偏向雲端或高階 GPU 的生成流程,縮短到可在行動裝置完成的級別。

技術路線分三步走:先用 distillation-guided pruning 保留關鍵影片生成能力,再把壓縮後模型結合 diffusion distillation 與 reinforcement learning,進一步做成 4-step generator,最後再用 hybrid post-training quantization 把整體模型壓到 1 GB 以下。這組做法直接對準兩個瓶頸:DiTs 參數太大,以及多步去噪太慢。

頁面提供的數字相當具體。相比採用 Wan 2.1 architecture 的 teacher model,CineMobile 可帶來 40× 生成加速;生成 49-frame、480p 影片時,在 NVIDIA H200 GPU 的每步 denoising latency 為 0.6 秒,在 MediaTek Dimensity 8400 Ultimate 5G 平台約為 20 秒,峰值記憶體使用量為 1.8 GB。這代表它雖然仍有明顯等待時間,但已進入手機可接受的範圍。

  • 基礎來源可確認與 Wan 2.1 架構有關,但頁面未見完整 base model 款式或 checkpoint 名稱
  • 核心優化包括 pruning、distillation、reinforcement learning 與 post-training quantization
  • 目標輸出為 49-frame、480p 的 cinematic camera motion 影片
  • 重點能力在於連續運鏡,同時維持 subject identity 與 scene consistency

Hugging Face 暫未提供可直接下載量化檔的模型頁,未提供 GGUF、mmproj、llama.cpp、Ollama、LM Studio、chat template 或 v2 檔名更新資訊,亦無法判斷是否支援 MTP draft speculation。

項目主頁 · Paper

Categories: AI productions, 視頻模型, 模型訓練, NVIDIA, Video, Image, LLaMa, Ollama

OpenCoF 用影片學會推理

推理未必只靠文字一步步寫出來,OpenCoF 把重點放到影片幀與幀之間的連續變化。它想證明,生成影片本身都可以成為推理過程。

Repository image for xinyan-cxy/OpenCoF

文字 Chain-of-Thought (CoT) 之外,OpenCoF 把推理搬到影片時間軸上,主打 Chain-of-Frame (CoF) reasoning:模型不是靠外部工具拆步驟,而是在連續生成的畫面裡理解因果、規則同狀態變化。這屬於一個研究型框架,核心想處理的問題,是現有影片生成模型多數只見過一般影片資料,未必學到穩定的時序推理能力。

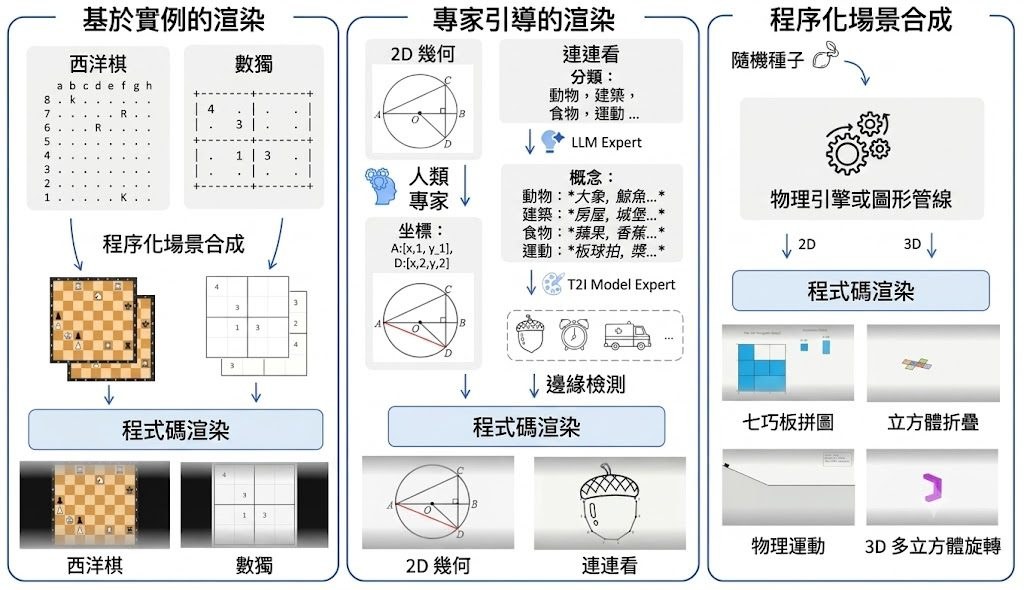
作者對既有做法的批評很明確:以往影片模型通常用通用影片語料訓練,缺少專門針對 CoF reasoning 的監督,因此即使畫面能動起來,都未必真係「識推」。OpenCoF 於是補上兩層東西:先有 OpenCoF-17K 這個包含 17,312 段影片、覆蓋 11 類任務的資料集,再用它把 Wan2.2-I2V-A14B 經 LoRA 微調成 Wan-CoF,之後再加上 Visual Reasoning Tokens (vt) 與 Textual Reasoning Tokens (tt) 兩種設計。

OpenCoF 先用資料監督驗證影片推理能否被教出來,再用 token 設計補強中間推理狀態,而不是一開始就堆很多複雜推理機制。公開資訊顯示,Wan-CoF 單靠資料監督,已經在 MME-CoF、Gen-ViRe、VIPER、RULER-Bench 四個外部 benchmark 全面勝過基線;Wan-CoF vt 與 Wan-CoF tt 則再向前一步,但兩者偏重不同,vt 較擅長低階視覺線索,tt 較著重高階語意先驗。

  • OpenCoF-17K 由四條資料整理流程建成,兼顧規則型任務、程序生成場景與真實影片多樣性
  • Wan-CoF 以 Wan2.2-I2V-A14B 為底,靠 LoRA 微調驗證資料本身已可提升推理表現
  • Wan-CoF vt / Wan-CoF tt 分別從視覺 latent 與文字條件序列加入 reasoning tokens,走兩條互補路線
  • 評測覆蓋 MME-CoF、Gen-ViRe、VIPER、RULER-Bench,結果指向同一件事:時序監督對影片推理有明顯幫助

OpenCoF 適合研究團隊、做視覺推理評測的人,或者關注 Video reasoning 與 Video generation 交界的開發者參考:儲存庫已公開論文與方法框架,但 code、dataset 同 model checkpoints 仍在內部審核,暫時未能直接下載測試;現時較合理的理解方式,是先把 OpenCoF 視為一個針對 CoF reasoning 的資料與訓練範式,等正式釋出後再判斷重現成本與落地價值。

項目主頁 · GitHub · Paper

Categories: 開源, 香港中文大學, 字節跳動, 視覺模型, 多模態模型, 視頻模型, Video, 蘋果, Dataset 數據集

ARDY 讓 3D 角色動作可即時受控

想像你一邊改文字指令,一邊即時見到角色順住路徑、姿勢同目標動起來。ARDY把可控性同即時回應拉到同一個工作流入面。

Og image

一邊輸入文字、一邊指定角色要去邊、幾時抬手或者身體要擺成咩姿勢,系統仍然可以即時生成自然動作;ARDY瞄準的正正是呢種互動式 3D human motion generation 場景。呢類能力對動畫、模擬同 humanoid robotics 都重要,因為傳統離線方法雖然控制精準,但速度未必跟得上互動需求;純即時方法又常常在語意理解、長距離目標同約束服從度上打折扣。

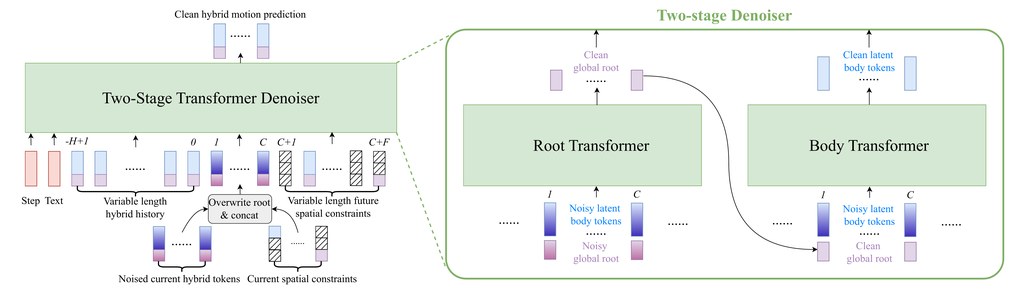
ARDY 採用 autoregressive diffusion model,同時配合 hybrid representation,把角色移動軌跡相關的 root features 同 latent body embedding 結合。咁樣做的用意很直接:一方面保留對路徑與朝向的明確控制,另一方面維持生成模型學習複雜全身動作時的效率與彈性。配合 two-stage autoregressive transformer denoiser,同一套框架可以處理 online text prompting,亦能接住較長時間範圍的 kinematic constraints。

它支援的約束方式幾完整,包括 root paths、waypoints、full-body keyframes,以及 sparse joint positions/rotations,亦可混合使用。更重要的是,約束唔一定只限當前生成視窗,較遠將來的目標都可以先講定,令角色更容易朝長程目標連續行動,而唔係每幾步就失去方向。

  • 支援 online text-to-motion generation,可即時改提示詞
  • 可加入 root paths、waypoints、full-body keyframes 同 sparse joint constraints
  • 兼顧即時反應、動作品質同長距離控制
  • 面向動畫、模擬、humanoid robotics 等互動工作流

資料提到,ARDY 以大型 motion capture dataset 訓練,並直接用文字標籤與來自真實姿勢抽樣的 kinematic constraints 作條件,令模型原生學會受控生成。研究團隊亦展示了互動式 demo,涵蓋動態文字控制、關鍵幀約束、路徑跟隨同即時 locomotion control;定位上,它較適合需要邊調邊看結果的內容製作與研究場景。

項目主頁 · 模型

Categories: Embedding, 世界模型, 模型訓練, NVIDIA, Video, VLA, 提示詞, Robotic, 框架, 軟件, 3D, 動畫, Dataset 數據集

OmniTacTune 用觸覺補上視覺機械手

只靠鏡頭學到的機械手,遇上插孔、開蓋這類接觸動作很易失手。OmniTacTune 用短時間真機強化學習,加上一層觸覺修正,專門補回這段最難的細節。

Og image

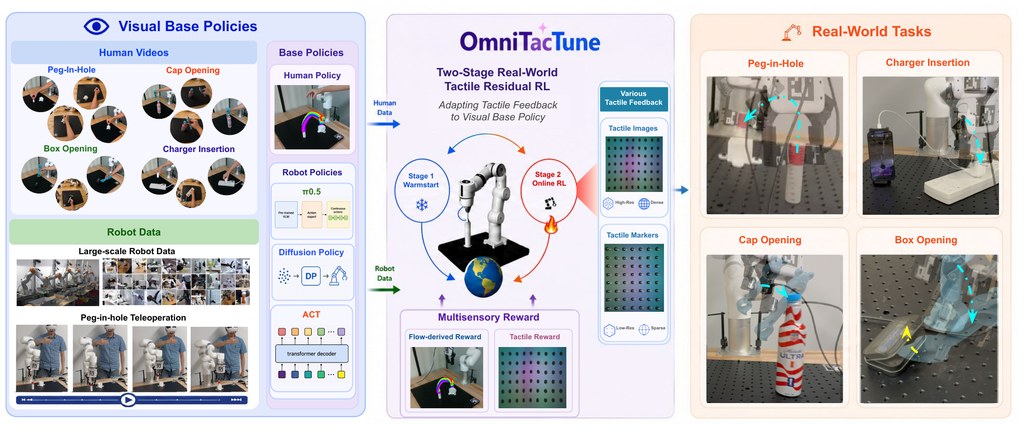
做到看得見路徑,未必做得到插得準、扭得開。OmniTacTune 屬於 Robotic 項目,處理的正是視覺策略在接觸密集操作上的短板:鏡頭能提供整體動作方向,但一到真正碰撞、受力、卡位的瞬間,就需要觸覺去補足判斷。

它的取向幾清晰:不重訓整個 visuo-tactile policy,而是保留已訓練好的 visual policy 作為 motion prior,再用 real-world RL 學一個輕量 tactile residual correction。這種做法的價值,在於可以直接疊加到不同基礎策略上,包括 ACT、Diffusion Policy (DP) 與 Flow Policy,亦能配合來自 human video 或 teleoperation data 的視覺基礎能力。

項目示範了四類 contact-rich tasks,包括 peg-in-hole、charger insertion、cap opening 同 box opening。公開結果指出,系統可在約 40 至 80 分鐘內於真機完成適應訓練,而且有一段 one-take online RL 示範,訓練過程不需要為鏡頭刻意重設場景,重點放在由較弱的 base policy 持續練到較可靠的接觸操作。

  • 凍結 visual base policy,只學 tactile residual,減少重訓成本
  • 可接到不同 observations、architectures 同 action-chunk horizons 的基礎策略
  • 適合插入、開蓋、開盒這類依賴接觸幾何與受力回饋的工作流
  • 使用 human video 與 teleoperation data 訓練的基礎策略都可接入

這個項目最受用的場景,是手上已經有視覺模仿學習策略,但卡在最後接觸成功率的人。現有資料顯示,它強調的是通用接入能力與真機短時適應,而不是用大量觸覺資料由零開始建模;取捨也很明顯,系統價值集中在「最後一里」修正,前提仍然是 base policy 本身已具備基本動作先驗。

項目主頁

Categories: 模型訓練, Video, Robotic, 教學

LingBot-World 2.0 把互動世界拉長

想像一個會持續生成、又跟得上操作節奏的互動世界模型。LingBot-World 2.0吸引人的地方,在於它同時追求連續性、速度與可玩性。

teaser

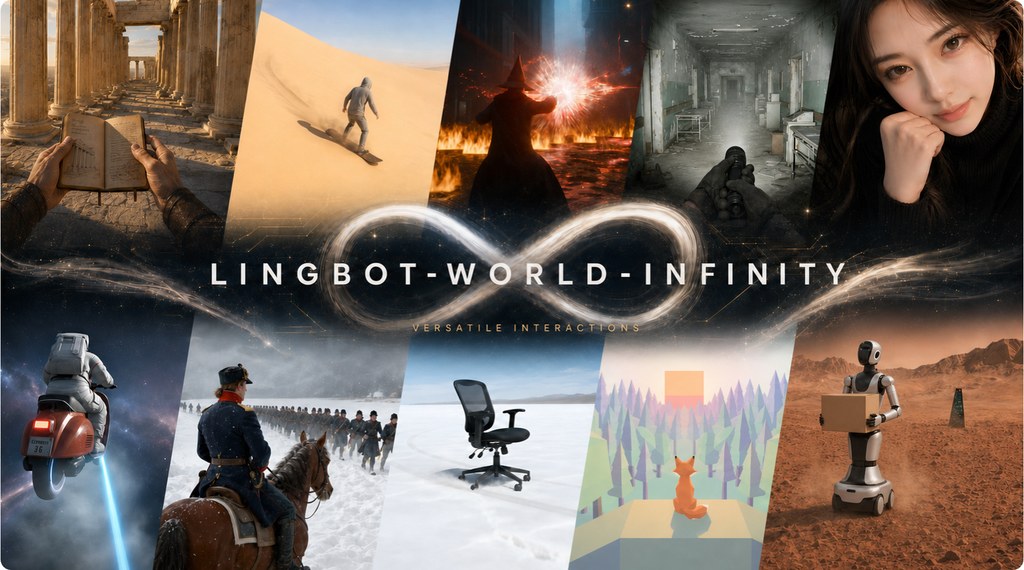
最值得留意的,不是單純生成影片,而是它嘗試把世界模型做成可持續互動的系統:畫面不只要動,還要在長時間互動下維持一致,並且跟得上即時操作。LingBot-World 2.0,也叫 LingBot-World-Infinity,定位上屬於模型項目,處理的是互動式世界生成容易愈玩愈散、反應又唔夠快的問題。

同類做法很多時偏向短片段展示,或者重視視覺效果多於操作連續性;這個版本反而把焦點放在「interaction horizon」拉長,同時保住輸出穩定度。它亦加入 agentic harness,由 pilot agent 規劃角色行為、director agent 補出新環境元素,方向上更接近可演進的遊戲式世界,而唔只係被動播放內容。

現階段最容易理解的試法,是先經 Reactor 的 Web 版本或 LingGuang 的流動平台體驗即時版;README 亦提供 Hugging Face 與 ModelScope 上的模型頁面。官方說明指出,平台版本方便試玩,但完整能力仍以官方設置為準,換句話說,公開體驗較適合感受互動節奏,未必等同完整表現。

  • 支援長時間互動,主打 unbounded interaction horizon
  • 提供即時變體,官方稱可驅動 720p、60 fps 影片串流
  • 動作與事件更豐富,包括攻擊、射箭、施法、射擊等互動
  • 以 pilot agent 與 director agent 分工,推進角色與場景演化

現有資料未見完整基準表或系統化對比結果,性能描述主要來自項目方公開說明,所以較適合把它視為一個展示取向鮮明的前沿模型。相關模型目前可見的是 lingbot-world-v2-14b-causal-fast;而從 Robbyant 整體路線來看,它亦與 LingBot-Vision、LingBot-Depth、LingBot-VLA、LingBot-Video 等項目一起指向 embodied AI 與世界模型的長線布局。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 多模態模型, 世界模型, Video, VLA

LingBot-Video 想做懂物理的生成影片

首个面向具身智能的大规模开源 MoE 视频基础模型。一般影片模型擅長畫面氣氛,未必處理到動作同物理合理性。LingBot-Video把重點放到具身智能場景,取向相當鮮明。

T2V Quality Score

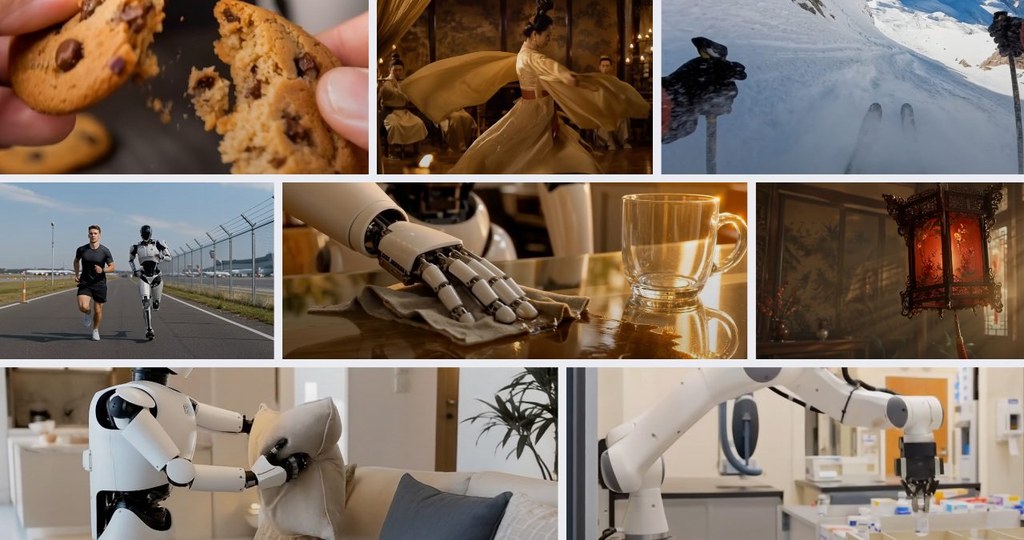
生成影片要做到「似真」,唔只係畫面靚,仲要交代到動作、物件同物理世界之間嘅關係。LingBot-Video屬於開源視頻模型,主打 embodied intelligence,想補足一般 T2V 只重視視覺效果、但對任務過程同物理合理性掌握較弱呢個缺口。

呢個項目的取向幾清楚:唔係單純追求更大參數,而係用 MoE(Mixture-of-Experts)架構去平衡容量同推理成本,官方說法指推理可快約 3 倍。訓練資料亦唔只靠網絡影片,仲加入超過 70,000 小時 embodied data,再配合 multi reward system,同時兼顧美感、physical rationality 同 task completion。

部署理解上,它已提供完整模型下載入口,同時覆蓋 Hugging Face、ModelScope 以及文件站;推理路線分成 diffusers 同 SGLang Diffusion,代表團隊唔只放權重,亦有考慮不同推理堆疊。README 亦列出 rewriter,當中包括以 Qwen3.6-27B 為基礎嘅版本,以及 Qwen3.6-27B LoRA adapter,表示提示詞改寫都係整個工作流一部分。

  • 提供 LingBot-Video-DenseLingBot-Video-MoE,前者較像基線路線,後者加入 Refiner
  • 任務覆蓋 T2I、T2V、TI2V,唔只限純文字轉影片
  • 以 embodied data 同多重獎勵機制強化動作合理性
  • 有文件、模型頁同技術報告,較適合研究團隊同進階內容生成流程測試

受益最大嘅,會係想做機械人模擬、具身智能研究、動作導向影片生成,或者需要比較「任務是否完成」而唔只係「畫面是否好睇」嘅團隊。現有資訊未見到完整基準分數整理,所以性能判斷暫時仍要配合官方技術報告同實測;不過以開源定位、MoE 架構、Refiner 同 rewriter 一併公開嚟睇,LingBot-Video明顯係朝住較完整嘅研究與部署鏈路去設計。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, Qwen, Video

Page 14 of 21
1 12 13 14 15 16 21