Rank-Then-Act 點樣用影片學出獎勵

想像你只得示範影片、冇現成 reward function,Rank-Then-Act 就係針對呢個卡位而來。它先學會判斷進度,再把次序感轉成強化學習可用的訊號。

Screenshot

做強化學習最麻煩的地方,往往不是訓練本身,而是根本冇一個好用的 reward function。Rank-Then-Act 針對的正正是這個缺口:它屬於一個以 Vision-Language Model (VLM) 為核心的強化學習框架,目標是在沒有環境獎勵的情況下,從示範影片推回任務進度,再把這種進度感變成 agent 可學習的 dense reward。

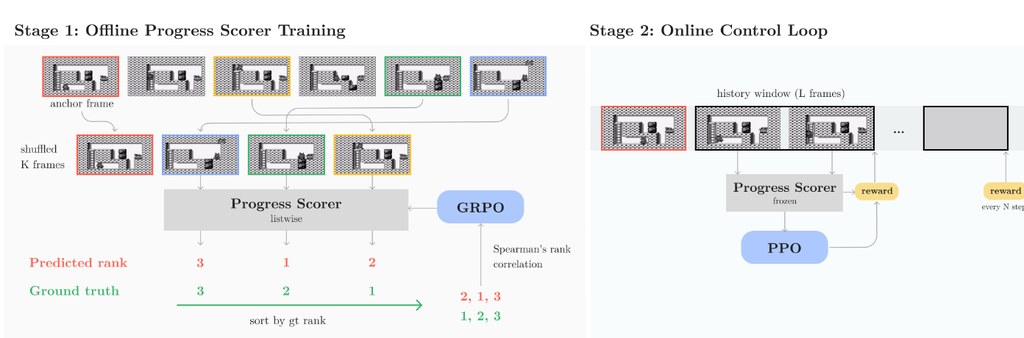
同類方法很多時會直接學一個 scalar reward,或者預測成功與否,但作者刻意避開這條路。RTA 先用 GRPO 微調 VLM,要求模型在打亂次序的畫面序列中估計 task-completion 百分比與排序,再用 VOC 這個 rank-correlation reward 去約束模型真的理解時間進展,而不是偷看絕對時間線索;之後在第二階段,系統不是直接輸出分數當 reward,而是用 Spearman rank correlation 比較預測進度排序與真實時間索引,得到一個 bounded、scale-invariant 的學習訊號。

這種取向的好處,是 reward 較不容易因尺度漂移而失真,亦較有機會跨任務重用同一個 progress scorer。現有資料指出,它在離散環境如 PyBoy 上的 Catrap、Kirby,以及連續控制環境如 MetaWorld、PointMaze 都有不錯表現,對 unseen tasks 亦有泛化能力;不過這仍然是研究型項目,重點在方法驗證,未算是即裝即用的成品工具。

  • 重點不是直接預測分數,而是先學會判斷畫面進度排序
  • 第一階段用 GRPO 訓練 VLM,第二階段用 PPO 訓練策略
  • reward 來自 VOC 與 Spearman rank correlation,訊號範圍固定在可控區間
  • 已覆蓋 Game Boy 模擬器 PyBoy 與 MetaWorld 這類不同控制場景
  • 需要 Python 3.10+、CUDA GPU,第二階段還要 xvfb、ROM 與 save state

理解和測試這個項目,最合理的方式不是把它當普通套件安裝,而是當成兩階段實驗流程來看:先在 stage1 用 gameplay videos 訓練 progress scorer,再到 stage2 把該模型凍結成 reward model,放進 PPO 訓練流程。儲存庫已把資料處理、Hydra 設定、多 GPU 配置、PyBoy 包裝器與 VOC 計算分開整理好,適合研究團隊、做 video-based RL 的人,或者想比較 ordinal reward 與 scalar reward 差異的讀者深入追蹤。
項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 視覺模型, 多模態模型, 模型訓練, NVIDIA, Video, Python

MuseBench 用藝術理解考驗 MLLMs

MuseBench唔係測模型見到咩,而係追問點解作品要咁表達。呢套 benchmark 把多模態理解拉到藝術語境,難度明顯高過一般視聽問答。

Repository image for musebench/musebench-code

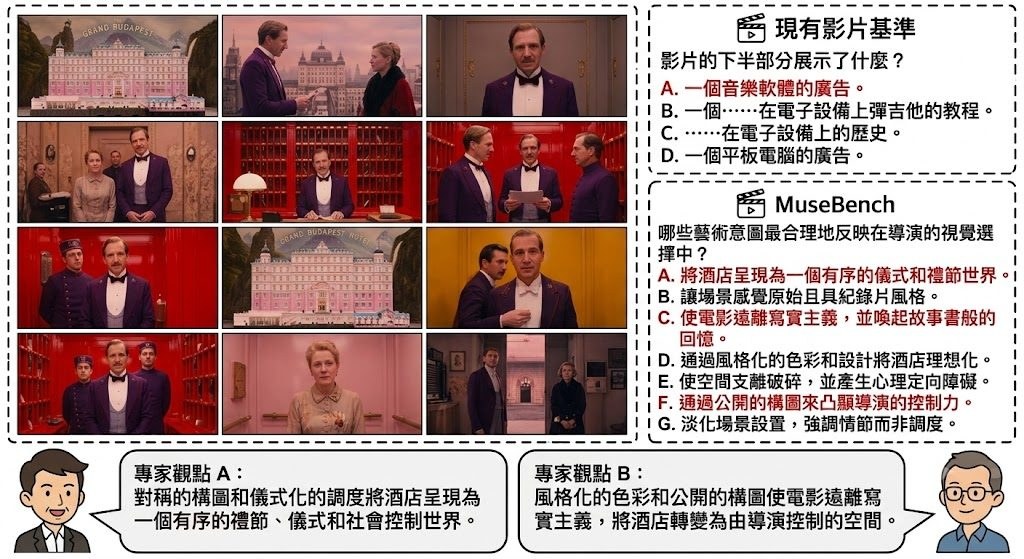
見到畫面、聽到聲音,未必等於真係明白作品想點講。MuseBench 把焦點放到 artistic intent,專門測 multimodal large language models(MLLMs)能否由視聽證據推斷創作選擇背後的意思;它屬於 benchmark/數據集型項目,處理的是現有評測多數只停留在 perceptual recognition,未能反映藝術理解深度的問題。

現有做法常用一般視覺問答或影片理解題,模型只要辨認物件、情節或表面事件就有機會得分;作者認為這種 fixed paradigm 忽略 stylistic vocabulary、cultural priors 同 grounded audiovisual inference,所以改用 narrator-removed video clip,並配合可選 audio transcript,迫使模型直接由鏡頭、聲音、節奏與敘事線索作判斷。題目覆蓋 Cinematic Arts、Static Visual Arts、Stage Performing Arts 同 Game Arts,合共 4,016 條問答。

同類 benchmark 多數著重「睇到乜」,MuseBench 則更在意「點解要咁呈現」。它亦唔只用單一選擇題,仲有 single-select 同 multi-select 兩種格式,並加入 Chance-Adjusted Accuracy(CAA)處理選項數量不同帶來的偏差,令比較 28 個 MLLMs 時較公平。

  • 涵蓋 4 個藝術領域、11 個細分類,題材比一般影片 QA 更闊
  • 評測 28 個 MLLMs,包含 proprietary、open source 同 video-specific 路線
  • 最佳模型準確率 48.29%,明顯低於 human expert 的 87.18%
  • 已整合 VLMEvalKit,方便把新模型接入同一套流程測試

部署同測試理解上,這個 code repository 主要唔係提供訓練模型,而是把 MuseBench 接到 VLMEvalKit 的評測流程,較適合研究團隊、模型評估人員、做 video understanding 或多模態推理的項目直接比較新舊模型。已公開的結果提到 Claude-4.6-Opus、Qwen-3.5-Plus、Doubao-Seed、GPT-5.4、Gemini-3.1-Pro、Grok-4.1 等都測過,分數整體仍與專家有大段距離;換句話說,這個項目最有價值的地方,在於它清楚指出現時 MLLMs 在藝術判讀仍未算接近可靠。

項目主頁 · GitHub · Paper

Categories: 開源, 香港大學, 字節跳動, 多模態模型, Qwen, OpenAI, Gemini, Video, Audio, 香港, Anthropic, Dataset 數據集

NVIDIA 用單一影片模型兼顧連貫與速度

想要影片生成既連貫又夠快,往往要在畫質、全局一致性同串流效率之間取捨。Flex-Forcing 嘗試用同一個 Video Diffusion Model,同時處理呢個矛盾。

Og image

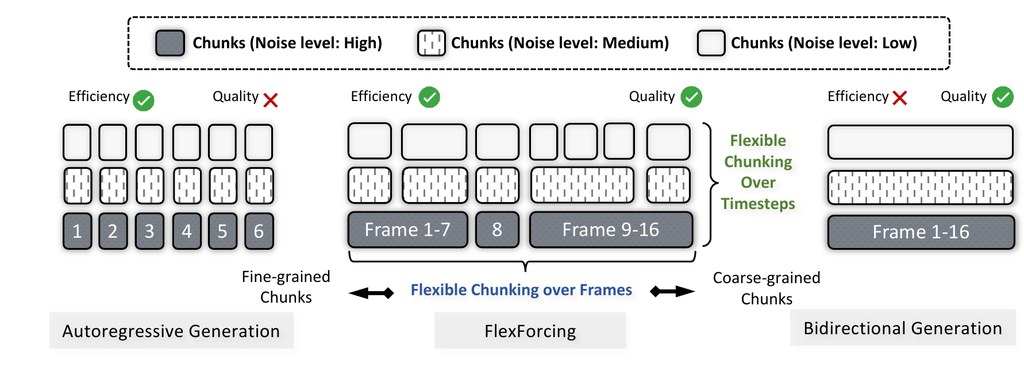
做影片生成時,最常見的卡位係:Bidirectional diffusion 生成得穩,前後鏡頭更一致,但速度慢;Autoregressive 方式可以逐段輸出,較適合串流,不過長片段容易失去連貫。Flex-Forcing 針對的正正係呢個兩難,屬於影片模型方向,目標係用同一個 Video Diffusion Model 橫跨兩種生成模式。

它的做法不是把兩套系統硬拼在一起,而是用一個較靈活的 chunking 機制,同時沿時間軸同 denoising steps 去切分。咁樣模型可以在 chunk 之間做 bidirectional 的全局規劃,又能在 chunk 之內用 autoregressive 方式逐步生成,兼顧整體一致性同推理效率。網頁用一句話概括得很清楚:one model, two generation regimes。

對內容創作、長影片生成同需要邊生成邊輸出的工作流來說,呢種設計幾有吸引力。它不是單純追求最快,亦不是只追求最完整的全局建模,而係嘗試將「先看全局」同「逐段出片」放入同一套推理框架,減少以往要為不同場景分開選模型的麻煩。

  • 統一 Bidirectional 與 Autoregressive 兩種影片生成路線
  • 以 temporal axis 配合 denoising steps 的 chunking 作核心設計
  • chunk 之間強調全局規劃,chunk 之內保留串流生成能力
  • 目標是改善長距離一致性、速度與 exposure bias 之間的取捨

現有資料顯示,Flex-Forcing 的核心價值在於統一訓練與推理框架,而不是只做單一生成模式的微調優化。公開內容暫時未完整列出具體評測細節,但方向已很明確:希望用一個模型覆蓋更多影片生成場景,特別適合重視長片段敘事連貫,同時又需要較靈活輸出節奏的項目。

項目主頁 · Paper

Categories: 視頻模型, 模型訓練, NVIDIA, Video, 框架

Light-Omni 想把長影片 Agent 變得更快

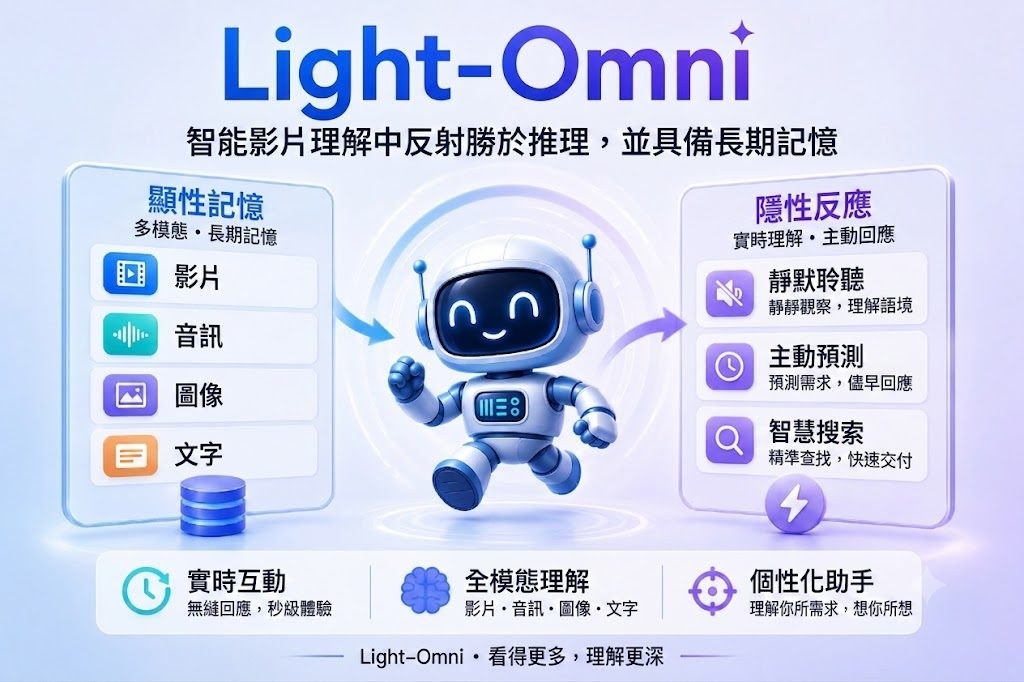
面對長影片互動,Light-Omni唔再靠一輪輪搜尋同推理。它把記憶、檢索同回應壓縮成較輕量流程,重點放在速度同連續互動。

Light-Omni

長影片互動最易卡住的位,不是模型看不懂,而是每次都要重新搜尋線索、反覆推理,回應自然會慢。Light-Omni把這件事改寫成一個Agentic video understanding研究項目:用長期多模態記憶處理視覺、語音與文字串流,目標是讓代理在連續對話中更快決定要直接回答、提取記憶,還是補足證據。

現有做法常採用作者所說的 detective-style iterative reasoning,一邊規劃、一邊搜尋、一邊聚合證據;好處是步驟清楚,代價是延遲高、計算開銷大。Light-Omni提出 reflexive video understanding,核心不是拉長 reasoning loop,而是以單次 forward pass 產生全域脈絡與 retrieval embeddings,再配合 Generation AdapterMemory AdapterReaction Adapter 三個模組,分別負責回應、長期記憶整理,以及預測何時檢索。

這個取向的價值很直接:它不是追求最繁複的推理鏈,而是優先解決互動代理在長影片場景的反應速度。項目建基於 Qwen2.5-Omni,示範則用 Qwen3-Omni-30B-A3B-Instruct;記憶設計包含 identity profiles、semantic memory、episodic memory,並加入 sleep-time memory consolidation,把較長時段的觀察壓成緊湊全域狀態,同時保留近期細節。

  • 相比 M3-Agent,平均準確率提升 2.4%
  • 速度達 12.1x,加強長影片互動的即時性
  • GPU 記憶體效率提升 2.6x,較適合資源有限的部署
  • 倉庫附有 eval.py、Flask/Socket.IO demo、Hugging Face 模型與訓練資料

想驗證這個項目,現時可沿三條路理解:先看 web demo 感受反應方式,再用倉庫內的 eval.py 配合 logs/ 檢查長影片 benchmark 結果,最後參考 thirdparty/ 內已修補的 transformersms-swift 組件做訓練或推理環境配置。較受用的讀者會是做多模態代理、長影片理解、記憶檢索,或者需要低延遲互動系統的研究團隊;它仍屬研究原型,效能數字主要來自項目提供的 benchmark 與示範,部署前仍要按自己的影片長度、硬件條件與任務形式再核實。

項目主頁 · GitHub · 模型

Categories: 開源, 南京大學, Agentic, Embedding, 模型, 多模態模型, Video, Dataset 數據集

MV-Forcing 讓長時多視角影片更一致

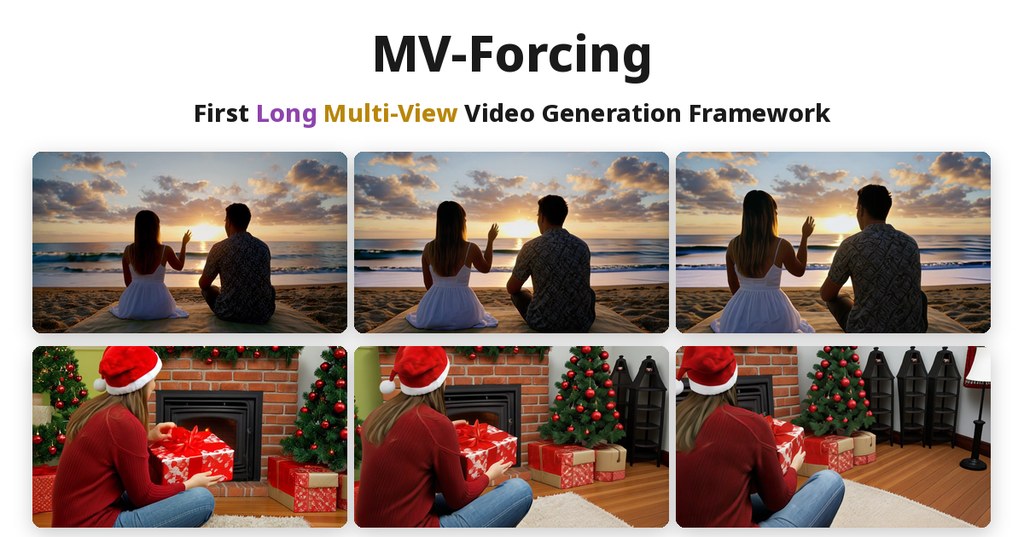
同一段動態場景,要由多個角度連續生成而且唔穿崩,一直都好難。MV-Forcing想解決的,正正是長片段、多視角與幾何一致性三件事同時成立。

Og image

想像同一個人物動作,要由三個鏡頭角度一路接住生成,畫面不但要連戲,視角之間的位置關係都要講得通。MV-Forcing 屬於多視角影片生成框架,處理的正是長時段 dynamic scenes 在不同 viewpoint 下容易失真、跳位、前後不一致的問題。

它的取向,不是只顧單一視角拉長影片,也不是只做短片式多視角同步,而是把 temporal autoregression 同 view-wise autoregression 放入同一個 diffusion model。中間再加上一個 4D geometric prior 作橋樑:先從已生成的 source view 重建 3D 結構,再渲染出下一個 target view 的幾何先驗,最後交由模型細化成高質影片。

另一個關鍵在訓練方式。MV-Forcing 用 joint denoising,令兩個 view slots 訓練時都可由雜訊起步,避免模型只依賴固定 teacher temporal window,從而支援更長的生成。它亦加入 Distribution Matching Distillation 與 Spatio-Temporal Self-Forcing,盡量縮窄訓練與推理之間的 exposure bias,讓時間與視角兩條自回歸鏈接得更穩。

  • 能同時處理長影片與多視角一致性,而唔係二選一
  • 以 3D reconstruction 連接相鄰視角,補上幾何關係
  • 支援 arbitrary lengths 與 viewpoint counts,彈性較高
  • 用單一 few-step student model 完成生成,推理路徑較集中

現有資料提到,它已在 synthetic 與 real-world data 做大量實驗,重點成果是能生成幾何一致的多視角動態影片。不過公開內容暫時較像研究展示,Code 仍標示 coming soon;對內容創作、視覺敘事、虛擬攝影機規劃有興趣的人,會較容易看出這個項目的價值。

項目主頁 · Paper

Categories: 視頻模型, 模型訓練, Video, 框架, 3D

Deform360 補上可變形物體世界模型短板

做布料、繩索、海綿這類可變形物體研究,最缺的往往不是模型,而是夠完整的真實數據。Deform360把多視角影像、觸覺與3D標註放在同一套資料流程內,定位相當清晰。

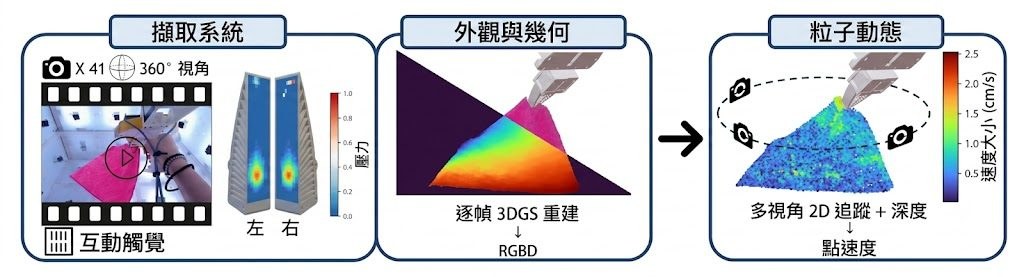
Deform360: per-frame 3D reconstruction alongside 360-degree multi-view capture.

一遇到布料、線材或柔軟玩具,很多世界模型很快就會暴露盲點:畫面看得到表面變化,卻未必掌握形變本身。Deform360屬於Dataset 數據集項目,集中處理的正是可變形物體研究長期缺少的真實多模態資料,讓2D video world models與3D particle world models可以放在同一基準下比較。

它的吸引力不只在於量大,還在於資料結構相當完整。項目收錄198件日常可變形物體、1,980段機械人互動、215.7小時累積錄製內容,配合41部同步720p RGB相機做360°拍攝,另有雙手UMI-based tactile grippers的四組16×32觸覺串流。對研究團隊來說,這代表不只是「有影片可看」,而是可以對齊視覺、觸覺、相機幾何與3D粒子標註去做分析。

跟不少只提供單視角影片、少量物件,或者只放最終標註的資料集相比,Deform360更重視重建與對齊流程。作者採用markerless visuotactile tracking pipeline,把ArUco calibration、3D Gaussian Splatting、CoTracker3與physics-informed refinement串起來,目的不是包裝成一鍵訓練工具,而是把可重用的資料契約、幾何工具、annotation I/O與multimodal alignment utilities公開。

  • 針對198件可變形物體,涵蓋多視角影像、觸覺與dense 3D particle annotations
  • 適合比較2D video world models與3D particle world models在真實形變上的差異
  • GitHub 目前主要釋出資料存取、preprocessing、geometry與對齊工具
  • 未附world-model baselines、training code、pretrained checkpoints或一鍵端到端流程

部署與測試的理解方式也要先講清楚:這不是拿來即刻訓練完整模型的全包框架。現有儲存庫提供Python 3.10以上的安裝入口,並連到 Hugging Face 資料集;你可以把它當成研究資料管線與讀取工具,用來下載資料、做相機去畸變、處理觸覺對齊、載入標註與幾何資訊。原始資料沒有提供完整基線訓練流程,因此較適合已有world model、tracking或robot learning流程的團隊接入。

性能方面,項目頁面有交代基準結論:ParticleFormer在held-out episodes預測較好,pretrained Cosmos在unseen objects的視覺指標領先,但可能偏離指令動作。這種結果也反映Deform360的價值不在於替某一類模型背書,而是把可變形動態、視覺觀測與觸覺證據放回同一個較公平的測試場。相關模型與方法脈絡包括2D video world models、3D particle world models、ParticleFormer、Cosmos,以及資料製備中用到的 CoTracker3 與 3D Gaussian Splatting。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, 世界模型, 模型訓練, Video, Robotic, 3D, Python, Dataset 數據集

InternVLA-A1.5:機械人策略一體化新路線

想像同一個模型既睇得明畫面與指令,又會預想下一步場景,再直接輸出動作。InternVLA-A1.5吸引之處,正正在於它把這三件事收在同一套機械人政策裡。

InternVLA-A1.5 teaser

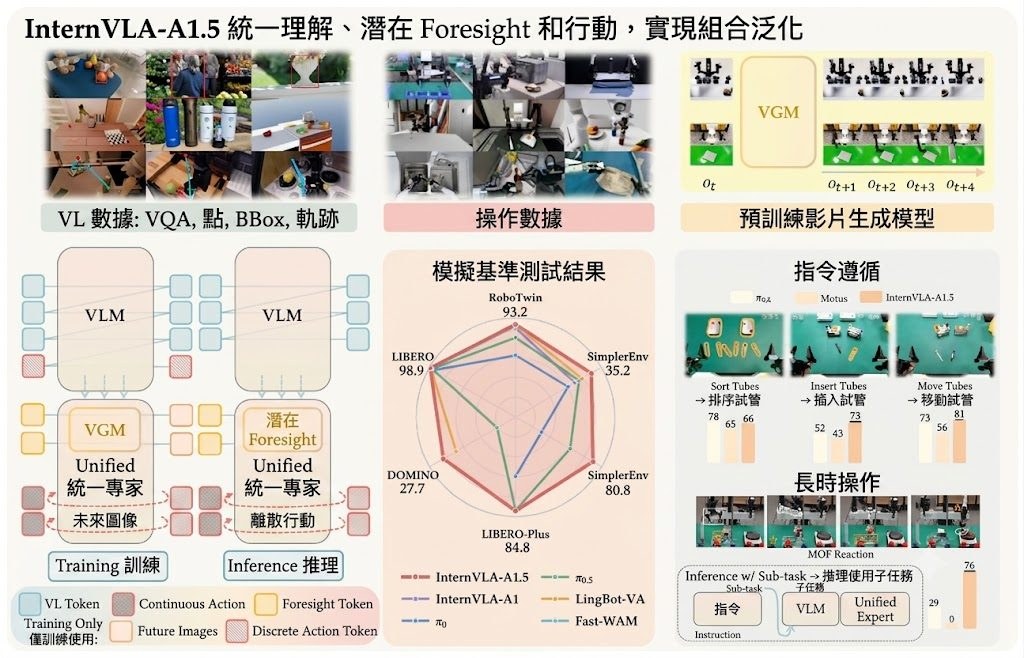
機械人操作最麻煩的地方,往往不是單純辨認畫面,而是要同時理解指令、估計接下來會發生什麼,再穩定地做出連續動作。InternVLA-A1.5屬於開源框架兼機械人政策模型,焦點放在把 vision-language understanding、latent visual foresight 與 action generation 合併,減少多模組串接帶來的延遲與協調成本。

它的取向很清楚:不少做法會把感知、未來預測、控制分開訓練或分開部署,InternVLA-A1.5則把 foresight 放進同一條政策路徑,在訓練期間借助凍結的 WAN2.2-5B video generation model 提供未來動態監督,但推理時丟棄 video branch,只保留動作預測。這個設計的好處是保住「先想一步」的能力,同時避免部署到真實機械人時推理太重。

模型骨幹建基於 Qwen3.5-2B VLM,透過 shared full-attention layers 接上一個輕量 unified action expert,並保留 modality-specific Gated DeltaNet processing;動作輸出則用 flow matching 預測 continuous action chunks。README 亦提到它可用於部署、數據收集和評估真實機器人上訓練有素的操作策略,但公開資訊較集中在模型與 benchmark,具體安裝流程與真機部署步驟未見完整展開。

  • 舊路線常把理解、預測、控制拆開,這個項目改為單一 policy 統一處理
  • 訓練用 WAN2.2-5B 學未來動態,推理時移除相關分支,換取較實際延遲
  • 已在 LeRobot V2.1 dataset 微調,亦結合大規模機械人與多模態資料
  • 基準成績突出:RoboTwin 2.0 為 93.2,LIBERO 為 98.9,LIBERO-Plus 為 84.8
  • 可取得的相關模型包括 InternVLA-A1.5-base、InternVLA-A1.5-RoboTwin、InternVLA-A1.5-Libero

從定位來看,它較適合想把研究原型推近真機驗證的團隊,尤其是同時重視語言理解、視覺泛化與操作成功率的人。現階段最值得留意的,不只是分數高,而是它示範了一種更接近完整機械人工作流的整合方式;限制則是公開說明仍偏研究導向,真正落地前仍需自行補足部署細節與硬件整合資訊。

項目主頁 · GitHub · 模型

Categories: 開源, 上海人工智慧實驗室, 視覺模型, 多模態模型, 視頻模型, Qwen, Video, VLA, Robotic, Dataset 數據集

EVA-Client 補上真實機械人部署斷層

訓練好嘅操作策略,去到真實機械人往往先開始出現混亂。EVA-Client想處理嘅,正正係部署、記錄同評測之間長期分散嘅那段流程。

EVA-Client Logo

研究團隊把模型訓練做得愈來愈完整,但一到真實機械人落地,常見情況仍然是靠零散 script、臨時橋接同各自為政嘅除錯流程撐住。EVA-Client屬於開源框架,集中處理已訓練操作策略喺真機部署、數據收集與評估之間嘅斷層,重點唔係再訓練一個新模型,而係令整個閉環更可重用。

它同一般只覆蓋單一步驟嘅工具唔同,將 transport、policy backend 同 inference strategy 放入同一套流程,支援 ROS1、ROS2、ZeroMQ 同 offline dataset,也能接 OpenPI、OpenPI-RTC、StarVLA、GR00T、mock、replay。作者明顯想修正「訓練框架成熟,但真機端仍然拼裝化」呢種既有範式,所以瀏覽器內直接整合 debug、部署、錄製、重播同比較,定位相當鮮明。

使用路徑方面,現有資料已交代可以用 .py config 串接機械人通訊、策略後端與推理策略,再透過介面喺 DEBUG、COLLECT、RESULT 分頁切換;不過完整安裝細節仍然要配合官方文件先夠穩陣。資料收集亦唔止錄影,還會保存 camera video、3D URDF scene、state charts、milestone scores,同步回放亦保留 QC PASS/FAIL 與每幀品質旗標,對做 dataset 整理同失敗分析幫助幾大。

  • 把部署、收數同評測放入同一個 browser workflow,減少真機迭代時來回切換工具
  • 支援多種 transport、backend 同 inference strategy,取向偏向兼容不同機械人與策略棧
  • 內建 live latency compensation、async strategy 同 replay,重點放喺真機穩定度而唔只係跑通
  • Teleop demos 與 model rollouts 共用同一套 on-disk layout,方便後續整理成 LeRobot v2.1 episodes

性能數字方面,現有資訊未見統一 benchmark 分數,較多是能力與流程層面的描述,所以暫時唔適合把它理解成用單一指標決勝負嘅項目。較受惠嘅會是做 VLA、VAM、WAM 或機械人操作研究嘅團隊,尤其要頻繁比較 checkpoint、遠端連 policy server、或者同時管理多款真機平台嘅場景;已列出可配合嘅相關模型與系統包括 OpenPI、OpenPI-RTC、StarVLA、GR00T,以及 LeRobot、VLA Foundry 呢類訓練側框架。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, NVIDIA, DeepSeek, Video, VLA, 3D, Dataset 數據集

LingBot-Vision 補強密集空間感知

想做深度估計或語意分割,但又唔想每個下游任務都重訓視覺編碼器,LingBot-Vision正是針對這個卡位而來。它把邊界、形狀同語意區域一併學好,重點放在更可靠的空間特徵。

Boundary-centric masked modeling

做深度估計、語意分割或者影片物件分割時,最麻煩往往唔係有冇大模型,而是編碼器抽出的特徵夠唔夠貼近物件輪廓。LingBot-Vision屬於模型,更準確地說是自監督預訓練的 Vision Transformer 視覺骨幹,處理的是密集空間感知裏面「語意有了,但邊界唔夠準」這個老問題。

它的取向幾明確:唔係一味追求分類式語意表示,而是用 masked boundary modeling 去逼模型同時保留空間結構與語意訊息。凍結後的 patch tokens 已經可以直接支援輕量 readout,涵蓋 depth estimation、semantic segmentation、video object segmentation,亦作為 LingBot-Depth 2.0 的 visual encoder 初始化,這種設計比起只偏重全局語意的 ViT 骨幹,更適合需要逐像素判斷的工作流。

這個項目較接近「取用預訓練骨幹再接下游任務」的用法,而唔係即裝即用的完整應用。模型已放到 Hugging Face 與 ModelScope,較合理的理解方式,是把不同尺寸的 LingBot-Vision 權重接入現有 dense prediction pipeline,先測 frozen features 的表現,再決定需唔需要額外微調。

  • 重點不在生成內容,而在提高 dense spatial perception 的特徵品質
  • 已公開多個相關模型:ViT-S/16、ViT-Base、ViT-L/16,以至 1.1B 參數的 ViT-g/16
  • 支援的方向包括 depth estimation、semantic segmentation、video object segmentation、depth completion
  • 與同類做法相比,更重視 boundary-faithful features,而唔係只強化高層語意表示

受益最大的會是做機械人視覺、3D 感知、影像理解基建的團隊,尤其當你手上已有 segmentation 或 depth 項目,只差一個更穩定的 encoder。性能方面,README 用「substantial performance gains」形容 LingBot-Depth 2.0 在換上 LingBot-Vision 編碼器後的提升,但公開內容未列出完整基準數字,所以現階段較值得先留意其特徵可遷移性,以及在邊界敏感任務上的潛力。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, Video, VLA, 影像處理, Robotic, 3D

Wan Streamer v0.2 提升實時視頻對話畫質

想做會講話、會望向場景嘅即時 AI 角色,畫面清晰度同延遲通常要二揀一。Wan Streamer v0.2 嘗試保住低延遲,同時把視訊互動提升到更自然可用。

Wan Streamer framework

做即時音視頻互動時,最麻煩往往唔係模型識唔識回應,而係畫面一清晰,延遲就容易升高。Wan Streamer v0.2 屬於原生流式 audio-visual interaction model,針對呢個取捨下手:把輸出由 192×336 提升到 640×368,仍維持 25 fps,同時把模型側延遲控制在約 200 ms。

它延續 v0.1 的做法,將文字、音訊、影片放在同一條 causal timeline,用單一 Transformer 協調,並以 block-causal attention 處理串流互動。重點唔係換掉整個架構,而係在低延遲預算不變下,令畫面由近景視像通話,擴展到更有場景感的中景 agent,連姿勢、視線、手部同附近物件都更易看清。

為咗撐起更高解析度而唔增加可見等待時間,v0.2 把高成本 latent 生成路徑移到 Ulysses-style context-parallel performer;另一邊的 thinker 仍留在單 GPU,負責流式感知、狀態更新、KV 建構同最終解碼。呢種分工代表項目唔係單靠堆硬件換速度,而係重新安排推理拓撲,把重負載部分放到更適合並行處理的位置。

  • 輸出解析度由 192×336 提升到 640×368
  • 幀率維持 25 fps,模型側延遲約 200 ms
  • 支援 scene-grounded mid-shot agents,而唔只係近景通話畫面
  • 保留單一 Transformer 的 native-streaming formulation
  • 以 thinker + performer 分工處理低延遲與高成本生成

呢個項目最適合想做即時數字人、互動客服、教學導覽或直播型 agent 的團隊,因為使用者會直接感受到畫面資訊量增加,但對話節奏未必因此變慢。現有資料主要強調架構升級同延遲維持,更完整畫質穩定性、部署成本與長時間使用表現,仍要配合論文與示範一齊判斷。

項目主頁 · Paper

Categories: 阿里巴巴, Agentic, 多模態模型, Video, Audio

Page 15 of 21
1 13 14 15 16 17 21