SemComp-Bench:影片生成評測由「似樣」走向真正完成任務

SemComp-Bench 不只看生成影片是否逼真,還檢查指定結果有否完成,以及關鍵語義是否仍然保留。

Repository image for Kelly372/SemComp-Bench

一段影片畫面流暢、物件外觀相近,不代表它真的完成了指令。SemComp-Bench(Benchmarking Semantic Task Completion in Video Generation)把評測焦點放在「結果有否做到」和「是否仍然保留與任務相關的語義」;GitHub 項目則是一套用來建立 SemComp-Data 的資料處理管線,處理影片篩選、狀態定位、指令整理和結果標註。

由原始影片到可評測資料,流程分成 9 個階段:先按標題過濾及分類任務,再定位 reference frame 與 outcome state,檢查畫面質素和狀態順序,產生中英雙語的簡短及詳細指令,最後抽取 outcome-centric clips、標註 semantic alignment types,並描述結果狀態。這種做法把評測所需的參考畫面、指令和完成結果放在同一段真實影片脈絡中,較適合檢查模型是否真的做到指定改變,而不只是產生看似合理的畫面。

項目屬於影片生成評測的資料集建構工具,實際解決的是把零散影片整理成可驗證、可重複評分的任務樣本。SemComp-Bench 目前提供 1,273 個結構化樣本、6 個真實世界領域、60 個 SemComp-Core cases,平均 outcome-centric clip 約 4.03 秒,並配有兩種指令、四類 reference alignment types,以及 27 個評測取樣畫面。

使用者需要 Python 3.10 或更新版本、ffmpeg、ffprobe,以及供第 2 至第 5 和第 7 至第 9 階段使用的 multimodal model service;第 6 階段的 ImageBind inference 建議使用支援 CUDA 的環境。原始影片、模型權重、服務憑證和執行輸出均不隨儲存庫提供,因此較適合研究團隊按自己的影片及模型服務重建資料,而不是下載後即時取得完整數據集。

  • 以 outcome achievement 配合 semantic grounding,避免只用畫質或 prompt alignment 判斷成功
  • 透過 reference frame、outcome state 和短片建立完整評測三元組
  • 1 至 7 階段通常會輸出 snapshot、excluded set,技術失敗另有 error.parquet
  • 可用 tests/ 的離線回歸測試檢查處理流程
  • splitting/ 含改編自 Panda-70M 和 ImageBind 的元件,非商業授權限制需要先審閱

對研究生成影片、製作評測數據,或需要分析任務完成率的團隊而言,這套管線提供了清楚的重建入口;但它依賴外部多模態模型服務和本地媒體資源,資料建立成本與授權審查仍是採用前必須計算的部分。

項目主頁 · GitHub · 數據集

Categories: 開源, 視覺模型, 多模態模型, NVIDIA, Video, Python, Dataset 數據集

V-RAE 重整影片潛空間,生成更快更準

V-RAE把影片生成前最難處理的時間冗餘壓細,同時保住語意結構。對想做重建、生成同預測建模的團隊,呢個方向幾有參考價值。

V-RAE method

做影片生成時,潛空間一旦又大又雜,訓練速度、重建品質同後續生成都會一齊受拖累。V-RAE放喺呢個位置切入:它屬於影片表示自編碼器模型,將 frozen vision foundation model 的表徵再壓成更緊湊的 generative latents,處理的是影片表示太冗長、但又不能失去語意同動態連續性的問題。

V-RAE不是重新訓練整個視覺骨幹,而是接在 DINOv3、SigLIP2、V-JEPA2.1、EUPE 這類 frozen encoder 之上,用 lightweight temporal pooling module 減少時間維度上的重複資訊,再交由 video decoder 重建連續動作。這種做法的取捨在於,它更依賴現成視覺表徵的品質,但換來較輕量的影片 latent 壓縮流程,亦令 semantic latents 可以變成 directly decodable predictive state space。

V-RAE:重构视频潜在空间以实现高效生成 2026-08-16

項目提供了訓練、評估與重建示例所需的程式結構,安裝條件寫明要用 Linux、NVIDIA GPUs、CUDA 相容驅動、FFmpeg,以及 Python 3.10 或以上。可配合已釋出的 checkpoints 與對應 frozen encoder 做重建測試,但能否自由下載、下載範圍是否完整,仍要以當前發佈頁面為準,不適宜直接假設任何人都可無限制取得全部模型。

結果 V-RAE在 K600 reconstruction 取得 2.13 rFVD,數值優於文中比較的大型 pretrained video VAEs;class-conditional generation 則在 UCF101 與 K600 分別達到 117.86 與 19.16 gFVD,並提到可快最多 6 倍收斂。作者亦提出 tFVD,令它與人類判斷的一致性提升,在 UCF101 與 K600 的 Pearson correlation 分別達到 r = 0.621 與 r = 0.919,這點對影片生成評測有直接意義。

  • 接在 frozen vision foundation model 後面做壓縮,避免由零建立整套影片表徵
  • 用 temporal pooling 減少時間冗餘,同時保住 semantic structure
  • 同時覆蓋 reconstruction、class-conditional generation 與 predictive modeling 場景
  • 倉庫已包含 training、evaluation、sampling 所需結構,但部署前提偏向研究級 Linux + NVIDIA GPU 環境
  • 適合研究影片生成、世界狀態建模、長序列表示學習的團隊參考其 latent 設計

V-RAE較適合有影片模型實驗能力的研究團隊、做 VideoDiT 類生成流程的人,以及想把影片 latent 拿去做預測狀態空間建模的項目。對於怎樣把強大的視覺表徵轉成更可生成、可重建、可評測的影片 latent,已經給出一條相當具體的路線。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Linux, Python

Qwen-Video-Edit:開源影片編輯模型

它把文字指令式影片編輯做得更直接,透過現成的 image editing model 去改寫影片 latent。對需要長片段、分段修改同一條影片的工作流,會比重起一套 video transformer 更省力。

input contact sheet

Qwen-Video-Edit 是一個 instruction-based video editing 項目,核心做法是把 Qwen-Image-Edit 直接搬去處理影片 latent,再用兩個可訓練 projection 接上 Wan 2.1 的 video-VAE。這樣做的價值很清楚:不用再依賴 video-pretrained transformer,也能按文字指令改影片內容。

安裝和測試路線已經整理得相當明確。train.py 走單機多 GPU 訓練,infer.py 負責長影片逐段編輯與 Wan 2.2 denoising-enhancement,dataset.py 則讀取 Ditto 格式的 source、edited、instruction 配對。

和一般影片編輯方法相比,差異在於它不是從頭學影片理解,而是借用影像編輯模型的先驗,再用 warm-started projections 與 grid positional encoding 去補上時間維度。這代表訓練成本和架構複雜度較低,但限制也在於效果仍仰賴 Wan 2.1 latent 空間、Ditto-1M 資料,以及後段 enhancement。

  • 支援 LoRA 或 full fine-tuning,取捨在訓練成本與自由度之間
  • 長影片可以分段套用不同指令,適合剪接、局部修改、旁白對齊內容
  • 輸出 checkpoint 以 trainable-weights-only .safetensors 形式提供,載入流程較直接
  • 另有 zero-training demo,可先看 image-grid 與 latent-grid 編輯行為
  • 模型權重已公開,方便直接做復現或二次改造

項目主頁 · GitHub · 模型

Categories: 開源, 視頻模型, 模型訓練, Qwen, Video, Image, 影像模型, Dataset 數據集

MiniMax H3 整合成單一節點,ComfyUI 剪走繁瑣接線

把 MiniMax H3 的影片流程收成一個節點,省去搭工作流和找模組的時間。它更像一個整合入口,讓生成、延伸、關鍵幀同音訊驅動集中處理。

Buy Me a Coffee at ko-fi.com

在 ComfyUI 裡要跑 MiniMax H3 影片流程,最麻煩往往不是模型本身,而是工作流太碎。ComfyUI-ALLinONE-MinimaxH3 把這套流程收成單一節點,屬於 ComfyUI 的工具項目,目標是把文字生成影片、圖片轉影片、參考圖驅動、音訊帶動嘴型同影片延伸放進同一個入口。

安裝方式很直接:放入 ComfyUI/custom_nodes/ 後重啟 ComfyUI,再在畫布搜尋 ALL in ONE MiniMaxH3。項目主打幾個模式,包括 Image、T2V、I2V、R2V、Audio Drive、Keyframes、Extend 同 Chain,實際用法是先揀模式,再輸入 prompt 或參考素材,由節點接管後續流程。

官方 MiniMax H3 原生工作流、ComfyUI-H3-Motion-Context-MultiRef、MiniMax H3 Turbo pack,同埋 H3 Studio 的圖片模式都被包進同一個介面,對需要反覆試片段、接續鏡頭、處理多參考素材的影片製作流程特別實用。

  • 支援 T2V、I2V、R2V、Audio Drive、Keyframes、Extend、Chain
  • Chain 用 H3 Motion Context 做多段續接,走 latent path,避免重新編碼
  • 內建歷史、收藏同預覽,方便回看 prompt 同結果
  • 亦有 RTX / Seed2VR Video Super Resolution 的 upscale 接口
  • 作者標明仍屬 Beta,兼容性要跟指定版本和模型清單對齊

目前較適合已經在 ComfyUI 裡做影片生成、又不想每次重砌圖的人。官方工作流仍然是底層來源,呢個項目更像把常用路徑包成一個操作面,方便快速試片、改參考圖同續接片段。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Image, Audio, MiniMax

EditBridge 更穩定的4K 影像編輯

EditBridge 把低解析度編輯和高解析度修復接起來,避免放大時細節走樣。它適合要保留原圖紋理、文字和結構的影像編輯流程。

Overview of the EditBridge paradigm

EditBridge 是一個影像編輯框架,目標很直接:在 1K 到 4K 的高解析度輸出下,仍然保住原圖細節,而不是放大後再補出一堆不一致的紋理。它把粗編輯結果先交給 diffusion bridge 再修復,讓高解析度原圖繼續參與推理,不用把整張圖重生成一次。

和常見做法相比,它的取捨在於把「補細節」改成「沿著已對齊的內容做橋接」。核心做法是 PG-BSA(prior-guided block-wise sparse attention),用先前編輯階段的對應關係去挑選需要看的區塊,減少密集全局注意力帶來的成本,同時降低高頻細節失真。

倉庫已經交代了基本使用路線:先建立 Python 環境,再安裝項目,下載 Qwen-Image-Edit-2509 checkpoint,之後用 CSV 準備 source_image、target_image、condition_image 和 prompt。訓練時還要先抽取 target-to-source correspondences,1K、2K 與 4K 的流程分開處理,4K 版本則透過降低記憶體消耗來跑。

這套方法較適合做高解析度修圖、產品圖改寫、海報文字修正,或者任何不能接受放大後失真、塗抹感太重的工作流。它的評估重點也很清晰:在 1K 到 4K 的 reconstruction 和 perceptual metrics 都維持領先,推理時間比直接高解析度生成和傳統 diffusion 超解析度方案更實用。

  • 保留原始高解析度 source 作為條件,減少細節漂移
  • 用 coarse edit 接 diffusion bridge,再做高解析度修復
  • PG-BSA 透過區塊級稀疏注意力控制計算量
  • 1K、2K、4K 都有對應訓練流程
  • 適合重視文字、邊緣、紋理一致性的編輯任務

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Qwen, Image, Python

MOSS-VL 多模態模型系列,致力於實時視覺理解。

MOSS-VL 針對直播式影片理解而來,讓模型邊看邊答,不再只靠看完才回應。它同時提供即時、離線與基礎三個版本,適合不同工作流。

MOSS-VL

MOSS-VL 是一組 video-language model,核心解法是把長影片理解從「先看完再回答」改成連續影片流上的即時對話。MOSS-VL-Realtime 會在收到新畫面時同步做感知與文字生成,遇到資訊不足時還會先保持沉默,等場景有變化再回應,這比一般離線影片模型更貼近直播、監控和互動式分析的需要。

項目的三個版本分工清楚:MOSS-VL-Realtime 主打串流互動,MOSS-VL-Instruct 偏向離線長影片理解與深入對話,MOSS-VL-Base 則提供可再訓練的基礎表示。三者都屬於 11B 參數的 open-weight 模型系列,架構上採用 unified cross-attention,重點不是單純堆大,而是把影片、問題和回答放進同一條流裡處理。

  • 支援任意時間點提問,適合直播解析、即時巡檢與互動式看片
  • 會主動等待關鍵事件,再決定是否開口,減少過早下結論
  • 新畫面一到就可修正先前回答,較適合連續變化的場景
  • MOSS-VL-Instruct 適合長影片分析,MOSS-VL-Base 適合延伸訓練
  • 官方資訊有 Hugging Face、ModelScope、Web demo 與論文連結,但原始資料未提供完整本地安裝流程

同類做法多數仍是離線式理解,先把影片看完才輸出答案;MOSS-VL-Realtime 則把回應插進觀看過程,連延遲和中途修正都納入設計。這種取捨對需要即時判讀的團隊更實用,尤其是做影音監察、現場助理、互動式多模態應用,或要在長影片上做持續問答的情境。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, Video

TRACE-Bench 拆解多參考生圖失誤來源

多張參考圖生成得似,未必代表每個要求都做對。TRACE-Bench把失誤拆成可追蹤能力,方便看清模型真正卡在哪裏。

Og image

生成圖片時同時引用多張參考圖,最難的地方往往唔係畫面夠唔夠完整,而係模型有冇準確保留指定主體、抽出正確屬性,再綁到啱嘅目標上。TRACE-Bench屬於 Multi-Reference Image Generation Benchmark,處理的正是這類「成品看似合理,但細節要求逐項出錯」的評估問題。它不再只用一個總分判斷好壞,而是把每條提示拆成可追蹤的能力步驟,讓研究者知道錯誤發生在身份保留、屬性抽離、屬性綁定,還是多元素構圖。

這個基準最核心的做法,是用四個原子操作統一資料建構、評分與診斷流程:Anchor負責鎖定並保留參考主體的身份特徵,Disentangle負責把某個屬性從原本載體抽離,Apply負責把抽出的屬性自然地套到指定目標,Compose則負責在空間、關係或整體場景限制下安排多個內容。TRACE-Bench把每個 prompt 表達成 compositional formula,令多參考生成不再只按「風格轉移」或「主體組合」這類粗分類來看,而是按能力需求逐層拆解。

它和常見 benchmark 的差異,在於評估單位由任務類型改成能力組合。原有做法容易出現覆蓋不足、案例難度難比較、失敗原因不透明等問題;TRACE-Bench則把同一套公式結構用於案例生成與對齊評分,並要求參考資訊有精準 grounding。資料規模方面,這個 benchmark 約有1,600個 evaluation cases、631個公式模板、約4,000張 reference images,覆蓋1至8個 operator slots,並評估了9個領先模型。現有結果顯示,真正的瓶頸主要落在 attribute disentanglement 同 binding,不是單純的場景級 composition。

對模型研究、影像生成工作流設計,甚至要挑選評測方法的團隊來說,TRACE-Bench的價值在於它能把「生成得唔錯」這種籠統印象拆成具體能力地圖。當案例失敗時,它還會用遞迴簡化方式做 diagnosis,逐步定位干擾來自哪一個參考需求。對於想改進多圖條件生成、測試 reference-following 能力,或者分析模型為何經常把屬性套錯對象的人,這種可追溯結構比單一總分更有用。

  • 用四個操作符描述多參考生成:Anchor、Disentangle、Apply、Compose。
  • 每個 prompt 都可寫成 compositional formula,方便控制複雜度與對齊評分。
  • 約1,600個案例涵蓋1至8個 operator slots,資料來自約4,000張參考圖。
  • 九個模型的評估結果指出,屬性抽離與屬性綁定比場景構圖更常成為瓶頸。
  • 原始資料聚焦 benchmark 設計與診斷方法,未提供一般讀者可直接下載或部署的完整使用流程。

整體來看,TRACE-Bench不是再增加一批「看圖感覺差不多」的測試題,而是把多參考生圖最難處理的依賴關係寫成可分析、可比較、可回溯的結構。當模型要同時記住誰是誰、哪個屬性要抽出、又要套到哪個實體上時,這套方法更能反映能力上限與失誤模式,也讓後續改進有更清晰的落點。

項目主頁

Categories: AI productions, Image, 框架, Dataset 數據集

[技術文章] pixel-space 模型可以追平甚至超過 latent-space 對應模型

研究聚焦 pixel-space text-to-image diffusion models 的訓練卡位,找出點樣喺大規模條件下兼顧畫質同速度。作者用 latent-to-pixel 策略,令 pixel-space 模型更接近甚至超過 latent-space 表現。

Hero image preview

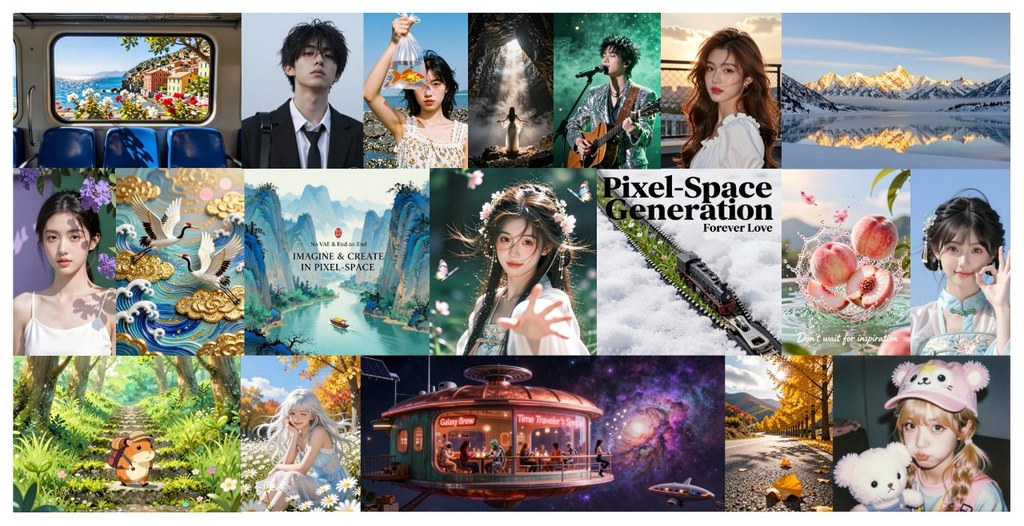
上圖是透過 pixel-space text-to-image diffusion models 的方法訓練的 Z-Image-Turbo (Pixel) 產生的圖像。在企業級 H800 GPU 上,推理延遲僅約 0.2 秒。

Pixel-space text-to-image diffusion models 一直有兩個吸引位:直接生成像素,唔受 VAE 壓縮上限限制,亦可以省去解碼步驟。但喺大規模訓練下,佢哋收斂速度明顯慢過 latent-space 模型,令「畫質、效率、可訓練性」三者之間嘅平衡一直唔夠成熟。

呢篇工作針對嘅正係呢個落差。作者先比較 pixel-space 同 latent-space 喺大規模 pre-training 下嘅行為,再提出 latent-to-pixel 策略:先喺 latent space 學到生成先驗,再轉去 pixel space 做 post-training,避免一開始就喺難度更高嘅像素空間硬推。

佢哋亦系統研究咗多個轉換設計,包括 weight initialization、data composition、prediction target、decoder architecture 同 noise schedule,整理出一套可行做法。結果顯示,做法調整得當之後,pixel-space 模型可以追平甚至超過 latent-space 對應模型,推理端仲有 3.18 到 4.75 倍嘅速度提升。

  • 直接處理 pixel-space diffusion models 喺大規模訓練時收斂慢嘅問題
  • 用 latent-to-pixel 路線,先學先驗,再轉入像素空間微調
  • 檢視多個關鍵訓練選項,搵出實用 recipe
  • 在畫質不退讓之下,換取更快的 end-to-end inference
  • 對想做高效文生圖系統、又在意生成細節保留嘅團隊最有參考價值

Paper

Categories: 香港科技大學, 南京大學, 阿里巴巴, 模型, 模型訓練, Image, txt2img, 香港

GenRouter AI 圖像生成變成會分流的工作流

它把 agentic image generation 由單一路徑改成可分流的工作流,按任務難度配對不同執行方案。對要兼顧畫質、文字準確度同運算成本的團隊,這種做法比硬套同一套流程更有彈性。

Figure1 00

安裝方式偏向研究原型工作流,先建立 environment.yml 對應的 Conda 環境,再按 scripts/services/ 和 scripts/serve.sh 需要下載本地模型。README 亦提到 OneIG 同 WISE 有獨立環境,代表它不是單一命令就能完整跑通的輕量工具,而是要跟着項目內的服務配置同基準測試流程去部署。

GenRouter 處理的不是單純「生成得靚唔靚」,而是把不同提示詞導向不同算力配置。當任務涉及多步空間推理、精準文字渲染,或者需要較高視覺質素時,GenRouter 會揀更合適的執行計劃;較簡單的請求則不必走沉重流程,這種取捨直接針對延遲同成本問題。

  • GenCanvas 將 agentic image generation 拆成通用原語,方便重用工作流
  • GenRouter 以需求分析、記憶輔助匹配同 Pareto filtering 做路由
  • 目標是減少「一刀切」流程造成的算力浪費
  • 比較適合做圖像代理、生成管線同研究型系統的團隊
  • README 未見完整公開的數值結果摘要,較適合當作框架型項目理解

GitHub

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, Qwen, Image, 影像模型

NaviDC-OCR:1.2B 參數文檔 VLM,統一處理相機與數碼文件

NaviDC-OCR 把文件理解收斂到一個輕量 Vision-Language Model(VLM)流程,對掃描件和手機拍攝文件都能一起處理。它的重點不只在識別文字,還在版面、表格與公式之間的結構還原。

icon

NaviDC-OCR 是一個輕量級 Vision-Language Model(VLM),專門處理 document understanding,也就是把文件內容、版面和結構一併讀出來。它最實際的價值,在於同時應付 digital documents 和 camera-captured documents,尤其適合文件拍攝角度不正、透視變形或版面較複雜的情境。

這個項目已釋出模型權重與 technical report,使用方式偏向直接載入 Hugging Face 上的模型做推理或再訓練,而不是一套獨立應用程式。它的訓練流程結合 Multi-node Consensus Voting(MCV)、Image-to-Image Self-Verification,以及 progressive four-stage training,顯示作者把大量標註成本轉移到自動化資料整理與驗證。

  • 1.2B 參數,定位是輕量部署而非堆大模型。
  • 同時面向掃描文件與相機拍攝文件,覆蓋範圍比只做單一路徑的做法更廣。
  • Geometry-aware Document Modeling 與 Curvature-Guided Douglas-Peucker Sampling(CGDP)主要針對彎曲、傾斜和變形頁面。
  • Content-Structure Decoupled Learning 令表格與公式的內容和結構分開學,較適合複雜文件。
  • 作者聲稱在多個 benchmark 上有強表現,但具體部署成本仍要視推理框架與硬件而定。

和不少只偏重 OCR 文字抽取的做法相比,NaviDC-OCR 更像是把「看懂文件」放在第一位:它不只要讀字,還要保留版面關係與幾何資訊。這會令它在企業文件處理、票據整理、表格抽取、學術文件解析,或者手機拍照掃描的工作流裡更有用,但它仍然是研究型模型,落地時要留意速度、記憶體與實際文件分佈是否接近訓練資料。

GitHub · 模型

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, Image, Dataset 數據集

Page 29 of 55
1 … 27 28 29 30 31 … 55