LeapTalk:1 步生成會話數字人

講人像相片同語音,就能連續生成對嘴影片。LeapTalk把速度拉到接近即時,同時盡量守住人臉一致性。

teaser

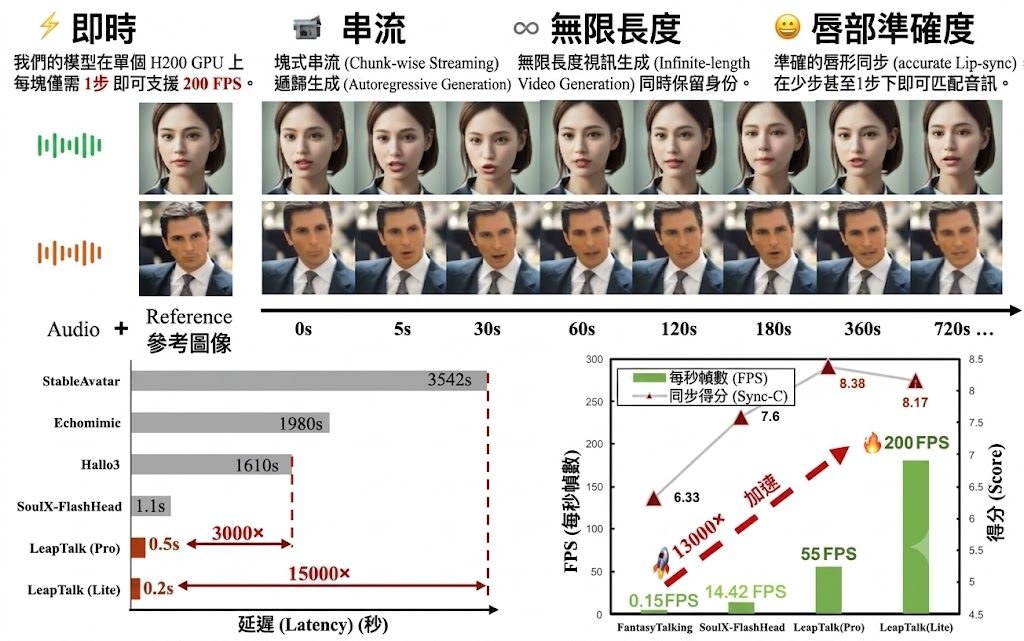
想做會話數字人?卡位通常唔係能否生成,而係夠唔夠快、個樣會唔會愈播愈走樣。LeapTalk屬於開源 talking-head generation 項目,針對的正是即時串流、人臉一致性同嘴型同步三件事一齊要兼顧的難題。

它的吸引力在於每個影片片段只用 1 NFE 就可推進,在 Lite 設定下標示可達 200 FPS,而且 Web Demo 已經做成可載入人像圖、用文字或咪高峰對話的介面。底層並非單靠硬推速度,而是建基於 SoulX-FlashHead-1_3B,再配合 LoRA、audio_proj_step_*.pt、wav2vec2-base-960h,用 audio-driven classifier-free guidance 強化對嘴。

  • 以 chunk-by-chunk streaming pipeline 連續生成長片
  • 用 Brownian bridge 同 Bridge Forcing 減少長片身份漂移
  • README 已交代需另外下載 base model、語音模型與 LeapTalk 權重
  • 推論前要自行填入 COND_IMAGE、AUDIO_PATH 等本地路徑

同類做法常見取捨是速度快但畫面累積誤差,或畫質穩定但延遲高;LeapTalk明顯站在「先把延遲壓到可互動」這一邊,再用 reference-anchored data-to-data transport 補回穩定度。

現適合做數字人互動、虛擬主播、即時內容生成的團隊。200 FPS 與單張 H200 GPU 的說法來自項目提供資訊,普通硬件能否複製同樣效果、Web Demo 的完整部署細節是否齊備,仍要等更多實測佐證。
項目主頁 · GitHub

Categories: 開源, AI productions, 數字人, 視頻模型, 影像處理, Audio

SwanTale 以場景佈局生成

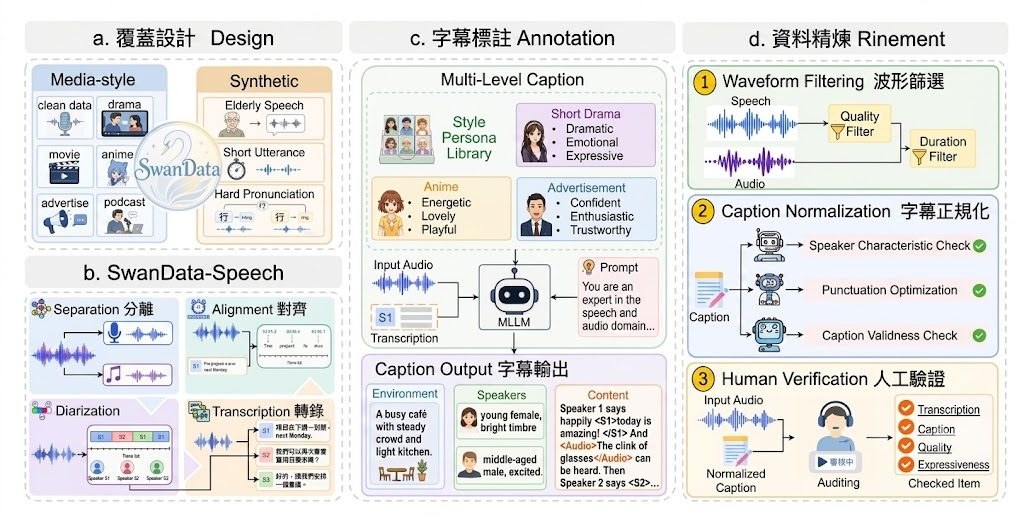
SwanTale 把語音與音訊研究集中成一個入口,重點放在更有表達力的生成能力。

swan logo

比起只追求把字讀出來,字節跳動的 SwanTale 更著重聲音是否自然、有情緒,亦能否處理多人說話生成。這個由 ByteDance 推出的研究項目,焦點放在 expressive audio、speech 與 multi-speaker generation。

現有資料不算多,但已見到它不是單一模型頁,而是一個集合式研究入口,整合 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere 等子項目。對做語音產品、數字人、配音內容與語音互動工作流的人來說,這類整理方式較易追蹤同一研究線的進展。

  • 聚焦 expressive audio、speech 與 multi-speaker generation
  • 由 ByteDance 發佈,定位偏研究整合入口
  • 站內列出 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere
  • 目前公開資訊有限,性能與方法細節仍要逐個子項目再看

它的價值在於把聲音生成從「可用」推向「更像真人表達」,同時覆蓋多人語音場景。現階段較適合先把它視為字節跳動音訊與語音研究的總覽入口,而不是已完整公開規格的單一產品頁面。

項目主頁

Categories: 字節跳動, 數字人, Audio, 語音

MiniMax H3 萬眾期待的開放多模態模型

文字、圖片、影片同音訊都可混合輸入,再直接生成帶原生立體聲的短片。MiniMax H3把理解與生成放進同一套多模態系統,重點在跨模態一致性。

Og image

一段提示未必只得文字,亦可以連同圖片、影片甚至音訊一齊交畀模型處理;MiniMax H3就是朝住呢種工作流而設。頁面未提供 based on、base model 或 fine-tuned from 資訊,所以無法確認它係唔係建基於其他基礎模型微調而成,但已清楚標示為 image-text-to-video,而且屬於可同時理解同生成多模態內容的 generative system。

它處理的重點不只是由文字生片,而係把 text、images、video、audio 放入同一個上下文,再輸出最長 15 秒、最短 4 秒、可到 2K 的影片,並且附帶 native stereo audio。呢種設計的價值,在於畫面、聲音同指令可以一齊對齊,適合做 image-to-video、video-to-video、text-to-audio-video 以至 reference-to-audio-video 等任務,減少要分開串接多個模型的工序。

H3 是 task-generalization-oriented system,意思是模型在 pre-training 階段已經針對廣泛任務泛化而設計,唔係只為單一路徑生成。它強調 unified understanding of multimodal contexts,同時支援多種輸入來源與輸出規格;比例覆蓋 21:9、16:9、4:3、1:1、3:4、9:16 等常見格式,短邊預設 768 像素,最高可到 2K,反映它偏向面向內容製作與跨媒體生成,而不只是研究展示。

  • 支援 text-to-video、image-to-video、video-to-video,同時覆蓋 audio-video-generation
  • 可生成 4 至 15 秒影片,並輸出 native stereo audio
  • 輸入上下文可混合 text、images、video、audio,屬於 omni-modal 路線
  • Hugging Face 頁面標示 library_name: diffusers,代表可沿用 diffusers 生態整合

現階段較能確定的是,它把多模態理解與帶聲影片生成放入同一模型體系,對需要一致視聽輸出的項目有直接吸引力,但部署細節仍要等更完整技術文件補足。

項目主頁 · 模型

Categories: 開源, 多模態模型, 視頻模型, Video, Image, 影像模型, 影像處理, Audio, 3D, MiniMax

用 Hermes Agent 自動跑 ComfyUI 影片流程

打幾句文字指令,就能讓 Hermes Agent 在 Windows 控制 ComfyUI,串起影像、聲音到影片生成流程。

Og image

由文字指令直接帶動整條 AI 內容製作流程,正是這段教學最吸引人的地方。影片示範 Hermes Agent 在 Windows 電腦上接手 ComfyUI 操作,把影像、語音與影片生成串成一套可執行工作流,減少人手逐步點擊介面的時間。

這類做法處理的,是多工具協作時常見的斷層:模型會生成內容,但流程仍要靠人逐格設定、切換節點、整理輸出。Hermes Agent 扮演的角色更接近可執行指令的 Agent,讓使用者用自然語言描述需求,再由它推動 ComfyUI 與相關模型完成步驟。

影片標題提到的 Krea 2、LTX 2.3、Qwen 與 Fish Audio,反映這條工作流並不只限於單一模型,而是把視覺、影片與音訊能力接在一起。重點不在單一模型參數,而在於怎樣把不同項目整合成可重複使用的自動化流程。

  • Hermes Agent 可在 Windows 環境控制 ComfyUI
  • 工作流涵蓋影像、音訊與影片生成
  • 輸入形式以簡單文字指令為主
  • 涉及 Krea 2、LTX 2.3、Qwen、Fish Audio 等模型或服務

對內容創作者、想整理 AI 製作流程的人,這類教學特別有參考價值。它未必代表所有步驟都能完全免調整,但已清楚展示 Agentic 工作流如何把 ComfyUI 由節點工具,進一步變成可自動執行的製作中樞。

項目主頁

Categories: ComfyUI, Agentic, AI productions, 視覺模型, 視頻模型, Qwen, Google, Video, Audio, 教學, 安全, LTX

ACE-Data-0:以人為中心的環境式採集構建具身數據引擎

煲水、抹枱、拎杯過房,呢類日常動作其實最難完整記錄。ACE-Data-0 嘗試用同步多模態方式,保留家居活動由開始到完成的全程變化。

Og image

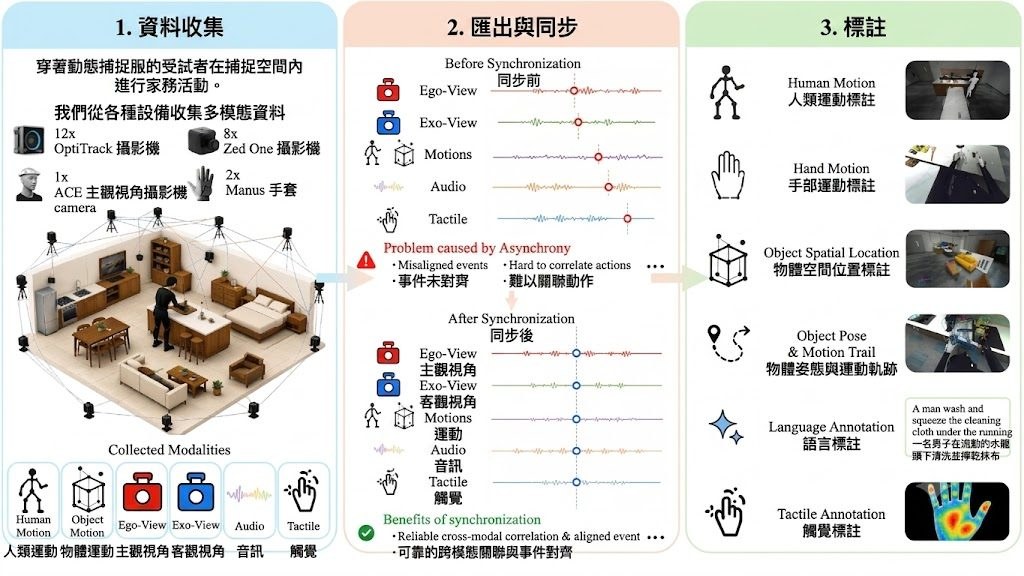
家居環境入面嘅長時間活動,一直係具身 AI 最難補足嘅數據缺口。ACE-Data-0 聚焦嘅唔係幾秒鐘嘅單一步驟,而係一段完整家務流程點樣一路影響視角、身體動作、物件狀態、接觸訊號同聲音,令模型可以學到「同一件事點樣隨時間演變」。

項目背後用 Ambient Capture Engine(ACE),將真實住宅場景變成同步錄製系統,並且同時覆蓋 table-scale 同 room-scale 兩個尺度。重點唔止係拍到第一身畫面或者外部鏡頭,而係將 ego view、exo views、body motion、hand articulation、object state、audio 同 touch 對齊到同一時間線,整理成可訓練、可標註嘅 embodied AI 數據。

相比只提供單一視角影片、實驗室動作捕捉,或者只得短片段互動記錄嘅常見做法,ACE-Data-0 更著重完整性同連續性。它以 household goal 為單位記錄活動,參與者自然完成任務,過程可以跨房間、牽涉多個物件,亦會保留場景由初始狀態、中途改變到任務完成嘅完整軌跡,較適合研究長程規劃、狀態追蹤同記憶能力。

  • 用同步多模態方式記錄真實家居活動,而唔係只截取短動作片段
  • 同一事件內對齊視角、身體、手部、物件、聲音同接觸訊號
  • 以目標導向活動收集數據,保留跨步驟、跨房間嘅連續變化
  • 適合具身 agents、機械人感知與操作、長時序決策相關研究

現有資料清楚交代咗項目定位、捕捉方式同數據價值,亦提到已釋出技術報告同 Hugging Face dataset。適合先將它理解為一個面向具身 AI 數據收集嘅基礎設施項目,而唔係即時上手型工具。

項目主頁

Categories: Agentic, Video, Audio, Robotic, Dataset 數據集

Gemini Robotics 2 想令機械人動作更完整

重點唔止係識睇同識答,而係令機械人連身體控制都更連貫。Gemini Robotics 2 指向的是把感知、推理同動作放入同一條工作流。

CSJxggUnu5m5TfompiXP2z7YLThhUvDn2 kBueCZv6HCEWWefUt WLzM6wxnTV1sTGqBbvmXDnOTB12W18NDr2NgFVXvHKCiTtjfXpyzuOYPJZXlg=w1440

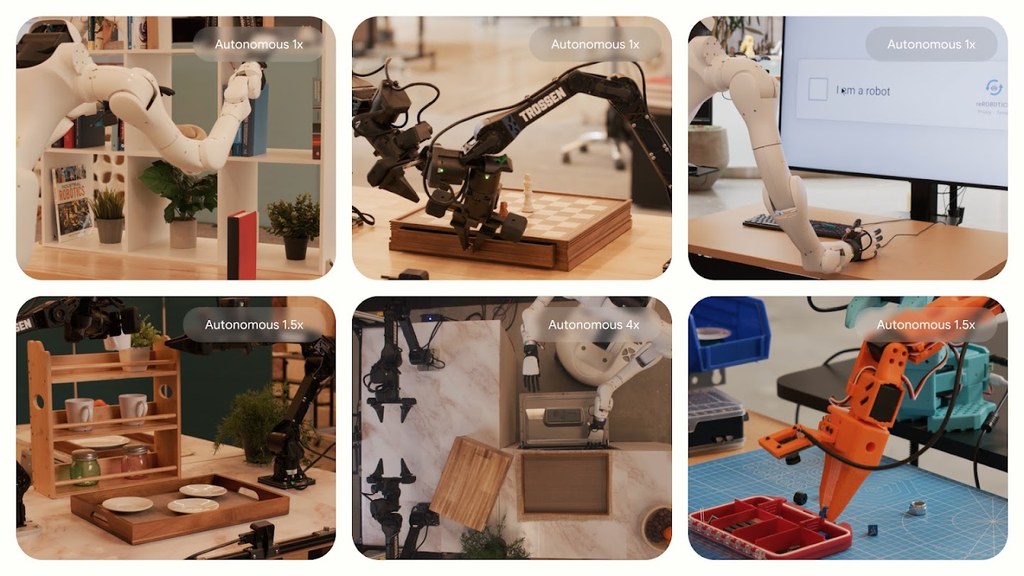
機械人最難處理的,往往不是單一步驟,而是由看見環境、理解指令,到整個身體協調完成動作的連續過程。Gemini Robotics 2 聚焦的正是這個落差,嘗試把 whole body intelligence 帶入機械人,讓系統不只會辨識和規劃,還能更自然地連動身體控制。

Google DeepMind 把它放在 Gemini Robotics 這條 physical AI 路線之下,定位清楚偏向機械人操作與互動。相比只處理螢幕、語言或單一機械臂任務的做法,這個方向更重視整體行為是否連貫,包括感知、推理、用工具與跟環境互動能否接上同一套能力。

對研究機械人、embodied AI 同 VLA 工作流的人來說,這類項目最有參考價值的地方,在於它瞄準真實場景中的協調問題,而不是只展示單點能力。文章提供的內容仍屬簡介層面,未見完整評測細節、量化指標或部署條件,所以現階段較適合當成技術方向觀察,而不是直接當作可落地規格。

  • 把機械人的感知、推理與身體動作放到同一條能力鏈
  • 核心關注點是 whole body intelligence,而不只是語言或視覺理解
  • 屬於 Gemini Robotics 系列,延伸 Google DeepMind 的 physical AI 佈局
  • 現有公開資訊偏介紹性,性能與限制仍有待更多技術資料補充

整體來看,Gemini Robotics 2 反映出機械人模型正在由「識唔識做判斷」走向「能唔能夠完整做完一個動作」。對需要長步驟操作、工具使用與環境互動的場景,這種整合式能力會比單一模組升級更值得留意。

項目主頁

Categories: Agentic, 世界模型, Google, Gemini, NanoBanana, Video, VLA, Audio, Robotic, 安全, Skill 技能

MiniMax H3 頂級高清影片生成

MiniMax H3 提供咗一套較完整的影片生成 API。它重點不只是出片,仲包括參考生成同影片編輯控制。

Og image

做影片內容時,最麻煩往往不只是「生成一段片」,而係點樣令角色、鏡頭起承轉合同參考素材保持一致。MiniMax H3 屬於多模態影片模型,處理的正正係呢類控制力需求:除咗 Text-to-Video,亦支援以首幀、尾幀、參考圖片、參考影片同音訊去引導生成結果。

對內容團隊、短片創作者同需要自動化出片流程的開發者而言,呢個項目的吸引力在於輸入方式夠彈性。你可以由一段 prompt 起步,也可以加入第一張或最後一張畫面去約束開場與收尾;當需要保留人物、動作、鏡頭風格、聲線或剪接節奏,則可改用 Reference Generation。

MiniMax Just Dropped a Open Source "Seedance Killer"
  • 支援 Text-to-Video、First/Last-Frame Image-to-Video、Reference Generation
  • 統一理解 text、image、video、audio,多種素材可混合輸入
  • 輸出最高為 2K,片長 4 至 15 秒,只接受整數秒
  • 參考輸入上限包括最多 9 張圖片、3 段影片、3 段音訊,混合檔案總數上限 12

規格上,MiniMax H3 支援常見長闊比,圖片、影片與音訊都有清晰的格式及大小限制,例如影片可用 H.264/AVC、H.265/HEVC,圖片可用 JPG、PNG、WEBP,音訊則支援 WAV、MP3。音訊不能單獨提交,必須配合圖片或影片一齊使用;而較大的素材更建議用 URL 方式傳入,避免 API request body 超出 64 MB。

現有資料集中在能力範圍、輸入限制同 API 使用方向,能夠幫你快速判斷適唔適合接入工作流。

項目主頁

Categories: MCP, 多模態模型, 視頻模型, API, Video, Image, Audio, 語音, MiniMax

SoulX-Singer 把零樣本歌聲合成

想快速試一把未見過的歌手聲線,SoulX-Singer提供咗幾近成品級嘅路線。它唔只唱得準,連跨語言同改詞後的人聲一致性都放埋入同一套流程。

SoulX-Logo

做歌聲生成,最難往往唔係「唱到」,而係未見過的聲線仍然要自然、準音、像本人。SoulX-Singer正是朝住呢個矛盾而來的開源模型項目,重點放在 zero-shot singing voice synthesis:唔使為每位歌手再微調,都可以用參考聲線配合旋律或樂譜生成歌聲。

它的定位幾清楚:一邊照顧創作控制,一邊盡量保住音色身份。你可以用 melody-conditioned 的 F0 contour 控制音高走向,亦可以用 score-conditioned 的 MIDI notes 對齊節奏與音符;對於需要改詞、換語言、保留同一把聲去做 demo、作曲草稿或虛擬歌手內容的人,這種控制方式比只靠文字描述更實際。README 亦提供 Hugging Face 模型與線上示範,部署理解上屬於下載預訓練權重後做推理的典型流程。

同類做法常見取捨,是控制愈細,聲線就愈易散;複製音色愈強,跨語言和改詞後又可能變得生硬。SoulX-Singer把 timbre 與 content 盡量拆開處理,目標是讓 Cantonese、Mandarin、English 之間仍能維持歌手辨識度,這點比單純追求「像真」更有產品意味。項目另外還有從 SoulX-Singer 微調而來的 SoulX-Singer-SVC,處理 singing voice conversion,直接由原始歌聲音訊轉換成目標歌手風格,連歌詞或 MIDI 標註都可省去。

  • 支援 F0 contour 與 MIDI 兩種控制,適合作曲草稿與精修流程
  • 主打 zero-shot,未見過的歌手聲線都可生成,減少逐人微調成本
  • 42,000+ 小時對齊人聲資料覆蓋 Mandarin、English、Cantonese
  • 可做改詞編修與跨語言合成,同時維持音色一致性
  • 另設 SoulX-Singer-SVC,補上 audio-to-audio 轉換場景

現有資料未完整列出量化指標細節,但項目已公開技術報告、arXiv 與示範頁,代表它不只停在概念展示。對音樂 AI 團隊、虛擬歌手內容製作、語音與歌聲研究者而言,SoulX-Singer吸引之處在於它把可控性、跨語言與免微調三件事放入同一條生成鏈,而限制則仍要留意倫理風險、聲線授權,以及最終作品是否需要後期混音補足細節。

GitHub · 模型

Categories: 開源, 模型, Audio, 聲效, 音樂

Wan Streamer v0.3:讓 AI 學懂「世界不變,只有事件在流動」

Wan Streamer v0.3 把影片拆成「持續存在的世界」和「持續發生的事件」,讓即時音視頻對話支援自由動作描述,延遲仍維持約 200ms。你可以把它理解成:一個會記得場景、然後跟著時間線即興演下去的 AI 對手。

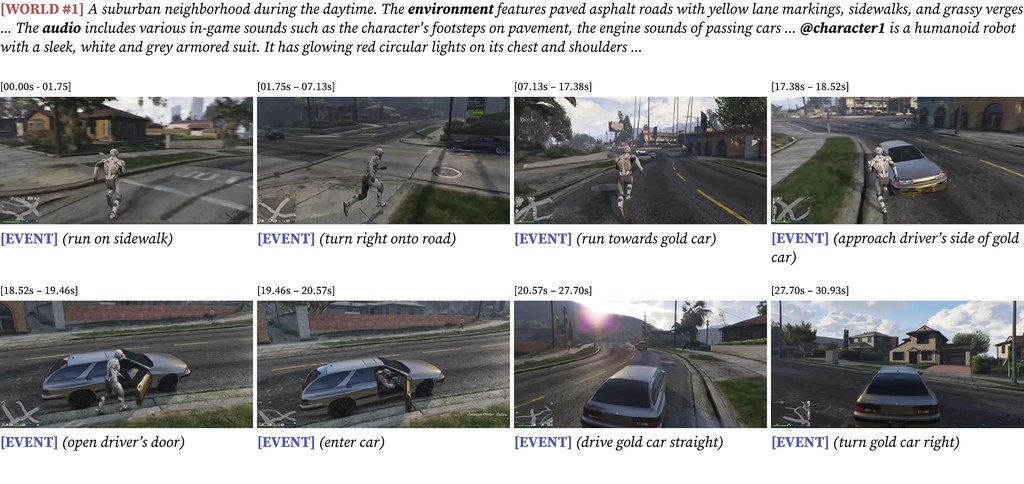
A robot navigates a suburban neighborhood and drives a car through a sequence of events

玩過 AI 影片對話工具的人都會發現一個矛盾:模型可以跟你聊天,但一旦想做動作,畫面就容易卡頓、失憶,甚至換了一張臉。Wan Streamer v0.3 想解決的就是這個問題——它把影片分成兩件事來學,一件是「世界設定」(場景、角色、畫風、聲音這些要長期保持一致的東西),另一件是「事件流」(說話、動作、鏡頭移動、環境變化這些隨時間發生的事)。

這個拆法聽起來抽象,但對使用者來說,最直接的差別就是角色終於可以做自然語言描述的動作了。你打開鏡頭,模型會一邊跟你說話,一邊伸手拿起眼前的物件、轉向聲音來源、或者露出驚訝的表情,而且動作和對嘴的時序是學出來的,不是後製對齊的。延遲仍然維持在約 200 毫秒,解析度 640×368、幀率 25fps,即時互動不會被打斷。

從工作流角度看,這個版本最大的價值是把普通影片變成訓練素材:先建立世界,再沿時間軸學接下來會發生什麼。同一套能力日後可以遷移到漫遊探索、機器人控制等場景,而這次發佈聚焦在即時音視頻對話。

重點摘要:

  • 拆解式學習:將「持續世界」與「事件流」分開建模,避免長對話中場景漂移
  • 自由動作描述:支援用自然語言寫出動作(如拿取物件、轉向、變換姿勢),並與對話同步渲染
  • 即時互動規格:640×368、25fps、約 200ms 模型側延遲,支援全雙工音視頻
  • 普通影片即訓練素材:不需特殊標註,現成影片就能用於學習時間軸上的因果事件
  • 可遷移架構:同一套預訓練能力可延伸至具身導航、漫遊等場景

對於做數位人、虛擬主播、互動敘事或即時陪聊的團隊,這個方向值得留意;對於只是想試試看的個人,現有 demo 已經足夠展示「角色真的在過日子,而不只是在回話」的差異。

項目主頁

Categories: 多模態模型, 世界模型, 模型訓練, Video, Audio, Robotic, 語音, Skill 技能

MultiRef-Compass:多模態影片不再各自為政

做多模態影片生成,最難往往唔係出片,而係點樣公平比較結果。MultiRef-Compass 把文字、影像參考同音訊參考放入同一套評測流程。

MultiRef-Compass overview

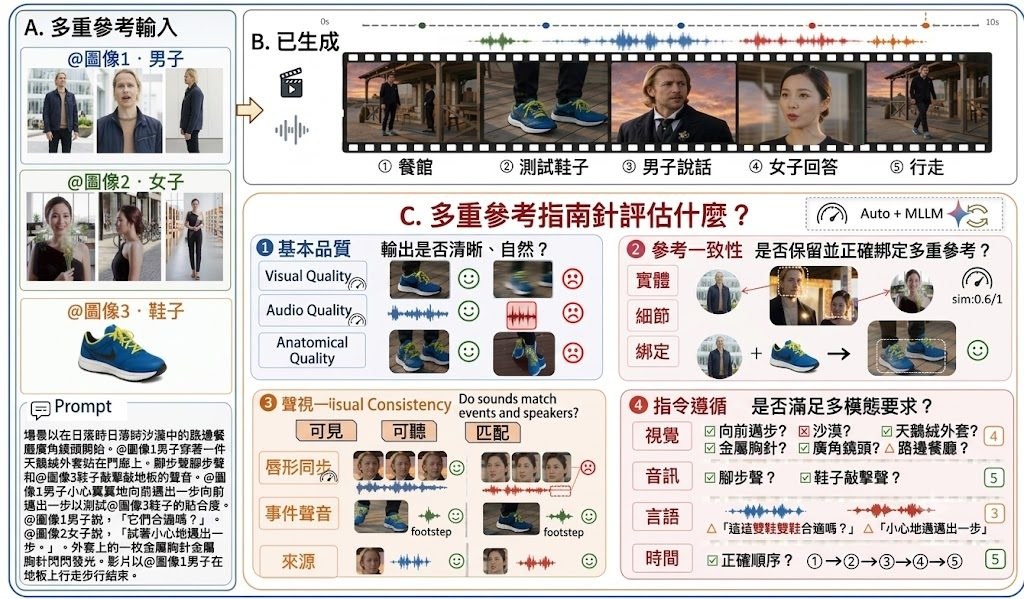
同一段生成影片,畫面可能順眼、聲畫卻唔對位;角色外觀接近參考圖,指令跟從又未必準。MultiRef-Compass 抓住呢種常見落差,定位成一個開源評測工具包,處理 multi-reference multimodal video generation 的比較問題,重點唔係逐條片人手睇,而係用可重現的方法把不同模型放到同一把尺上量度。

它的取向相當明確:偏向研究比較,而唔係臨時檢查作品。項目用固定的 CSV 輸入欄位,接收文字、視覺參考、音訊參考同生成影片,再輸出 per_sample.csv、model_summary.csv、ranking.md 同 details.json。這種設計的好處,是團隊可以用同一批樣本反覆測不同模型;代價是流程較講究資料整理,較適合已有實驗管線的人。

跟只看單一分數的做法相比,MultiRef-Compass 把結果拆成四組共 14 個公開指標,包括 Basic Quality、Entity Fidelity、Audio-Video Consistency 同 Instruction Following。它同時混合 classical media-analysis pipelines、learned quality models、speaker embeddings,以及 multimodal language model judges,所以看到的不只是整體高低,仲會知道問題出在 anatomy、reference fidelity、voice timbre similarity,定係 temporal order。

  • 用統一 schema 比較不同影片生成模型,較容易做橫向排名
  • 保留 sample-level diagnosis,同時支援 model-level ranking
  • 支援 text、visual-reference、audio-reference 三種條件一齊評測
  • 著重公開 metric taxonomy,同類研究較易重現結果

現有資訊未見到完整安裝細節,但理解方式已很清楚:先準備符合欄位要求的 CSV manifest,再按指標群組跑評測後端。受益最大的,會是做多模態影片生成、聲畫對齊、角色一致性與指令跟從研究的團隊。相關能力圍繞 Visual Quality、Audio Quality、Entity Fidelity、Speech-Lip Synchronization、Voice Timbre Similarity 等指標展開;它未必幫你直接提升模型質素,卻能先把模型到底差在哪一環講清楚。

GitHub · 模型

Categories: 開源, Embedding, 多模態模型, 視頻模型, Video, Audio, 語音

Page 8 of 10
1 … 6 7 8 9 10