OmniVideo-100K:增強影音推理訓練數據集

這是一個面向音訊與影片聯合理解的數據集項目,重點不在片段標註,而在較完整的跨模態推理。它更像是幫模型補課的訓練材料庫。

Framework Overview

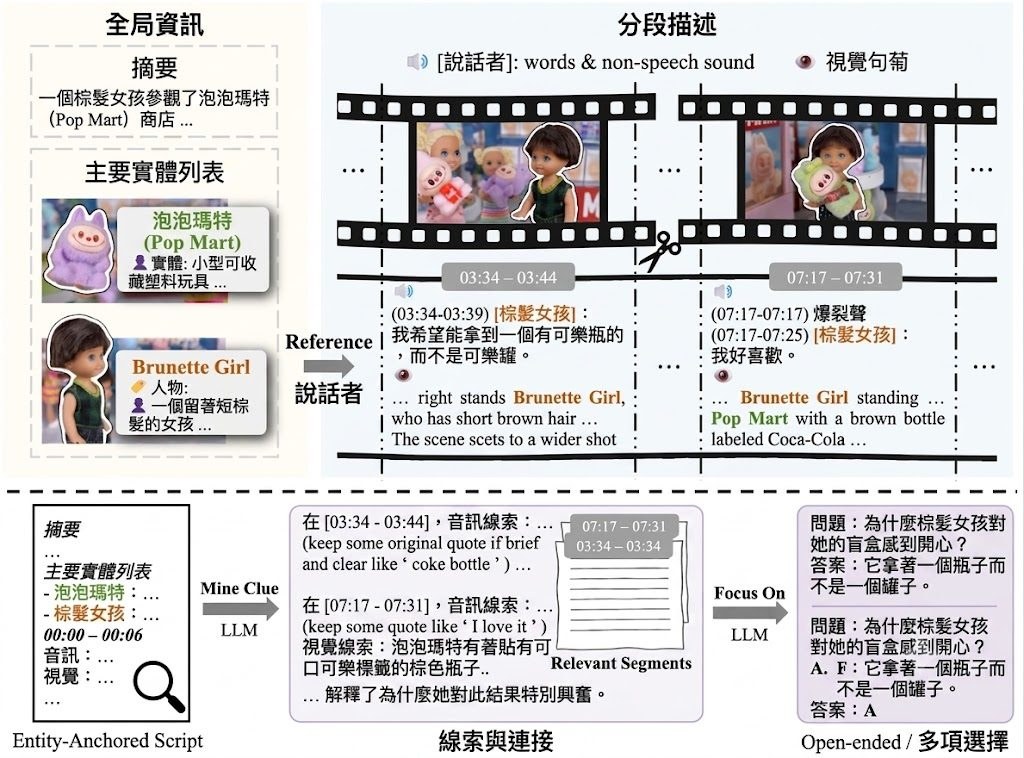
現時不少影音問答資料建立流程,普遍沿用「video-caption-QA」範式:先把影片切成短片段,再分開寫視覺與音訊描述,最後生成 QA。論文作者認為這種做法容易出現 modality bias、temporal misalignment,同一角色在不同片段亦可能描述不一致,令問題多數只圍繞局部事件,難以考驗長時間跨度的 audio-visual reasoning。

OmniVideo-100K 是一個 Dataset 數據集,目標是為 Multimodal Large Language Models (MLLMs) 提供較完整的影音推理訓練材料。它提出兩個核心機制:Entity-Anchored Video Scripting 先把原始影片整理成結構化 script,包括摘要、主要實體清單,以及帶時間戳的分段音畫描述;Clue-Guided QA Generation 則先抽取跨片段、跨模態線索,再生成較複雜的問答。

這種設計的關鍵,不在於題目數量大,而在於先整理證據鏈再出題。對比舊方法把長文本理解和 QA 合併成一步,OmniVideo-100K 把線索挖掘獨立出來,較有機會產生涉及因果、未來預測與假設推理的題目,而不只是問畫面中「見到乜」。

如果你想測試這個項目,可以先留意 Hugging Face 上的 OmniVideo-100K 與人手驗證的 OmniVideo-Test,看看資料結構是否適合自己的訓練流程;做研究的人則可直接比較模型在外部 benchmark 的變化。論文提到,VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B 經此資料集微調後,在 OmniVideo-Test 最多提升 20.59%,在 Daily-Omni、JointAVBench 也有最多 12.64% 增幅,同時盡量保留在 Video-MME 這類一般影片 benchmark 的能力。

  • 針對舊式「video-caption-QA」流程的三個痛點:modality bias、temporal misalignment、敘事不連貫
  • 用 structured scripts 加 entity list,補回跨片段指代一致性與聲音來源對應
  • 任務覆蓋 10 類,包括 FGP、STD、CU、CP、SA、ESO、SM、CR、FP、HR
  • 適合做影音理解、跨模態推理、指令微調資料研究的人參考
  • 相關模型包括 VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B

整體來看,這個項目的價值在於它不只新增一批資料,而是重寫影音 QA 資料的組織方法。若你關心的不是單張畫面問答,而是影片內角色、聲音、事件先後與推論之間的連結,OmniVideo-100K 會比一般自動合成資料集更有研究參考價值。

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, Qwen, Video, Audio, 工具, 庫, 語音, Dataset 數據集

MMAudio 自動配音效模型

高品質的自動音訊合成模型 其創新之處在於採用多模態聯合訓練方法,能同時利用影音和文字資料進行訓練。 模型能根據影片和/或文字提示生成同步的音訊,並包含一個同步模組確保音訊與影片畫面一致。 詳細說明了模型架構、使用方法(包含命令列和圖形介面)、預訓練模型下載和安裝步驟,以及已知限制和未來發展方向,例如訓練和評估部分仍在進行中。 整體而言,MMAudio專案旨在提供一個強大且易於使用的影片到音訊合成工具。 https://www.youtube.com/watch?v=Ta6H45rBzJc https://www.youtube.com/watch?v=n4sCNi_9buI https://www.youtube.com/watch?v=oxexfpLn7FE

Categories: 模型, Audio, 聲效

Hello2 – 高清 LipSync 工具

GitHub - fudan-generative-vision/hallo2: Hallo2: Long-Duration and High-Resolution Audio-driven Portrait Image Animation Hallo2: Long-Duration and High-Resolution Audio-driven Portrait Image Animation - fudan-generative-vision/hallo2

Categories: 模型, Video, Audio

LogicPro 11 -「AI 做歌真神奇」

香港音樂人試用 LogicPro 11 編曲、混音、Mixing、去人聲、自動分 Track 「AI 做歌真神奇」

香港音樂人試用 LogicPro 11 編曲、混音、Mixing、去人聲、自動分 Track 「AI 做歌真神奇」

香港音樂人試用 LogicPro 11 編曲、混音、Mixing、去人聲、自動分 Track 「AI 做歌真神奇」
Categories: Audio

MVSEP – 自制 Karaoke 必備

新增了新版本的 BSRoformer 權重。目前它可能是世界上最好的可用模型。

新增了新版本的 BSRoformer 權重。目前它可能是世界上最好的可用模型。

Categories: Audio, 線上服務

RVC-Boss/GPT-SoVITS 語音合成模型

GPT-SoVITS 開源語音合成,支援 5 秒零樣本與 1 分鐘少樣本克隆,提升聲音相似度。支援中英日跨語言推理,提供 WebUI 工具及 Windows 預打包檔,方便快速建置語音模型。

功能:

  1. 零樣本文本到語音(TTS): 輸入5秒的聲音樣本,即刻體驗文本到語音轉換。
  2. 少樣本TTS: 僅需1分鐘的訓練數據即可微調模型,提升聲音相似度和真實感。
  3. 跨語言支持: 支持與訓練數據集不同語言的推理,目前支持英語、日語和中文。
  4. WebUI工具: 集成工具包括聲音伴奏分離、自動訓練集分割、中文自動語音識別(ASR)和文本標注,協助初學者創建訓練數據集和GPT/SoVITS模型。

如果你是 Windows用戶(已在 win>=10上測試),可以直接通過預打包文件安裝。只需下載預打包文件,解壓後雙擊 go-webui.bat 即可啓動 GPT-SoVITS-WebUI。預訓練模型

GPT-SoVITS语音克隆AI,只需一分钟素材训练模型,效果堪比商用。一键安装,附Colab脚本 | TTS | RVC|GPT-SoVITS Colab

從 GPT-SoVITS Models 下載預訓練模型,並將它們放置在 GPT_SoVITS\pretrained_models 中。

對於中文自動語音識別(另外),從 Damo ASR Model, Damo VAD Model, 和 Damo Punc Model 下載模型,並將它們放置在 tools/damo_asr/models 中。

對於UVR5(人聲/伴奏分離和混響移除,另外),從 UVR5 Weights 下載模型,並將它們放置在 tools/uvr5/uvr5_weights 中。

數據集格式

文本到語音(TTS)注釋 .list 文件格式:

vocal_path|speaker_name|language|text

語言字典:

  • ‘zh’: Chinese
  • ‘ja’: Japanese
  • ‘en’: English

示例:

D:\GPT-SoVITS\xxx/xxx.wav|xxx|en|I like playing Genshin.

Categories: 文字轉語音, Audio, 軟件

AudioBox –

Audiobox 是 Meta 的新音訊生成基礎研究模型。 集 TTS、聲效、音樂於一身。它結合使用語音輸入和自然語言文字提示來產生語音和聲音效果,從而可以輕鬆地為創建任何音訊。 Audiobox 模型系列亦包括專業模型 Audiobox Speech 和 Audiobox Sound,所有 Audiobox 型號都基於共享的自我監督模型 Audiobox SSL 構建。 馬上體驗 – 多種聲效 – 創作故事

Audiobox 是 Meta 的新音訊生成基礎研究模型。 集 TTS、聲效、音樂於一身。它結合使用語音輸入和自然語言文字提示來產生語音和聲音效果,從而可以輕鬆地為創建任何音訊。 Audiobox 模型系列亦包括專業模型 Audiobox Speech 和 Audiobox Sound,所有 Audiobox 型號都基於共享的自我監督模型 Audiobox SSL 構建。

馬上體驗 – 多種聲效 – 創作故事

Categories: Audio, 線上服務

智能提升音頻品質 ai|coustics

ai|coustics 是一家專注於人工智慧及聲學領域的公司。他們提供多種提升音質的解決方案,包括聲音處理、音頻分析、語音辨識等。 ai|coustics 擁有未來的語音技術!你可體驗前所未有的使用生成語音人工智能高品質音頻,。無論您是在錄製播客、使用低品質耳機還是應對煩人的背景噪音,我們的技術都能將您的音頻提升至專業級品質。 筆者實測聲音原檔 聲音優化後檔案 ai|coustics 提供 HD-Speech API 同 SDK,可以方便自動整合並增強你的語音。 我哋嘅程式庫本身已經過優化,占用記憶體少,同時用最短嘅推斷時間而設計嘅,確保任何情況下都可以即時提升音頻品質,令你的音頻清晰及靚聲。 HD-Speech 即時音頻 SDK 程式庫適用於Windows、Mac、Linux、Web、Android 同iOS 平台,實現嵌入式、桌面及雲端環境度運行。 你可以親身體驗我哋嘅技術強大之處,即刻到我哋嘅 Playground Page 去見證 AI 語音增強嘅變革效果。 如果您對人工智慧和聲學感興趣,可以進一步探索該網站瞭解更多資訊。

ai|coustics 是一家專注於人工智慧及聲學領域的公司。他們提供多種提升音質的解決方案,包括聲音處理、音頻分析、語音辨識等。

ai|coustics 擁有未來的語音技術!你可體驗前所未有的使用生成語音人工智能高品質音頻,。無論您是在錄製播客、使用低品質耳機還是應對煩人的背景噪音,我們的技術都能將您的音頻提升至專業級品質。

筆者實測聲音原檔

聲音優化後檔案

ai|coustics 提供 HD-Speech API 同 SDK,可以方便自動整合並增強你的語音。 我哋嘅程式庫本身已經過優化,占用記憶體少,同時用最短嘅推斷時間而設計嘅,確保任何情況下都可以即時提升音頻品質,令你的音頻清晰及靚聲。

HD-Speech 即時音頻 SDK 程式庫適用於Windows、Mac、Linux、Web、Android 同iOS 平台,實現嵌入式、桌面及雲端環境度運行。

你可以親身體驗我哋嘅技術強大之處,即刻到我哋嘅 Playground Page 去見證 AI 語音增強嘅變革效果。

如果您對人工智慧和聲學感興趣,可以進一步探索該網站瞭解更多資訊。

Categories: Audio, 線上服務

廣東話<>輸出書面語字幕! youtuber.ai

YouTuber AI | 將時間花在創造力上,讓人工智能做餘下工作。 幾分鐘內完成字幕:節省數小時的手動打字時間。 多種語言支持,包括粵語、英語、普通話、法語、德語等。這是個線上服務,無需下載或安裝,按月收費。

Categories: 文字轉語音, Audio, 線上服務

Humanpal.io (支持 7 個廣東話語音模型)

如果你要製作一啲簡單嘅影片,呢個平台可以提供所有你需要製作影片工具,由文字到聲音,甚至動畫,都可以非常快速完成。而且收費非常便宜,最近甚至加入新嘅廣東話語音模型,值得一試。

如果你要製作一啲簡單嘅影片,呢個平台可以提供所有你需要製作影片工具,由文字到聲音,甚至動畫,都可以非常快速完成。而且收費非常便宜,最近甚至加入新嘅廣東話語音模型,值得一試。

Categories: Audio

Page 10 of 10
1 … 8 9 10