KTP(Knowledge-Transfer-Probing) 統一多模態模型做知識轉移考核

清華與 Z.AI 團隊提出 KTP 評測協議,專門測試統一多模態模型從圖像生成學到的新知識能否透過純文字問答取出,逐步補上視覺與語言之間的知識流動缺口。

knowledge transfer probing

統一多模態模型(Unified Multimodal Models, UMMs)一邊做圖像生成、一邊做語言理解,但訓練時從圖像吸收的知識,一直難以量化究竟有多少真的能在純文字 QA 場景派上用場。Knowledge Transfer Probing(KTP)這個項目正正填補這個缺口:它設計了一套受控的評測協議,先以圖像生成訓練把新知識餵進模型,再以純文字問答檢驗模型能否取出。
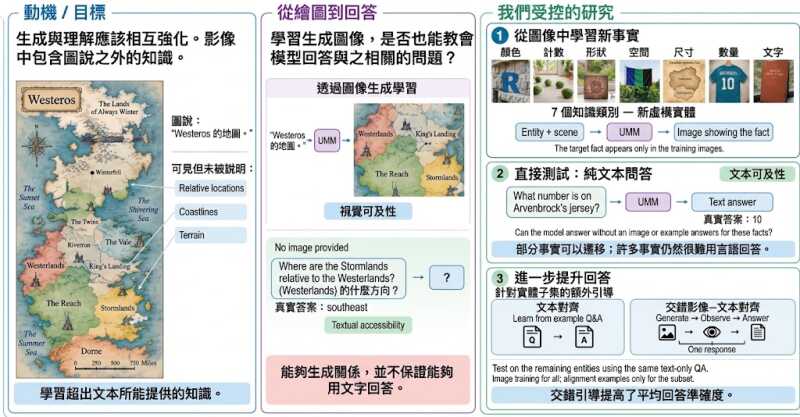
團隊跨越七個知識類別(色彩、數量、形狀、相對空間、相對大小等),在三個 UMM 上觀察到一個關鍵現象:直接從視覺監督遷移到語言的知識,效果並不均勻,部分類別知識存取明顯偏弱。有趣的是,在部分實體上做 Textual Alignment 或 Interleaved Image-Text Alignment 對齊訓練後,模型在未對齊的其餘實體上同樣能改善知識存取,其中交錯式對齊的平均準確率比純文字對齊更高。

項目屬於研究型資料集與評測框架,隨倉庫釋出 KTP-Data(分為 train/ 與 eval/),訓練檔涵蓋文字生成圖像、文字對齊及交錯圖文對齊三類樣本,評估檔則提供文字可達性(QA 題目與參考答案)與視覺可達性(生成提示與屬性)。評分腳本只用 Python 標準庫,跑分結果會輸出 results.jsonl 與 summary.json,方便研究者直接替換自家模型回應做比較。

對正在訓練或微調 UMM 嘅團隊而言,KTP 提供一個可重現的基準去量度「圖像生成帶來多少純文字世界可用的知識」,同時指出交錯對齊是一條有實證支持的改進路徑。多模態模型研究者、訓練數據設計者,以及關心視覺-語言聯合表徵架構的人都會從中受益。

這個項目的限制同樣需要留意:KTP 目前只覆蓋七類視覺屬性,且只測試三個 UMM,並未涵蓋複雜語境或多輪推理,結論的普遍性仍有待擴充樣本驗證。
項目主頁 · GitHub

Categories: 開源, 清華大學, 模型, 多模態模型, 模型訓練, Image, 框架, Python, 庫, Dataset 數據集

Hy Memory 共享不同 Agent 的記憶

Hy Memory 的模型、框架、應用三層全開源。將聊天脈絡、工作進度與代碼修改原因分開管理,再讓不同 AI 工具共享同一份記憶。

Tencent Hunyuan

當 AI 需要記住的不只是單句事實,還包括事情是如何發展、任務做到哪一步,以及代碼為何這樣修改,Hy Memory 便提供了一套較完整的處理方式。它屬於面向 LLM agents 的認知記憶引擎與 Python SDK,將 Chat、Working、Coding 三類場景分開處理,減少長對話和長期任務中召回錯誤脈絡的問題。

Chat 以分層長期記憶整理事件及後續發展;Working 同時保存任務事實與可重用經驗,重用前會檢查適用條件;Coding 則以版本演化鏈追蹤每次改動,將相關指令、真實 diff 和指定函式區塊連結起來。這比單純把內容切段後交給向量搜尋更適合需要延續工作的 Agent,但也依賴清晰的 user id、workspace id 和代碼變更來源。

• 自動按工具呼叫及搜尋模式分流到三類記憶
• 支援記憶的新增、更新、刪除、列出及 System 2 演化
• Coding 可讀取本地 Git diff,亦可處理 path、old、new 替換記錄
• MemHub 將 Claude Code、Cursor、Codex、OpenCode 和 Qwen Code 等工具的資料集中管理

評測涵蓋四套 benchmark:LoCoMo 聊天記憶準確率為 72.6%,MemoryArena 工作記憶平均分為 55.31%,CodeMemoryBench 的問答及解決率為 64.2% 和 35.6%,SWE-ContextBench 解決率為 28.3%。官方亦指記憶儲存佔用維持在較低水平,但不同任務和資料來源仍會影響結果。

透過 hy-memory SDK 接入,按場景寫入及搜尋;不指定場景時,無工具呼叫的寫入會直接進入 Chat,帶工具呼叫的內容才會分類。Hy-Memory-30B-A3B 是負責記憶讀寫的專用模型,約有 3B 激活參數,並可與引擎分開使用;MemHub 則提供 local-first 桌面及 CLI 產品,適合需要跨 AI 工具延續對話或編程工作的個人與團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, Agentic, 模型, API, 工具, IDE, Python, 編程, Dataset 數據集

DeepSeek 為 Agent 和 RAG 補上即時資料來源

DeepSeek Search 與 Fetch API 將網頁搜尋與單頁抓取整合成兩個 API,為 Agent 和 RAG 應用補上即時資料來源。

Og image

當 Agent 或 RAG 應用需要查找最新網頁資料,單靠模型內置知識往往不夠。DeepSeek API 現已提供 Search 與 Fetch 兩個原始 JSON API,讓應用程式可以搜尋網頁,再按需要讀取指定頁面的內容。

Search API 由 DeepSeek 自研搜索引擎支援,會按 query 返回結構化結果,包括標題、網址及摘要;將 need_content 設為 true,則可一併取得網頁正文。Fetch API 則針對單一網址抓取內容,並以 Markdown 文本返回,方便後續交給模型處理。

搜尋條件可透過 site:、lang:、after:、before: 及精確短語等語法收窄範圍,也能排除指定網站或關鍵詞。count 可設定返回 1 至 50 筆結果,ori_question 則可補充使用者原始問題,協助系統理解搜尋意圖。

• 適合建立需要即時資料的 Agent 與 RAG 工作流
• Search 用於找資料,Fetch 用於讀取指定頁面
• 支援中文及多語言搜尋條件
• 兩個 API 均使用 Bearer API Key 鑑權
• 搜尋沒有匹配結果時會返回空陣列

兩個接口共用 https://api.deepseek.com Base URL,分別對應 /v1/tools/search 與 /v1/tools/fetch。開發者需要自行處理 API 呼叫、結果篩選及網頁內容交給模型前的整理,文件目前提供 cURL 和 Python requests 範例,適合直接接入現有資料問答流程。

項目主頁

Categories: Agentic, RAG, DeepSeek, API, 軟件, Python

SCOPE 讓文字提示詞按語意學習

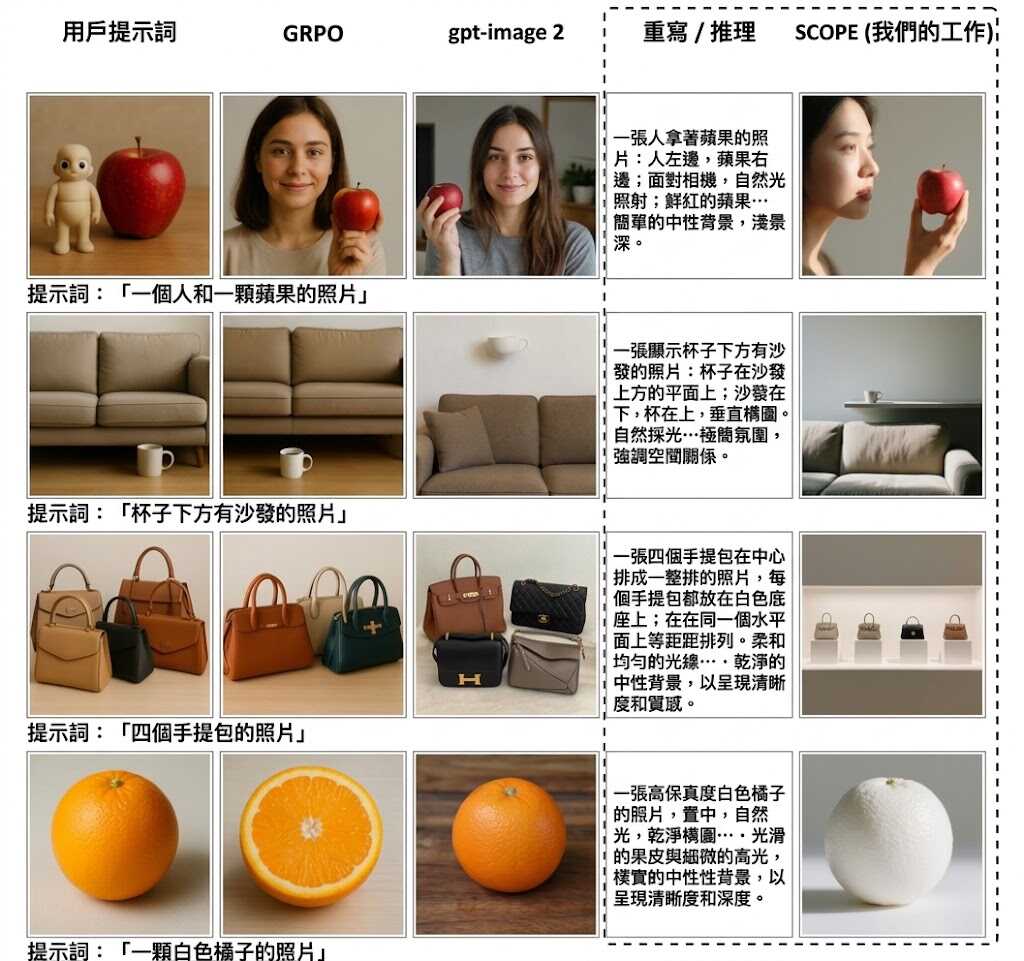
文字轉圖像不再把同一分數平均分給每個字詞,SCOPE 按物件、數量與關係調整提示詞優化方向。

Uniform token GRPO versus SCOPE span credit.

當提示詞包含物件、數量、屬性和關係時,逐個 subword token 套用同一個圖像分數,往往難以知道哪段文字真正需要修改。SCOPE 是一個開源的文字轉圖像提示詞優化項目,利用 GRPO(Group Relative Policy Optimization)讓語言模型重寫提示詞,同時保留凍結的圖像生成器作評分基準。

每組提示詞會由 pi_theta 產生 N-1 個改寫版本,並加入原始提示詞作第 N 個成員;預設 N 為 8。Qwen-Image 以同一個 diffusion seed 生成 512 x 512 圖像,使用 20 steps 和 CFG 4.0,再由 GenEval 回傳 0 或 1,減少不同隨機結果對比較造成的干擾。

SCOPE 的差異在於把回饋由 token 層面提升至語意片語。項目會在每個 phrase 內池化 log pi_theta 與 log pi_old 的差值,將 span coefficient 限制在 0.8 至 1.2,再把片語 token 權重正規化至平均值 1;tags 和垂直線則維持權重 1。原始提示詞分數低於預設 tau 1 時,採用截斷 reward gap;達到門檻後,改用改寫群組的 clipped z-score。

  • 訓練流程:原始提示詞會參與評分及 advantage 計算,但不直接更新參數。
  • 策略穩定性:pi_old 是上一個 optimizer step 的凍結副本,第一步會與 pi_theta 相同。
  • 適合情境:需要改善物件數量、屬性或空間關係表達的文字轉圖像研究與實驗。

測試時可觀察 reward service 產生的圖像、logs/node-RANK/內的安裝與訓練記錄,以及每項工作使用的 service.token;該 token 權限設定為 0600。項目更接近研究型訓練框架,而不是即開即用的圖像生成介面,使用者需要準備 Qwen-Image、評分服務及足夠的生成資源,亦要留意 GenEval 的二元分數未必能涵蓋所有美學或語意品質。

GitHub

Categories: 開源, 模型, 模型訓練, Qwen, Image, 提示詞, 框架, Mac, Python, Tokenize

3dcodeverse 讓 AI 以程式碼建立可驗證 3D 世界

3DCodeVerse 將可執行程式、空間檢查與視覺評審接成工作流,讓 AI 產生的 3D 內容不止能看,亦能修改和驗證。

3DCodeVerse

由幾百行 Blender Python、Three.js 或 GLSL 生成互動場景,內容仍可編輯和檢查,正是 3DCodeVerse 的實用定位。它屬於面向 coding agents 的 3D 研究生態系,處理文字要求轉化為可執行 3D 程式的問題,而不是只輸出一張渲染圖。

核心資料集 3DCodeVerse-2M 收錄約 2.03M 個 code-condition pairs,來自 269,597 個可執行程式,涵蓋 bpy、CadQuery、OpenSCAD、Three.js、URDF、GLSL、OpenGL 七種語言或 runtime,並分為物件、可動物件、場景及圖形渲染四條軌道。每個項目附有程式、所需資產、指令描述、視覺描述、建構步驟和驗證記錄,較適合訓練及測試,而非只作展示素材。

3DCodeVerse Harness 以多智能體和 DAG 結構規劃 3D 項目,再交由空間工具、MCP 服務及確定性檢查驗證連接、介面合約、關節掃描和畫面指標;VLM 評審則用二元缺陷清單及程式上限評分。讀者可先在項目網站瀏覽器執行示例,再從 Hugging Face 取得資料集;自行運行則要準備相應的 Blender、Three.js、OpenGL 等 runtime,不能只靠單一推理套件完成。

開放模型部分提供 Qwen 的 LoRA、DPO 微調配方,並列出 27B 模型在 3DCodeBench 的執行率由 51.9% 提升至 92.9%;項目亦列出相對同一 Claude Opus 5.5 backbone 的 90% 人類偏好結果。這些數字反映訓練資料和驗證流程的價值,但仍應留意評測設定、成本及不同 runtime 對結果的影響。

  • 可生成可修改的程式化 3D 物件、場景和渲染效果
  • 以 DAG Harness 串連規劃、執行、空間檢查和視覺評審
  • 2.03M code-condition pairs 支援模型訓練與基準測試
  • Qwen 微調配方兼顧執行成功率和偏好評審

對研究 3D 生成、coding agents、程式化建模或模型微調的團隊,這個項目提供由資料集、工具鏈到模型配方的完整起點。限制在於工作流程依賴多個 3D runtime,評審仍可能受視覺品質和規則覆蓋範圍影響。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, 模型, 視覺模型, 模型訓練, Qwen, Google, 工具, 3D, Python, 編程, 安全, Anthropic, Dataset 數據集, LoRA

Doc2Harness:測試模型能否造出真正可用的 Coding Agent

Doc2Harness 不只測模型識唔識寫程式,還把整套 Coding Agent harness 交由模型建造,再以黑盒方式驗證是否真的運作。

Doc2Harness

當 Coding Agent 要處理長時間、多步驟工作,成敗不只取決於模型本身,還取決於工具呼叫、權限、工作階段、復原流程和整個執行迴圈。Doc2Harness 是一個評測基準,專門處理模型能否按照開發文件和介面骨架,建造完整 Coding Agent harness 的問題。

項目分成兩個階段:第一階段由 build model 在隔離容器內透過 OpenCode 實作 harness;第二階段會凍結成果,再放到另一個容器,由 scripted mock model 端到端驅動。評分不接受 harness 自己聲稱完成任務,而是讀取四個可觀察渠道:傳給模型的請求、磁碟檔案、程序 exit code,以及 command output;positive controls 亦會阻止空殼實作取得通過結果。

  • 測試範圍:完整基準包含 328 個 test cases,公開儲存庫只提供 94 個 scenarios,包括 53 個評分案例和 41 個 positive controls。
  • 模型差距:完整套件涵蓋 19 個 frontier models,最佳模型通過率為 53.05%,最低約 27.4%。
  • 可重現限制:排行榜數字來自完整套件,不能只用公開子集重現。
  • 執行條件:需要 Python 3.11+、Docker,依賴採用 Python standard library;完整 catalog 在 concurrency 12 下約需 25 至 90 秒。

這項目直接把 harness engineering 本身納入評測。結果亦反映模組拆分並非必然帶來好處:在控制程式碼大小後,module count 與通過率呈負相關,相關係數為 -0.423;同一模型在 direct drive 和 permissions 等場景的排名也可能大幅變動,顯示權限及工具編排是獨立而關鍵的能力。

Doc2Harness 適合研究 Coding Agent、模型評測和 agent infrastructure 的團隊,用來比較模型建造長流程工具系統的能力,亦可協助定位 harness 在請求流程、檔案操作、程序控制或復原機制上的失敗位置。

項目主頁 · GitHub

Categories: 開源, 北京大學, 清華大學, Agentic, 模型, Vibe Coding, 工具, Python, 庫, 編程, Anthropic, Dataset 數據集

LSCBench 揭示 AI 編程代理安全盲點

LSCBench 以不提安全的真實漏洞重建任務測試編程代理,結果顯示能正常運作與同時安全的程式碼仍有明顯距離。

Qwen

當編程代理只收到功能規格、完全沒有被提醒要處理安全問題時,能否自行避開已知漏洞?Last Secure Code Benchmark(LSCBench)正是用來回答這個問題的開源基準測試項目:它從真實項目移除曾經包含漏洞的程式碼,再要求代理按規格重建,最後以功能測試及重現原有攻擊的安全測試共同評分。

LSCBench 共設 450 個任務,涵蓋 150 個漏洞情境,包括 115 個 Common Vulnerabilities and Exposures(CVE)案例及 35 個專家編寫的 Java 應用程式,支援 C、C++、Go、Java、JavaScript、PHP 和 Python。每個情境分成 function、file 及 repo 三種粒度,分別測試代理修補最小函式、相關檔案,以及較完整程式庫的能力。

六個模型在 450 個任務中大多能產生可運作程式碼,但同時通過功能和安全測試的比例最高只有 25.1%。Claude Fable 5 配合 Claude Code 取得最高 Func∧Sec 比例,GPT-5.6-Sol 的安全測試通過率則以 25.8% 稍高;Kimi-K3 雖然功能通過率達 91.3%,兩項測試同時通過的比例只有 16.4%,反映功能完成度與安全性並非同一件事。

  • 測試焦點:編程代理沒有收到安全提示,必須自行辨認風險。
  • 評分方式:功能測試確認程式可運作,安全測試重播原有攻擊。
  • 資料範圍:450 個任務、150 個漏洞情境、7 種程式語言。
  • 粒度差異:同一情境會在 function、file、repo 三個層次出現。

LSCBench 屬於面向 Computer-use agents(CUAs)及 coding agents 的安全基準測試,實際解決的是「生成的程式碼能否在沒有安全提示下仍然避免已知漏洞」這個評估缺口。對模型開發團隊、安全工程師及採用 AI 輔助編程的團隊而言,項目提供了比單看功能通過率更接近真實風險的檢查方式;不過,測試結果只涵蓋指定漏洞與攻擊重現流程,不能取代完整 code review、模糊測試及正式安全審計。

項目主頁 · GitHub

Categories: 開源, 阿里巴巴, Agentic, 模型, Qwen, OpenAI, DeepSeek, Python, 庫, 編程, 安全, Anthropic, Dataset 數據集, Kimi

Jeva 把可變選項決策搬到本地模型

面對候選答案會增減、排序又不應影響結果的任務,Jeva 以本地 4B 模型處理選擇、否定及評分。

Null-aware · Permutation-invariant · Option-scalable · Cacheable

候選答案數量不固定、選項次序不應改變判斷,正是 Jeva 嘗試處理的場景。它屬於開源本地決策模型,輸入狀態和 typed questions,輸出候選機率、Boolean probability 或 expected rubric score,亦能表達「沒有合適答案」。

Jeva 以共享語言編碼器獨立處理 state 和每個 option,再由 compact decision stack 只更新 state,對完整 option memory 作集合式判斷。這讓候選集合可以改變而毋須固定 label vocabulary;排序候選只會同步排列機率,不會改變語義身份。

模型權重可從 Hugging Face 載入本地推理,項目目前要求 Linux x86_64、NVIDIA GPU、CUDA 12.8 及 PyTorch 2.9.1。加速 kernel 可能在第一次請求時編譯,亦提供較慢的 reference installation;evaluation 和 fine-tuning 文件可用來延伸測試。

可重用的 option vectors、projected keys/values,以及完整 option tuples,適合候選內容反覆重組的分類、審核和評分流程。代價是硬件與 CUDA 環境要求較高,而項目提供的評估資料需要按自身任務重新核對,不能只憑模型名稱推斷效果。

  • 集合式決策: 候選數量可變,無需為每套選項重建輸出層。
  • Permutation symmetry: 重排候選只會重排對應機率。
  • Null awareness: 分開估計答案是否存在,以及候選之間的競爭。
  • 計算重用: 可快取整組選項,或重用個別 option 表示。
  • 適合場景: 本地化的選擇、審核、狀態判斷和 rubric 評分工作流。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, Linux, Python

ManimGX 高速 3D 動畫渲染

面向 AI agents 的 Manim 相容動畫引擎,以 Rust 和 wgpu 大幅縮短 2D、3D 教學動畫的製作等待時間。

ManimGX

製作數學教學片時,渲染速度往往比寫動畫程式更容易拖慢流程。ManimGX 屬於開源 3D 動畫引擎,兼容 Manim CE API,讓 Python 使用者可用熟悉的文字、方程式、曲面和鏡頭,處理 2D 與 3D 動畫生成。

它以 Rust 和 wgpu 重寫渲染核心,並加入完整靜態類型、關鍵字參數及 .animate 鏈式寫法;LaTeX 或 Typst 不需另行安裝。項目亦支援瀏覽器執行,透過 Pyodide 讓示範、教學或 AI agents 生成的動畫毋須先配置完整本地環境。

• M4 Pro、1080p60、五個場景合計 36.2 秒影片,渲染需時 3.08 秒
• 同一測試中,比 Manim CE 快 90.6 倍、ManimGL 快 11.5 倍、Blender Workbench 快 18.7 倍
• manimgx inspect 可檢查 storyboard、2D 版面,以及指定時間或播放結束時的畫面
• 支援語音同步,方便按旁白內容安排動畫節奏

安裝可選 prompt、PyPI 或 npm,適合數學教育、技術內容製作,以及需要反覆生成和檢查畫面的 agent 工作流。速度數字來自 Apple M4 Pro 的固定場景測試,不能直接代表所有硬件、動畫複雜度或互動需求;對已深度依賴 Manim CE 生態的團隊,API 相容性可降低遷移成本,但仍應先驗證現有場景和第三方功能。

GitHub

Categories: 開源, Agentic, AI productions, API, Video, 教學, 3D, Python, 語音, 動畫, 蘋果

Urbex 讓城市級 3D 定位改用主動搜尋

Urbex 讓視覺語言代理在城市級 3D 場景自行搜尋證據,毋須預先建立物件候選框,定位能力與效率取捨更值得檢視。

Urbex logo

面對城市級 3D 場景,逐一比較預先產生的物件候選框容易拖慢搜尋,也會受候選品質限制。Urbex 屬於開源的 Agentic 視覺模型項目,將 3D grounding 改成主動空間搜尋,讓 vision-language agent 按需要查詢地標、縮放區域、切換斜視角,再提交目標 bounding box。

它不是只靠一次影像判斷,而是在互動式 multi-view environment 逐步收集證據。Reinforcement learning 同時訓練定位和搜尋決策,模型會學習應該檢查哪裏、何時縮窄範圍,以及幾時足以作答;這免除對 precomputed instance proposals 和 ground-truth boxes 的依賴,但每次搜尋仍要承受多步操作成本。

CityRefer 測試中,Urbex 的 ND Hit@1、Hit@3、Hit@5 為 25.8、39.2、42.3,NO 對應為 23.9、36.9、40.7,搜尋時間約 3.2 秒。相較 CityAnchor 的 32.1 秒,速度明顯較快;模型亦在 STPLS3D-Refer 取得 zero-shot 結果,反映跨場景泛化潛力,但不能直接等同於所有城市環境都同樣穩定。

• 支援 CityRefer 訓練及單查詢互動式 3D 推理
• 提供 Hugging Face 的 Urbex-4B 模型和 Urbex-Data 數據集
• 可透過 Colab notebook 試用預測視圖
• 安裝需要 Linux、Python 3.11、CUDA 12.8 及 C++ 編譯器

研究城市建模、3D 視覺定位或多模態代理的團隊,較適合用它測試 candidate-free grounding;想快速驗證概念的人則可先用 Colab。完整訓練需要 CUDA 12.8、Megatron Core、Transformer Engine 和 FlashAttention,硬件及環境門檻明顯高於單純推理,因此本地部署前應先確認 GPU、編譯工具和數據下載流程。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Image, 工具, 3D, Linux, Python, Dataset 數據集, 強化學習

Page 4 of 21
1 2 3 4 5 6 … 21