SpatialScout 揭示 3D 定位落差,讓視覺語言模型探索室內空間

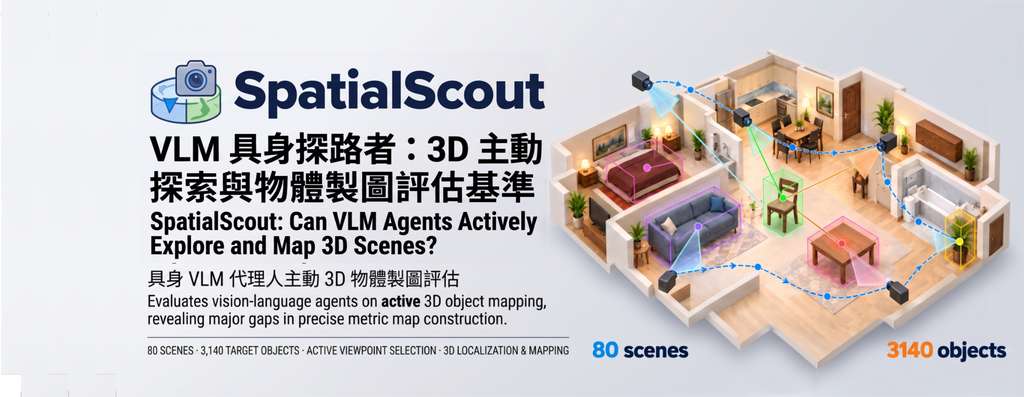
視覺語言模型要邊探索室內場景、邊把物件放進共通的 3D 座標,仍難兼顧完整度與精準度。SpatialScout 以 80 個場景測試這種主動建圖能力。

SpatialScout overview

要讓視覺語言模型看過不同角度後,找出物件在房間中的位置,單靠辨認影像並不足夠:模型還要選擇鏡頭視點、累積視覺證據,再把多個畫面中的物件對應起來。SpatialScout 是測試視覺語言模型(Vision-Language Model,VLM)代理主動探索與物件級 3D 建圖能力的基準項目,涵蓋 80 個室內場景及 3,140 個目標物件。

每項任務提供物件清單、RGB 觀察畫面,以及相機校準資料和位置資訊;代理要控制相機,在有限互動回合內探索場景,並估算物件在共通 3D 座標系中的中心位置。這讓測試不只檢查模型能否辨認物件,也衡量它會否選擇有用視點、跨畫面追蹤物件,以及逐步修正位置。

結果反映出由大概布局走向精確地圖仍有明顯距離:表現最佳的受測模型平均 IoU 為 41.71%,只有 3.25%的目標物件達到 IoU 0.9 以上。項目亦提供涵蓋所有物件及已提交物件的八項 IoU 指標,並以成功完成 finish_mapping 的軌跡計算任務平均分;這有助分辨模型是定位不準,還是漏掉了物件。

  • 基準涵蓋 80 個室內場景及 3,140 個目標物件。
  • 每項任務最多 100 回合,模型需主動選擇觀察視點。
  • 評分同時考慮定位準確度與物件完整度。
  • 最佳受測模型平均 IoU 為 41.71%,高精度定位仍有限。

研究團隊可用自己的模型 API 執行全部任務,預設採用 Responses API 模式,亦可切換至 Chat Completions、Anthropic 或 Gemini 端點。項目要求 Linux x86_64 和 Python 3.10,安裝程序會設定 CPU 渲染並透過 apt/sudo 安裝系統套件;場景資源則需另行下載及掛載。它適合研究主動感知、機械人空間理解或多模態代理的團隊作比較測試,但目前提供的是評估基準,不是可直接取代建圖系統的模型。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, 視覺模型, 多模態模型, Gemini, API, Image, 3D, Linux, Python, Anthropic, Dataset 數據集

PrismaCoder 的多模態生成

多模態程式碼智慧將程式的符號世界與其執行所產生的視覺世界連結起來。

PrismaCoder: Open Multimodal Code Intelligence

從文字或視覺輸入生成圖表、網頁、示意圖、文件和動畫,PrismaCoder 是一系列開放的多模態程式碼模型,處理的不只是程式能否執行,也包括輸出畫面是否符合要求。這對需要快速製作圖表、前端介面或科學文件的開發者和研究團隊,提供了涵蓋多種視覺程式任務的模型選擇。

它的訓練流程 PrismaForge 會為每項指令建立評分規準,分開檢查程式碼與渲染結果,再用相同規準篩選訓練資料及提供強化學習獎勵。這做法把「程式寫得對」和「畫面呈現得對」分開衡量,減少只靠整體印象評分所帶來的偏差。

模型以 Qwen3.5 為基礎,提供 9B 和 35B-A3B 兩種規模,並各有監督式微調(SFT)及強化學習(RL)版本。PrismaCoder-2M 資料集涵蓋圖表生成與重建、網頁介面、互動示範、向量圖像、科學文件及化學圖形等任務;評估工具包括 VisPlotBench 和 ChemDraw。

  • PrismaCoder-9B 的 SFT 與 RL 權重均可取得;35B-A3B 的 RL 權重仍在上載中。
  • 項目網站稱模型在圖表、前端頁面和半結構化文件任務中領先開放模型,並能匹敵或超越部分專有系統;具體分數需查看網站或論文。
  • 儲存庫已提供格式專屬執行與渲染檢查、多模態資料合成,以及 Python、SVG、HTML 的文字評分工具;PrismaForge 完整評分與資料篩選流程,以及 SFT、RL 訓練腳本仍未完成。

模型權重和資料集可經 Hugging Face 項目頁取得;不過,儲存庫目前未提供完整訓練流程,35B-A3B 的 RL 權重亦未上架。想先驗證生成品質的團隊,可參考 VisPlotBench、ChemDraw 評估程式和互動示例;若要自行重現訓練,則要留意腳本尚未開放。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 工具, Python, 庫, 動畫, Dataset 數據集, 強化學習

TextRIRO:修改文字內容並保留原始風格

讓圖片中的文字換內容、留風格,但處理範圍限於裁切文字區域,項目暫時只是作為研究,因此生成解像度亦有限制。我仍為這研究有助 Diffusion Model 發展更多的應用

TextRIRO training, inference, STR-pretrained text encoder, and TextRIRO-3M construction pipeline

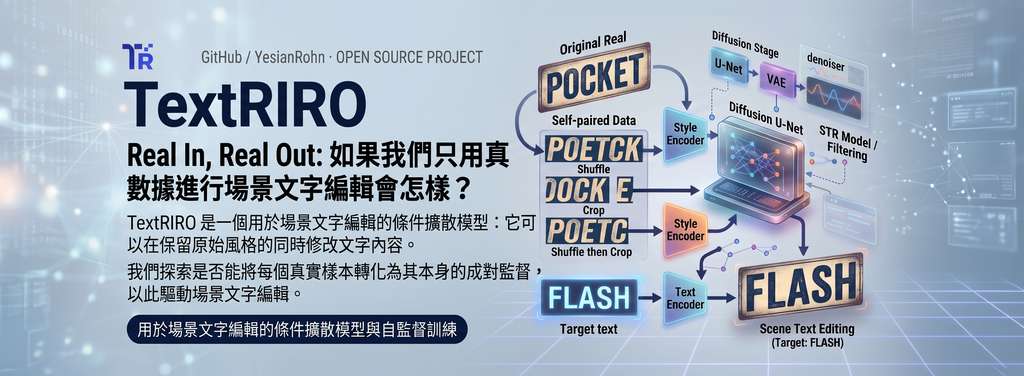
招牌或包裝上的字換了,仍希望保留原有外觀;TextRIRO 以條件擴散模型處理場景文字編輯(Scene Text Editing,STE),輸入裁切文字圖及替換內容,輸出改字後的圖像。

它以 Shuffle&Crop 打亂真實影像的文字語意,同時保留風格線索,讓每張圖形成自身的配對監督,毋須合成編輯前後配對或字元分割。多尺度風格編碼器配合以場景文字辨識(Scene Text Recognition,STR)預訓練的文字編碼器,分別提供外觀與字元條件。

「Real-only」只涵蓋編輯監督及文字編碼器預訓練。生成骨幹仍採用 Stable Diffusion(SD)1.5 的 U-Net 與 scheduler,以及 SD 2.1 的變分自編碼器(Variational Autoencoder,VAE)。

  • 可透過 Hugging Face Demo 試改文字。
  • 本地推理需 CUDA、模型權重及相關組件;儲存庫列出 Python 3.8/PyTorch 1.13 環境。
  • 生成解像度為 64 × 256,再還原來源尺寸,細節仍受限制。
  • RIROCommon 測試等長及變長改字;所附資訊未提供分數,不能判斷領先幅度。

文字辨識研究團隊亦可利用 TextRIRO-3M 的三百萬張長文字影像。這批資料由篩選後的編輯圖與原圖拼接而成,屬合成資料;完整照片改字流程,仍需另行處理文字區域裁切及回貼。

GitHub · 模型

Categories: 開源, 模型, 模型訓練, NVIDIA, Stable Diffusion, Image, Python, 庫, Dataset 數據集

RubatoCodec:深入神經音訊編碼 – 殘差向量量化(RVQ)與高保真重構架構

固定長度切分未必適合語音的每個片段;RubatoCodec 按訊號變化分配事件,並可逐段解碼,面向低位元率語音處理與串流生成。

RubatoCodec architecture

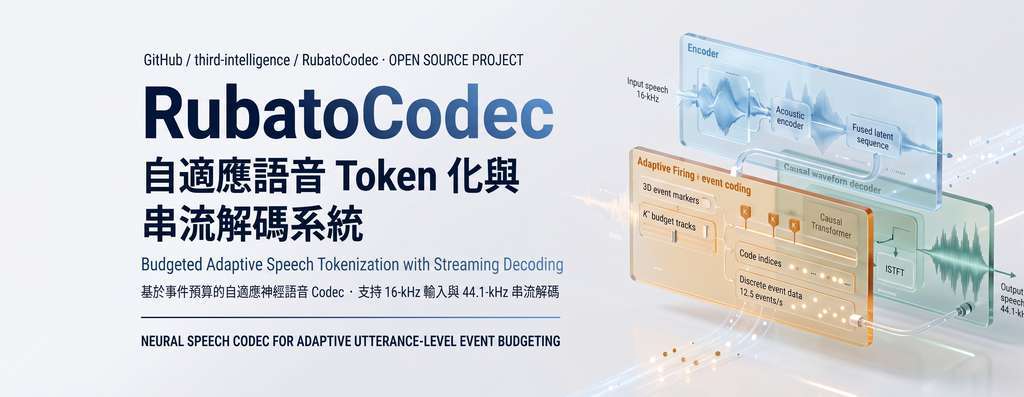
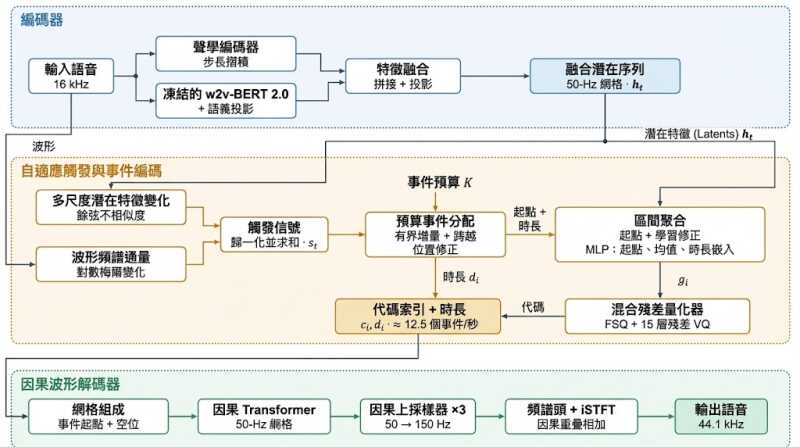
語音片段的資訊密度各有不同,若一律按固定長度切分,便難以按內容分配編碼資源。RubatoCodec 是神經語音編碼器,會把語音轉成帶有離散碼索引和持續時間的可變長事件,並支援逐段重建波形,適合需要控制碼率或串流輸出的語音系統。

它在 50 Hz 潛在表示上,參考多尺度潛在特徵差異和波形頻譜通量,累積分配事件;預設目標比例為 0.25,整段語音的事件數則按公式精確控制。這種做法毋須另設邊界預測器、邊界標籤或 rate loss,但仍需把事件持續時間一併納入編碼,不能只看碼索引的位元率。

量化器採用 16 層混合式殘差結構:首層是接受語義監督的 FSQ,其後 15 層使用 DAC-style residual VQ。解碼時可選用 1 至 16 層的任意前綴深度,名義碼索引位元率約為 150 至 2,400 bit/s,另加持續時間資訊;模型以約每秒 12.5 個事件表示語音,輸入為 16 kHz,因果串流解碼器輸出 44.1 kHz。

每個事件代表約 80 毫秒音訊,在 H200 上解碼約需 11 毫秒,具備逐事件或分批解碼的條件。這是硬件與模型設定下的速度數據,不能直接當成其他設備上的延遲保證;現有資訊亦未提供足以比較音質取捨的具體評測結果。

研究人員、語音模型開發團隊,以及需要低碼率儲存或即時音訊處理的系統,可用公開模型和 Python API 載入語音、編碼,再按指定深度解碼。重點包括:
– 事件長度按語音訊號變化調整,整段事件數受目標比例控制。
– 支援逐事件或分批串流解碼。
– 可選不同量化器深度,在碼率與表示容量之間調整。
– 編碼資訊除離散碼索引外,亦包括事件持續時間。
– H200 上每事件約需 11 毫秒解碼,其他硬件表現未有提供。

基本使用範例(推論與重構流程)

專案通常遵循標準 PyTorch 神經編解碼介面,基本 Python 處理流程如下:

import torch
import torchaudio
from rubatocodec import RubatoCodec

# 1. 載入模型與權重
device = "cuda" if torch.cuda.is_available() else "cpu"
model = RubatoCodec.from_pretrained("third-intelligence/RubatoCodec").to(device)
model.eval()

# 2. 讀取並預處理音訊(重取樣至模型支援之採樣率)
waveform, sample_rate = torchaudio.load("input.wav")
if sample_rate != model.sample_rate:
    resampler = torchaudio.transforms.Resample(sample_rate, model.sample_rate)
    waveform = resampler(waveform)

waveform = waveform.unsqueeze(0).to(device)  # [Batch, Channels, Time]

# 3. 編碼:提取離散 Tokens (RVQ Codes)
with torch.no_grad():
    # tokens 形狀通常為 [Batch, Num_Quantizers, Frames]
    tokens = model.encode(waveform)

# 4. 解碼:由離散 Tokens 還原音訊波形
with torch.no_grad():
    reconstructed_waveform = model.decode(tokens)

# 5. 儲存重構音訊
torchaudio.save("reconstructed.wav", reconstructed_waveform.squeeze(0).cpu(), model.sample_rate)

GitHub · 模型

Categories: 開源, 模型, NVIDIA, API, Audio, Python, 語音, Dataset 數據集

PhysSkin++ 令 3D 模型郁得唔再硬掘掘!

PhysSkin 把靜態 3D 形狀轉成可泛化的物理動畫控制,減少每個模型重新訓練的成本。

teaser

不同模型形狀、網格密度甚至空間表示法各異,物理動畫往往要重新建立變形控制。PhysSkin 屬於 3D 動畫模型,透過自監督 Neural Skinning 學習連續 Skinning Fields,讓不同形狀可以共用即時物理動畫能力。

模型先用 transformer-based shape encoder 讀取形狀,再由 cross-attention field decoder 產生與形狀相關的變形子空間;physics-informed self-supervised objectives 則以物理約束和正交性要求取代完整模擬軌跡標註。這個組合針對的是泛化能力與運算速度之間的取捨,而不是單純追求更細緻的離線模擬。

README 提供 Python 3.11、PyTorch 2.7.1 等環境版本,以及資料目錄、physskin_vis.ipynb 視覺化筆記本和訓練流程。資料包含 (1, 256, 768) 的 float32 latents 與三維內部點,項目亦列出預訓練 checkpoint 路徑;原始資料沒有交代公開下載方式,不能因此假設模型可隨意取得。

  • 可跨不同形狀與 discretization 使用連續 Skinning Fields
  • 以自監督物理目標減少動畫標註依賴
  • 支援即時 physics-based animation 的研究與互動控制場景
  • README 沒有提供具體 FPS、誤差或同類方法差距

對動畫研究、3D 內容工具及需要碰撞互動的圖形團隊,PhysSkin 更適合用作研究原型或既有 rig 的物理補強。配套的 PhysSkin++ 描述進一步延伸至 meshes、point clouds、NeRFs 和 3D Gaussians,但這些能力不應直接當成本 GitHub 項目中同一 checkpoint 已完整提供的功能。

項目主頁 · GitHub

Categories: 開源, 模型, 模型訓練, 工具, 3D, Python, 動畫

Deepseek Recipe 幫本地推論後端連接多格式 API

在本地跑 DeepSeek 模型、想同時提供 Messages、Chat Completions 與 Responses 三種 API 格式?這個 Rust + Python 工具庫把格式轉換、prompt 渲染與 token 編碼一條龍包辦。

DeepSeek

對想自建 DeepSeek 推論服務嘅開發者來說,最頭痛往往唔係模型本身,而係點樣令自家後端兼容外界各種 API 格式。deepseek-recipe 就係針對呢個痛點而來——它用 Rust 寫核心邏輯,再提供 Python bindings,專門負責將 Messages、Chat Completions 同 Responses 三種主流請求格式統一轉換成 DeepSeek 內部嘅 Conversation 結構,再渲染成模型識讀嘅 prompt,最後用附帶嘅 tokenizer 編碼成 token ID。

呢個庫定位相當清晰:佢只處理格式轉換同 prompt 拼裝,模型推論、工具執行、HTTP 傳輸呢啲都交返俾呼叫方自己負責。換句話講,開發者可以揀任何推論引擎,再喺外面搭一層 recipe 做「翻譯員」,咁就可以用同一個後端撐起多個對外 API 端點。對於正在從 Ollama、vLLM 或自家 CUDA 服務過渡到 DeepSeek 模型嘅團隊嚟講,等於慳咗大量重複開發。

它對 DeepSeek V4 同 V4.1 有針對性處理:V4.1 支援圖像(會用 OpenCV 預處理),V4 則會把圖片替換成 [Unsupported Image] 字串,避免下游出錯。Thinking mode 方面亦照顧周到,無設定時自動補 8192 tokens,開啟 thinking 預設 65536,開到 max effort 就去到 131072。Structured output 同樣齊全,Chat Completions 嘅 json_schema、regex,以至 Responses 嘅 text.format 都做咗驗證同轉寫,並會喺 InferenceOptions 揀選對應嘅 OutputConstraint,畀呼叫方決定要唔要開 constrained decoding。

工具支援亦係重點之一。Function tools 全部覆蓋,V4.1 仲額外支援 Messages 嘅 deferred tool loading 同 Responses 嘅 client-executed tool search,對做 agent 框架嘅人特別有用。串流方面,token usage 會回報 reasoning_tokens,logprobs 喺 Responses 格式下亦會被轉成 InferenceOptions。不過要留意,圖片抓取組件 ReqwestImageFetcher 預設連任何地址都得,如果服務面向不可信來源,記得裝返 DestinationFilter。

GitHub

Categories: 開源, Agentic, 模型, NVIDIA, DeepSeek, API, Image, 框架, 工具, Ollama, Python, 庫, Tokenize

DeepInfer 開放 DeepSeek 離線推理核心

DeepInfer 把 DeepSeek 大規模服務的離線推理核心開源,涵蓋高效 kernels、並行排程與解碼加速,但未包括完整線上服務組件。

Prefill: non-cached input throughput vs. latency

對需要自行建立高效模型服務的團隊,DeepInfer 提供了一條更接近 DeepSeek 生產環境的技術路徑。這個框架負責離線推理,處理模型執行、批次排程與輸出生成;KV cache 系統、Prefill/Decode 分离及跨資料平行副本負載平衡則須另行整合。

  • 支援 DeepSeek-V4.1-Flash,涵蓋模型與 sampler runtime、FlashMLA、DeepGEMM、DeepEP 等最佳化 kernels。
  • 以 DSpark draft tokens 配合信心度排程驗證,減少解碼階段等待;預設最大 draft 長度為 5。
  • 支援 MoE EP、EPLB、Attention DP、balanced CP,以及 CPU 與裝置執行重疊的非同步批次排程。
  • 提供 SWA bounded replay、structured outputs、batch-invariant inference 與 deterministic sampling,方便控制成本和重現結果。

它與一般模型框架的分別,不在新增模型能力,而在於把 DeepSeek 線上服務累積的低延遲機制整理成可編譯的推理框架,代價是硬件與整合門檻較高。環境要求包括 Linux、Python 3.12、GCC 13 或以上;NVIDIA 路線使用 CUDA 13 及 SM100 GPU,另有 Huawei Ascend 950 NPU 版本,部分功能只支援 NVIDIA。

對吞吐量、推理成本和結果一致性敏感的 AI 平台團隊,DeepInfer 的價值較明顯。它提供 batch-invariant inference、regex、JSON schema 與 EBNF grammar 約束,但官方未提供吞吐量或延遲數據;公開內容亦未涵蓋完整部署指南與線上服務元件,較適合具備 GPU、NPU 及分散式系統經驗的團隊從源碼整合。

GitHub

Categories: 開源, 華為, 模型, NVIDIA, DeepSeek, 框架, 線上服務, Linux, Python

CoPE 讓 Agent 逐步預測行動,節省一半訓練樣本

CoPE 以多步行動預測補強 Agentic RL,在不增加推論成本下,提升語言智能體的學習效率。

CoPE

長軌跡只靠完結時一次獎勵學習,往往會令多數步驟欠缺直接回饋。CoPE 是建基於 AgentGym-RL 及 verl 分支的強化學習框架,透過逐步預測智能體接下來會採取的 K 個行動,為每個決策位置加入更細緻的訓練訊號。

模型骨幹同時負責 acting 與 forecasting:智能體按既有 policy 行動,並在每一步預測未來行動;完成 rollout 後,真實行動序列會監督預測結果,再把學習成果蒸餾回同一個 policy。關閉相關功能後,訓練路徑便維持標準 Group Relative Policy Optimization(GRPO),方便按研究需要比較。

  • 每一步預測 K 個後續行動,補充終結獎勵欠缺的分步監督。
  • acting 與 forecasting 共用一個模型,不需額外模型或預訓練階段。
  • 推理時仍逐步行動,不加入額外運算開支。
  • 支援 SciWorld、ALFWorld、WebShop、AppWorld 及 τ²-bench 五個互動環境。

結果顯示,CoPE 在上述環境擊敗 GRPO 與 predictive-auxiliary baselines;樣本效率最高提高 2 倍,其中 ScienceWorld 為 2.0 倍、AppWorld 為 1.6 倍。任務成功率相對 GRPO 在 ALFWorld、WebShop 與 ScienceWorld 分別增加 5.0、12.5 及 8.0 個百分點。

配置需要 Python 3.10 訓練環境及獨立環境服務;WebShop 使用 Python 3.8,τ²-bench 需要 Python 3.12 或以上,並須取得 AgentGym submodule。這套架構適合研究互動式語言智能體、計算成本受控的團隊,以及比較 action forecasting 與稀疏獎勵訓練方法的開發者,但多環境配置與 GPU 需求增加了安裝門檻。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, 框架, Python, Meta, 強化學習

MT-Forcing:多輪改圖守住細節唔再走樣

連續改同一張圖時,主體、紋理與構圖往往會慢慢偏離;MT Forcing 以多輪訓練與教師引導改善這類累積錯誤。

MT Forcing teaser

連續要求「改杯色、加條紋、再調光線」時,圖片往往未到最後一輪已經失真。MT Forcing 是針對多輪圖像編輯的訓練框架,配合自迴歸擴散模型,減少每輪修改帶來的漂移。

方法把單輪 DMD(Distribution Matching Distillation)與 Teacher-Forcing Guidance 結合:學生模型逐步編輯自己生成的歷史,凍結的單輪教師則從原圖一次套用累積指示,提供分布層面的引導。參考真實編輯軌跡後,模型既要改善畫質,也要維持跨輪次內容關係。

  • 以自身多輪輸出作為訓練歷史
  • 引入單輪 DMD 改善視覺品質
  • 用 Teacher-Forcing Guidance 減少誤差累積
  • 展示最長十五輪及八輪編輯比較

官方程式碼要求 Python 3.11.13、NVIDIA CUDA GPU,以及指定 checkpoint、架構資源和擴充 U1.5 tokenizer;配置完成後,可在同一工作階段依序執行多個編輯提示。公開資料未交代完整硬件門檻、推理速度或標準化定量結果,因此較適合作為需要 NVIDIA GPU 的研究重現工具,而非直接比較成本已知的消費級服務。

它以 SenseNova-U1.5 作為相關基礎模型,並在多輪比較中加入 MT Forcing。對需要逐步修訂產品 concept、人物姿勢或場景細節的設計團隊,單輪教師可作品質參照。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 清華大學, 模型, 模型訓練, NVIDIA, Image, 影像模型, 框架, 工具, Python, Tokenize

MOSS-Image 支援 JSON 排版的 5B 文字生圖模型

MOSS-Image 推出的 5B 參數文字生圖模型,能夠直接在 prompt 內用 JSON 描述物件位置、標籤與邊界框,毋須額外 ControlNet 也能控制版面。

MOSS-Image

用文字生圖最常遇到的卡位,是 prompt 寫得再精準,模型依然把主體放錯位置或把文字渲染得歪七扭八。OpenMOSS 開源的 MOSS-Image 把這個矛盾寫進模型架構本身:除了自然語言 prompt,它同時接受結構化 JSON 輸入,裏面可以逐個列出物件的標籤、描述與 yxyx 格式邊界框,由模型原生處理版面配置,毋須借助外掛 ControlNet 或額外 inpainting 步驟。

對於做海報、漫畫分鏡或產品 mockup 的人來說,這種介面比「再抽幾次卡」來得直接。生成結果可以直接根據 JSON 編輯調整單一物件的位置或文字內容,方便反覆迭代。模型骨幹約 5B 參數,支援長達 4K token 的 prompt,文字渲染能力亦比同類開源模型紮實,並同時覆蓋動漫與寫實風格。

New top local AI image generator is here!

現階段提供 Base 與 SFT(curated-data 微調)兩個版本,權重以 Apache-2.0 釋出,部署上已有 SGLang、vLLM-Omni 與 ComfyUI 的 day-0 支援,配合 Python 及 Gradio 共用的 Diffusers pipeline,本地或雲端皆可即時跑起 demo。

重點摘要:

  • 原生版面控制:JSON prompt 直接描述物件、位置與邊界框,毋須外掛 ControlNet。
  • 5B 緊湊骨幹:兼顧生成效率與微調彈性,prompt 可長達 4K token。
  • 雙版本開源:Base 與 SFT 權重皆公開,Apache-2.0 授權。
  • 多元框架支援:SGLang、vLLM-Omni、ComfyUI 同日適配,並提供 Hugging Face Spaces 線上 demo。
  • 風格覆蓋廣:動漫與寫實風格並重,文字渲染品質為主打賣點之一。

項目主頁 · GitHub · 模型

Categories: 開源, ComfyUI, 模型, NVIDIA, Image, 框架, Python, 蘋果

Page 3 of 21
1 2 3 4 5 … 21