Microsoft 研究團隊聯同 POSTECH、KAIST 及南方科技大學開發 AutoSaddler,針對長流程 AI Agent 容易因小錯誤累積而失敗的問題,建立自動優化 harness 的方法。
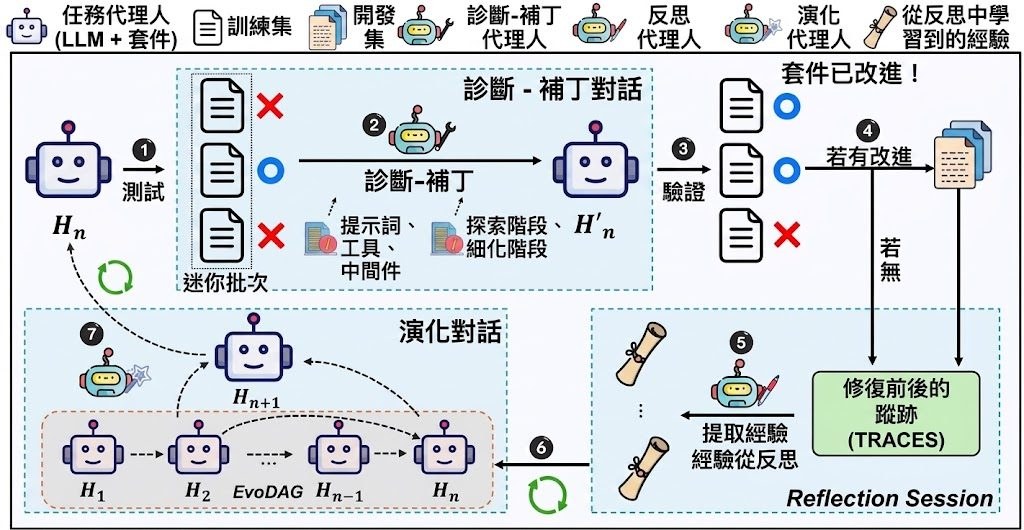
AutoSaddler 係一個用嚟自動優化 LLM agent harness 嘅開源項目,處理嘅係長流程任務入面,agent 因為提示詞、工具或控制邏輯有少少偏差,就一路累積錯誤而失敗呢個問題。佢唔係單靠反覆改 prompt,而係將 harness 當成程式去診斷同修補。
佢會分析執行 trace,找出失敗根源,再按既定補丁分類去改 prompts、tools、middleware 同 agent-loop logic。資料夾同 佢用 durable、plugin-based 方式記錄狀態,適合要反覆試驗、回復同追蹤修改歷程嘅工作流。
同類方法通常只改少量提示詞,AutoSaddler 就將搜索範圍擴大到整個 harness,仲會用 validation 去挑選較能泛化嘅更新。初步結果顯示,佢喺 GAIA2、SWE-Bench Pro 同 Terminal-Bench 2.0 都帶來約 9 到 10 個百分點嘅 Pass@1 提升。
對做 agent 系統、評測框架或者自動化工作流嘅團隊特別有用,因為佢處理唔係單一模型輸出,而係整套執行環境點樣更穩定。項目要求 Python 3.12-3.14、uv 同 Git,官方建議用 uv run 去執行 Python 指令,代表佢偏向可重現同可追蹤嘅研究與工程整合。
- 以 failure trace 診斷問題,唔係淨係做表面反思
- 改動範圍包括 prompt、工具、middleware 同 agent loop
- 會驗證更新喺其他情境可唔可以保持效果
- 初步 benchmark 結果顯示有明顯提升
- 適合要持續調整 LLM agent harness 嘅團隊