chi-bench:測試醫療 AI 代理真功夫

這個專案不是聊天測驗,而是叫 AI 真正處理醫療流程。它特別適合想比較代理模型實戰能力的人。

χ-Bench

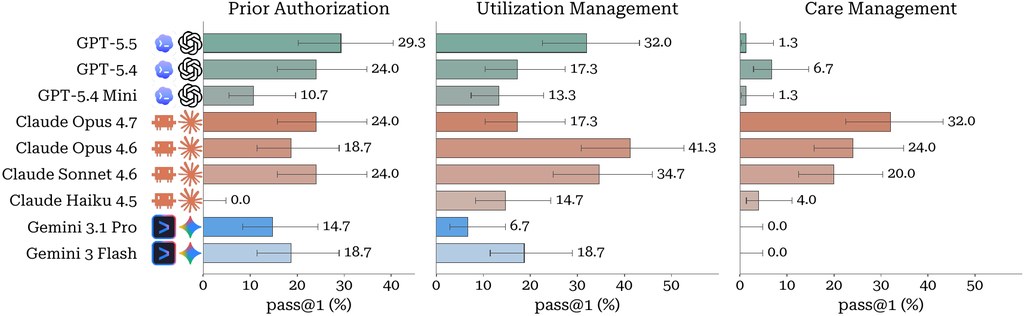
chi-bench 係一個用來評估 AI 代理嘅基準環境,重點唔係問答,而係要模型喺模擬出嚟嘅美國醫療工作流程中,逐步完成整個個案。它覆蓋事前授權、保險方利用管理,以及群體照護管理三類長流程工作,目的是測試 AI 有冇能力處理多步驟、規則密集、而且涉及多角色協作嘅任務。

官方摘要提到它使用 20 個 healthcare apps、87 個 MCP tools,以及一份 1,290+ 文件的 managed-care operations handbook 作為任務依據。

實際使用時,研究者通常會先準備對應嘅 API 金鑰,再揀選代理框架同模型跑任務,之後由內建評審機制按每次結果評分。每個任務會提供臨床個案、模擬工作系統,以及大量操作手冊,AI 要透過工具呼叫同撰寫文件去推進流程,唔係單靠生成一段答案就算完成。

它最有意思嘅地方,在於把醫療行政流程入面最麻煩嘅部分具體化:規則多、文件多、系統多,而且中途可能要反覆互動。相比一般 benchmark 只量度單步推理,chi-bench 更接近現實世界,因為它會考驗模型點樣跨應用程式、跟住政策辦事,並保持長時間決策一致。

  • 涵蓋 3 大醫療流程場景,屬於端到端任務評估
  • 以約 20 個模擬醫療應用及大量文件作為操作環境
  • 支援多類代理與模型比較,包括 Claude、OpenAI、Gemini 及開源權重路線
  • 排行榜以 pass@1 為主,亦可保留多次試跑作額外分析

從現有資料睇,呢個基準對現時最強模型都相當困難,代表它有一定鑑別力,唔會輕易被高分掩蓋弱點。已知相關配置包括 Claude Code 配 Claude Opus、OpenAI/Codex 路線、Gemini CLI,以及經 OpenRouter 接入嘅 Hermes、OpenClaw、DeepAgents 等;至於具體表現會隨代理包裝方式同工具使用能力而有明顯差異。

對 AI 代理研究員、醫療流程自動化團隊,甚至想了解「模型識唔識真做事」嘅產品人員嚟講,chi-bench 都幾有參考價值。不過它聚焦美國醫療制度同受規管流程,閱讀結果時要留意場景限制,唔適宜直接當成所有行業嘅通用結論。
GitHub: https://github.com/actava-ai/chi-bench

Paper: https://arxiv.org/pdf/2605.16679

Categories: 開源, 框架, Medical醫學

RealICU:測試AI能否真正讀懂深切治療數據

RealICU用更貼近臨床現實的方法,評估大型語言模型是否能理解長時間、密集變化的ICU資料。它不只看AI會否模仿醫生,更重視判斷是否合理與安全。

Og image

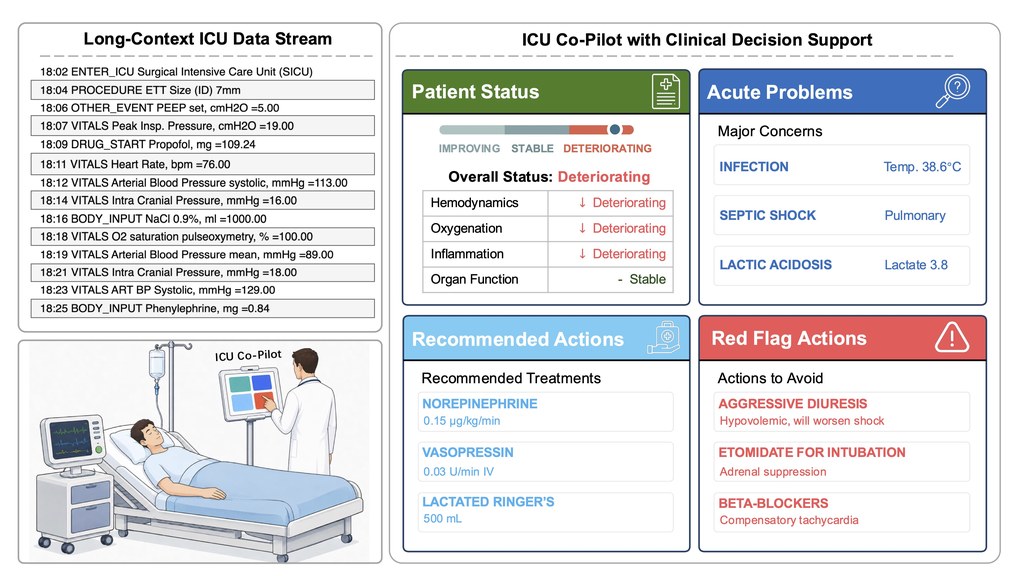
RealICU 是一個用來評估大型語言模型在深切治療部情境下表現的基準。重點不在於AI有沒有照抄以往醫生做過的決定,而是看它面對長時間、資訊密集又持續變化的病人資料時,能否作出較接近臨床正確性的判斷。

如果你對醫療人工智能有興趣,RealICU-Bench 值得留意。它聚焦深切治療部入面又長又密集的病人資料,目的唔係叫模型照抄過往醫生做法,而係測試模型面對完整病程時,能否作出更合理判斷。

這個項目針對一個很實際的問題:ICU 決策往往要在高壓下,快速整合大量檢驗、監測和病程資訊。現有不少評估方法把歷史醫療行為當作標準答案,但原始決策當時可能資訊未齊全,因此未必最理想;RealICU 改用事後回顧整個病人歷程的標註方式,嘗試更公平地評估AI推理能力。

如果你想了解或使用這個項目,最適合由它定義的四類任務入手:病人目前情況、急性問題、建議處置,以及需要避免的危險行動。網站亦提供論文與程式碼入口,而資料集顯示仍有部分內容即將推出;若你是研究者,可先用 RealICU-Gold 和 RealICU-Scale 的設計思路,理解其評估框架。

  • 由超過30位臨床醫生共同界定核心任務
  • 包含 930 個醫生共識樣本,以及 11,862 個大規模評估視窗
  • 引入經醫生驗證的 LLM 評估器作大規模標註
  • 提出 ICU-Evo,以結構化記憶研究長時序推理
  • 發現前沿模型存在召回與安全之間的取捨,以及錨定偏差

這個項目的創新之處,在於它把評估焦點由「像不像醫生以前做過的事」轉向「是否真正理解病情演變」。另外,ICU-Evo 用多種結構化記憶整理臨床上下文,較貼近醫生思考方式;不過作者亦明確指出,這類方法雖有助長程推理,仍不足以保證安全。

整體而言,RealICU 特別適合醫療AI研究者、醫院創新團隊,以及關注高風險場景AI安全的人士。從現有結果看,這不是一個宣稱模型已可直接臨床部署的項目,而是一個更嚴謹的測試場,幫助大家看清AI在真實重症決策支援中的能力與限制。

層級作用規模標註方式
RealICU整體 benchmark全部框架包含 Gold 和 Scale 兩部分 
RealICU-Gold高品質基準集930 windows / 94 patients醫師共識標註 
RealICU-Scale大規模延伸集11,862 windowsOracle 自動擴展標註 

在 RealICU-Gold 上,Gemini-3.1-pro + ICU-Evo 達到 Patient Status 0.459、Action Recommendation Recall@5 0.534;同時,structured memory 雖然提升了長程推理,但仍然沒有徹底解決安全失敗和 anchoring bias. 也就是說,ICU-Evo 是“更好的 memory-based agent”,但不是把 RealICU 這個 benchmark 作為最終方案。

RealICU
├─ RealICU-Gold
│  └─ 930 個 window,來自 94 個 ICU stays
│     └─ 由多位 ICU 醫師做 hindsight consensus 標註
└─ RealICU-Scale
   └─ 11,862 個 window
      └─ 用 Oracle(醫師驗證過的 LLM hindsight evaluator)自動擴展標註

網址: https://chengzhi-leo.github.io/RealICU-Bench/

Categories: 開源, 框架, Medical醫學

Healthcare_GYM:醫療代理訓練場

這個專案把醫療知識檢索、工具使用與強化學習整合成可訓練環境。對想做多回合臨床代理的團隊來說,實用性相當明確。

Repository image for minstar/Healthcare_GYM

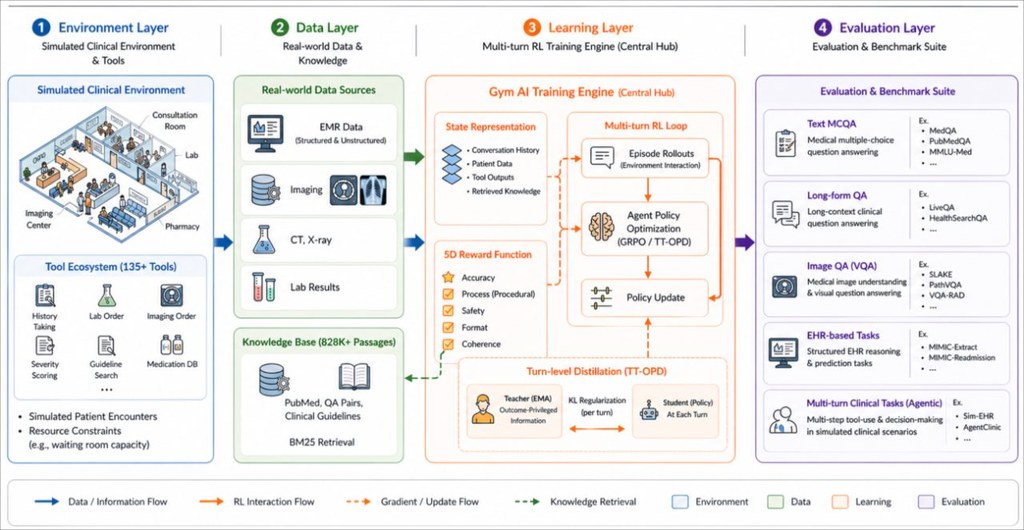
Healthcare_GYM 是一個相容 Gymnasium 的醫療 AI 訓練環境,核心目的不是單純問答,而是讓代理在多回合流程中學會查資料、呼叫工具並完成臨床任務。它涵蓋 10 個臨床領域、3,600 多個任務與 135 個專用工具,並把 82.8 萬筆醫療段落納入可檢索知識庫。

實際使用上,它比較像給研究團隊的「醫療代理測試場」。若你已經有強化學習流程,就能透過標準的環境互動介面,把代理接到任務、工具呼叫與回饋函數上,觀察模型在臨床推理、資訊檢索與多步驟決策中的表現。

這個專案最值得注意的創新,是提出 TT-OPD 這套多回合代理式 RL 的自蒸餾方法。從說明來看,作者認為 teacher 會隨學生探索而逐漸過時,因此蒸餾價值主要集中在訓練前期,並以 EMA 教師與週期性硬同步控制師生偏移,而不是長期依賴固定 teacher。

從結果來看,它在 18 個基準中的 10 個拿到最佳成績,平均比非 RL 的代理基線高出約 3.9 個百分點。不過資料也顯示,代理式評估未必在所有知識回憶型任務都占優,代表這套框架更適合需要檢索、工具操作與多步推理的情境,而不是只比裸模型記憶能力。

  • 重點摘要
  • 支援多回合臨床工具使用,不只是靜態醫療問答。
  • 知識來源包含 PubMed 摘要、臨床指引與醫學教科書。
  • 以 BM25 檢索 82.8 萬筆醫療段落,工具呼叫直接納入動作空間。
  • TT-OPD 以 EMA teacher 與分階段淡出蒸餾來穩定訓練。
  • README 指出實驗使用 Qwen3.5-9B 骨幹模型。

整體而言,Healthcare_GYM 最適合醫療代理、臨床決策輔助研究、RAG 結合工具使用的 RL 訓練,以及需要比較不同代理策略的學術實驗。若你的目標是建立可重現的醫療 agent benchmark,這個專案提供的環境設計與訓練觀點都相當有參考價值。

Source: https://github.com/minstar/Healthcare_GYM

Categories: Medical醫學

MedConclusion 一個用於生物醫學結論生成的基準資料集

MedConclusion 包含 570 萬個 PubMed 結構化摘要,每個樣本將非結論部分與作者原寫結論配對,用於訓練和評估大型語言模型(LLM)從證據推斷結論的能力。資料集還包含期刊元數據,如生物醫學類別和 SJR 指標,支持跨領域子群分析。論文於 2026 年 4 月 7 日提交至 arXiv,主題涵蓋計算語言學(cs.CL)和人工智慧(cs.AI)。 研究評估了多種 LLM 在結論生成和摘要生成提示下的表現,使用參考基準指標和 LLM-as-a-judge 評分。結果顯示,結論寫作與摘要寫作行為不同,強模型在自動指標下仍緊密聚集,且評判者身份會大幅影響分數。這提供了一個可重用資源,用於研究科學證據到結論的推理,程式碼和資料在 GitHub 上公開。

MedConclusion 包含 570 萬個 PubMed 結構化摘要,每個樣本將非結論部分與作者原寫結論配對,用於訓練和評估大型語言模型(LLM)從證據推斷結論的能力。
資料集還包含期刊元數據,如生物醫學類別和 SJR 指標,支持跨領域子群分析。
論文於 2026 年 4 月 7 日提交至 arXiv,主題涵蓋計算語言學(cs.CL)和人工智慧(cs.AI)。

研究評估了多種 LLM 在結論生成和摘要生成提示下的表現,使用參考基準指標和 LLM-as-a-judge 評分。結果顯示,結論寫作與摘要寫作行為不同,強模型在自動指標下仍緊密聚集,且評判者身份會大幅影響分數。這提供了一個可重用資源,用於研究科學證據到結論的推理,程式碼和資料在 GitHub 上公開。

Categories: 開源, Medical醫學

TRIBE v2 (Meta) 全腦神經活動資訊

TRIBE v2(Trimodal Brain Encoder)是一個多模態基礎模型,用於輸入一段影片、音訊或文字,然後輸出一個對應的「全腦神經活動圖」(約 7 萬個體素的 fMRI‑style 活動預測)。它在 Algonauts 2025 獲獎架構上進一步提升,準確度約是上一代 2–3 倍,空間解析度提高約 70 倍,並支援跨受試者、跨語言、跨任務的 zero‑shot 預測。 可以當成一個「神經科學可視化工具」,用來研究。例如內容設計(影片、廣告、UI)如何觸發大腦特定區域(視覺皮層、語言區等)。又或者多模態 embedding 是否真的對齊人類大腦的處理路徑。 若你在做 RAG、多模態搜尋或 Brain‑AI 類實驗,可以拿這個 demo 來:比較不同 prompt/多模態輸入對「腦激活圖」的差異(例如:同一段文字用不同語氣、圖片風格重製)。

TRIBE v2(Trimodal Brain Encoder)是一個多模態基礎模型,用於輸入一段影片、音訊或文字,然後輸出一個對應的「全腦神經活動圖」(約 7 萬個體素的 fMRI‑style 活動預測)。
它在 Algonauts 2025 獲獎架構上進一步提升,準確度約是上一代 2–3 倍,空間解析度提高約 70 倍,並支援跨受試者、跨語言、跨任務的 zero‑shot 預測。

可以當成一個「神經科學可視化工具」,用來研究。例如內容設計(影片、廣告、UI)如何觸發大腦特定區域(視覺皮層、語言區等)。又或者多模態 embedding 是否真的對齊人類大腦的處理路徑。

若你在做 RAG、多模態搜尋或 Brain‑AI 類實驗,可以拿這個 demo 來:比較不同 prompt/多模態輸入對「腦激活圖」的差異(例如:同一段文字用不同語氣、圖片風格重製)。

Categories: 開源, 視覺模型, Medical醫學, Meta

醫療 SAM3 省卻重新標註

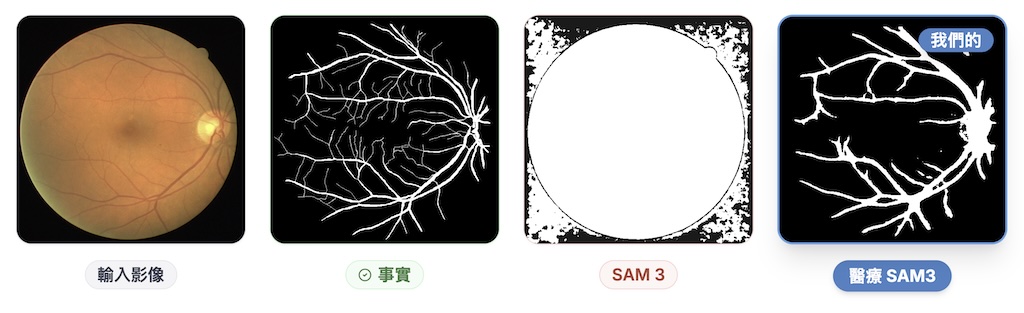
Medical‑SAM3 目標是做一個類似 SAM/Segmentation Foundation 的醫療版,但是真正「通用」到多器官、多疾病、多成像模態(CT、MRI、超音波等),並且支持多種互動式 prompt。 動機在於現有醫療分割模型普遍是單任務 / 單器官 / 單模態,泛化到新醫院、新機器或新部位時效果差,需要大量重新標註。Medical‑SAM3 想以大規模預訓練 + prompt-conditioning 來解決這個問題。因此在新的檢查方式或少數族群資料面前能跨機構使用。 Medical‑SAM3 基於多個公開醫療影像資料集進行大規模預訓練與評估,涵蓋多器官、多模態和多中心資料,以求提升 domain shift 下的泛化能力。

Medical‑SAM3 目標是做一個類似 SAM/Segmentation Foundation 的醫療版,但是真正「通用」到多器官、多疾病、多成像模態(CT、MRI、超音波等),並且支持多種互動式 prompt。

動機在於現有醫療分割模型普遍是單任務 / 單器官 / 單模態,泛化到新醫院、新機器或新部位時效果差,需要大量重新標註。Medical‑SAM3 想以大規模預訓練 + prompt-conditioning 來解決這個問題。因此在新的檢查方式或少數族群資料面前能跨機構使用。

Medical‑SAM3 基於多個公開醫療影像資料集進行大規模預訓練與評估,涵蓋多器官、多模態和多中心資料,以求提升 domain shift 下的泛化能力。

Screenshot
Categories: 開源, 香港理工大學, Medical醫學

MedGemma 1.5 醫學影像更新

人工智慧在醫療保健領域的應用正以驚人的速度加速發展,其應用速度是整體經濟的兩倍。為了支持這項變革,Google去年透過其健康人工智慧開發者基金會(HAI-DEF) 計畫發布了 MedGemma 開源醫療生成式人工智慧模型集。 MedGemma 等 HAI-DEF 模型旨在為開發者提供評估和調整的起點,以適應其醫療應用場景,並且可以透過 Vertex AI 在Google雲端 上輕鬆擴展。 MedGemma 的發布反應熱烈,下載量達數百萬次,並在 Hugging Face 上發布了數百個社區構建的變體。

人工智慧在醫療保健領域的應用正以驚人的速度加速發展,其應用速度是整體經濟的兩倍。為了支持這項變革,Google去年透過其健康人工智慧開發者基金會(HAI-DEF) 計畫發布了 MedGemma 開源醫療生成式人工智慧模型集。 MedGemma 等 HAI-DEF 模型旨在為開發者提供評估和調整的起點,以適應其醫療應用場景,並且可以
透過 Vertex AI 在Google雲端 上輕鬆擴展。 MedGemma 的發布反應熱烈,下載量達數百萬次,並
在 Hugging Face 上發布了數百個社區構建的變體。

Categories: 開源, 模型, Google, Medical醫學

MCD-rPPG 非接觸式健康監測的未來

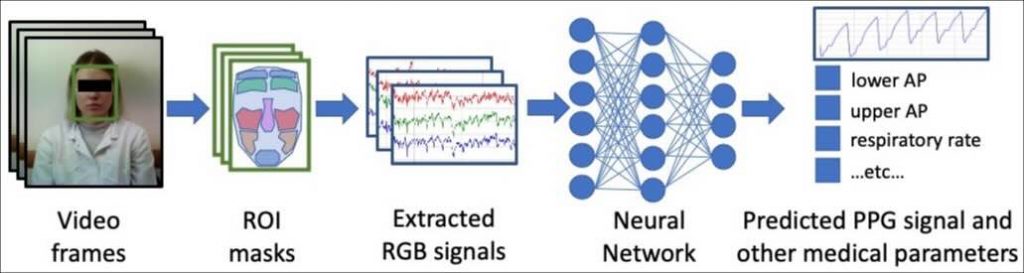
大規模多模態 MCD-rPPG 資料集旨在用於遠程光電容積脈搏波 (rPPG) 和基於視訊的健康生物標記估計。此資料集包含 600 名受試者在靜止和運動後狀態下,從三個攝影機以不同角度拍攝的同步視訊記錄、PPG 和 ECG 訊號以及擴展的健康指標(動脈血壓、血氧飽和度、壓力水平等)。 我們還提供了一個高效的多任務神經網路模型,即使在 CPU 上也可以即時估計臉部視訊中的脈搏波訊號和其他生物標記。(Paper)

大規模多模態 MCD-rPPG 資料集旨在用於遠程光電容積脈搏波 (rPPG) 和基於視訊的健康生物標記估計。此資料集包含 600 名受試者在靜止和運動後狀態下,從三個攝影機以不同角度拍攝的同步視訊記錄、PPG 和 ECG 訊號以及擴展的健康指標(動脈血壓、血氧飽和度、壓力水平等)。

我們還提供了一個高效的多任務神經網路模型,即使在 CPU 上也可以即時估計臉部視訊中的脈搏波訊號和其他生物標記。(Paper)

(more…)
Categories: 開源, Medical醫學

ZARA 人類身體活動識別框架

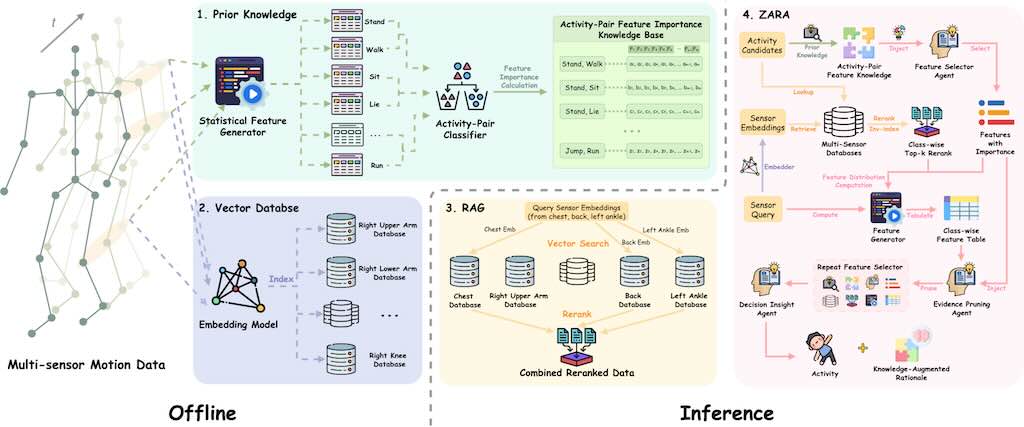
ZARA 是一個用於人類身體活動識別 (HAR Human Activity Recognition) 的新型框架,它利用穿戴式感測器的原始運動數據。傳統的 HAR 系統通常需要針對特定任務的深度學習模型進行昂貴的重新訓練,而且在引入新感測器或未見活動時,其泛化能力和零樣本識別能力有限,同時也缺乏可解釋性。 ZARA 透過結合多感測器檢索增強生成 (RAG)、自動化的成對領域知識注入和層次代理式大型語言模型 (LLM) 推理來克服這些限制。ZARA 不需額外訓練,就能在多種數據集和感測器配置上實現零樣本分類,其性能超越現有方法,並可提供驗證。研究強調了其檢索、知識庫和代理模組在提升準確性和支援決策方面的關鍵作用。

ZARA 是一個用於人類身體活動識別 (HAR Human Activity Recognition) 的新型框架,它利用穿戴式感測器的原始運動數據。傳統的 HAR 系統通常需要針對特定任務的深度學習模型進行昂貴的重新訓練,而且在引入新感測器或未見活動時,其泛化能力和零樣本識別能力有限,同時也缺乏可解釋性。

ZARA 透過結合多感測器檢索增強生成 (RAG)、自動化的成對領域知識注入和層次代理式大型語言模型 (LLM) 推理來克服這些限制。ZARA 不需額外訓練,就能在多種數據集和感測器配置上實現零樣本分類,其性能超越現有方法,並可提供驗證。研究強調了其檢索、知識庫和代理模組在提升準確性和支援決策方面的關鍵作用。

Categories: 開源, RAG, 視覺模型, Medical醫學

 MedRAX 肺片推理 Agent

 MedRAX 是個專為胸部 X 光影像 (俗稱肺片) 所設計的醫療推理 Agent。它的主要功能是將 X 光分析工具 C X R,以多模態整合成為一個統一的模型框架,它可以處理複雜的醫療查詢而無需要額外的訓練。為了驗證它的能力,開發團隊透過一個名為 Chest Agent Bench 的綜合評估基準測試,包括 7 個不同類別的 2,500 個醫療查詢。而最終實驗結果顯示 Med RAX 在性能上超越了同類型的模型。

 MedRAX 是個專為胸部 X 光影像 (俗稱肺片) 所設計的醫療推理 Agent。它的主要功能是將 X 光分析工具 C X R,以多模態整合成為一個統一的模型框架,它可以處理複雜的醫療查詢而無需要額外的訓練。為了驗證它的能力,開發團隊透過一個名為 Chest Agent Bench 的綜合評估基準測試,包括 7 個不同類別的 2,500 個醫療查詢。而最終實驗結果顯示 Med RAX 在性能上超越了同類型的模型。

Screenshot

Categories: Agentic, OpenAI, Medical醫學

Page 5 of 6
1 … 3 4 5 6