OpenBioRQ 用未解醫學問題測試 AI 代理

這不是一般醫學問答集,而是用未解研究問題檢驗 AI 代理找證據與引用是否可信。它更重視能否誠實保留不確定性。

Repository image for minstar/healthcare-research

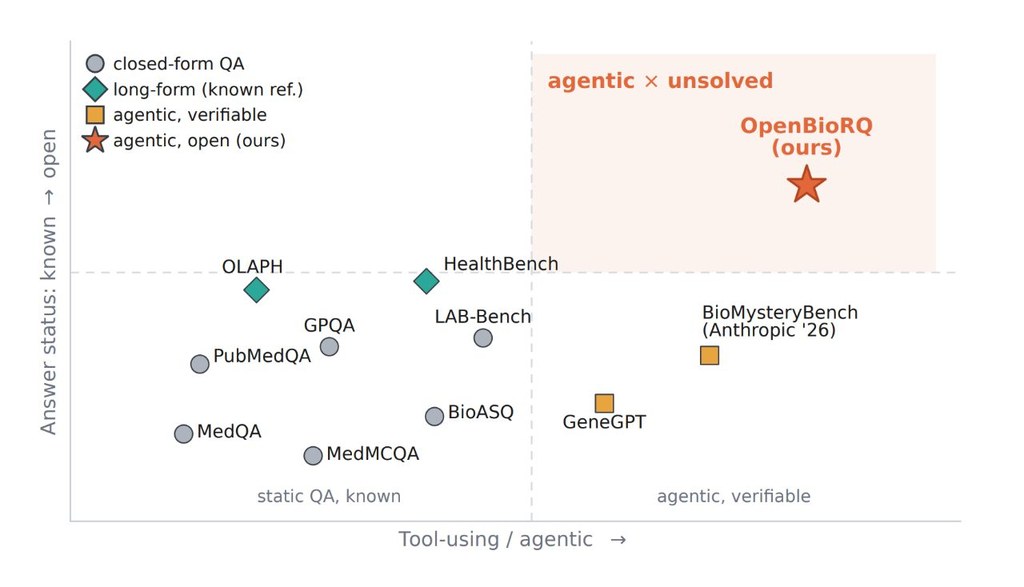
OpenBioRQ 是一個生物醫學基準資料集兼評測流程,聚焦於目前仍未解決的 biomedical / clinical research questions。它要解決的不是背答案能力,而是測試 LLMs 在 agentic tool use 情境下,能否自己找證據、正確引用文獻,並在沒有定論時保持 abstention。

現有 benchmark 多數採用固定答案 key 的問答範式,模型有機會靠記憶或線索反推標準答案,未必真的驗證過來源。OpenBioRQ 直接改用 retrieval-grounded openness:每條問題的 open_status 會用後續論文與 trial records 重新核對;難度也不是作者主觀標示,而是先讓強模型連工具一起跑,再用 pass/fail 結果界定哪些題目真的難。

項目的資料流程相當完整,從 crawl、extract、refine、dedup,到 status verification、contamination audit、agentic-eval 都有清楚分工。README 顯示它以 v3 的 12,553 題為基礎,另有 frozen core 作主要評測集;refine 步驟亦把問題整理成較自足的表述,自含性由 51.6% 提升到 85.4%,這對模型和人工評審都重要。

它和同類做法最大的分別,是把「引用可打開」與「引用真的支持答案」分開看。項目指出 agent citations 超過 99% 可以解析,但約 15.9% 其實連到錯誤論文;同時最難題組出現 agentic collapse,部分模型就算關掉工具,分數變化也不大,反映工具調用未必自然轉化成更好推理。

  • 類型定位:屬於基準資料集加評測 pipeline,不是臨床決策系統
  • 主要價值:檢查 evidence retrieval、faithful citation 與 abstention,而非考模型背誦
  • 評測設計:用 per-question checklist rubrics 固定評分,inter-judge agreement 由 Spearman 0.35 升到 0.82
  • 資料可靠性:core 657 與 expand 483 均報告 contamination hard 0%
  • 相關模型:Google、Anthropic、OpenAI 三條獨立 lineage,以及 README 提到的 GLM-5.1、MiniLM-L6

受惠最大的會是做醫療研究助理、文獻檢索代理、醫學 AI 評測的團隊,而不是想直接拿去做診斷的機構。它目前更像一個研究基建項目:幫人看清楚模型在高不確定、無標準答案場景下,究竟是有能力找證據,還是只是在生成看似合理的回答。
項目主頁 · GitHub · Paper

Categories: 開源, Agentic, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, Medical醫學, Anthropic, Dataset 數據集

Qwen-AgentWorld:用語言模型模擬七大代理環境的世界模型

Qwen-AgentWorld 是首個覆蓋 MCP、Search、Terminal、SWE 等七大領域的原生語言世界模型,透過三階段訓練管線與千萬級真實互動軌跡,為代理訓練提供可擴展、可控的環境模擬器。

logo

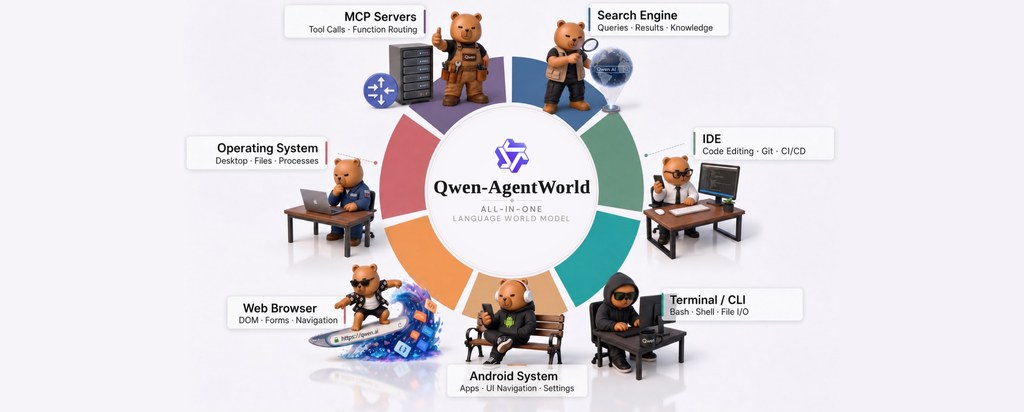
Qwen-AgentWorld 是阿里 Qwen 團隊開源的語言世界模型(Language World Model),屬於模型與訓練框架類項目,核心任務是透過長鏈思維推理模擬代理(agent)在七大領域的環境動態,並為代理強化學習提供可擴展、可控的模擬環境。

現有做法普遍把世界模型視為代理訓練完成後的「後加配件」(post-hoc add-on),僅在需要時才引入環境模擬能力,這種範式限制了模擬品質與遷移效果。Qwen-AgentWorld 的差異在於從 CPT 階段起就把環境建模作為訓練目標,透過 CPT 注入環境知識、SFT 啟動下一狀態預測推理、RL 以混合獎勵機制銳化模擬保真度,最終在超過 1000 萬條真實互動軌跡上完成訓練。

這個項目同時釋出 Qwen-AgentWorld-35B-A3B(MoE 架構,總參數 350 億、激活 30 億、256K 上下文)以及 AgentWorldBench 評測基準,後者涵蓋 Tool Decathlon、Terminal-Bench 1.0/2.0、OSWorld-Verified 等九個基準,從五個維度以真實標籤評分世界模型品質。團隊亦提出兩種互補應用範式:作為解耦的環境模擬器支援大規模代理 RL,或作為統一代理基礎模型,以世界模型預訓練作為下游代理任務的暖身步驟。

重點摘要:

  • 七大統一領域:MCP、Search、Terminal、SWE、Android、Web、OS,首次由單一語言模型覆蓋。
  • 原生世界模型:環境建模從 CPT 階段即為訓練目標,非後加適配。
  • 可泛化模擬器:支援零樣本遷移到分布外環境(如 Claw Agent),並允許可控擾動與虛構世界構建。
  • 代理基礎模型:單輪非代理軌跡上的 LWM RL 暖身,可遷移至多輪工具調用代理任務。
  • 開源權重與基準:模型權重與 AgentWorldBench 均於 Hugging Face 與 ModelScope 釋出。

部署方面,模型可透過 Hugging Face 模型 ID 直接下載,或在無法存取 HF Hub 的環境下透過 ModelScope 配合 SGLang、vLLM 等框架載入。對於需要大量代理 RL 訓練數據的團隊,這個項目提供了一條以模擬取代部分真實環境互動的路徑,有助降低成本並提升可控性。

GitHub: https://github.com/QwenLM/Qwen-AgentWorld

Paper: https://arxiv.org/pdf/2606.24597

Categories: 開源, 阿里巴巴, Agentic, MCP, 模型, 世界模型, 模型訓練, Qwen, 框架, 深度學習

TVEdit:文字與點拖軌跡合一的圖片編輯項目

TVEdit 把文字意圖同視覺軌跡一併建模,令圖片編輯更準確。它亦自建評測,檢查語意、位置同畫面一致性。

TV-Edit Gradio demo

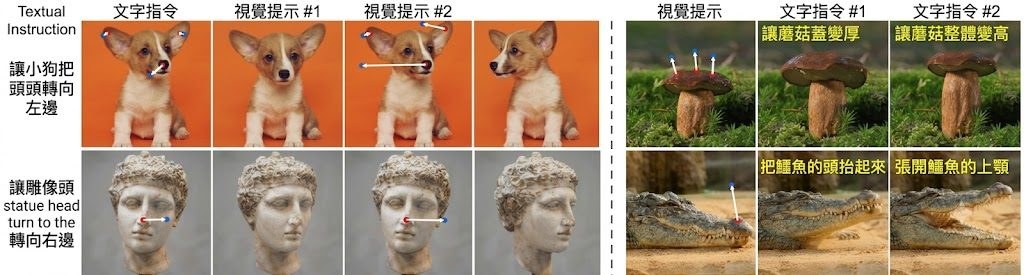
TVEdit 是一個圖像編輯項目,目標是解決「只靠文字講意思,或者只靠拖點講位置」都不夠準的問題。以往文字指令較易表達語意,但難控制空間;點拖軌跡可以指位置,卻容易令語意變得含糊,所以作者把兩者合併成 Text-Vision Co-Instructed Image Editing。

這項目的做法是用一個文本與視覺指令配對資料集來訓練,資料超過 23K 筆,來源與動態影片有關。再配合 TV-Edit 框架,把拖曳或點選等視覺指令轉成更有語意的控制表示,然後接到預訓練編輯骨幹上,例如 Qwen-Image-Edit。

它能同時處理「想改成什麼」與「要改到哪裡」,而不是只偏重其中一邊。作者另外建立了 TV-Edit-Bench,專門看語意忠實度、空間對齊同畫面一致性,這比一般只看最終效果的做法更能反映模型有沒有真正聽懂指令。

先載入 Qwen-Image-Edit,再配 TV-Edit 權重,之後在 Gradio 介面上上傳圖片、畫出軌跡、輸入文字指令,再調 CFG 同步數生成結果。若有加速 LoRA,步數可以大幅減少,適合想快速試驗互動式編輯的人。

  • 結合文字語意與點拖軌跡,令空間控制更細
  • 用 23K+ 配對資料補足跨模態指令訓練
  • TV-Edit-Bench 同時看語意、位置、畫面一致性
  • 目前已提供推理程式、模型權重同網頁示範
  • 適合做互動式圖片編輯、研究評測或模型整合

GitHub: https://github.com/PolyU-VCLab/TVEdit

Paper: https://arxiv.org/pdf/2606.16767

Categories: 開源, 香港理工大學, 阿里巴巴, Agentic, RAG, MCP, 模型, 視覺模型, 模型訓練, Qwen, Image, 影像模型, 影像處理, 框架

PhoneHarness:重新量度手機代理能力

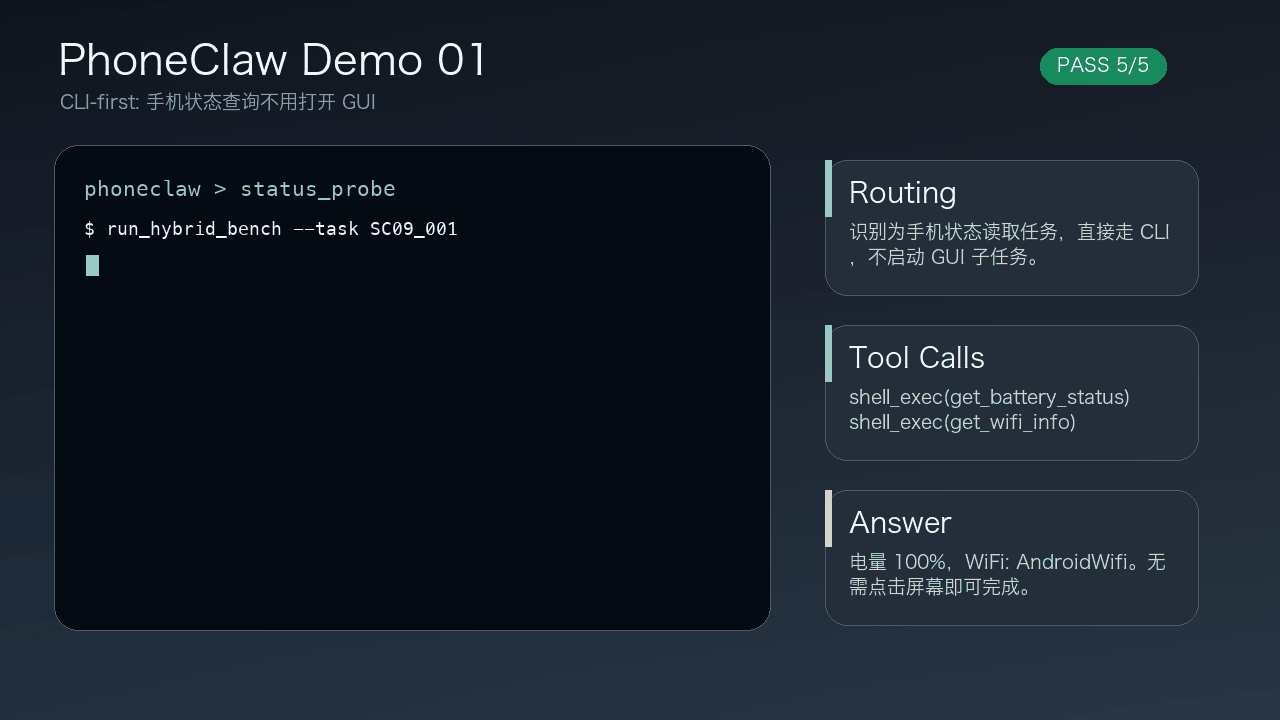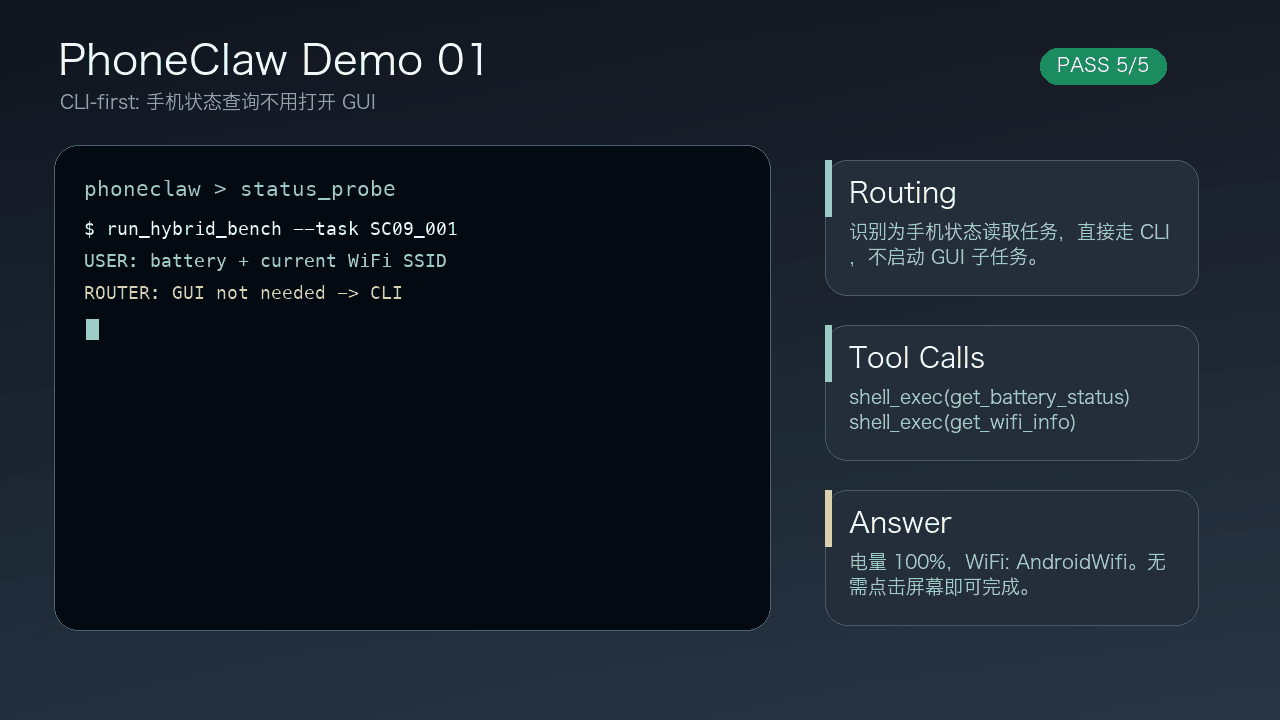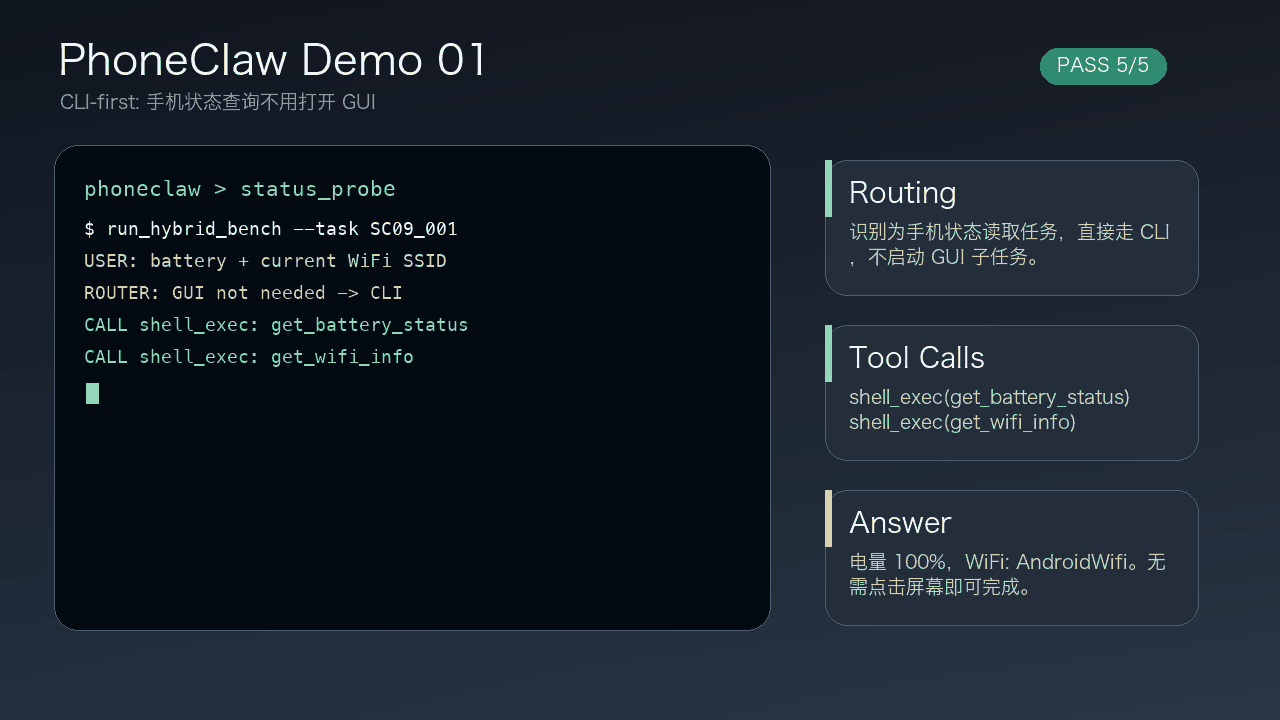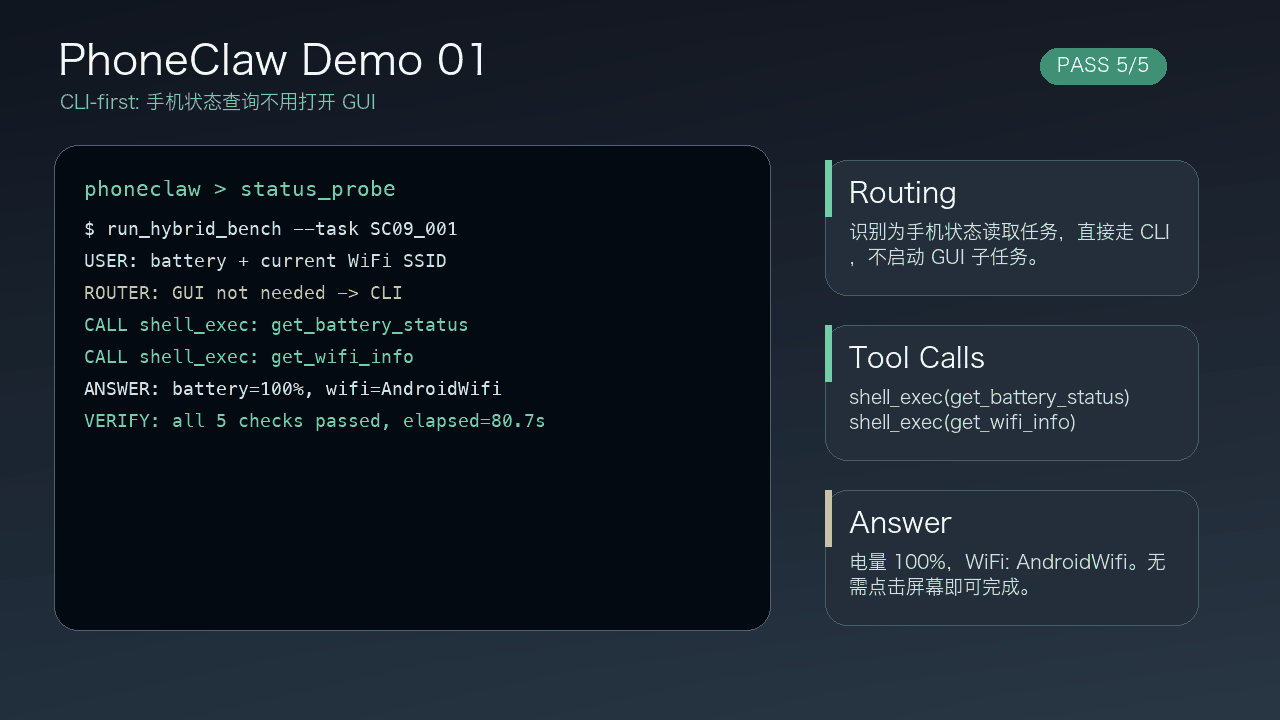
它不只看下一步點擊,而是看有沒有真正做成事。PhoneHarness 把 GUI、CLI 和工具動作放在同一個手機代理評測框架。

PhoneHarness CLI status demo

PhoneHarness 是一個混合動作的手機代理評測框架與基準,解決只靠 GUI 點按去評分、卻量不到真實副作用的問題。論文指出,手機任務往往需要在 GUI、CLI 與 structured tools 之間切換,單看最後畫面會漏掉很多關鍵步驟。

它的做法是把行動路由、GUI 委派和可追蹤執行記錄放進同一個流程。當任務有明確可執行路徑時,系統會優先走 CLI 或 MCP 完成;只有必要時才交由 GUI worker 透過截圖互動,令評測更貼近真正手機工作流。

這個項目的新意在於把「能否完成」和「是否留下可驗證證據」綁在一起。JSONL traces 和 HTML viewer 令失敗可以被拆成模型推理、GUI 對齊、環境、工具或 verifier 不一致幾類,方便找出問題來源,而不是只見到一個分數。

論文中的 PhoneHarness Bench 在 annotated evaluation split 上取得 75.0% pass rate,較最強的非 PhoneHarness 設定高 12.9 個百分點。這表示它不只是測試介面操作,還在測試代理怎樣選擇動作面,對做手機自動化、裝置測試、或需要可審計流程的團隊都幾有參考價值。

  • 混合支援 GUI、CLI、MCP tools,適合手機工作流評測
  • 優先 deterministic 路由,減少不必要的畫面操作
  • 可追蹤 traces,方便定位錯誤來源
  • 適合研究 phone agents、裝置自動化與安全副作用檢查

相關模型/基準可一併留意:PhoneHarness、PhoneHarness Bench、AndroidWorld、AppAgent、Mobile-Agent-v2、MobileAgentBench、AndroidLab。

GitHub: https://github.com/PhoneHarness/PhoneHarness

項目: https://phoneharness.github.io/

Categories: 開源, Agentic, MCP, 模型, 框架, 軟件, 工具, 安全

GitHub Copilot CLI 正式發佈

GitHub Copilot 編碼代理的強大功能直接帶到您的終端。透過 GitHub Copilot CLI,您可以在本地與能夠理解您的程式碼和 GitHub 上下文的 AI 代理程式同步工作。

GitHub Copilot 編碼代理的強大功能直接帶到您的終端。透過 GitHub Copilot CLI,您可以在本地與能夠理解您的程式碼和 GitHub 上下文的 AI 代理程式同步工作。

Categories: 開源, MCP, Vibe Coding, Mac, Linux, 編程, Win

Chrome MCP 伺服器

Chrome MCP 伺服器是一款基於 Chrome 擴充功能的模型上下文協定 (MCP) 伺服器,它將您的 Chrome 瀏覽器功能開放給 Claude 等 AI 助手,從而實現複雜的瀏覽器自動化、內容分析和語義搜尋。與傳統的瀏覽器自動化工具(例如 Playwright)不同,Chrome MCP 伺服器直接使用您日常使用的 Chrome 瀏覽器,利用現有的使用者習慣、配置和登入狀態,讓各種大型模型或聊天機器人控制您的瀏覽器,真正成為您的日常助理。

Chrome MCP 伺服器是一款基於 Chrome 擴充功能的
模型上下文協定 (MCP) 伺服器,它將您的 Chrome 瀏覽器功能開放給 Claude 等 AI 助手,從而實現複雜的瀏覽器自動化、內容分析和語義搜尋。與傳統的瀏覽器自動化工具(例如 Playwright)不同,
Chrome MCP 伺服器直接使用您日常使用的 Chrome 瀏覽器,利用現有的使用者習慣、配置和登入狀態,讓各種大型模型或聊天機器人控制您的瀏覽器,真正成為您的日常助理。

ai 编程测试, chrome mcp server ,自动化必备,web 开发必备工具!
Categories: 開源, MCP, Mac, Linux, 編程, Win

Spec-Workflow MCP

模型上下文協定 (MCP) 伺服器為 AI 輔助軟體開發提供結構化的規範驅動的開發工作流程工具,具有即時 Web 儀表板和 VSCode 擴展,可直接在開發環境中監控和管理專案進度。 https://github.com/Pimzino/spec-workflow-mcp

模型上下文協定 (MCP) 伺服器為 AI 輔助軟體開發提供結構化的規範驅動的開發工作流程工具,具有即時 Web 儀表板和 VSCode 擴展,可直接在開發環境中監控和管理專案進度。

https://github.com/Pimzino/spec-workflow-mcp

颠覆AI写代码的MCP插件:超越kiro 支持所有AI代码工具,有效减少AI拉扯,提升效率200%
Categories: 開源, MCP, Vibe Coding, 編程

Chrome MCP

Chrome MCP 伺服器是一款基於 Chrome 擴充功能的模型上下文協定 (MCP) 伺服器,它將您的 Chrome 瀏覽器功能開放給 Claude 等 AI 助手,從而實現複雜的瀏覽器自動化、內容分析和語義搜尋。與傳統的瀏覽器自動化工具(例如 Playwright)不同,Chrome MCP 伺服器直接使用您日常使用的 Chrome 瀏覽器,利用現有的使用者習慣、配置和登入狀態,讓各種大型模型或聊天機器人控制您的瀏覽器,真正成為您的日常助理。

Chrome MCP 伺服器是一款基於 Chrome 擴充功能的模型上下文協定 (MCP) 伺服器,它將您的 Chrome 瀏覽器功能開放給 Claude 等 AI 助手,從而實現複雜的瀏覽器自動化、內容分析和語義搜尋。與傳統的瀏覽器自動化工具(例如 Playwright)不同,Chrome MCP 伺服器直接使用您日常使用的 Chrome 瀏覽器,利用現有的使用者習慣、配置和登入狀態,讓各種大型模型或聊天機器人控制您的瀏覽器,真正成為您的日常助理。

Playwright Can't Do This... But This MCP Can.

Categories: 開源, MCP, API, Python

TRAE 1.35 新版整合 MCP

Trae 令我放棄了 Cursor,放棄了 WindSurf,甚至 Cline 等等。因為它擁有更加直觀的操作介面,除了提供傳統的 IDE 功能,亦包括自動編寫代碼、項目管理、插件管理,同時,最新版本亦都直接整合了 MCP 同 MCP 市場。當然亦唔少得 AI Agent。

Trae 令我放棄了 Cursor,放棄了 WindSurf,甚至 Cline 等等。因為它擁有更加直觀的操作介面,除了提供傳統的 IDE 功能,亦包括自動編寫代碼、項目管理、插件管理,同時,最新版本亦都直接整合了 MCP 同 MCP 市場。當然亦唔少得 AI Agent。

📢Breaking News TRAE.AI Just Added GAME CHANGING Features!
Trae 大更新!免費 AI IDE 終於支援 MCP,自訂智能體、強大模型 (GPT-4.1/Claude 3.7) 全面進化!
Categories: MCP, Vibe Coding, 編程

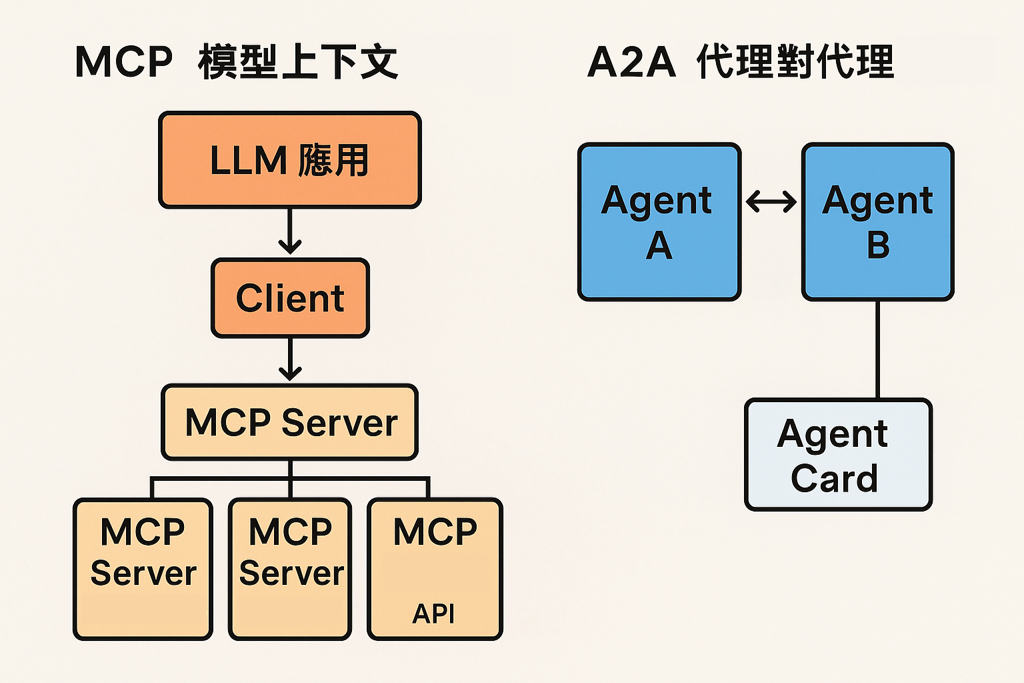
MCP vs A2A 技術比較

Categories: MCP

Page 5 of 6
1 … 3 4 5 6