OpenWorker – Andrew Ng 開發桌面 AI 龍蝦

OpenWorker 係一個開源嘅桌面 AI 同事,由 Andrew Ng 團隊開發,強調本地執行、帶自己嘅模型 API key,並且會產出真正嘅成品而唔止係聊天回覆。

How OpenWorker works

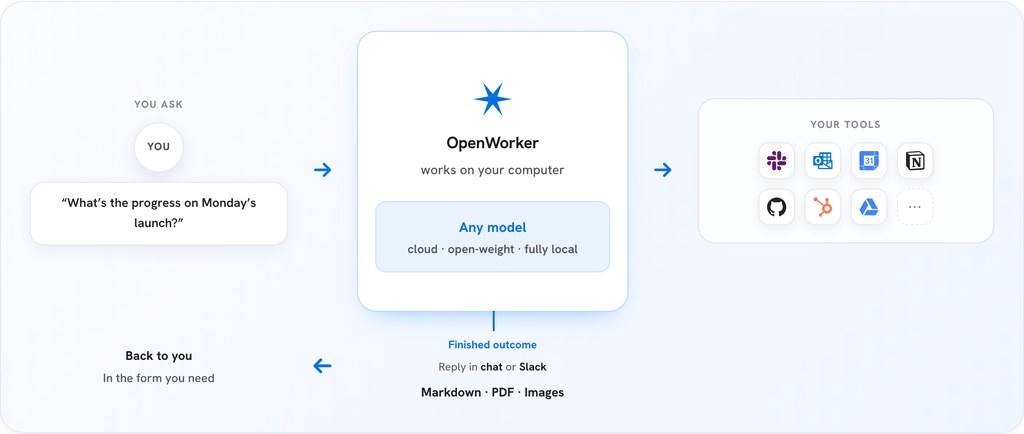
對好多打工仔嚟講,最大嘅困擾唔係 AI 唔夠聰明,而係佢只識得「答問題」而唔識得「做完件事」。OpenWorker 嘅切入點正正喺呢度:佢定位係一個會跑喺你電腦上面嘅 AI 同事,可以幫你整理 calendar、寫 follow-up email、甚至自動出一份 customer brief,最後畀你一份可以直接開嚟用嘅文件,唔係一串對話。

OpenWorker 由 Andrew Ng(吳恩達)相關團隊推出,引擎建基於佢哋自己開發嘅 Python 開源庫 aisuite,呢個庫提供統一嘅 chat-completions API 以及支援工具調用(tool calling)、MCP 等功能。簡單講,OpenWorker 唔係從零寫起嘅 wrapper,而係將 aisuite 包成一個真正面向桌面用戶嘅應用,並且喺原本 aisuite 倉庫入面開發咗一段時間之後,先搬出嚟獨立成 repo。

目前支援 macOS(Apple Silicon)以及 Windows 10/11,用家可以貼上自己嘅 API key 去用 OpenAI、Anthropic、Google Gemini、DeepSeek、Kimi、Qwen、Mistral 等模型,亦可以經 Ollama 完全本地跑開源模型。所有嘢都喺本機行,只有用家授權嘅 model call 或者連接工具先會接觸到網絡。對於注重私隱或者公司政策唔畀數據出 cloud 嘅人,呢個係一個幾實際嘅選擇。

OPENWORKER: The Free AI Desktop Agent That Isn't Locked to One Model

佢亦內建 25+ 個整合,包括 GitHub、Slack、Jira、Notion、Linear、HubSpot、Outlook、Gmail、Google Calendar 等,亦支援任何可以經 MCP(Model Context Protocol)接駁到嘅工具。最令筆者欣賞嘅係佢嘅審批機制:寫訊息、發送郵件、執行 shell 指令呢類「對外有影響」嘅動作,全部都要先經你確認先至會執行,唔會自己靜靜雞撳掣。

以下係幾個用家會比較關心嘅重點:

  • 定位係桌面 AI 同事,目標係交到「成品」而唔止係聊天回覆,例如 HTML brief、Markdown 報告、排好嘅 calendar 更新等。
  • 完全開源、MIT 授權,由 Andrew Ng 團隊開發,引擎建基於佢哋嘅 aisuite 開源庫。
  • 模型自選,支援多間主流 cloud provider,亦可以經 Ollama 完全本地執行開源模型。
  • 重視私隱,對話、token、API key 都儲喺本機 secret store,唔需要登入亦可以用。
  • MCP + 審批機制,所有對外動作(發訊息、執行指令)都會先問過你先做,減低「AI 自行撳掣」嘅風險。

如果你係一個人或者小型團隊,想搵一個可以幫你「跑手」而唔係淨係「傾偈」嘅 AI 工具,又唔想將公司敏感資料送去閉源服務,OpenWorker 算係一個值得試嘅選擇。佢而家仲喺 open beta,官方表示會自動更新、不斷執吓啲 bugs,畀用家提交 issue。適合想認真將 AI 融入日常工作流、對私隱同可控性有要求嘅人。

項目主頁 · GitHub

Categories: 開源, MCP, Qwen, Google, OpenAI, DeepSeek, Gemini, API, 工具, Mac, Ollama, Python, Anthropic, 蘋果, Kimi

Voicebox 本地語音克隆完整工作台

想喺自己部機完成語音克隆、朗讀同聽寫,Voicebox 幾乎把整條語音 I/O 流程收進同一個桌面項目。它吸引人的地方,不只係多模型,仲有本地私隱同跨平台部署。

Voicebox

把語音克隆、TTS、聽寫同 agent 語音互動放埋一個桌面介面,正正擊中不少內容創作、無障礙輸入同 AI 工作流嘅痛點。Voicebox 屬於本地優先嘅開源語音工具項目,重點唔係單做一種聲音生成,而係將完整 voice I/O stack 放到 Mac、Windows 同 Linux 上運行,令模型、錄音同聲音資料都留喺自己部機內。

它最有競爭力嘅地方,在於把雲端常見嘅兩段流程合併:一邊做語音輸出,一邊做全域聽寫,仲可以接到 MCP-aware AI agent。對比只做 TTS 或只做 dictation 嘅服務,Voicebox 提供嘅係一個較完整工作台;代價亦明顯,本地推理對硬件、模型管理同快取安排有一定要求,想追求最省心體驗,未必比純雲端方案輕鬆。

支援面向相當廣,內建 7 個 TTS engines,包括 Qwen3-TTS、Qwen CustomVoice、LuxTTS、Chatterbox Multilingual、Chatterbox Turbo、HumeAI TADA 同 Kokoro,亦提供 zero-shot cloning 同 50+ preset voices。23 種語言加上後製效果,例如 pitch shift、reverb、delay、chorus、compression 同 filters,令它唔止適合做旁白,對要快速試聲線、做角色語氣、整理語音筆記嘅小團隊同個人創作者都幾有用。

  • 本地執行係核心價值,私隱敏感內容唔使上傳雲端
  • 一個項目包辦 voice cloning、speech generation、dictation 同 agent 語音介面
  • 支援多個 TTS engines,同一段內容可按聲線、語氣同語言需要切換
  • Chatterbox Turbo 可處理 [laugh]、[sigh]、[gasp] 等 paralinguistic tags,Qwen CustomVoice 可用自然語言控制演繹方式

安裝方式以桌面應用為主,官方已提供下載、文件同 troubleshooting,理解上接近本地 AI studio,而唔係單一模型倉庫。現有資料未見統一基準分數或嚴格 benchmark,對聲音相似度、延遲同穩定性,仍要視乎你選用邊個 engine、樣本質素,同埋會唔會改用 local or remote inference;但作為把多語音模型、克隆流程同輸入輸出控制整合起來嘅開源項目,它已經比只提供單點功能嘅工具更接近可長期放入工作流。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, Agentic, MCP, Qwen, Clone, Mac, Linux, 語音

FunASR 工業級語音辨識:支援廣東話

想在本地架一個 OpenAI 相容嘅語音轉文字 API?ModelScope 嘅 FunASR 將 SenseVoice、Paraformer、Fun-ASR-Nano 等模型收喺同一個 Python 接口,仲支援 vLLM 加速同 MCP 接入 AI Agent。

Repository image for modelscope/FunASR

如果你做過語音相關項目,大概率遇過呢種情況:開源模型散落喺唔同倉庫、部署方式各異、要接入 Agent 仲要自己寫 WebSocket 中間層。FunASR 就係針對呢類工程痛點嘅工業級語音識別工具包,屬於開源框架,由阿里達摩院維護,提供統一 Python 接口,將 ASR、VAD、標點恢復、說話人分離、情感偵測同音訊事件辨識串成一條流水線。

旗艦模型 Fun-ASR-Nano 係基於 LLM 嘅解碼架構,覆蓋中、英、日三語以及中文方言群組;針對 31 種語言嘅場景可以用 Fun-ASR-MLT-Nano-2512;鍾意多語言又有 LLM 解碼能力嘅,亦有 Qwen3-ASR(52 種語言、0.6B/1.7B 參數)。如果想要更輕量、非自迴歸嘅選擇,Paraformer 同 SenseVoice 仍係穩陣起點,前者適合生產線串流,後者額外送情感同音訊事件標籤。

funasr-server 一行指令就可以拉起 OpenAI 相容嘅轉寫 API,本地聽返 localhost:8000,配合 vLLM 仲可以做到 2-3 倍 LLM 解碼加速同 tensor parallel 批次推理。Agent 整合係另一個重點:MCP Server 可以直接接入 Claude 或 Cursor,OpenAI API 接口又同 LangChain、Dify、AutoGen 無縫對齊。最近幾個版本(v1.3.18 至 v1.3.22)就專門執緊 SRT/字幕分段、長時 WebSocket 連線、verbose_json 回傳呢啲工程細節。

要留意嘅取捨係:Fun-ASR-Nano 需要 GPU;新環境第一次 import funasr 已唔再強行依賴 PyTorch,但用 AutoModel 仍然要先裝 torch。FunASR 比較適合需要私有語音 API、字幕生成、長會議轉寫、或想將語音能力塞入 Agent 工作流嘅團隊開發者。

重點摘要:

  • 統一 Python 接口整合 ASR、VAD、標點、說話人分離、情感偵測
  • Fun-ASR-Nano 旗艦模型支援 31 種語言及中文方言,Fun-ASR-MLT-Nano 覆蓋更廣
  • funasr-server 提供 OpenAI 相容 API,搭配 vLLM 可達 2-3 倍加速
  • 內建 MCP Server 支援 Claude/Cursor,亦可接入 LangChain、Dify、AutoGen
  • 近期版本持續優化字幕分段、WebSocket 長連線、verbose_json 回傳等工程細節

以下是其對粵語支持的詳細信息:

  • UniASR模型:這是一個專為粵語設計的語音識別模型,能夠處理簡體中文的粵語語音識別任務。
  • ITN模型:用於對粵語語音識別結果進行擬文本正則化後處理,以提高識別結果的準確性。
  • VAD模型:語音端點檢查模型,用於檢測長語音片段中有效語音的起止時間點,這對於粵語方言的語音識別同樣重要。
  • 訓練語料:為了提高模型的準確性和適用性,通常會使用大量的粵語語料進行訓練,以便模型能夠更好地理解和識別粵語中的特有詞彙和表達方式。
  • 離線功能:Funasr提供了離線語音識別模型,這意味著即使在沒有網絡連接的情況下,也能夠進行粵語語音識別。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, Qwen, NVIDIA, API, IDE, LangChain, Python, 語音, Dataset 數據集

Grok Build 開源後,編碼代理點樣運作一目了然

想知道 AI 編碼代理點樣讀上下文、調工具同改碼,Grok Build 而家可以直接睇原始碼。它更吸引的地方,是連本地推理流程都可自行接駁。

Og image

想追到 AI 編碼代理點樣一步步理解程式碼、決定用咩工具,再把結果送回終端,Grok Build 而家提供了一個相當直接的入口。這個由 SpaceXAI 公開的 coding agent 與 TUI,不只方便試用,還把整個運作骨架開源,重點是讓人真正查清楚代理在處理什麼、又可以改到什麼。

對開發者而言,價值不止在「可用」,而是在「可驗證」。你可以直接查看它怎樣組裝 context、解析模型回應、分派 tool calls,也可以理解它怎樣讀寫程式碼、搜尋內容與執行指令。做緊技能擴充、插件整合,或者研究 MCP servers、subagents 工作流的人,這份原始碼會比單靠文件更有參考價值。

  • 開源範圍涵蓋 agent loop、tools、terminal UI 與 extension system
  • 可研究 skills、plugins、hooks、MCP servers、subagents 的載入與呼叫方式
  • 支援 local-first 用法,可自行編譯並接上本地 inference
  • 主要透過 config.toml 控制整體執行流程

和常見只提供託管服務或有限介面的工具相比,Grok Build 把關鍵細節直接攤開。使用時不一定要綁定雲端環境,亦可以自己編譯、指向本地推理後端,令測試、除錯、客製化與安全審視都有更大空間;代價是你要自己處理部署與整合,門檻自然較高。

對需要打造自訂 coding agent、終端工作流,或研究代理工具調度方式的人來說,這次開源相當有參考價值。

項目主頁

Categories: 開源, Agentic, MCP, API, Vibe Coding, 編程, 安全, Skill 技能

Qwen3.6 全新的動態 NVFP4 量化器

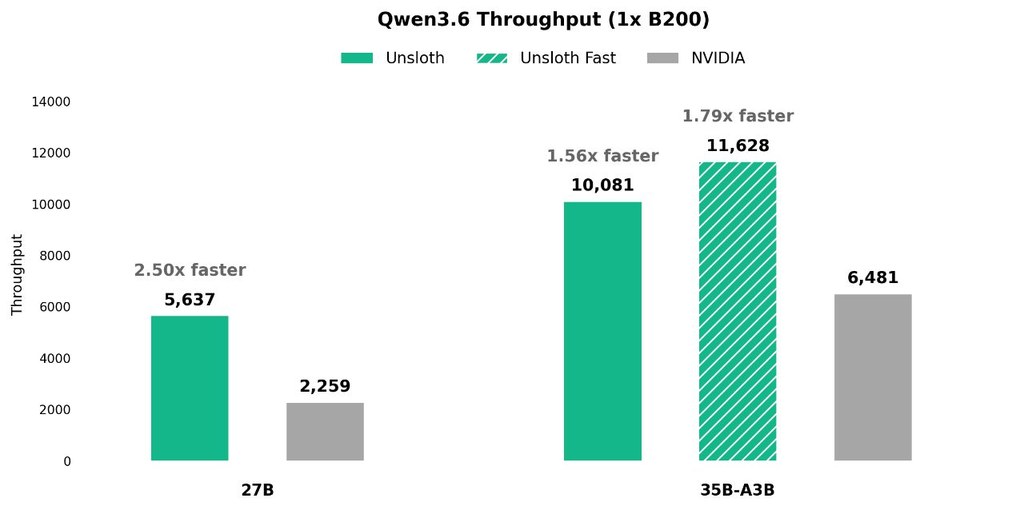
運行速度比其他 NVFP4 量化器快約 2.5 倍,效能更佳,檔案大小也相近。在24GB 記憶體上,Qwen3.6-27B NVFP4 的運行速度提升 2.5 倍;在32GB 顯存上,Qwen3.6-35B-A3B 的運行速度提升 1.7 倍。

Og image

想喺自己電腦上跑到規模較大的多模態模型,最大卡位通常唔係功能,而係記憶體同速度。Qwen3.6 屬於阿里巴巴的新一代多模態 hybrid-thinking 模型系列,重點在於用相對可控的硬件需求,處理 agentic coding、vision 同 chat 等工作。

現有資料提到兩個主力型號:Qwen3.6-27B 同 35B-A3B。前者可在約 18GB 記憶體配置下運行,後者約需 22GB 至 23GB 左右,並支援 256K context 及 201 種語言。對想喺本地做長內容理解、跨語言對話,或者配合工具調用工作流的人來說,這個取向幾實用。

相比只講「可量化、可本地跑」的常見做法,Unsloth 這邊更著重點樣揀到速度與準確度較平衡的版本。Qwen3.6 GGUFs 採用 Unsloth Dynamic 2.0,會按真實使用資料做 calibration,並把重要 layers upcast;另外新推出的 NVFP4 quants 主打在 GPU 上帶來約 2.5 倍更快速度,MTP 則標示可把 inference 再加快 1.4 至 2.2 倍,同時不犧牲準確度。

  • 適合本地部署多模態模型,兼顧編碼、視覺與對話
  • 27B、35B-A3B 記憶體需求相對克制,較易在個人設備起步
  • GGUF 格式配合 Unsloth Dynamic 2.0,重點是量化後仍保持可用表現
  • NVFP4 與 MTP 主要改善推理速度,幫助減少等待時間

使用上仍有幾點要留意:總可用記憶體最好高於下載的量化模型大小,否則雖然可經 llama.cpp 用 SSD/HDD offloading 繼續運行,但推理會慢得多;文件亦明確提醒不要使用 CUDA 13.2,以免輸出異常。整體來看,這不是單純把 Qwen3.6 搬到本地,而是把「跑得動、跑得快、精度仍可接受」這幾個取捨整理得更清楚。

所引用的模型列表:Qwen3.6-27B、Qwen3.6-35B-A3B。

項目主頁 · 模型

Categories: 開源, 阿里巴巴, Agentic, MCP, 模型, 多模態模型, Qwen, NVIDIA, API, 教學, Medical醫學, Python, 編程, OpenClaw, Anthropic

open-design:本地優先的開源設計工具

open-design 是一款本地優先的桌面應用,讓 AI 編碼代理直接生成設計稿、頁面與多媒體內容。

Og image

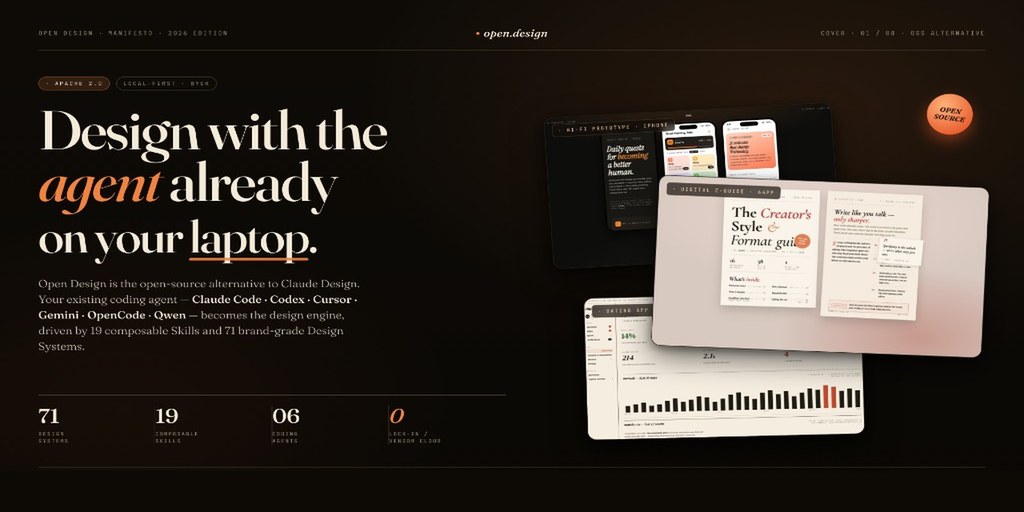
open-design 是一款本地優先(local-first)的開源桌面應用程式,主打讓 AI 編碼代理(coding agent)直接充當設計引擎,協助用戶快速產出原型設計(prototypes)、登陸頁面(landing pages)、儀表板(dashboards)、投影片、圖片甚至影片等各種多媒體素材,並輸出真實可用的檔案。這個項目的定位是 Claude Design 的開源替代方案,強調在桌面環境中本地執行,無需依賴雲端服務即可完成設計工作。

與傳統的設計工具相比,open-design 的最大差異在於將 AI 編碼代理作為核心驅動力,用戶可以透過自然語言指令讓代理直接生成設計內容,省去手動拖拽元件的繁瑣流程。從 GitHub 上的數據可見,該項目已獲得超過 7.5 萬顆星及 8 千多次 fork,社群關注度相當高,顯示開源社群對本地化 AI 設計工具的強烈需求。

這個項目最適合需要快速產出網頁原型或行銷素材的開發者、設計師及內容創作者。對於重視資料隱私、希望在本地環境完成設計工作的人來說,local-first 的架構尤為吸引。開發者亦可將其整合到現有的編碼工作流中,讓 AI 代理同時負責程式碼與設計兩個層面。

以下是這個項目的重點摘要:

  • 屬於本地優先的開源桌面應用,定位為 Claude Design 的替代方案
  • 核心功能是讓 AI 編碼代理生成設計稿、頁面、儀表板及多媒體內容
  • 強調本地執行,無需依賴雲端服務,保障資料私隱
  • 適用於開發者、設計師及內容創作者快速產出原型與行銷素材
  • 社群關注度高,GitHub 上已累積超過 7.5 萬顆星

由於該項目仍處於活躍開發階段,功能成熟度與跨平台支援等細節尚未完全明朗,建議有興趣的使用者持續關注其更新進度。

項目主頁

以下是該網頁主要內容(麻省理工學院電子工程與計算機科學系 MIT EECS 的訪談文章)的繁體中文翻譯:

(more…)
Categories: 開源, Agentic, MCP, Vibe Coding, 編程, 安全, Skill 技能


Google A2UI 想讓 AI Agent 直接講出介面

A2UI 不是聊天模型,而是一套讓 AI agent 產生互動介面的開源格式與函式庫。它主打安全、可跨平台渲染,適合要把 agent 接入產品的人。

Gallery of A2UI components

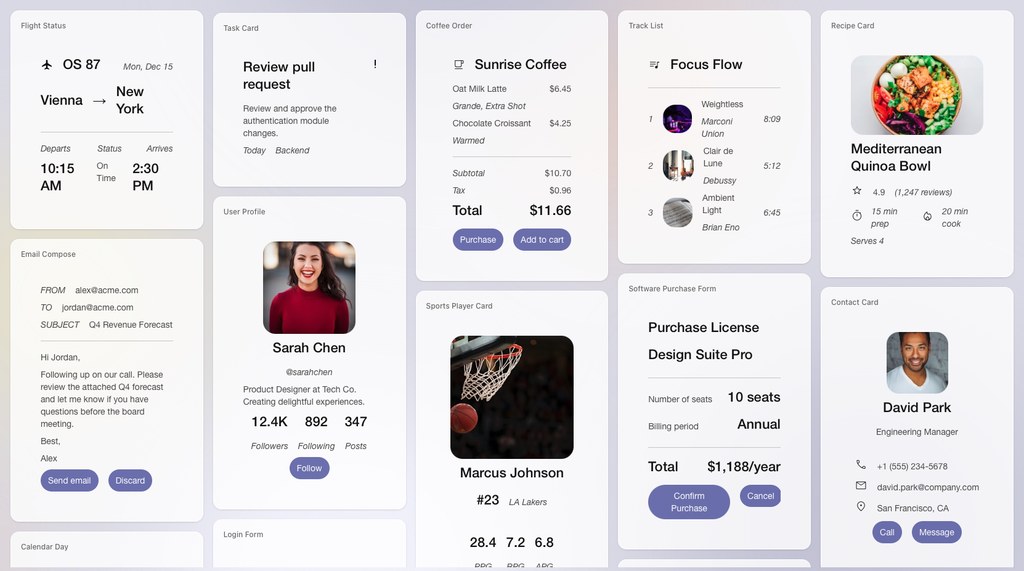
A2UI 是一個開源框架/協定格式項目,核心是讓 AI agent 用宣告式 JSON 產生可更新的互動介面。它要解決的問題很直接:agent 不只回文字,還可以安全地把表單、卡片、按鈕等 UI 交畀前端或原生客戶端渲染。

這個項目的取向,和直接讓 LLM 輸出 HTML、JavaScript,或者在前端執行 agent 生成程式碼很不同。A2UI 把介面描述同實際元件庫分開,client 只會渲染已預先信任的元件 catalog,安全性較高,但代價是自由度受 catalog 和 renderer 能力限制,並非想畫甚麼介面都可以即時做到。

現有資料顯示,A2UI 仍屬 early stage public preview,目前生產版本為 v0.9.1,v1.0 specification 則是 release candidate。部署與理解方式上,它較像一個要接入現有產品的基礎層:agent 端輸出 A2UI JSON,client 端用對應 renderer 轉成 Flutter、Angular、Lit、Web 或其他原生 UI;官方網站有 Quickstart、Client Setup、Agent Development 同 renderer 文件,但這份資料未列出完整安裝流程,亦看不到一鍵接入 OpenClaw、OpenCode、Codex、Hermes Agent、Copilot、Pi 的管理介面整合資訊。

它的優勢,在於增量更新和跨框架可攜性。README 提到 UI 會以扁平元件清單加 ID 關聯表示,這種結構對 LLM 較友善,也方便串流更新;同一份 A2UI payload 理論上可以映射到不同客戶端。相比綁死某一個前端框架的做法,這更適合多端產品、內部工具平台,或者需要跨信任邊界把 agent 能力交到用戶手上的團隊。

重點可概括為:
– 不是模型,而是讓 agent「講 UI」的協定與函式庫
– 核心賣點是安全渲染,避免直接執行 LLM 生成程式碼
– 支援增量更新,較適合串流式互動介面
– 可對接多種前端技術,但前提是要先有 renderer 和元件 catalog
– 文件已見版本演進與示範場景,公開資料未提供明確性能跑分

性能與現有內容較著重設計理念、版本演進與示範,而不是基準測試數字,所以不宜把它理解成追求速度排行榜的項目。較可能受益的是正在做 agent 產品的前端團隊、平台工程團隊,以及需要把資料收集、任務委派、跨端 UI 呈現整合起來的企業應用;相關技術脈絡則包括 AI agents、MCP、Flutter、Angular、Lit、React、SwiftUI,以及 A2A extension。

項目主頁 · GitHub

Categories: 開源, Agentic, MCP, Google, 框架, OpenClaw

拆解 AI Agent Loop 核心運作

用最簡單控制流程,講清 AI Agent 點樣反覆調用模型與工具。

Og image

這是一段介紹 AI Agent 底層控制流程的教學影片。它主要用來解釋主流 Agent 為何能連續思考、調用工具並完成任務,核心其實是一個簡化版 while 迴圈。

內容重點不是堆砌框架名詞,而是把 Agent Loop 拆成幾個基本步驟:先問模型、按模型要求執行工具、把結果回填,再繼續詢問模型,直到模型不再要求工具。這種講法有助非技術讀者理解,很多看似複雜的 AI Agent,底層控制流未必複雜。

它要處理的問題,是怎樣讓語言模型由一次性回答,變成可逐步執行任務的系統。相比只靠單輪提示詞的做法,Agent Loop 多了狀態延續、工具調用與停止條件,因此更適合查資料、操作 API、分步完成工作等情境。

  • 核心概念:Agent Loop 可視為模型與工具之間的反覆回合
  • 主要流程:模型決定下一步,系統執行工具,再把結果交回模型
  • 關鍵價值:把複雜 Agent 拆成可理解、可實作的最小控制單位
  • 適用情境:想學 AI Agent、工具調用、任務自動化流程的人最受用

這類內容特別適合剛接觸 Agentic 系統、MCP、工具代理或自動化工作流的讀者,也適合寫程式的人建立正確心智模型。單靠目前提供的資料,未見具體效能數字、基準測試或完整程式實作細節,因此較適合視為概念導讀,而不是完整技術文件。

項目主頁

Categories: Agentic, MCP, Google, API, 框架, 安全

Headroom:幫 AI agent 壓縮上下文

這個項目專注減少 AI agent 的 token 消耗,同時盡量保留答案品質。它適合想降低成本、加快回應的開發團隊。

Headroom in action

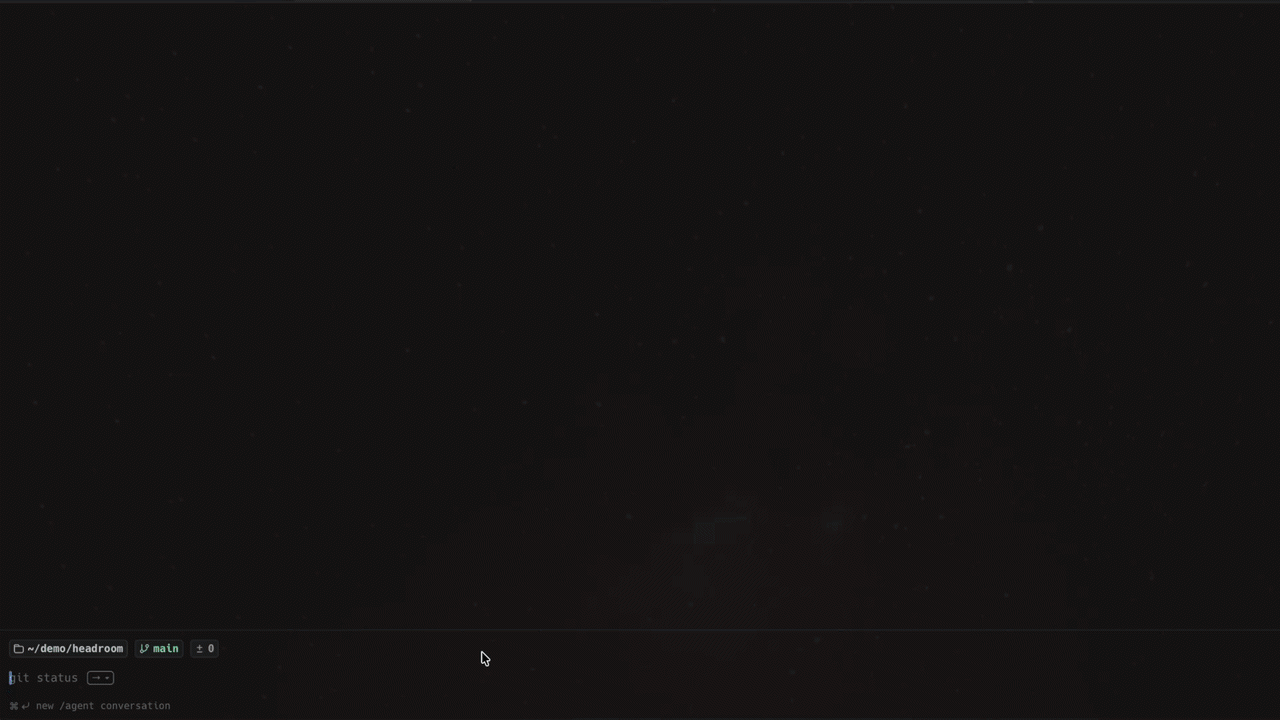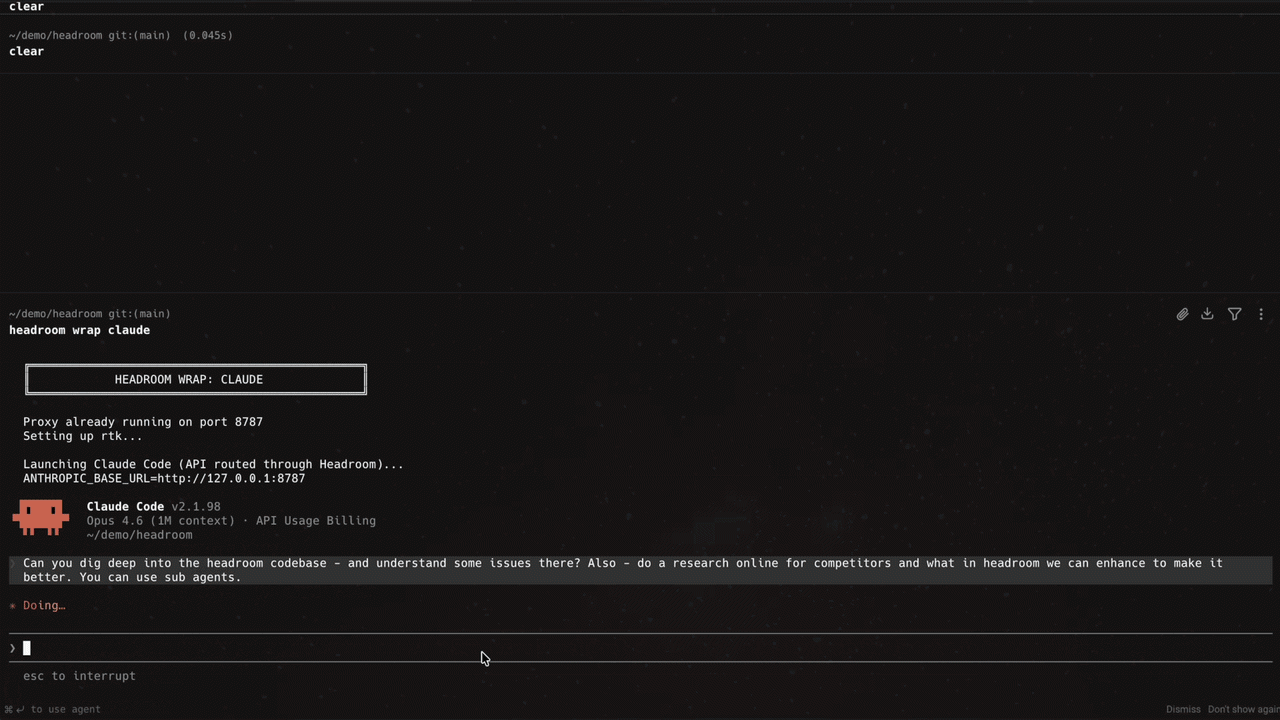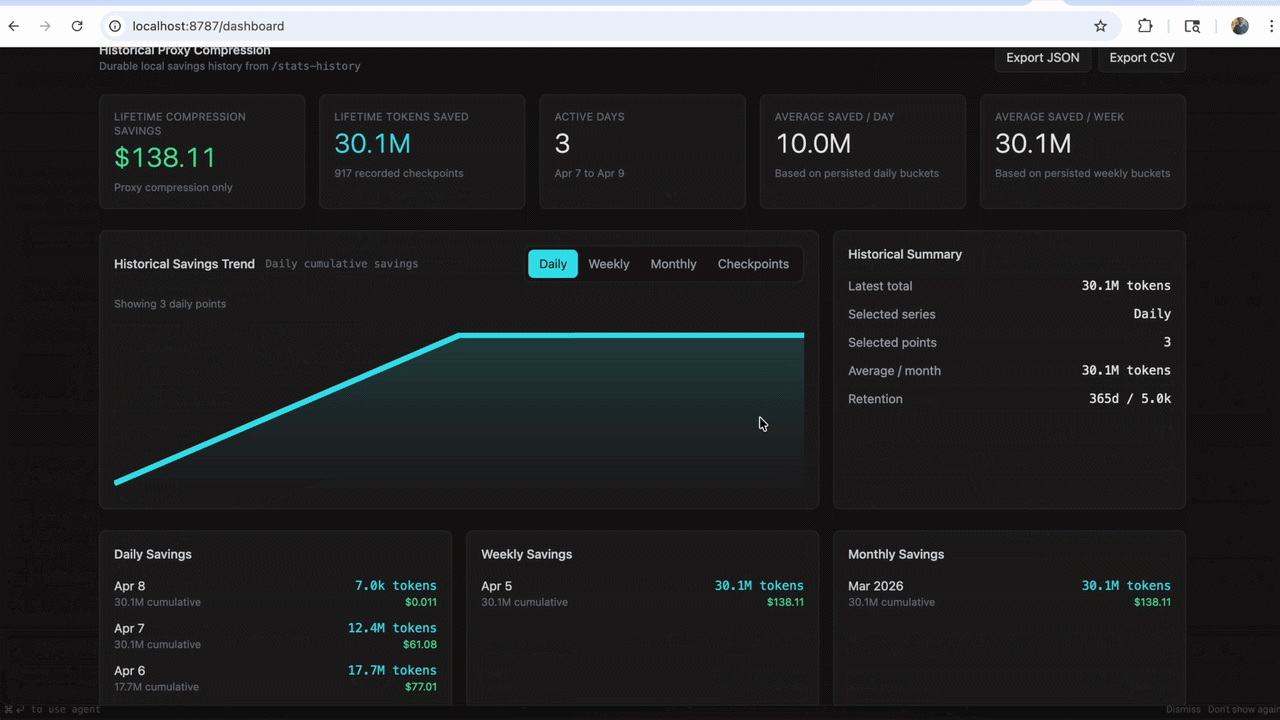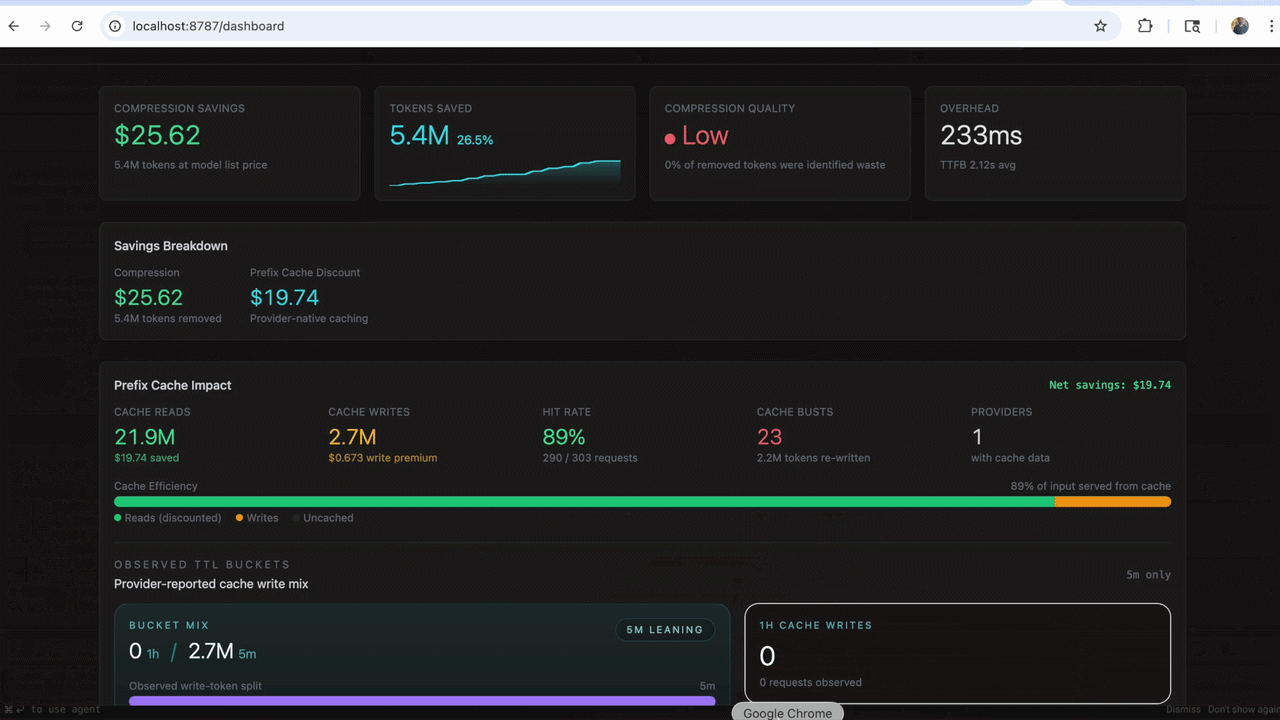
Headroom 是一個給 AI agents 與 LLM 應用使用的庫兼代理工具,核心角色是把送進模型前的上下文做壓縮。它主要解決長對話、工具輸出、日誌、RAG 片段與檔案內容太長,令 token 成本、延遲與上下文容量很快爆滿的問題。

這個項目不只提供 Python 與 TypeScript 內嵌式 compress(messages) 用法,亦提供 proxy 模式與 MCP server,代表它可以直接插入現有流程,未必需要大改程式。README 提到 zero code changes 的代理方式,對已有多語言系統的團隊尤其實用;另外它走 local-first 與 reversible 路線,取向明顯是先保留可控性,再追求節省 token。

和一般只縮短輸入文字的做法相比,Headroom 的差異在於它同時處理模型輸出,會減少重複客套、重述程式碼,以及在例行步驟略過過深的「thinking」。這種取捨有助壓低來回 token,但也代表較依賴它對內容重要性的判斷;對需要完整推理痕跡或逐字保留輸出的流程,部署前應先做回歸測試。

結果列出的數字是 60–95% fewer tokens,示例亦有 10,144 壓到 1,260 tokens,同時保留相同問題結論;不過這些結果較適合視為官方展示,具體效果仍會受任務類型影響。較容易受益的情境包括多步驟 agent、跨工具調用、RAG 對話系統,以及 Claude、Codex、Gemini 之間需要共享記憶的團隊協作流程。

  • 支援 Library、Proxy、MCP server 三種接入方式
  • 可壓縮對話、工具輸出、logs、RAG chunks 與檔案內容
  • 提供 cross-agent memory,支援 Claude、Codex、Gemini 共用與去重
  • headroom learn 會整理失敗 session,寫入 CLAUDE.local.md、CLAUDE.md、AGENTS.md 或 GEMINI.md
  • 相關模型包括 Kompress-v2-base,而整體定位較接近 agent 基礎設施,不是單一聊天模型

整體來看,Headroom 最有價值的地方不在於再做一個包裝 LLM 的介面,而是把「上下文壓縮」獨立成基礎層。對經常被 token 成本、上下文長度與 agent 記憶雜訊拖慢的項目,它屬於值得優先測試的一類工具。

GitHub

Categories: 開源, Agentic, RAG, MCP, 模型, Gemini, Python, 庫, 編程, Anthropic

Page 4 of 6
1 2 3 4 5 6