3D HAMSTER 把機械臂規劃帶進真 3D

同樣是看圖加文字指令,3D HAMSTER唔再只畫2D路線,而是直接交出可落地的3D機械臂軌跡。對機械操作流程來講,呢個改動細節不多,影響卻很實際。

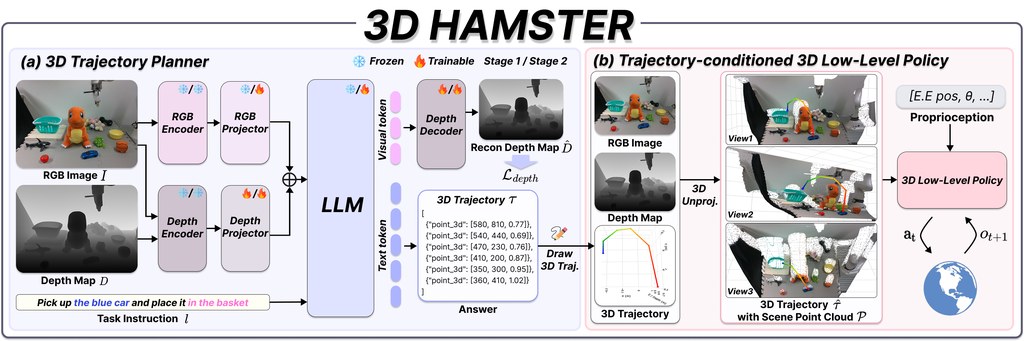
3D HAMSTER architecture: a depth-augmented VLM planner produces metric 3D waypoints that unproject into the point cloud

機械臂最怕規劃講得通,落到控制層卻對唔準空間位置。3D HAMSTER屬於 Vision-Language-Action 規劃模型/機械人研究項目,重點不是再產生螢幕上的 2D waypoint,而是根據單張 RGB 圖、metric depth map 同文字指令,直接輸出帶有深度的 3D end-effector trajectory,同時附上 gripper actions,格式亦整理成 JSON,方便接去後續控制流程。

它針對的矛盾很明確:不少 hierarchical Vision-Language-Action models 由高層 planner 先預測 2D 像素軌跡,再交給吃 point cloud 的低層 policy 執行。問題在於 2D waypoint 只會「借用」像素下方表面的深度,幾何上未必真是機械臂應走的位置。3D HAMSTER改成在 metric 3D 空間規劃,等高層輸出可以直接對接 point-cloud low-level policy,少了中間 2D 轉 3D 的失真。

模型骨幹用的是 Qwen3-VL-8B,再加上凍結的 LingBot-Depth geometry encoder,當中採用 DINOv2 ViT-L/14,並配合 dense depth-reconstruction objective 去強化深度感知。儲存庫目前提供的是 inference-only 版本,即是你可以安裝套件、下載 checkpoint 後直接跑推理或用 Gradio demo 測試;低層 point-cloud policy 屬於論文完整系統一部分,這個 GitHub 項目未有一併放出。

  • 直接輸出 [u, v, depth] waypoint,深度單位是米,較易接入真實機械臂流程
  • 走 RGB-D + language instruction 路線,不靠多視角觀察
  • checkpoint 已包含 geometry encoder 權重,載入時毋須再額外抓模型
  • 項目偏向展示 planner 能力,不等於完整可部署的機械人控制堆疊

,它的定位很適合做研究驗證、機械操作規劃比較,或者拿來觀察 2D planner 與 3D planner 在幾何一致性上的差異。作者在項目頁面強調這種做法對語言、空間與視覺分佈轉移更穩健,但這個儲存庫未有完整公開訓練流程與低層控制模組,所以較適合把它理解為一個清楚展示方向的 3D-native planner,而不是即裝即用的全套機械人方案。
項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, Qwen, Gemini, VLA, Robotic, 3D, Dataset 數據集

MuseBench 用藝術理解考驗 MLLMs

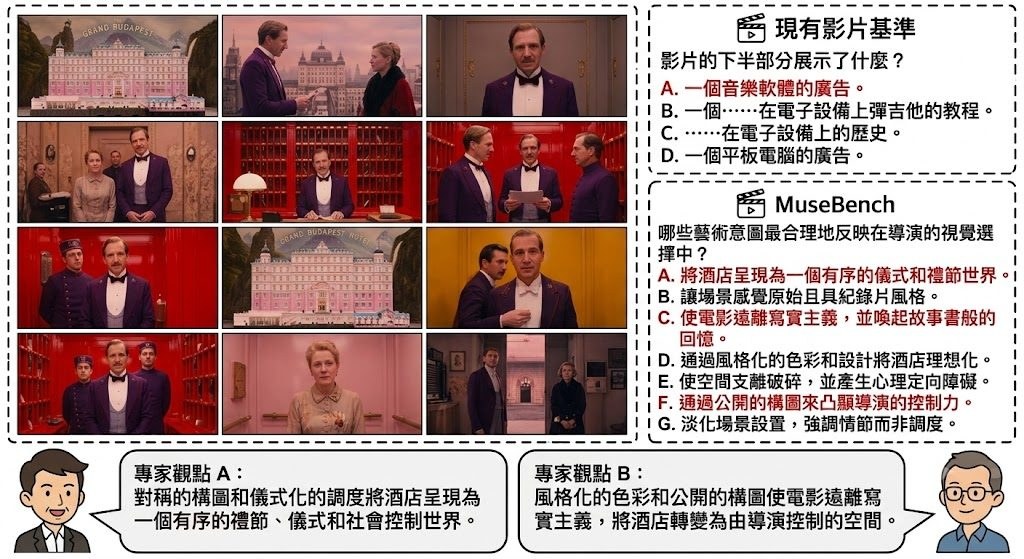
MuseBench唔係測模型見到咩,而係追問點解作品要咁表達。呢套 benchmark 把多模態理解拉到藝術語境,難度明顯高過一般視聽問答。

Repository image for musebench/musebench-code

見到畫面、聽到聲音,未必等於真係明白作品想點講。MuseBench 把焦點放到 artistic intent,專門測 multimodal large language models(MLLMs)能否由視聽證據推斷創作選擇背後的意思;它屬於 benchmark/數據集型項目,處理的是現有評測多數只停留在 perceptual recognition,未能反映藝術理解深度的問題。

現有做法常用一般視覺問答或影片理解題,模型只要辨認物件、情節或表面事件就有機會得分;作者認為這種 fixed paradigm 忽略 stylistic vocabulary、cultural priors 同 grounded audiovisual inference,所以改用 narrator-removed video clip,並配合可選 audio transcript,迫使模型直接由鏡頭、聲音、節奏與敘事線索作判斷。題目覆蓋 Cinematic Arts、Static Visual Arts、Stage Performing Arts 同 Game Arts,合共 4,016 條問答。

同類 benchmark 多數著重「睇到乜」,MuseBench 則更在意「點解要咁呈現」。它亦唔只用單一選擇題,仲有 single-select 同 multi-select 兩種格式,並加入 Chance-Adjusted Accuracy(CAA)處理選項數量不同帶來的偏差,令比較 28 個 MLLMs 時較公平。

  • 涵蓋 4 個藝術領域、11 個細分類,題材比一般影片 QA 更闊
  • 評測 28 個 MLLMs,包含 proprietary、open source 同 video-specific 路線
  • 最佳模型準確率 48.29%,明顯低於 human expert 的 87.18%
  • 已整合 VLMEvalKit,方便把新模型接入同一套流程測試

部署同測試理解上,這個 code repository 主要唔係提供訓練模型,而是把 MuseBench 接到 VLMEvalKit 的評測流程,較適合研究團隊、模型評估人員、做 video understanding 或多模態推理的項目直接比較新舊模型。已公開的結果提到 Claude-4.6-Opus、Qwen-3.5-Plus、Doubao-Seed、GPT-5.4、Gemini-3.1-Pro、Grok-4.1 等都測過,分數整體仍與專家有大段距離;換句話說,這個項目最有價值的地方,在於它清楚指出現時 MLLMs 在藝術判讀仍未算接近可靠。

項目主頁 · GitHub · Paper

Categories: 開源, 香港大學, 字節跳動, 多模態模型, Qwen, OpenAI, Gemini, Video, Audio, 香港, Anthropic, Dataset 數據集

MIRA 把《Rocket League》變成可互動世界模型

MIRA 唔係單純重播比賽片段,而係讓四名玩家動作一齊驅動畫面生成。你可以把它理解成一個能即時模擬 2v2 對戰走勢的世界模型研究項目。

Repository image for mira-wm/mira

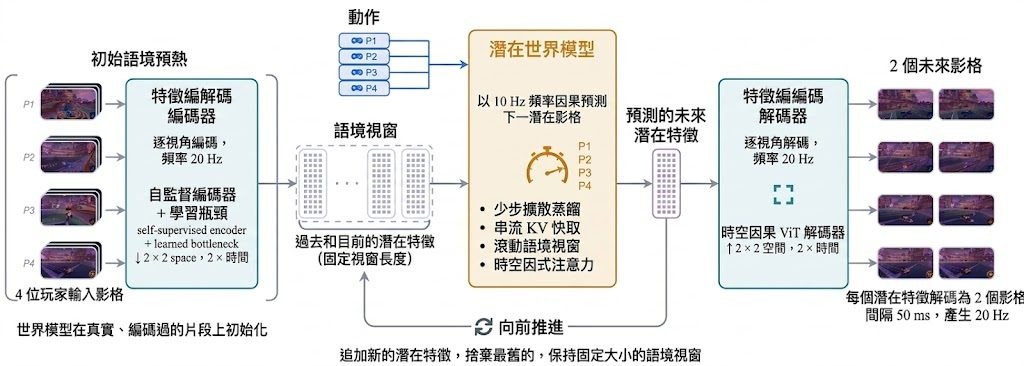
打機畫面一路變化,背後又有四名玩家同時輸入動作,呢類情境一向好難靠 world model 穩定重建。MIRA 屬於開源框架兼研究型模型項目,處理的是多人互動環境中,如何按四條 action streams 即時生成《Rocket League》對戰畫面,令 2v2 比賽可以直接在模型內運行。

現有做法多數集中在 single-player world models,其他角色通常只被當成環境一部分;作者明確反對呢種 fixed framing,因為多人場景入面,畫面變化要分得清楚邊個玩家造成。MIRA 改用 multiplayer conditioning,並配合 Representation Autoencoders 同 latent diffusion,目標唔只係畫面似真,而係令物理互動、攻守切換同多角色行為保持連貫。

個項目的取向相當鮮明:它唔係先追求最輕量部署,而係用 5B parameters 模型換取即時互動與長時間 rollout 穩定性。資料來自 10,000 小時 gameplay,README 亦公開了 RocketScienceDataset,當中每個 sample 都包含四個同步視角、逐格 keyboard action 同 game state,對做世界模型、VLA 或互動模擬研究的團隊都很有參考價值。

  • 屬於開源框架加世界模型研究項目,重點是部署、資料使用與評估多人互動生成
  • 與單人 world model 最大分別,在於同時按四名玩家動作生成畫面,而唔係把其他玩家當背景擾動
  • 官方指出模型可在單張 NVIDIA B200 GPU 上以 20 FPS 生成完整 2v2 對戰
  • 相關資料集 rocket-science 提供同步視角、動作與 game state,方便重做測試與分析
  • README 提供 pixi 環境安裝與 test suite 入口,但更完整部署細節仍要靠原始程式與技術報告配合理解

就公開結果看,MIRA 最有說服力的地方唔係單一 benchmark 數字,而係它把「多人動作歸因」變成核心問題,再補上對物理理解的 targeted evaluations。官方亦表示,雖然模型只用短片段訓練,distributional quality 可維持到五分鐘量測範圍,實驗中甚至能持續更長時間;不過硬件門檻高,定位更接近前沿研究平台,而唔係一般人可隨手在本地執行的輕量工具。

項目主頁 · GitHub · Paper

Categories: 開源, 世界模型, NVIDIA, Gemini, VLA, Dataset 數據集

LLM-as-a-Verifier 點樣重寫代理評分

當代理唔只要答得啱,仲要一步步做得穩,粗略打分已經唔夠。LLM-as-a-Verifier把評估拆細,令挑選、追蹤同訓練都更有依據。

LLM-as-a-Verifier

代理系統最常見的瓶頸,唔係生成唔到答案,而係你難以知道它每一步到底做得幾好。LLM-as-a-Verifier屬於開源框架,針對的正是呢個問題:它唔只為最終結果打一次分,而係用更細緻的方式為候選答案、行動步驟同任務準則提供可量化回饋。

現有做法不少仍然依賴單次判斷、粗粒度分數,或者只看最終成敗;作者認為呢種固定範式會忽略不確定性,亦難以支援 progress tracking 同 reinforcement learning。LLM-as-a-Verifier改用三個核心設計重組驗證流程:score granularity、repeated evaluation 同 criteria decomposition,並且直接對 LLM score tokens 的完整 logprob distribution 取期望值,而唔係只取單一輸出。

呢個取向令它同一般 judge-style 評分器有明顯分野。它重點唔在於產生一句評語,而係產生可反覆比較、可分解、可累積的 fine-grained feedback,所以可以用於 Best-of-N selection、pairwise compare,同埋逐步追蹤代理行為變化。README 亦展示了 Python 套件 llm-verifier 的基本用法;安裝方式有提供,但更完整的部署細節主要放在官方文件,而某些流程亦需要 VERTEX_API_KEY 或可回傳 logprobs 的 OpenAI-compatible server。

  • 支援任何 modality 的驗證框架,定位比單一 benchmark judge 更廣
  • 方法核心是細粒度評分、重複驗證、按 criteria 拆解準則
  • 可直接用於 selection、compare、track,同時連到 reinforcement learning
  • 官方列出 Terminal-Bench V2、SWE-Bench Verified、MedAgentBench、RoboRewardBench 等結果
  • 相關模型與服務包括 Qwen/Qwen3.5-9B、Qwen3-8B、Gemini 2.5 Pro,以及 OpenAI-compatible server

表現上,項目聲稱在多個 agentic benchmarks 達到 state-of-the-art,包括 Terminal-Bench V2 86.5%、SWE-Bench Verified 78.2%、RoboRewardBench 87.4%、MedAgentBench 73.3%,亦提到在 LIBERO 配合 SAC 微調 pi 0 policy 時,sample efficiency 約高 1.8 倍。呢類數字反映它較適合研究團隊、代理平台開發者,同埋想將評估訊號接入訓練迴路的人;單純只想要一個最終分數的團隊,未必需要用到它整套驗證尺度。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Qwen, NVIDIA, OpenAI, Gemini, Medical醫學, Python, Anthropic, Dataset 數據集

TasteGap:量度人類與 LLM 的 Research Taste

這是一套研究構思評測工具,用來比較人類與 LLM 想法分佈有幾唔同。它唔係只看新穎度,而是追蹤研究口味偏向。

Repository image for ziyuuc/TasteGap

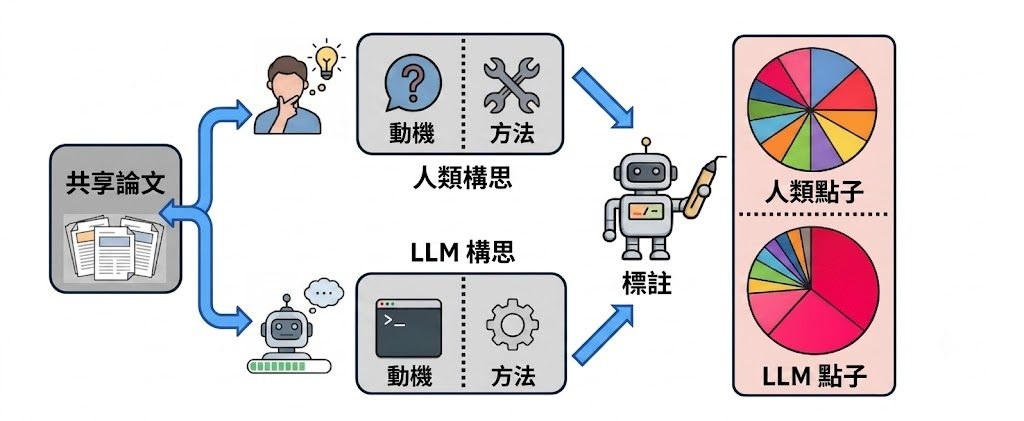
TasteGap 是一個研究評測工具與研究原型,核心工作是比較人類研究者與 Large Language Models(LLMs)生成研究構思之間的差距。它並非處理單篇提案好唔好,而是同一批文獻背景下,人類與模型會傾向提出邊類動機、邊類方法,從而量度所謂 research taste。

現有做法多數用 novelty、feasibility 或專家偏好去評分單個 idea,作者認為呢種固定範式只能判斷「像不像好主意」,但未必見到分佈偏差。TasteGap 改用 shared literature context:先從高質論文反推一組可能啟發該論文的 related works,再要求 LLM 從相同材料生成新 idea,之後用 two-axis research-taste taxonomy,分別標註 motivation 同 method,對比 human ideas 與 LLM ideas 的整體分佈。

GitHub 儲存庫目前提供 evaluation code,而唔係完整訓練框架。安裝理解上相當直接:準備 Python 依賴、設定 config.json 內的 generation 與 labeling 模型、填入 OpenAI 或兼容 API 端點,再用 JSONL 輸入跑 generate_ideas.py 同 label_research_taste.py;要重現完整資料,則需另外下載 Hugging Face 上的 IdeaSeed。輸入記錄包含 paper title、URL、domain、related works,以及人類參考 proposal 的 motivation 同 method,代表這個項目設計重點是可重跑比較,而唔係單次展示結果。

作者提出的主要判斷幾清楚:不同 LLM 生成的 idea sets 都出現一致 distributional gap。LLM ideas 較集中在 bridge-like opportunities 同 synthesis methods,人類論文參考分佈就覆蓋更廣,表示模型可以提出合理點子,但研究取向仍然較窄,亦有系統性偏移。

  • 不是一般 brainstorming 工具,而是用來量度 ideation 分佈差異的評測項目
  • 保留 human ideation 與 LLM ideation 在相同文獻脈絡下的可比較性
  • 研究口味以 motivation 與 method 兩條軸線標註,分析角度比單純打分更細
  • GitHub 內容偏向生成與標註流程,完整資料需配合 IdeaSeed dataset
  • 適合做 AI for science、LLM ideation、科研流程研究的團隊作內部基準

TasteGap 沒有綁定相關模型,只要求在 generation 與 labeling 填入可用模型,並支援 OpenAI-compatible endpoint。這種設計方便團隊橫向比較不同 LLM,但現階段儲存庫未提供完整效能表或基準腳本整理頁,因此不算是交付即用型產品。

GitHub · Paper

Categories: 開源, 模型, OpenAI, Gemini, API, 工具, Python, Anthropic, Dataset 數據集

discrete_diffusion_RRG:離散擴散模型點樣寫胸肺 X 光報告

這是一個醫學影像語言模型微調與評測項目,重點是比較 DiffusionGemma 與自回歸基線。它也示範任何順序補全文本在放射報告草稿中的價值。

Repository image for mxvp/discrete_diffusion_RRG

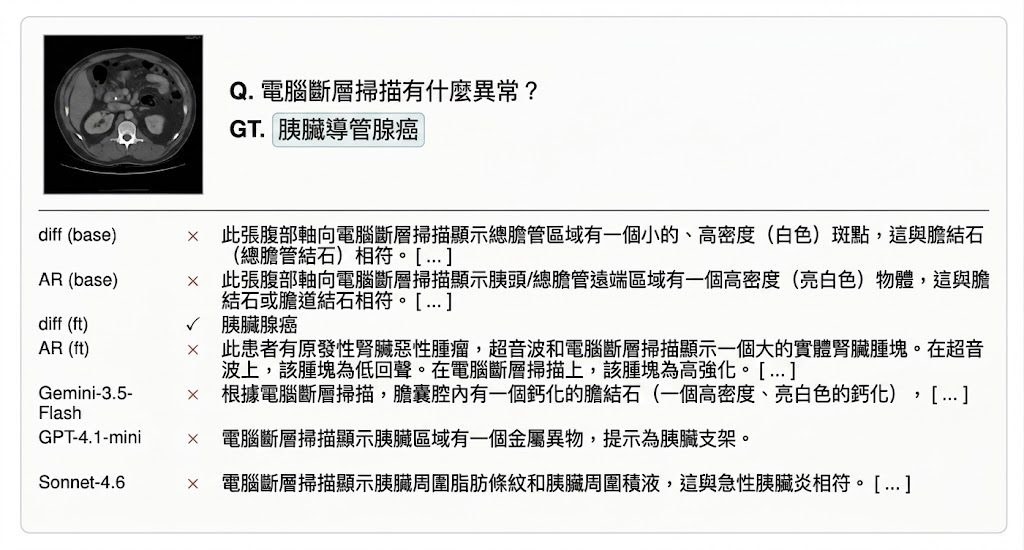
這是一個醫學影像語言模型微調與評測項目,核心是把 image-conditioned discrete-diffusion language model 與 autoregressive baseline 放在同一家族骨幹下直接比較。它主要處理 chest X-ray VQA 與放射報告補全,目標不是單純生成文字,而是讓模型根據 X 光影像回答問題,或在已知部分句子的情況下補寫其餘內容。

項目的設計重點在於控制變因:DiffusionGemma 與 Gemma-4-26B 使用相近的 backbone family、vision tower、資料與 LoRA 配方,令比較更集中於生成方式本身。diffusion 路線把報告當成可逐步去噪的 decoder canvas,autoregressive 則沿用 next-token 順序生成;前者的優勢是可以做 any-order infill,用雙向脈絡補空位,後者則較接近現時多數 VLM 的常見做法。

部署與測試門檻不算低。模型權重透過 Hugging Face IDs 載入,設定檔要接駁本地 JSON 資料索引;倉庫也提供 synthetic: {n: 16} 這種小型 smoke test,適合先確認流程有沒有跑通。硬件要求比較明確,diffusion backbone 需要支援 bf16 的 GPU,而且記憶體大約要 80 GB,這已經把它定位成研究團隊或具備高階 GPU 環境的醫療 AI 項目。

效能表現有幾個值得留意的點。支援內容提到 Discrete Diffusion Language Models 在醫療 VQA 上可追平,甚至略勝同系 autoregression,解碼速度亦可達 3.5 至 4.4 倍;不過目前較完整的準確度重心仍放在 VQA,而報告生成部分主要展示互動式 infill 能力,未算是完整臨床報告生成系統。語義評分還可接 LLM judge,但這部分需要額外 API 金鑰,也表示結果解讀仍有一定研究性質。

  • 類型上,它較接近研究原型加評測程式碼,不是即裝即用的臨床軟件。
  • 主要資料來源包括 VQA-RAD、SLAKE、VQA-Med 與 MIMIC-CXR。
  • 相關模型包括 DiffusionGemma-26B、Gemma-4-26B,並以 LoRA 方式微調。
  • any-order infill 是最有辨識度的能力,適合先固定部分報告內容,再由模型補全其餘位置。
  • 適合需要比較生成範式、研究 radiology report drafting,或想驗證 discrete diffusion 在醫療場景表現的團隊。

項目主頁 · GitHub · 模型

Categories: 開源, 視覺模型, Google, Gemini, API, Image, Medical醫學, Dataset 數據集

AnyGroundBench 點出影片定位模型盲點

AnyGroundBench不是新模型,而是專門測試影片理解能力的 benchmark。它把專業場景放入同一套規則,直接揭示現有 VLMs 的適應落差。

Repository image for rinost081/AnyGroundBench

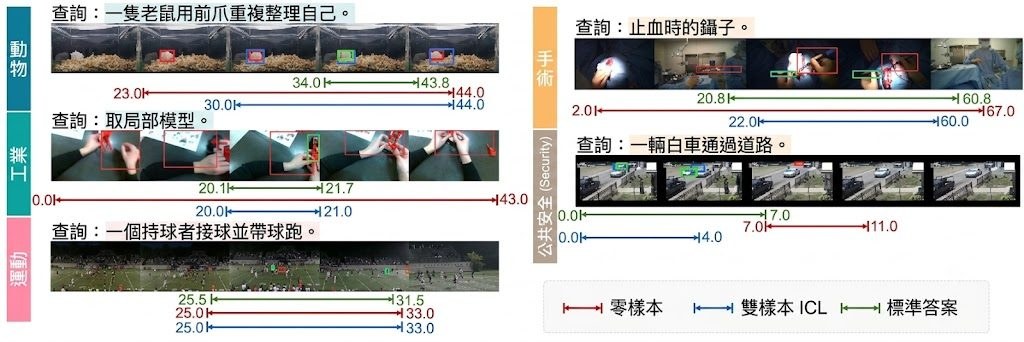
AnyGroundBench 是一個影片 grounding benchmark,也是面向專業領域的資料集與評測基準。它主要用來測試 Vision-Language Models(VLMs)在 animal、industry、sports、surgery、public security 幾類場景中,能否把文字描述準確對應到影片中的時間、位置,以及時空同時發生的事件。

現有做法多數停留在 general、daily-life benchmark 的 zero-shot 測試,重點是看模型有沒有通用理解力;作者認為這種範式無法反映專門場景,因為稀有視覺概念、複雜動作關係與領域術語,通常不會在通用資料裡被充分學到。AnyGroundBench 因而把評測重心轉去 domain adaptation,並加入 dedicated training subsets,令測試不再只問模型「有沒有見過」,而是進一步量度它「能不能適應新領域」。

這個項目的差異,在於它把 temporal、spatial、spatio-temporal annotations 用統一方式整理,並混合 newly captured videos 與 existing datasets。資料來源涵蓋 mouse、american_football、Animal-Kingdom、MECCANO、EgoSurgery 等,覆蓋面比單一領域 benchmark 廣,亦更接近研究團隊、產業分析、醫療影像研究與安全監測場景會遇到的資料分佈。

項目提供 Hugging Face dataset、project page:這不是即插即用應用程式,而是供研究與模型比較的 benchmark。部署重點不是介面安裝,而是按 domain 讀取整理後的資料,然後以 STVG、TVG、SVG 三類任務跑推理與評分;指標分別用 vIoU@0.3、tIoU@0.3、sIoU@0.3。

  • 類型屬於 benchmark / 資料集,目的是測量 VLMs 的 specialized-domain video grounding 能力
  • 舊範式以 zero-shot general benchmark 為主,新設計改為檢查 domain adaptation 與 In-Context Learning(ICL)是否真的有效
  • 評測涵蓋 temporal、spatial、spatio-temporal 三層,較容易看出模型究竟是看錯時間、找錯位置,還是兩邊都失準
  • 已評測 15 個 state-of-the-art VLMs,結果指出現有模型在 specialized domains 的 zero-shot 與 ICL 表現都不穩定

建議模型包括 GPT-4o、GPT-5.1、Gemini-2.5-Flash 等 proprietary VLMs;現有結果顯示,加入 2-shot ICL 雖然在部分 domain 有改善,但整體仍未解決 specialized-domain spatio-temporal reasoning 的缺口。對研究 VLM evaluation、video grounding、視覺模型遷移能力的團隊來說,這個項目最有價值的地方,是它把「通用測試看似可用」與「專業場景仍然失手」之間的差距量化出來。

項目主頁 · GitHub · Paper

Categories: 開源, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, OpenAI, Gemini, Video, 安全, Dataset 數據集

PerceptionRubrics 點出多模態評測盲點

呢個項目用更貼近人類觀感的方式,重新檢查多模態模型有無看錯重點。它唔係再鬥平均分,而係追查關鍵事實有無答錯。

Performance Comparison

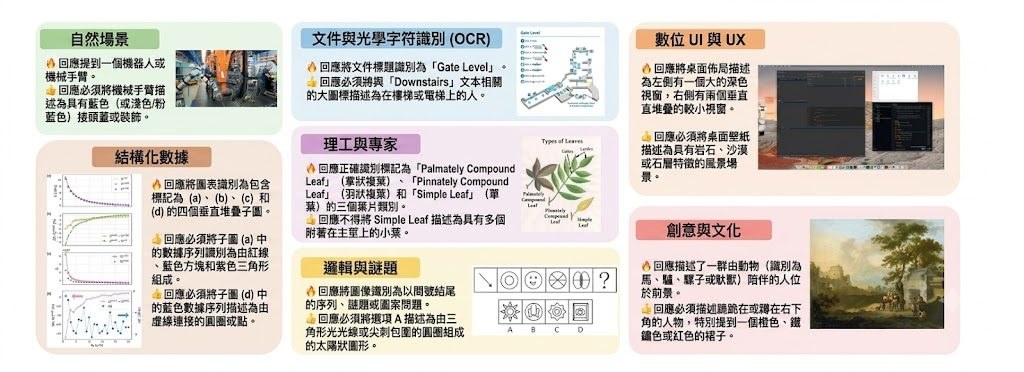
PerceptionRubrics 是一個多模態評測框架兼資料集,主力檢查 Multimodal Large Language Models 是否真正看清圖片內容,而唔係只係在傳統 benchmark 拿到高分。它要解決的問題很直接:現有 caption 評測常用 holistic semantic matching 或平均分,容易把嚴重錯誤沖淡,但人類閱讀結果時,關鍵事實一錯,整體輸出已經未必可信。

作者把舊有範式拆開重做,改用 atomic auditing,把每張圖分解成可核實的細項,再分成 Must-Right 與 Easy-Wrong 兩條 rubric 流。Must-Right 針對必要事實,Easy-Wrong 針對模型常見的細節遺漏、幻覺或誤判;再配合 gated scoring,只要必要視覺事實出錯,就會被明顯扣分,而唔係被其他小分數平均掩蓋。

資料規模方面,項目提供 1,038 張 information-dense images,同超過 10,000 條 instance-specific rubrics,來源是用 Circular Peer-Review 建立的 Golden Captions,再蒸餾成評測規則。覆蓋範圍包括 natural scenes、OCR documents、GUIs、charts、STEM、logic puzzles 同 creative/cultural images,明顯偏向高資訊密度、容易出現感知失真的場景。

測試方式不算複雜:這個 GitHub 儲存庫主要提供 evaluation code 和 data,較適合研究團隊、模型開發者,或者需要比較多個 MLLMs 表現的人,把模型輸出的 captions 對照 rubric 計分。它不是部署給終端用家的應用程式,而是拿來驗證模型在圖像理解任務到底穩不穩;使用前亦要接受一點,這類更嚴格的評分會令模型成績比傳統 leaderboard 更難看,但診斷價值更高。

  • 核心取向是由 holistic semantic matching 轉向 atomic auditing
  • Must-Right 與 Easy-Wrong 直接對應關鍵事實與常犯細錯
  • gated scoring 強調「關鍵錯一項就要反映出來」
  • 資料集中在 GUIs、文件、圖表等高密度視覺任務
  • 適合用來比較 20+ 主流 MLLMs 的感知可靠性,而唔只係比較平均分

項目指出模型經常能辨認零碎元素,卻未能同時滿足多個關鍵視覺約束,尤其在 GUIs、documents 同 structured charts 更明顯。README 與 supporting context 亦提到曾評測 20+ 主流 MLLMs,包括 GPT-5.5;不過這個儲存庫重點仍然是評測框架本身,而唔係推出新模型,所以較值得留意的是它怎樣暴露 perception brittleness,而不是單一排行榜名次。

項目主頁 · GitHub · Paper

Categories: 開源, 清華大學, 字節跳動, 多模態模型, Qwen, OpenAI, DeepSeek, Gemini, Dataset 數據集

Hermes MoA 協作提升答案質素

MoA 讓多個 LLM 平行作答,再交由一個模型整合。它適合較複雜的問題,但成本和延遲都會增加。

Hero image preview

這是 Hermes MoA(Mixture of Agents,混合代理)架構。它的主要用途是讓多個 Large Language Models 同時回答同一條問題,再由一個聚合者整合各自較強的部分,輸出單一答案。

MoA 的重點不在於訓練一個新模型,而是把多個現有模型疊成一個協作流程。文件指出它依靠多樣性、互補性與聚合三個機制運作:不同模型會走出不同推理路徑,彼此可以補足盲點,最後再由較強的模型統整結果。這種做法和只用單一模型相比,目標是提升複雜任務的回答質素。

在 Hermes Agent 內,這個項目提供三種落地方式:shell 腳本、delegate_task 與 Kanban。Shell 版本最直接,做法是先把多個 proposer 的回覆收集起來,再交給 aggregator 讀取並重寫成最終答案,較適合快速驗證流程;另外兩種方式則較適合需要更穩定管理的工作流。

文件亦清楚交代取捨。MoA 的成本大約是 N+1 倍,延遲通常接近最慢 proposer 再加 aggregator 的時間,所以不適合簡單問答;但對需要比較、整合、推理的任務會更有價值。頁面同時提到在 AlpacaEval 2.0 可帶來約 65% lift,而 proposer 數量以 3 至 5 個作為較理想的平衡點。

  • 核心流程是平行提議者 + 單一聚合者
  • 主要價值在於結合不同模型的長處
  • Hermes Agent 支援 shell、delegate_task、Kanban 三種實作
  • 成本與延遲明顯上升,較適合複雜任務
  • 示例有 anthropic/claude-sonnet-4、openai/gpt-4o、google/gemini-2.5-pro、deepseek/deepseek-chat

適合想在現有 LLM 工作流上疊加協作機制的人閱讀,尤其是需要提升答案穩定性、綜合能力或多角度分析的場景。它不是單一模型的介紹,而是一種可直接套用在 Hermes Agent 的編排方法。

項目主頁

Categories: Agentic, Google, OpenAI, DeepSeek, Gemini, 框架, Anthropic, Dataset 數據集

Headroom:幫 AI agent 壓縮上下文

這個項目專注減少 AI agent 的 token 消耗,同時盡量保留答案品質。它適合想降低成本、加快回應的開發團隊。

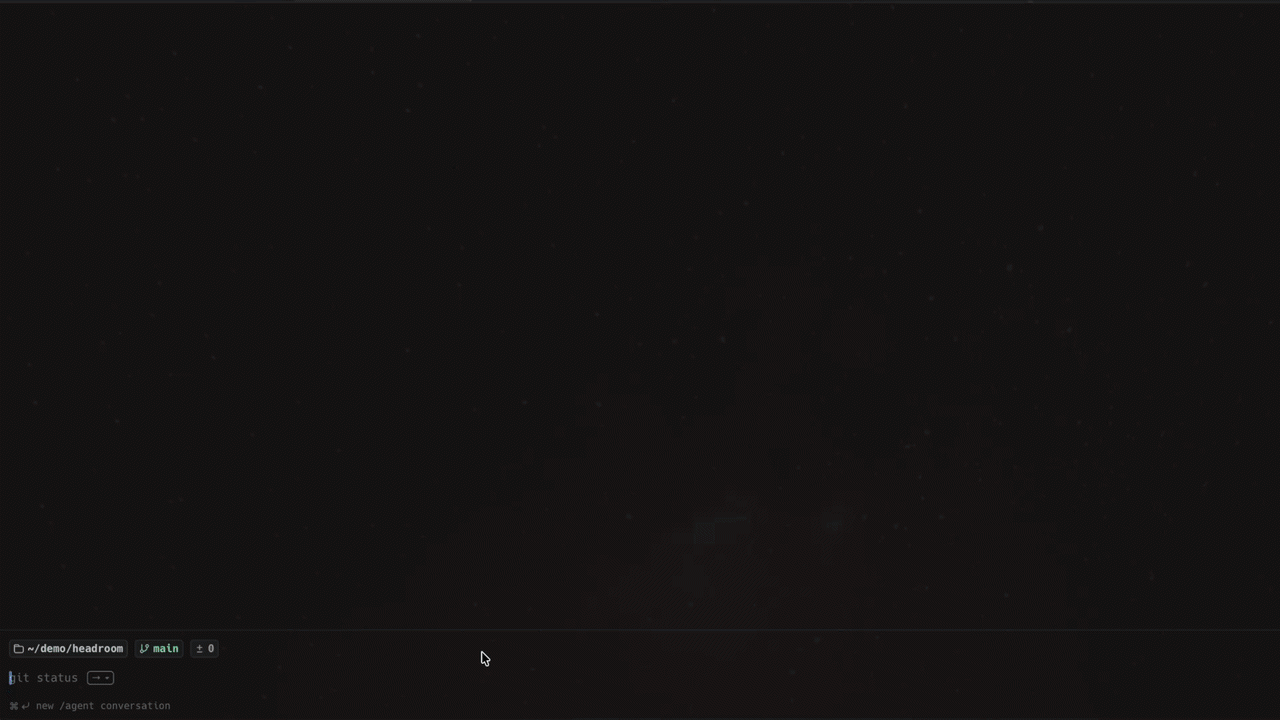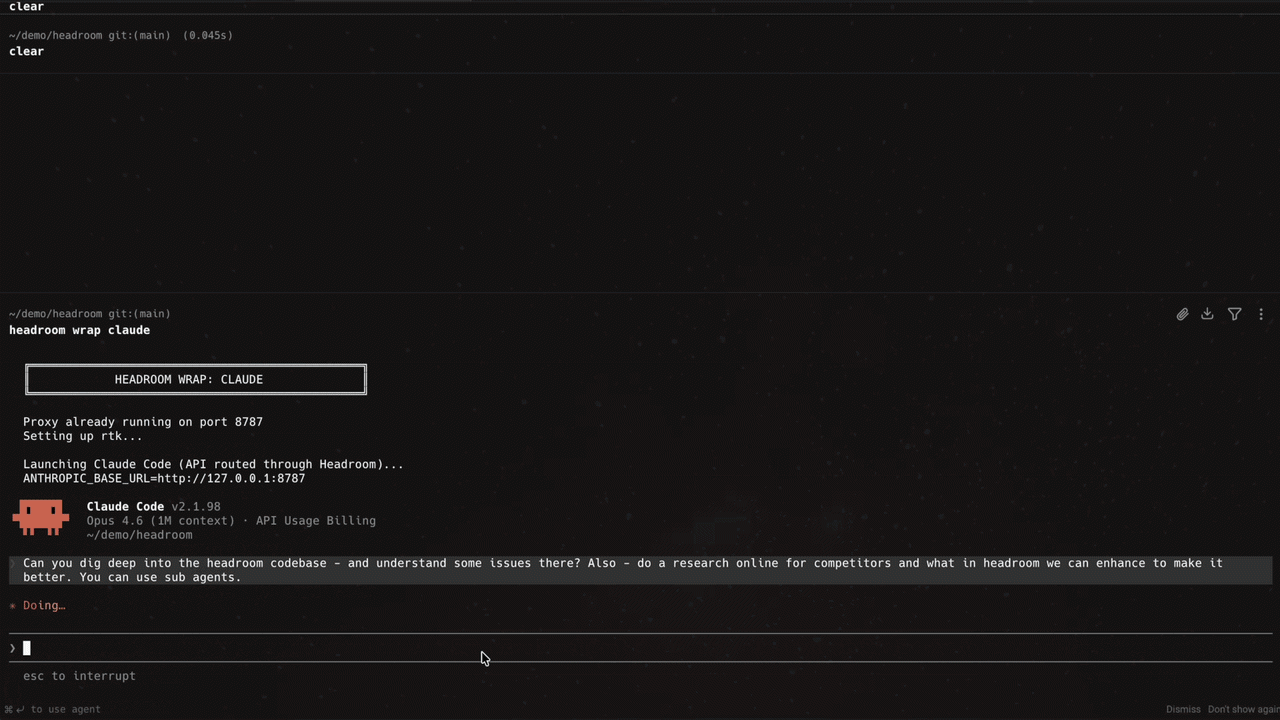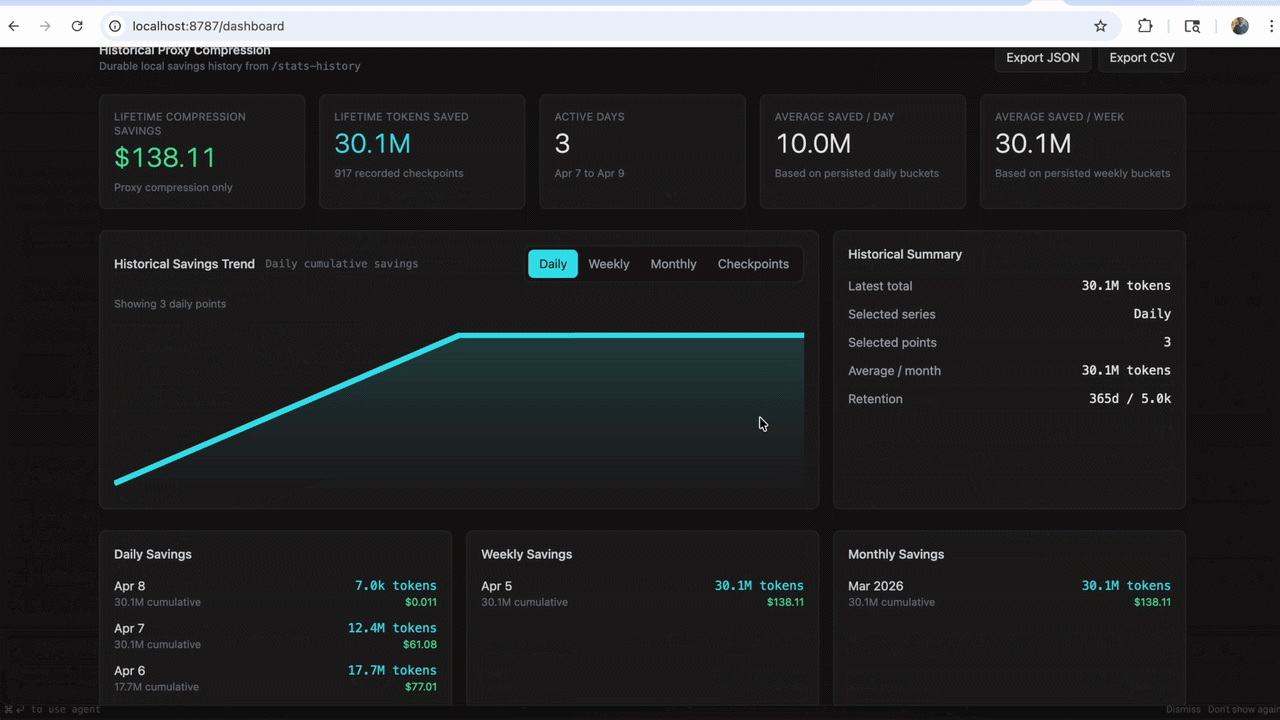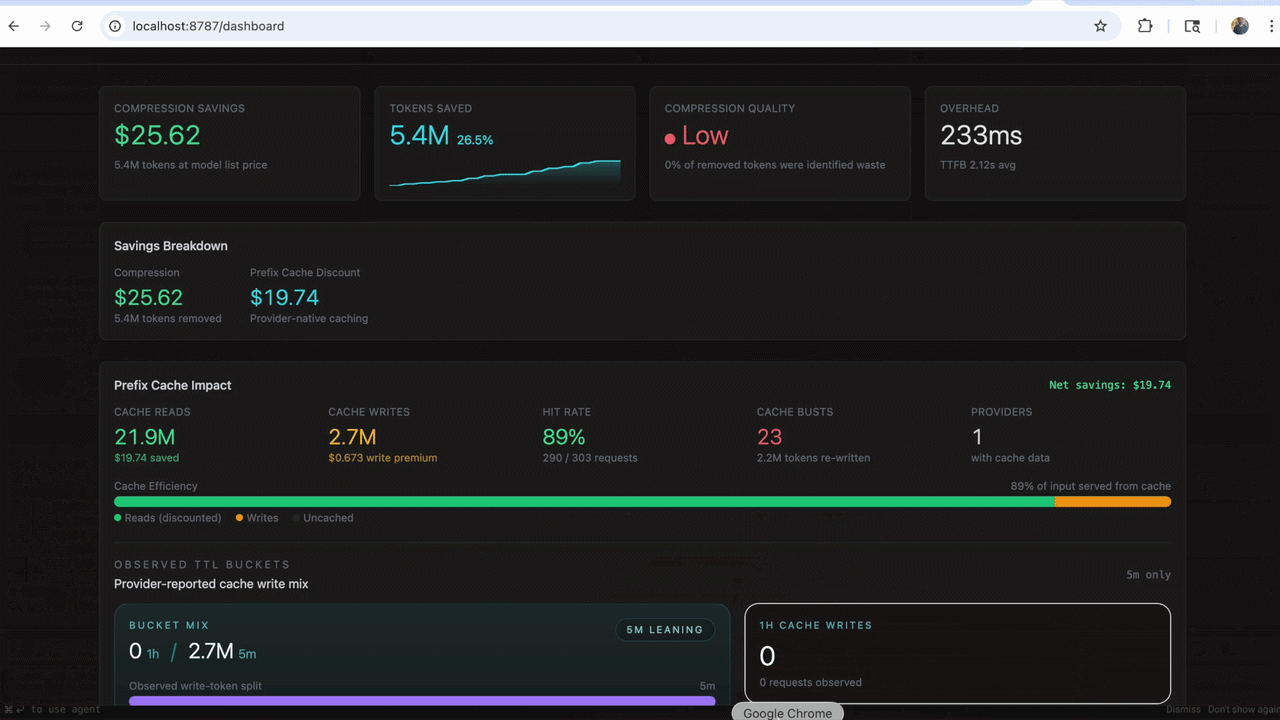
Headroom in action

Headroom 是一個給 AI agents 與 LLM 應用使用的庫兼代理工具,核心角色是把送進模型前的上下文做壓縮。它主要解決長對話、工具輸出、日誌、RAG 片段與檔案內容太長,令 token 成本、延遲與上下文容量很快爆滿的問題。

這個項目不只提供 Python 與 TypeScript 內嵌式 compress(messages) 用法,亦提供 proxy 模式與 MCP server,代表它可以直接插入現有流程,未必需要大改程式。README 提到 zero code changes 的代理方式,對已有多語言系統的團隊尤其實用;另外它走 local-first 與 reversible 路線,取向明顯是先保留可控性,再追求節省 token。

和一般只縮短輸入文字的做法相比,Headroom 的差異在於它同時處理模型輸出,會減少重複客套、重述程式碼,以及在例行步驟略過過深的「thinking」。這種取捨有助壓低來回 token,但也代表較依賴它對內容重要性的判斷;對需要完整推理痕跡或逐字保留輸出的流程,部署前應先做回歸測試。

結果列出的數字是 60–95% fewer tokens,示例亦有 10,144 壓到 1,260 tokens,同時保留相同問題結論;不過這些結果較適合視為官方展示,具體效果仍會受任務類型影響。較容易受益的情境包括多步驟 agent、跨工具調用、RAG 對話系統,以及 Claude、Codex、Gemini 之間需要共享記憶的團隊協作流程。

  • 支援 Library、Proxy、MCP server 三種接入方式
  • 可壓縮對話、工具輸出、logs、RAG chunks 與檔案內容
  • 提供 cross-agent memory,支援 Claude、Codex、Gemini 共用與去重
  • headroom learn 會整理失敗 session,寫入 CLAUDE.local.md、CLAUDE.md、AGENTS.md 或 GEMINI.md
  • 相關模型包括 Kompress-v2-base,而整體定位較接近 agent 基礎設施,不是單一聊天模型

整體來看,Headroom 最有價值的地方不在於再做一個包裝 LLM 的介面,而是把「上下文壓縮」獨立成基礎層。對經常被 token 成本、上下文長度與 agent 記憶雜訊拖慢的項目,它屬於值得優先測試的一類工具。

GitHub

Categories: 開源, Agentic, RAG, MCP, 模型, Gemini, Python, 庫, 編程, Anthropic

Page 7 of 11
1 … 5 6 7 8 9 … 11