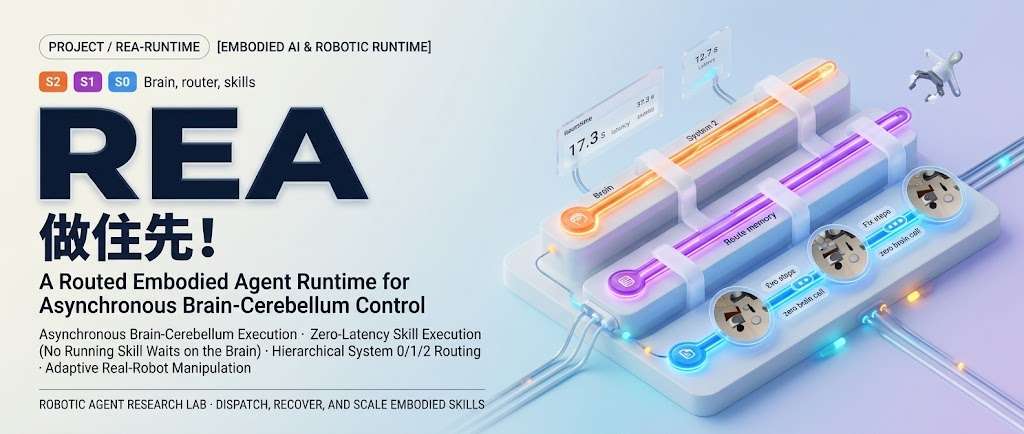
機械人執行動作時,若每一步都要等 AI 完成較慢的推理,控制就可能停頓。REA(Routed Embodied Agent Runtime)是為具身智能代理設計的執行框架,讓負責推理的「大腦」與快速控制的「小腦」非同步協作,並在需要時路由任務或復原執行流程。
這種安排適合需要連續動作、同時又要處理複雜指令的機械人工作流。REA 可協調 VLA(Vision-Language-Action)模型與程式控制政策,讓系統按任務選用不同控制方式;推理延遲不會直接令正在執行的控制政策停下來。
評測結果包括:在 3,000 個 LIBERO-Pro 測試回合中取得 95.9%,控制步數減少 25%;在 RoboTwin 2.0 中,結合 VLA 與程式政策取得 86%。頁面亦稱,REA 在 BEHAVIOR-1K 與真實 Unitree G1 測試中解決的回合數最多,但沒有提供這兩項測試的具體數字。
- 推理與快速控制非同步進行,執行中的政策毋須等待大腦回應。
- 透過路由與復原機制,協調不同類型的控制政策。
- RoboTwin 2.0 評測結合 VLA 與程式政策,結果為 86%。
- 項目頁需啟用 JavaScript 才能查看互動圖表;提供的內容沒有安裝或下載步驟。
REA 適合研究機械人長流程任務、異質控制政策協作,以及推理延遲如何影響動作連續性的團隊。現有內容提供多項基準測試結果,但未列出各項實驗設定與比較基線,閱讀數字時仍需留意這些資訊限制。