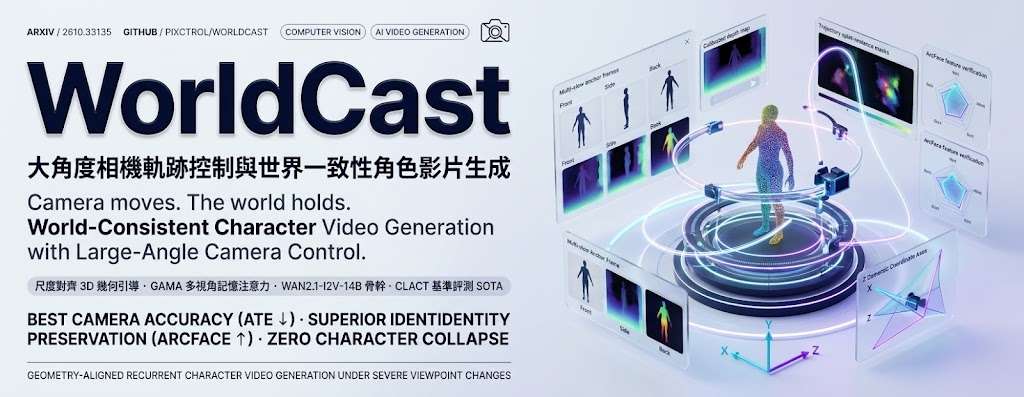
WorldCast 讓角色跟隨大角度鏡頭仍保持一致

只需一張參考圖、鏡頭軌跡及最多四張不同角度的錨點圖,WorldCast 便可生成保持角色身份的影片。

logo

只提供一張參考圖、目標鏡頭軌跡,以及 1 至 4 張不同視角的角色錨點圖,WorldCast 便能生成跟隨多角度運鏡的角色影片,同時減少轉換視角時身份走樣。這個開源模型項目針對的是影片生成中「鏡頭要郁得大」與「角色外觀要保持」難以兼顧的問題。

它以 Wan2.1-I2V-14B-720P 作為基礎模型,再加入 scale-aligned geometric guidance 和 Geometry-Aligned Memory Attention(GAMA)。前者把初始畫面轉成具校準深度的彩色 3D 點雲,沿目標軌跡渲染出 RGB 引導與 coverage mask;後者透過 Umeyama alignment 對齊多視角角色記憶,將相關特徵注入影片 token,補足新視角內容。

  • 支援 360° 鏡頭移動
  • 使用多視角 anchor images 維持角色身份
  • CLACT 包含 80,000 個訓練樣本及 42 個評測場景
  • 以 ATE、MEt3R 和影像品質比較結果

GitHub 已提供 inference code 和示範案例,但 WorldCast checkpoint、CLACT dataset 及 training code 尚未公開,因此下載 Wan2.1 基礎權重後仍未能完整執行示範。推理建議使用 Python 3.10 或以上、bf16,以及至少 48 GB 顯存;解析度和影片幀數提高後,記憶體需求亦會增加。

結果以較低的 ATE 和 MEt3R 對應更準確的鏡頭控制及跨視角一致性,影像質素則維持具競爭力。電影預視、角色廣告、遊戲過場及需要指定運鏡的生成影片工作流較適合採用。
項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Video, Image, Content Creator, 3D, Python, Dataset 數據集

RoboJudge:把影片的物理合理性與指令分開評測

RoboJudge 分開檢視具身影片的物理合理性與指令完成度,並以人類評分訓練模型,供團隊比較生成結果。

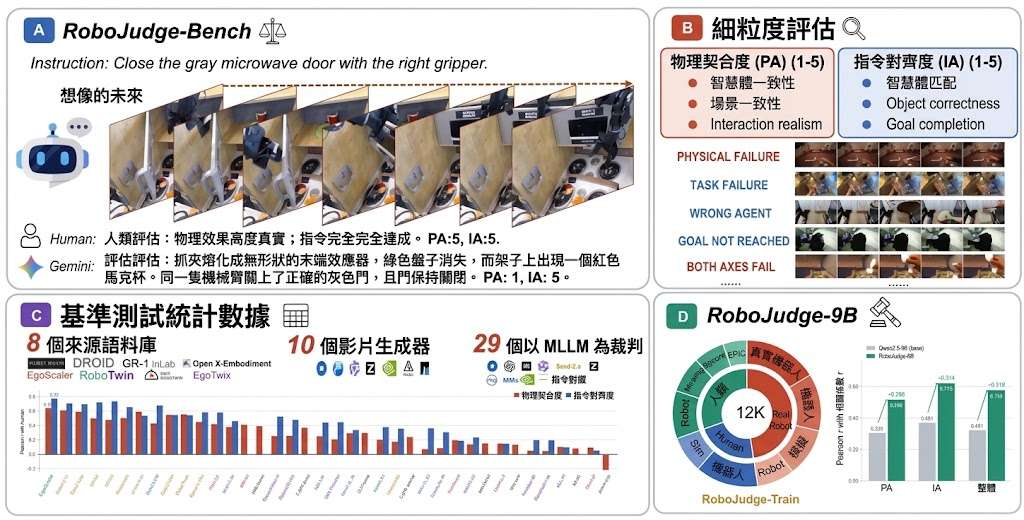
RoboJudge overview

具身影片可能動作自然卻未完成指令,也可能完成任務但違反物理規律。RoboJudge 以 Multimodal Language Models (MLLMs) 評審生成影片,分開衡量 Physical Adherence (PA,物理遵循) 與 Instruction Alignment (IA,指令符合度)。

這有助機械人及具身世界模型團隊分辨動作可信度和任務完成度。RoboJudge-Bench 收錄 800 段人工標註影片,涵蓋 8 個語料來源、10 個影片生成器,以及夾爪、人手與靈巧手。

RoboJudge-Train 收錄 12,000 段影片及 25,000 筆人工評分與理由;RoboJudge-9B 經監督學習及強化學習訓練。Pearson 相關係數在 PA 為 0.645、IA 為 0.775、整體為 0.719,較測試中的最佳專有基線高 0.089;相關性不代表每次判斷都正確。

GitHub 提供推理和基準評估程式,並連結模型與資料集。README 列出依賴安裝及執行流程,但沒有硬件需求資料,採用前宜先確認設備能否負擔模型載入與影片處理。

  • PA 檢視影片是否符合物理與時間約束。
  • IA 檢視影片動作是否符合指令。
  • 基準可用於比較評分,不能取代人工核對。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, AI productions, 模型, 多模態模型, 世界模型, 模型訓練, Video, 香港, Dataset 數據集, 強化學習

ComfyUI Graph Grid:一個比較提示詞、LoRA 與模型設定

ComfyUI Graph Grid 將不同提示詞、LoRA 強度、採樣器或 checkpoint 排成圖表,列隊生成,方便逐格比較結果。

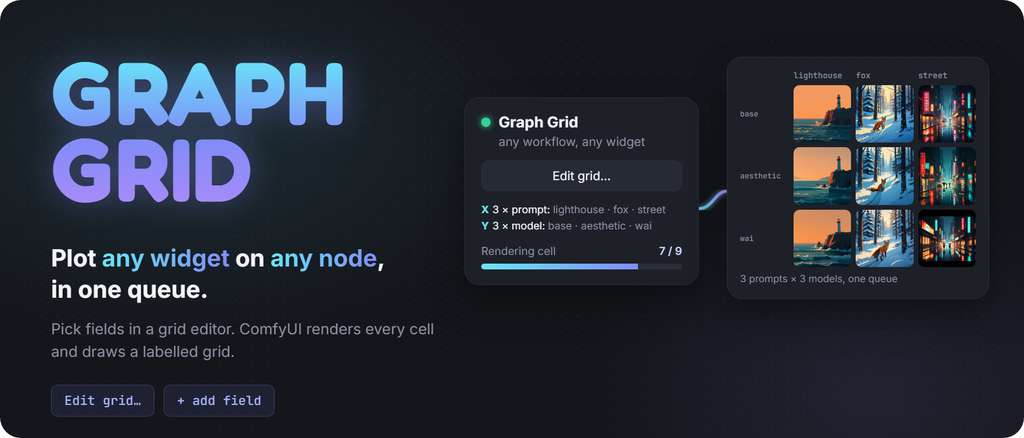
Graph Grid: plot any widget on any node, in one queue

將提示詞、LoRA 強度、CFG、採樣器或 checkpoint 放到行列中比較,ComfyUI Graph Grid 會一次佇列所有組合,再輸出附有標籤的圖像網格。它屬於 ComfyUI 自訂節點,處理的是影像生成工作流中逐組改參數、逐張記錄和肉眼比對過於零散的問題。

安裝可透過 ComfyUI Manager 搜尋 Graph Grid,或放入 ComfyUI/custom_nodes 後重新啟動。使用時把最終影像輸出接到 Graph Grid,再把 grid 輸出接至 Preview Image 或 Save Image;在編輯器中選擇要變動的 widget,填入行列值後佇列生成即可。項目已在 ComfyUI 0.41.0 測試,標籤位置亦取決於 Pillow 10.1 或更新版本。

它不要求特別的 loader 或 sampler,而是複製每格需要改動的上游圖段,讓 ComfyUI 執行各組設定;沒有變動的節點可載入一次,重複內容亦有機會由快取提供。接線中的 widget 不能直接變更,必須改動負責輸入的上游節點,其他未接入 Graph Grid 的輸出節點仍會以原值執行。

• 可同時比較多個欄位,亦能用數值範圍、下拉選單選項或逐行文字填充。
• 空白格會保留原本設定,Cross with existing 可建立完整組合。
• 適合測試 LoRA 權重、提示詞、模型和採樣參數的差異。
• 生成量會隨行列組合增加,顯存、時間和輸出整理成本仍需自行控制。

對需要挑選模型、整理提示詞實驗,或為影像生成流程建立可重現比較表的創作者和研究者,Graph Grid 能補足 ComfyUI 原生流程缺少的批量對照介面;它不會替你判斷哪組設定最好,價值在於把比較過程變得一致、可視化和容易回看。

GitHub

Categories: 開源, ComfyUI, AI productions, 模型, Image, 提示詞, Content Creator, LoRA

Digital Human Koubo:一句需求生成數字人口播廣告,連聲音也自動完成

相片加一句需求,就能串起數字人口播、字幕與影片包裝;代價是依賴外部雲端生成。

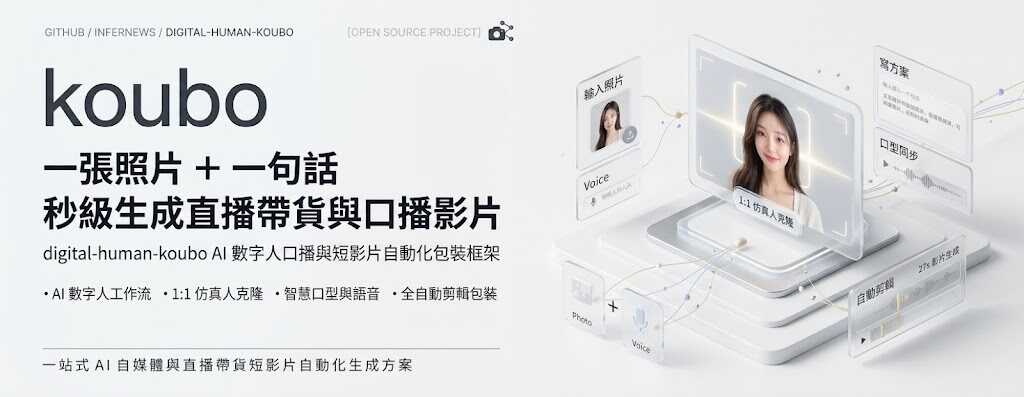
一張相片加一句需求,便可生成有數字人口播、字幕和促銷包裝的短片。andyhuo520/digital-human-koubo 是由人工智能(Artificial Intelligence,AI)代理執行的影片工作流,串連文案、對嘴、聲音整理和剪輯。

主持人設定存於 persona.json,固定外觀和聲線描述;GPT Image 合成場景後,Grok Video 1.5 經 Renoise 的 Model Context Protocol(MCP)製作每段最多 15 秒的口播片。按 SKILL.md 配置代理並連接服務後,可先看倉庫示例;其中一條 27 秒廣告耗用 482 Renoise credits,不能視為固定價格。

  • Whisper 逐段轉錄核對文稿,每段檢查 4 格畫面;若畫面出現生成字幕,該段會重做。
  • 頻譜匹配、去齒音及響度標準化協助統一分段聲音;測試中的齒音差距由 13.2 dB 降至 5.9 dB。
  • 48 項影片包裝手法參考 25 條創作者影片整理,可按需要增減。

這套流程適合需要反覆製作商品介紹或社交平台短片的小型內容團隊,也能把文字置於主持人身後。成品仍受外部模型服務和點數成本限制,使用前宜先檢查口型、畫面及人物一致性。

GitHub

Categories: 開源, AI productions, MCP, 數字人, 模型, Video, Image, Audio, Content Creator, 庫, Skill 技能

DirCast-code:AI 同時導播與解說,直播一手包辦

DirCast 每秒查看 Dota 2 十名英雄的鏡頭,自行選擇播出畫面並配上解說。它把導播與主播工作交給同一個模型,但目前評估仍集中於有限的職業賽事。

DirCast

直播觀眾看到的畫面和聽到的解說,通常由導播與主播共同決定;DirCast 嘗試讓 AI 每秒查看十名英雄的原始鏡頭,選出播出畫面,再按該畫面決定何時發言及說甚麼。這個研究型工具以 Dota 2 賽事為場景,處理的是如何在比賽仍在進行時,同步完成選鏡和解說,而非只替已剪好的直播影片配音。

DirCast 使用單一串流影片語言模型 Qwen3-VL-8B,並以 LoRA 微調。模型先低解像度掃描各英雄鏡頭及遊戲狀態,再由導播模組決定維持現有畫面或切換;選中的鏡頭會再以高解像度讀取,供發言判斷和文字生成。這種安排把全場掃描與播出畫面的細節理解分開,也讓模型的解說跟隨自己選出的畫面。

模型不會永久保留所有低解像度鏡頭:這些畫面只在設定的時間窗內留在上下文,播出畫面、事件和已生成的說話則會保留,令處理長賽事時的上下文成本受控。訓練時加入受擾動的播出流程,讓模型練習從自己選錯鏡頭後恢復;事件標記則協助它把擊殺等值得呈現的時刻納入選鏡考量。控制切鏡與發言的門檻亦會按頻率調節,避免節奏過密。

研究資料集包含 27 場職業 Dota 2 比賽,記錄每名英雄的鏡頭、人類導播選擇及主播解說。示範涵蓋兩場留出比賽,展示模型切到鏡頭外發生的交戰並作出評論;但這些例子不足以證明它已能應付不同遊戲、直播延遲或長期穩定運作,現階段較適合研究團隊測試自動化直播製作,而非直接取代真人轉播團隊。

  • 每秒掃描十路英雄鏡頭,並自行選擇播出畫面。
  • 同一模型負責導播決策、發言時機及解說文字。
  • 低解像度畫面會過期,播出內容與事件記錄則留在上下文。
  • 訓練資料來自 27 場職業 Dota 2 比賽,公開示範展示兩場留出賽事。

GitHub 儲存庫提供模型、資料處理與賽事狀態相關程式碼;研究人員可據此檢視流程或測試模型。儲存庫資訊未列出完整安裝步驟、硬件需求或可直接重現的評估指標,因此部署成本與相對真人導播、主播的穩定差距,仍需更多測試才能判斷。

項目主頁 · GitHub

Categories: 開源, 北京大學, AI productions, 模型, 模型訓練, Qwen, OpenAI, Video, 工具, 庫, Dataset 數據集, LoRA

CapCut 以外,Concat 把影片剪輯搬回本機

想剪片但不想上載素材、註冊帳戶或處理浮水印?開源影片編輯器 Concat 提供本機字幕、語音與多軌剪輯功能。

Concat

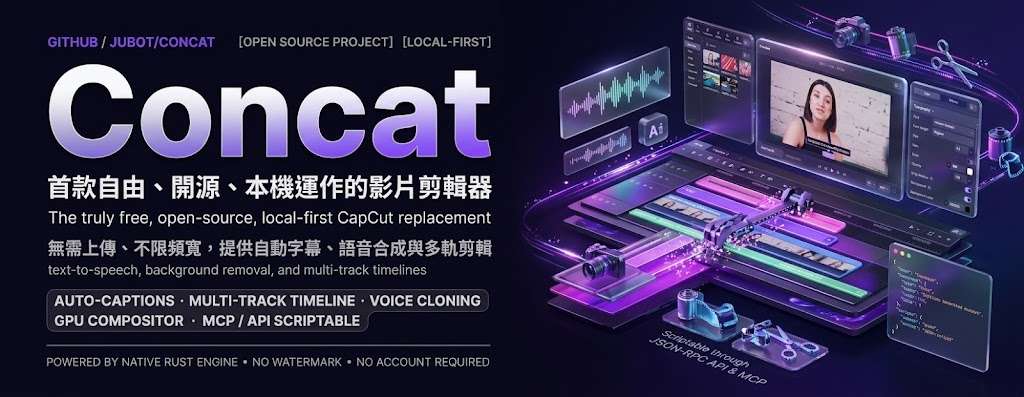
剪短片、上字幕、替換背景,卻不想先建立帳戶,把原片交給雲端平台處理,Concat 提供了另一條路。這個跨平台開源影片編輯器把自動字幕、文字轉語音、聲音複製、背景移除、多軌剪輯及 4K 匯出放進同一個介面,支援 macOS、Windows、Linux 與 Android。

Concat 屬於桌面及流動裝置影片編輯工具,核心特色不是追求完整取代所有專業軟件,而是針對 CapCut 常用的剪輯流程,減少上載素材及依賴訂閱的摩擦。自動字幕由本機 Whisper 處理,選擇模型大小後即可把字幕放上時間軸,再配合文字轉語音、關鍵幀動畫、特效及標題完成內容製作。

這項取捨十分清楚:素材可完全留在本機,離線工作,不會因平台政策改變而失去作品控制權;但代價是本機運算能力會直接影響字幕生成等功能的處理速度。Concat 亦提供語音複製,只需數秒錄音便可建立聲音,適合處理旁白、角色對白及多語言版本,背景移除則涵蓋人物、物件,亦可自行修正遮罩。

  • 支援 macOS、Windows、Linux 及 Android
  • 本機 Whisper 自動字幕,無須上載影片
  • 提供文字轉語音、聲音複製及背景移除
  • 支援多軌剪輯、關鍵幀、特效、標題與 4K 匯出
  • 無浮水印、無需帳戶,亦沒有上載限制或訂閱費用

對內容創作者、獨立製作者、教育工作者及需要處理敏感素材的團隊而言,這是一套頗完整的本機工作流。多軌剪輯、位置、縮放、旋轉、透明度及音量關鍵幀控制,令它不只停留在簡單裁片工具;惟目前版本號仍為 0.2.8,跨平台的成熟度、介面細節及不同裝置上的匯出表現,仍須經實際作品驗證。

GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, Video, Audio, 軟件, 工具, Content Creator, Mac, Linux, 語音, 動畫

MoneyPrinterTurbo 整合 AI 影片流程

輸入主題即可生成短片內容與素材,亦可接入不同模型;適合內容團隊快速製作多語言影片。

Kimi 赞助 MoneyPrinterTurbo

給定一個主題,便要自行寫稿、找素材、配音、加字幕再剪輯;MoneyPrinterTurbo 將這套流程整合成 AI 短影片生成工具,涵蓋腳本、配音、素材搜尋、字幕、配樂及剪輯,並提供 AI Agent、WebUI、API 和 CLI 四種介面。

由一句主題到成片:它可自動生成或改寫多語言影片腳本,也允許逐個環節改用自訂內容。支援批量生成、任務紀錄,以及設定和 API Key 的匯入、匯出與恢復,對經常製作大量短內容的編輯、社交媒體營運團隊及小型工作室尤其方便。

  • 輸入主題或關鍵詞,自動完成短片內容與素材配對
  • 以 WebUI、API、CLI 或 AI Agent 接入不同工作流程
  • 可替換腳本、配音、素材、字幕或配樂
  • 支援批量生成、任務歷史及多語言腳本
  • 兼容多種模型服務、統一網關及本地環境

模型選擇相當廣,可連接 Kimi/Moonshot AI、OpenAI、Anthropic Claude、Google Gemini、DeepSeek、阿里云通義千問、Microsoft Azure OpenAI、火山引擎方舟、xAI Grok、MiniMax、小米 MiMo,以及 Ollama、LiteLLM、OpenRouter 等平台。Kimi K3 獲項目採用,負責撰寫文案、提煉素材搜尋關鍵詞及判斷合適畫面;本地模型則適合重視資料控制或降低雲端依賴的團隊,但最終流暢度與準確度仍取決於所選模型、服務配額及素材來源。

這套工具的優勢不是生成單段影片,而是把多個製作步驟串成可重複運作的流程。代價是成品質素仍受文字模型、素材版權、語音及剪輯設定影響,重要影片應保留人工審核,而非直接自動發佈。

GitHub

Categories: 開源, Agentic, AI productions, 模型, Google, 微軟, OpenAI, DeepSeek, Gemini, API, Video, 工具, Ollama, 語音, Anthropic, Kimi, 小米-Xiaomi, MiniMax

video-use:一句指令把素材剪成 final.mp4

video-use 將 Claude Code、FFmpeg 與 AI 動畫工具串成影片剪輯流程,適合需要快速製作短片的創作者與內容團隊。

video-use

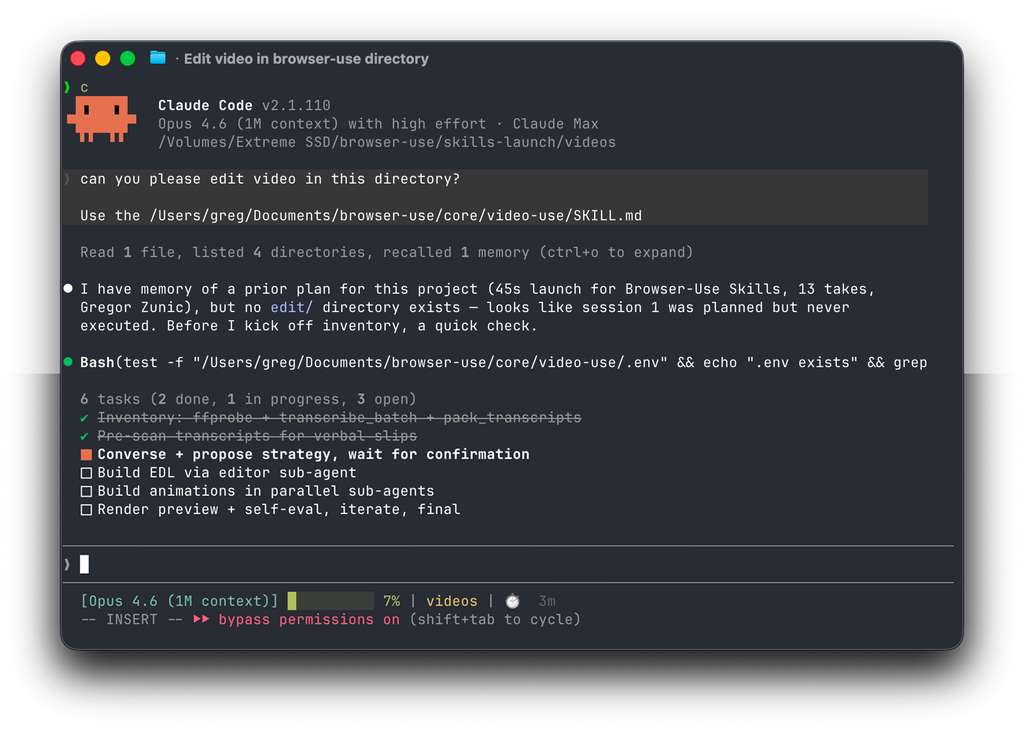
剪片最花時間的往往不是逐格拖拉,而是刪去口誤、停頓、重拍,再處理字幕、調色和動畫。開源項目 video-use 將這些工作整合到 Claude Code 對話中:把原始素材放入資料夾,提出剪輯要求,確認方案後便可取得 final.mp4。

它屬於 Agent 影片剪輯工具,依賴 FFmpeg、ElevenLabs API,以及支援 shell access 的 Agent;Claude Code、Codex、Hermes、Openclaw 等均可按技能方式整合。Agent 會先盤點素材並提出策略,待你確認後才進行剪輯,亦可用 project.md 保存跨次工作的記憶。

  • 自動移除「umm」、「uh」、重試開頭及拍攝間的空白
  • 支援預設或自訂 FFmpeg 調色,並在剪接點加入 30ms 音訊淡出
  • 預設以每兩字一個大寫單元燒錄字幕,樣式可自行調整
  • 可並行呼叫 HyperFrames、Remotion、Manim 或 PIL 製作動畫疊層

這種做法省去大量重複剪輯操作,也毋須在預設項目與選單之間來回切換。代價是成果會受素材品質、Agent 判斷、FFmpeg 設定及 ElevenLabs 服務影響;影片內容、關鍵 API 費用與電腦運算資源仍要由團隊控制。它適合對話式影片、教程、旅遊片段、訪談及社交媒體短片,但複雜敘事和高度精準的專業後期仍需要人工覆核。

影片輸出前,工具會逐個檢查剪接點,協助發現突兀轉場或音訊爆音;然而自我評估並不等同真人審片。採用這個項目時,重點不在追求完全自動,而在讓 Agent 先處理機械而重複的工序,把最後一輪節奏、內容與品牌審校留給創作者。

GitHub

Categories: 開源, Agentic, AI productions, API, Video, Audio, 工具, Content Creator, OpenClaw, Anthropic, 動畫, Skill 技能

video-shotcraft:用一張產品圖製作可編輯的宣傳片

video-shotcraft 將 Claude Code 或 Codex 接到影片製作流程,以 Remotion 排版真實產品截圖,交付可編輯 MP4。

video-shotcraft logo

只要向 Claude Code 或 Codex 提出「替產品製作宣傳片」,video-shotcraft 便會擷取產品真實頁面,選取鏡頭、編排故事線,再以 Remotion 動畫化。最終輸出 MP4、瀏覽器編輯器 Motion Workbench,以及剪映可編輯草稿,方便後續修改。它不是端到端影片生成模型,而是一套整合截圖、動態配方、節拍與音效的 agent skill。

  • 以真實截圖及文案作畫面素材,保留品牌外觀與文字清晰度
  • 提供 124 張 recipe cards,涵蓋 150 種鏡頭及預覽
  • 流程涵蓋 storyboard、Remotion 動畫、節拍同步、聲效及逐格檢查
  • 可交付 MP4、Motion Workbench 與剪映草稿

這種做法與文生影片模型的分別,在於每一幀都由程式碼繪製,而不是生成抽象影像;代價是成品取決於頁面素材、shot recipe 的覆蓋範圍及 Remotion 排版,創意空間主要來自鏡頭選擇和動態組合。36.2 秒的 ready template 可供快速改稿,但較長或講解密集的產品影片仍需要重新編排內容。

產品團隊、獨立開發者及需要反覆製作版本宣傳片的 marketing 部門,都可從「保留可編輯性」中受益。工程師可用現有網站截圖建立視覺稿,內容團隊亦可沿用剪映草稿調整節奏,省去由錄屏再逐段重做動畫的時間。

一行 “幫我安裝這個 skill:https://github.com/Vincentwei1021/video-shotcraft” 便完整安裝。適合希望將影片製作納入 coding agent 工作流、而非直接生成寫實片段的團隊。

項目主頁 · GitHub · 作品展示

Categories: 開源, Agentic, AI productions, Video, Image, Vibe Coding, 編程, Anthropic, 動畫, 聲效, Skill 技能

AI Toolkit 把擴散模型訓練搬上消費級硬件

將多種新式圖像與影片模型放入同一套訓練工具,兼顧 GUI、CLI 與本地環境管理。

AI Toolkit UI

想在家用硬件微調 FLUX、Qwen-Image 等模型,過往往往要自行處理環境、依賴與介面;Ostris AI Toolkit 把這些繁複步驟整合成一套擴散模型訓練工具。官方資料未提供完整安裝指令,但建議透過儲存庫內建的 AI Toolkit Manager 啟動。

AI Toolkit Manager 會偵測硬件並配置合適的 PyTorch 版本、建立 Python 環境,以及下載 Node.js 和 FFmpeg,所有檔案留在 ai-toolkit 資料夾內,不會系統級安裝。啟動時亦會檢查更新;若本機檔案經修改,更新會跳過並發出警告,減少覆蓋自訂設定的風險。

它屬於開源訓練套件,可透過 GUI 或 CLI 操作,涵蓋圖像及影片模型訓練。模型支援範圍頗廣,包括 FLUX.1、FLUX.2、FLUX.2-klein 4B/9B、Lumina-Image-2.0、Qwen-Image-2512、SDXL,以及 Chroma、HiDream、OmniGen2、Z-Image、ERNIE-Image 等新式架構。

  • 以消費級硬件為主要目標,縮低本機訓練門檻
  • 同一套工具支援多種新舊擴散模型
  • GUI 與 CLI 並存,兼顧互動操作及批次流程
  • 依賴與模型資源集中管理,減少系統污染
  • 保留本機修改,並在更新衝突時給出警告

相較只針對單一模型或只提供訓練腳本的做法,AI Toolkit 的優勢是將模型選擇、環境配置與操作介面放進同一工作流。不過,原始資料沒有交代各模型的訓練速度、記憶體需求或量化設定,硬件是否足夠仍要視模型大小與訓練配置而定。

這套工具較適合需要建立角色、產品或風格資料的設計團隊、內容創作者,以及想在本地微調開源模型的開發者。模型及環境檔案仍佔用大量磁碟空間,影片模型亦可能帶來更高記憶體與運算負擔,部署前宜先核對個別模型的條件。

GitHub

Categories: 開源, AI productions, 模型, 模型訓練, Qwen, Stable Diffusion, Video, Image, 工具, Content Creator, Python, 庫, 百度

Page 4 of 22
1 2 3 4 5 6 … 22