Gemini 4 Hydrogen:多模型分工的代理工作流

Google 推出日常編碼與代理工作流取向的 Gemini 4 Hydrogen,並以 Orchestrator 自動調度模型分工。

Gemini 4 Hydrogen 的定位不是取代模型,而是補上「快速執行」這一環:寫程式、跑測試、驗證改動都可以交給它處理,較複雜的架構判斷則留給 Gemini 4 Carbon 或 Gemini 4 Argon。Google 把它形容為多模型工作流中的高效率執行引擎,適合需要長時間運作、但每一步又講求速度的代理(agentic)流程。

這套安排最實際的改變,是不必由開發者逐項指定每個步驟用哪個模型。Google Antigravity 推出的 Orchestrator 可以在同一個工作階段內,根據任務需要切換 Carbon 與 Hydrogen;並行代理工作時,也可由 Carbon 協調,Hydrogen 負責執行與驗證,減少關鍵路徑上的等待時間。
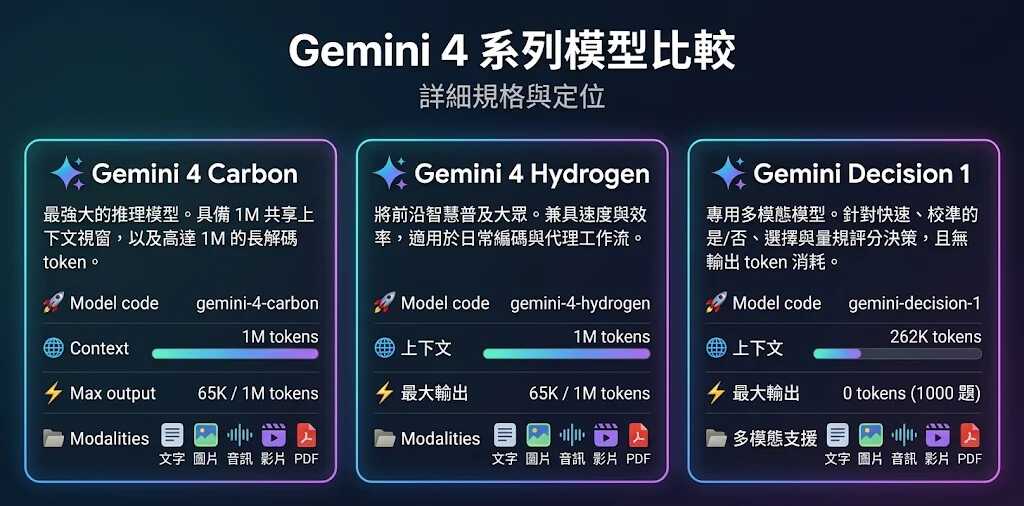
Hydrogen 的幾項重點如下:

  • 覆蓋所有 Google AI Studio 層級、Gemini API、Gemini for business、Gemini 應用程式及 Google Search,付費的 Google AI Pro 與 Ultra 訂戶亦可於 Google Antigravity 使用。
  • 預設 high 思考層級在 Artificial Analysis Intelligence Index 得分 51,較 Argon 的 50 高;切至最高 xhigh 設定可達 54。
  • 整段 100 萬 token context window 採用統一定價,每百萬輸入 token 為 1.50 美元、輸出 token 為 7.50 美元。
  • 官方同時強調可調思考層級、代理流程的可靠執行,以及在 Gemini 應用程式與 Search 中提供日常協助。

效能與成本之間的取捨也有具體數字。Orchestrator 在 Terminal-Bench 4.0 的任務成功率接近 Carbon,但平均少用 24% 配額、快 19% 完成。這意味著它未必每次都贏過 Carbon,卻可能在「完成度相若」的前提下,為高頻、規律的工程任務節省時間與額度。

Hydrogen 與 Carbon、Argon 的分工,適合架構設計、程式碼編寫、測試與改動驗證混合的團隊。對開發者而言,可把它視為處理重複執行步驟的工作模型;對企業而言,多模型調度則有機會降低整體用量。訂閱安排與實際成本,仍要視乎所選方案及工作負載而定。
項目主頁

Categories: Agentic, 模型, Google, Gemini, 工具, 安全

OpenMausBot:比 GrokBot 更強的工作團隊

OpenMausBot 把 Claude、Codex 或 Grok CLI 接入聊天介面,讓每個 AI 代理擁有自己的角色、工作環境與權限審批。

Boat (boat.dev)

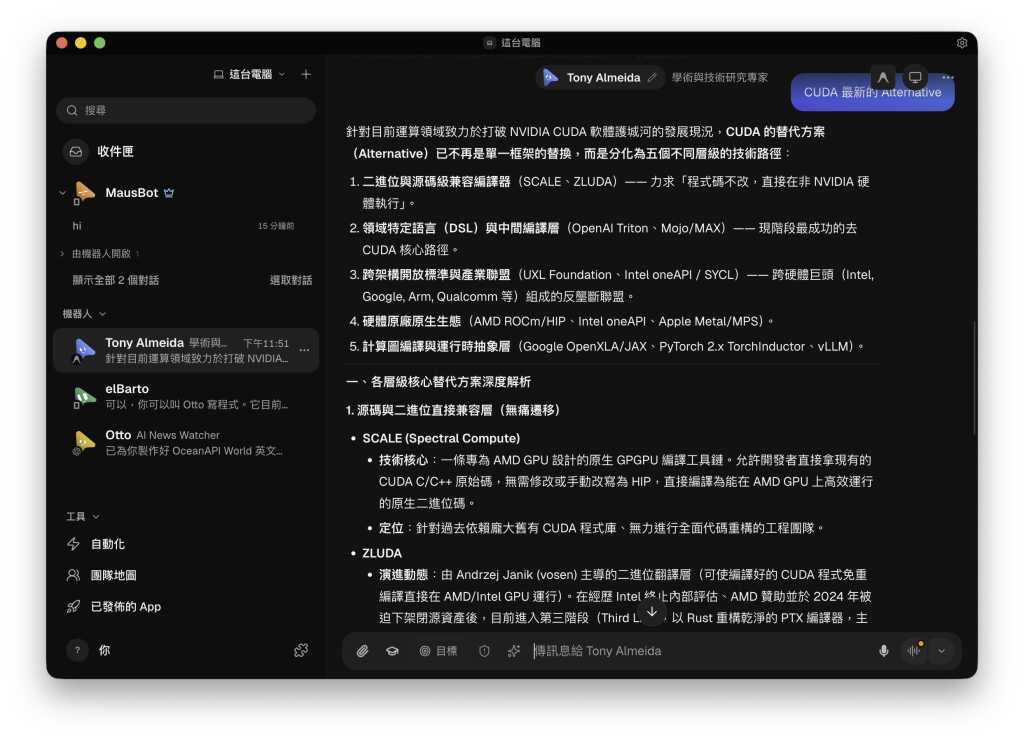
把多個 AI 代理放進同一個聊天視窗,最容易出現的問題不是模型不夠強,而是誰負責哪件事、可以動到哪些檔案,以及哪些操作必須先讓人批准。OpenMausBot 是一個開源桌面工具,正好把代理團隊、執行環境和人工確認串在一起。

它採用 local-first 架構,由一個綁定 127.0.0.1 的輕量 harness server 管理本機上的代理程序;聊天紀錄與金鑰留在自己的電腦。每個 bot 可以選擇 DeepSeek Harness、Claude、Codex 或 Grok CLI,配置不同模型、個性與工作目錄,像管理一群同事般分配任務。

  • 每個 bot 都是獨立代理,而非單一模型的聊天分頁
  • 代理可使用雲端 Linux desktop、隔離的 Local VM,或按平台支援的環境執行工作
  • 支援連接應用程式,並由使用者審批重要操作
  • 提供 React 19、Electron、TypeScript 桌面介面,涵蓋 macOS、Windows 與 Ubuntu

與直接使用 CLI 相比,OpenMausBot 增加的是聊天入口、代理分工、工作環境和權限控制;與雲端協作代理相比,它保留較高的資料控制權,代價是要自行處理 CLI 安裝、登入、API 費用及本機環境設定。官方沒有提供統一的模型跑分,因此較適合以任務完成率、操作審批流程和實際檔案需求來評估。

這個工具特別適合需要多個 AI 角色並行處理資料、研究、文件和程式工作的個人或團隊。Claude、Codex 與 Grok 是可選的 agent engines,並非 OpenMausBot 自行訓練的模型;先安裝桌面程式,再按引導連接其中一種引擎,便能由單一代理逐步建立代理團隊。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 模型訓練, Google, OpenAI, DeepSeek, API, 工具, Mac, Linux, Anthropic

Embodied First Exam:機器人是否真正理解任務?

這是一套針對具身智能程式代理的統一測試框架,以程式作答,再重播機器人片段評分。

logo

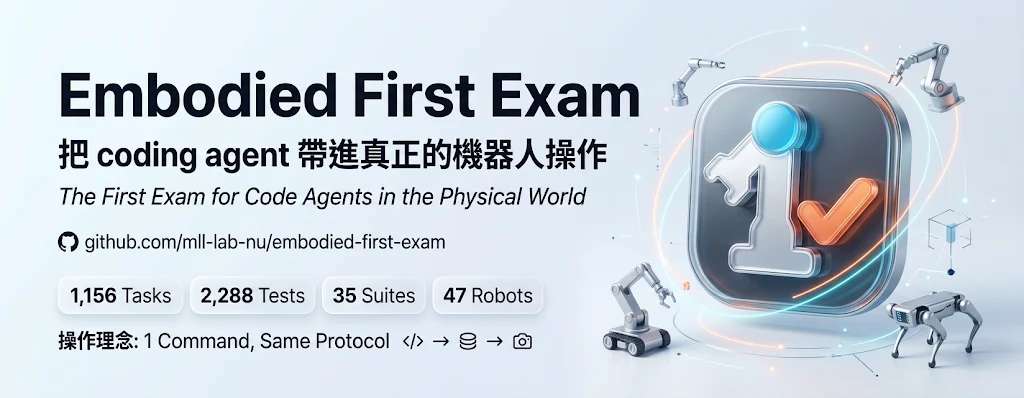
Embodied First Exam 把 coding agent 帶進真正的機器人操作題:代理在凍結場景中編寫並執行程式,觀察機械臂或身體控制器的反應,再按結果修正。它屬於 benchmark(評測基準)與統一框架,專門檢查程式代理能否把抽象指令轉成可運行的物理動作。

與只比較最終成功率的一次性測試不同,這套方法保留執行程式及場景重播,讓研究人員能分辨模型是真正理解任務,還是碰巧得到滿意結果。框架涵蓋 RoboPaint、RoboARC、RoboDynamicExam 等九個原創 suite,亦接納多個既有機器人與具身 benchmark,著重增加任務多樣性。

測試可分成三個層次:
– 以 RoboPaint、RoboARC 等任務檢視操作能力。
– 以 Embodied Olympics、KinDER、MuJoCo Playground 等涵蓋動態與控制。
– 以 Embodied Safety Exam 等檢查安全表現。

代價是測試環境相當厚重:需要 Linux、Docker、模型 API 權杖,部分 suite 要 NVIDIA GPU;RTX 級別顯示卡與 A100、H100 的支援安排不同,首次拉取映像亦可能佔用 1 至 30 GB。GPU 亦不是每項任務都需要,部分 suite 可在無 GPU 環境執行。

這套框架較適合具身智能研究團隊、agent 開發者,以及需要重現操作失敗原因的工程師。它提供的是可審核的考試環境,而非單一最佳模型;真正有用的成果,是讓不同 coding agent 接受相同物理任務、程式與重播式評分。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, NVIDIA, API, 框架, Vibe Coding, Linux, 編程, 安全

Grok Bot:把社交媒體流程拆成六個 AI 助手

一套月費 30 美元的配置,讓六個 AI 助手分工處理社交內容;發佈前仍由你拍板,亦要另付發文工具費用。

Og image

在 x.com 上看到有人用 GrokBot 成功借助開源工具做出一個社交媒體部門,經營社交媒體往往要兼顧找題材、寫稿、製圖、排程和檢視成效。這篇文章轉錄他示範如何用 Grok Bot 建立六個分工助手,讓創作者把日常流程交給雲端執行,自己保留發佈前的最後決定。

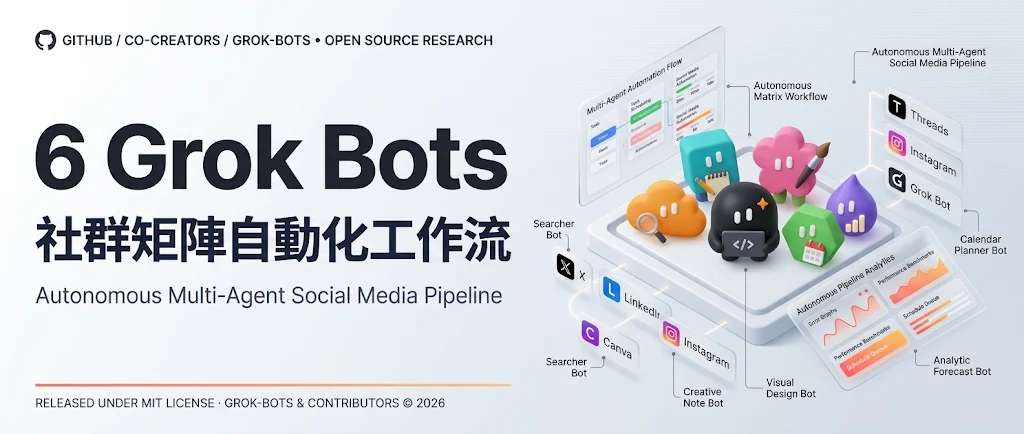
六個助手各司其職:研究題材、模仿帳戶語氣撰稿、製作視覺內容、安排發文時間、整理成效報告,以及統籌其餘五個助手。與把所有工作塞進單一提示詞不同,這種配置將任務分開,也可在關閉電腦後繼續運作;適合需要固定更新社交帳戶、但不想逐項手動處理的個人或小型團隊。

文章同時指出一個關鍵限制:Grok Bot 的官方 X connector 可搜尋貼文、讀取時間線和查看提及,卻沒有直接發文的工具。要把內容發到 X 或其他平台,仍須另接發文服務;因此,月費 30 美元只涵蓋 Grok Bot 所屬訂閱方案,發文工具費用另計。

整套流程仍以人工批准作最後把關,助手負責準備內容,不會未經同意就上線。使用者亦要留意每週用量配額未有公開具體數字,六個助手若配置不當可能很快耗用配額;若要製作圖片,還需另備 Canva 等設計工具。

  • 六個助手分工處理研究、寫作、視覺、排程、分析與統籌。
  • Grok Bot 可讀取 X 資料,但官方 connector 不支援直接發文。
  • 發文服務和設計工具可能產生額外費用。
  • 貼文須經人工批准;每週用量配額亦是成本考量。

項目主頁

Categories: 開源, Agentic, Image, 提示詞, 工具, Content Creator, 語音

Gemini Robotics 2.5:讓機械人更懂得感知與行動

Gemini Robotics 2.5 聚焦真實環境中的機械人智能,讓機械人感知周遭、作出推理並與環境互動。

1p0vcWGLECMy9qInQW 1AumUwO5fa37wyJ66G0eO8H14BurbFkN7NkKAXbjXYXZ9tS034NyZ9ByuQk8ptQ24dLcMBeg6o fHMmauBZJ7KAXdM5NHFQ=w1440

過去數年,人工智慧在大語言模型(LLM)與多模態推理上取得了突破性進展。然而,當我們嘗試將這些「數位大腦」移植到實體機器人時,卻遭遇了嚴苛的現實障礙:機器人在實驗室裡表現亮眼,一旦走進雜亂、充滿動態變數的真實世界,往往因缺乏靈巧度、應變力與安全性而頻繁失誤。

Gemini Robotics 2.5 的方向,是把感知、推理和互動能力帶進實體機械人工作流程,面向需要處理真實物件與環境變化的任務。

與預設指令執行固定動作的做法相比,這類模型著重把視覺理解、推理及工具使用連接起來。對研究機械人控制、設計任務流程或探索人機協作的團隊,這種能力有望減少任務與環境之間的落差。

Gemini Robotics 2.5,正是為了解決這道橫跨在「數位認知」與「物理操作」之間的鴻溝。作為迄今最強大的視覺-語言-動作(Vision-Language-Action, VLA)模型,Gemini Robotics 2.5 不僅提升了機器人的操作靈巧度與學習速度,更透過在賓士(Mercedes-Benz)真實汽車裝配線上的驗證,象徵實體智慧(Physical Intelligence)正式跨出實驗室,邁向規模化落地。

從以下幾點理解它的定位:
– 面向真實世界的實體互動,而非只生成文字或影像。
– 涵蓋感知、推理、工具使用與環境互動。
– 適合關注機械人任務規劃及人機協作的研究與開發團隊。

項目主頁

Categories: Agentic, 模型, Google, Gemini, NanoBanana, Video, Image, Audio, Robotic, 工具, 安全

ProTEUS 顛覆閉環蛋白質的「突變解析世界模型」

設計蛋白質變異時,預測只是起點;ProTEUS 把模型排序和濕實驗結果接起來,逐輪挑選更有機會提升功能的候選序列。

proteus logo

在合成生物學與生物製藥領域,高活性、高穩定性的蛋白質酶一直是生技研發的核心聖杯。然而,傳統的「定向進化(Directed Evolution)」與當前主流的 AI 蛋白質設計工具,依然被困在巨大的序列空間與昂貴的濕實驗(Wet-lab)瓶頸中。

挑選蛋白質變異時,單靠預測未必能找出真正有效的序列。ProTEUS 把模型設計、實驗室測量和下一輪候選連成閉環,協助研究人員逐輪搜尋具有更高活性的變異蛋白。

蛋白質由 20 種天然胺基酸排列組合而成,僅僅一條 300 個胺基酸的中型蛋白質,其潛在突變空間就高達 $20^{300}$,遠超宇宙原子總數。項目先利用已測量的蛋白質功能資料訓練模型,再根據突變效果為候選序列排序;每輪測試 30 個變異,取得濕實驗結果後,便用累積測量重新調整目標預測器。預訓練表示則保持固定,讓後續搜尋能利用新結果,而不必每輪重做整套預訓練。

ProTEUS 在兩種蛋白質上展示了閉環演化流程。SacB 經過 3 輪、測試 90 個變異,最佳篩選活性達野生型的 14.03 倍;另一條 SacB 演化路線達 12.38 倍。ALDH 經過 5 輪、測試 150 個變異,最佳篩選活性為野生型的 6.85 倍。這些數字是篩選活性,不應直接解讀為已證明所有用途下的功能提升。

項目亦以 132 萬筆變異測量、涵蓋 161 種蛋白質背景的資料進行預訓練。研究報告指出,把功能訓練資料增加 80 倍後,測試誤差下降 56.3%;在預訓練測定中的留出變異測試,MSE 由 0.262 降至 0.115。這些結果反映特定資料與評估設定下的表現,未代表所有蛋白質或實驗條件。

ProTEUS 適合需要在有限實驗批次中安排蛋白質候選測試的研究工作流,尤其是能反覆測量功能並把結果用於下一輪設計的情境。它的成果仍受目標蛋白、測定方式和候選範圍限制,實驗驗證是閉環中不可缺少的一環。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 世界模型, 模型訓練, Video, Vibe Coding, Medical醫學, 編程, 安全

InfraRSI:自動加速 LLM 訓練的 AI Agent

InfraRSI 是一個專注於大語言模型(LLM)訓練基礎設施優化的自主 Agent(Harness)。其核心理念是利用遞歸自我改進(Recursive Self-Improvement, RSI)技術,自動為既有的訓練任務進行效能調優與程式碼層級的最佳化。

InfraRSI Logo Banner

傳統的調優工具多半聚焦在超參數搜尋(Knob Tuning)— 例如嘗試調整 Batch Size、Gradient Accumulation Steps 或是平行度設定。然而在現代 GPU 叢集上,真正的效能瓶頸往往深植於程式碼層級:

何時該導入融合算子 (Fused Kernels)?如何正確啟用 Flash Attention 與 torch.compile 編譯注意力機制?如何在 Activation Checkpointing、Offload 與運算速度之間取得平衡,避免顧了顯存卻犧牲吞吐量?

InfraRSI 突破傳統純調參(Knob Tuning)的局限,自動引入融合算子(Fused Kernels)、編譯注意力機制(torch.compile)及顯存平衡策略。官方實測平均提速達 1.83×,MFU 由 17.4% 大幅拉升至 30.0%。

RSI 經嚴格驗證的成功方案會寫入知識庫。跨 GPU 硬件遷移時能直接沿用歷史經驗,大幅縮短摸索至效能峰值的時間。

嚴謹驗證的機制包括內置 16 項不變量檢驗,確保數據量、Optimizer Steps 完全一致且 Loss 偏差在容許範圍內;配合雙模型交叉審查(一個寫 Patch、另一個 Code Review)及背靠背複測,杜絕訓練異常。

廣泛支援並相容 Megatron-Core、FSDP2、DeepSpeed 等主流框架;後端可直接串接本機已登入的 Claude Code、Codex CLI,或各類 OpenAI 相容 API 與自建 vLLM。

快速上手,執行單一 Bash 指令即可開始運作:

infrarsi optimize ./train.sh --llm codex-cli

啟動時會透過互動式問答確認設定,並支援以自然語言下達限制(例如「不能改動 optimizer」、「batch size 不可大過 4」)。系統驗證完成後,會直接輸出最佳化腳本 infrarsi_optimized.sh 與審核完畢的程式碼補丁,讓團隊以極低門檻榨盡 GPU 算力。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型訓練, Qwen, OpenAI, DeepSeek, 工具, Python, 庫, Anthropic

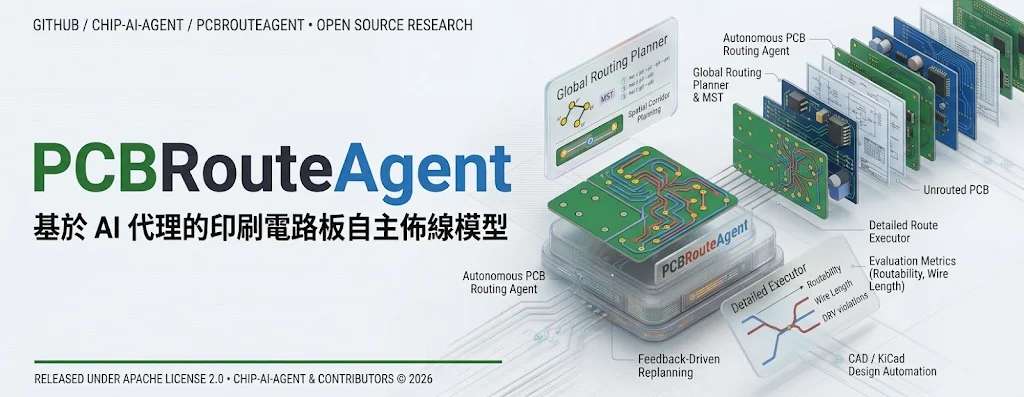
PCBRouteAgent:讓 AI 規劃並修正電路板佈線

PCBRouteAgent 把全板佈線規劃交給多模態代理,再以 KiCad 原生路由器執行並回報失敗原因。它在 247 塊電路板上的測試,也揭示連線完成不等於設計規則全數過關。

Overview of PCBRouteAgent

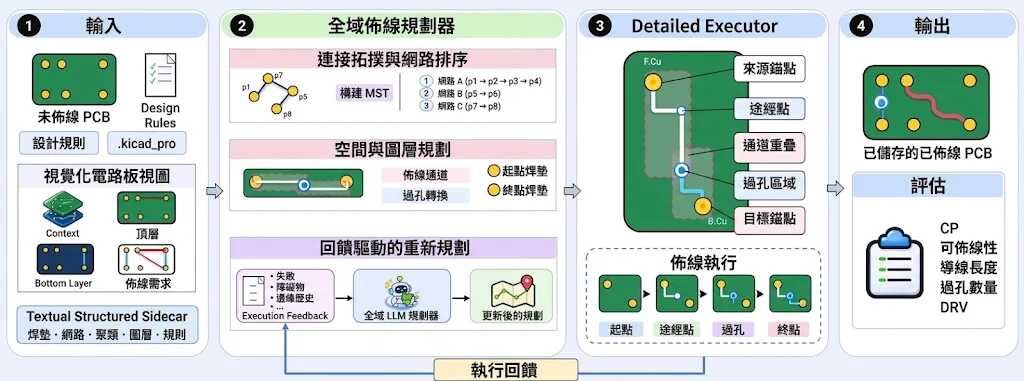
PCB 佈線不只是把焊盤連起來,還要避免走線互相阻擋,並符合間距、線寬等設計規則。PCBRouteAgent 是一個多模態代理框架,讓大型語言模型(LLM)負責安排連線順序、路徑和層次,再由 KiCad 的原生推擠式路由器(push-and-shove router)處理具體走線;遇到障礙時,執行結果會回傳給規劃器,供它調整策略。

這種分工讓代理不必單靠模型逐段猜測幾何路徑,也保留全板層級的規劃能力。項目以 PCBWorld 的 247 塊電路板測試,使用 PCBWorld 官方評測器檢查連線是否完成,以及 KiCad 是否回報設計規則錯誤;電氣連通完整仍不足以代表所有訊號限制都已符合,案例亦顯示前段走線可能堵住後續連線。

• Opus 版本在 D2、D3-A、D3-B、D3-C 的 clean pass 分別為 100%、94.9%、100% 和 40%,不同測試集的落差明顯。
• 使用相同 Haiku 模型骨幹比較時,框架提升完成度,整體模型呼叫約減少 131 倍,API 成本約低 4.3 倍。
• 測試以固定元件位置、網表及設計規則的 KiCad 電路板為輸入,輸出仍是 KiCad 格式的已佈線電路板。

這套流程適合研究 PCB 自動化、評估模型代理能力,或需要批次比較佈線結果的工程團隊;但 D3-C 的 clean pass 仍只有 40%,不能把代理輸出的完整連線直接當成符合工程要求的成品。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型, 多模態模型, API, 框架, Anthropic

Video-Coder:用 AI 幫 Blender 補足影片生成的物理控制

Video-Coder 先用 Blender Python 建立具結構與動態的 Draft Video,再交給影片生成器完成畫面,改善物理合理性與控制能力。

Video-Coder overview

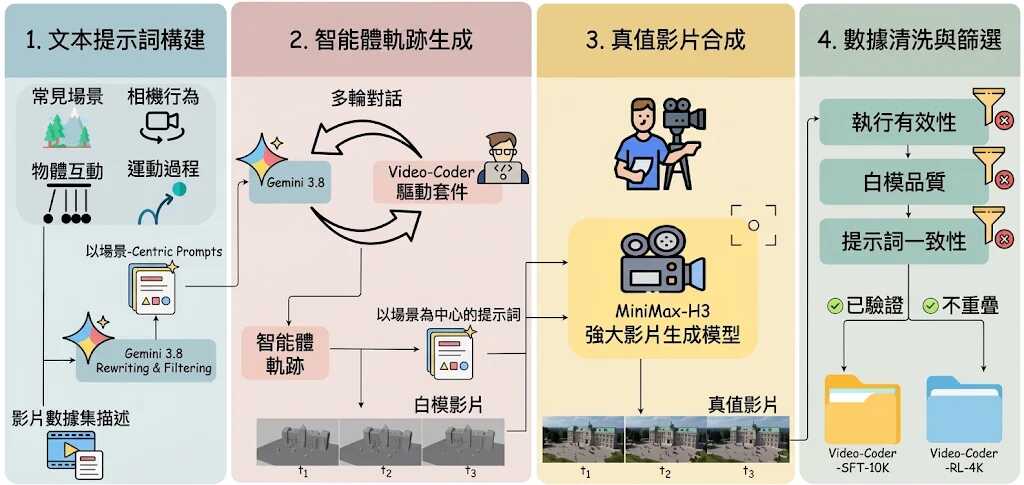
影片生成遇到物件互動、鏡頭運動或物理效果時,單靠文字直接生成往往難以穩定控制。Video-Coder 以 coding agent 身份編寫並執行 Blender Python,建立 3D 場景及 Draft Video,再把物件位置、動作和鏡頭資訊交給下游影片生成器;項目屬於影片生成代理項目,處理的是生成結果缺乏明確結構與物理約束的問題。

核心流程放在 Video-Coder Harness:代理會寫程式、執行、檢查結果,再按回饋修改程式。模型先以 supervised fine-tuning(SFT)訓練,之後接受 harness-native agentic reinforcement learning(RL);執行獎勵會逐步轉向影片獎勵,令程式能夠產生可用的場景草稿。Video-Coder-9B 建基於 Qwen3.5-9B,並可配合不同 Video generators。

  • 以可執行 3D 程式補強直接文字生成
  • Draft Video 提供結構、動作與鏡頭訊號
  • 同時提供 SFT、RL 訓練流程及訓練資料
  • Video-Coder-9B 配合 MiniMax-H3 可提升物理相關評分

評測結果顯示,Video-Coder-9B + MiniMax-H3 在 PhyGenBench 平均取得 0.67,高於 MiniMax-H3 的 0.61;VBench-2.0 平均為 78.19%,較單獨使用 MiniMax-H3 的 54.58% 高 23.61 個百分點。Mechanics 分數達 88.67%,但這些結果依賴特定模型組合,未必能直接代表所有影片生成器的效果。

項目提供 Video-Coder-9B、Video-Coder-SFT-9B 模型及 Video-Coder-train-data,並列出 SFT 和 RL 的 Python 3.12 環境設定方向;提供的資料未包含完整推理流程,訓練指令亦在輸入內容中截斷。研究團隊、影片模型開發者及需要精確控制物件互動的創作者,較容易從這套程式驅動流程受益,但使用者需要準備 Blender、模型推理及訓練所需的運算資源。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, Agentic, AI productions, 模型, 模型訓練, Qwen, 微軟, Video, Vibe Coding, Content Creator, 3D, Python, 編程, Dataset 數據集, MiniMax, 強化學習

Confucius4-R2T2:即時語音辨識

開源串流 ASR 模型以 160 毫秒更新文字,並把未確認部分留在內部,減少字幕閃動與後續重寫。

Confucius4-R2T2

即時字幕最惱人的問題,不只是慢,而是文字一邊出、一邊改。Confucius4-R2T2 針對這個矛盾,採用只追加、不回頭修訂的穩定前綴(Stable Prefix)串流設計,已確認的文字永久提交,未確認內容則留在模型內部,適合直播字幕、即時傳譯及接入 Large Language Model(LLM)的語音流程。

這是一個開源的低延遲自動語音辨識(Automatic Speech Recognition,ASR)模型,源自 Qwen3-ASR-1.7B,透過 Longest Stable Prefix(LSP)學習及 1,500 小時中英文音訊訓練。解碼區塊可設為 80 毫秒至 2 秒,權重優先與延遲優先模式均只輸出已提交內容,並可加入主題及詞彙提示。

  • 160 毫秒(10 分之一秒)解碼、每次保留一個暫存 token 時,辨識錯誤率為 5.76%。
  • 相同串流設定下,基礎模型錯誤率為 21.01%。
  • 完整上下文參考結果的錯誤率是 5.15%,差距已相當接近。
  • 同一個 checkpoint 支援完整上下文及串流辨識,涵蓋 13 組中英文測試集。
  • 項目提供 vLLM、Hugging Face transformers 離線路徑,亦可選擇 llama.cpp 解碼。

它並非把所有即時輸出都交給下游處理,而是以 Longest Stable Prefix(LSP)學習配合 Wait 動作,訓練模型分辨哪些內容可以提交、何時需要更多音訊。訓練分為 SFT 與 GRPO 兩階段,只更新語言解碼器,音訊編碼器及 projector 保持凍結,亦沒有改變原有架構。

取捨主要落在準確度與輸出延遲之間:調整解碼區塊和暫存 token 預算即可改變兩者關係,毋須重新訓練。專注即時字幕、會議紀錄、同聲傳譯或需要即時觸發動作的 LLM Agent 團隊會較容易受惠;代價是已提交文字不能修訂,而且所報延遲未包括服務及網絡時間。

項目主頁 · GitHub · 模型

Categories: 開源, Agentic, 模型, 模型訓練, Qwen, Audio, LLaMa, 語音

Page 2 of 47
1 2 3 4 … 47