Echo-Memory 讓世界模型認得回家的路

當 AI 影片模型控制鏡頭離開某個場景再折返時,常常會「認錯地方」——同一條街、同一件家具,回來時卻變成另一個看起來合理、但其實陌生的世界。

Echo-Memory paper teaser and workflow

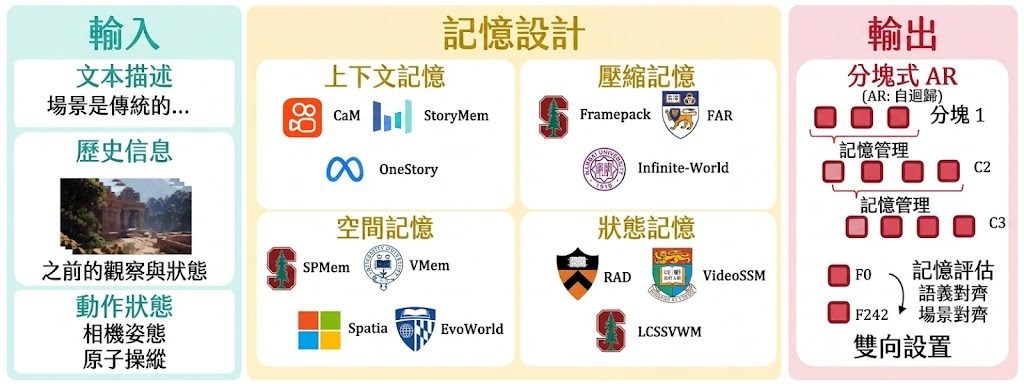
當 AI 影片模型控制鏡頭離開某個場景再折返時,常常會「認錯地方」——同一條街、同一件家具,回來時卻變成另一個看起來合理、但其實陌生的世界。Echo-Memory 想解的,正是這個讓生成影片失去一致性的老問題。整個研究的設計非常克制:只更換「記憶模組」,其餘一概不動。

Echo-Memory 以同一套 Wan 2.1 1.3B 動作到影片(action-to-video)模型作為共用底座,把記憶方式分成四大類——Context(原始幀滑窗)、Compression(壓縮後的學習 token)、Spatial(顯式空間讀寫狀態)、State-Space(區塊式 SSM 遞迴更新)。所有變體都掛在相同的寫入—讀取介面上,差別只在於「存什麼」和「怎麼取回」。這種單一變因的設定,讓四種記憶家族的表現可以乾乾淨淨地比較。

對研究員和工程師而言,項目提供了開發者指南。Echo-Team 已把訓練到 30,000 步的 Wan 2.1 1.3B 權重放在 Hugging Face 的 Echo-Team/Echo-Memory,並附上 SpatialVID 子集的動態訓練池設定文件,開發者指南亦提供中英雙語流程。評測方面,項目提供 GT replay、in-domain 180 度折返,以及 open-domain 編輯式回訪三種探測腳本,涵蓋靜態回放和場景重訪兩個維度。

要注意的是,目前的權重僅限 Wan 2.1 1.3B(epoch-0),Wan 2.2 以及 5B/14B 多尺度底座、以及超越靜態重訪的動態評測,仍列在路線圖上等待補齊。對於研究世界模型長期一致性、做可控影片生成,或是想在 LoRA/記憶外掛(memory adapter)方向動手的人,這個項目提供了一個難得的可重現基準;對一般讀者來說,它也示範了當鏡頭「回家」時,AI 為何會迷路、又該怎麼讓它記路。

重點摘要:

  • 統一底座、只換記憶:以 Wan 2.1 1.3B 為共用骨幹,比較 Context、Compression、Spatial、State-Space 四種記憶家族。
  • 可控變因設計:所有模組共享寫入—讀取介面,差異集中在「存什麼、怎麼取回」。
  • 完整可重現資源:公開 30,000 步權重、SpatialVID 訓練池設定、雙語開發者指南與評測腳本。
  • 三種回訪探測:GT replay、in-domain 180 度折返、open-domain 編輯式回訪,分別檢驗重播與折返記憶。
  • 未來路線:Wan 2.2、5B/14B 多尺度底座與動態評測仍待補齊。

GitHub: https://github.com/Echo-Team-Joy-Future-Academy-JD/Echo-Memory

項目: https://echo-team-joy-future-academy-jd.github.io/Echo-Memory/
Categories: 開源, 香港大學, 香港科技大學, 北京大學, 清華大學, 框架

Stream3D-VLM 把串流影片變成 3D

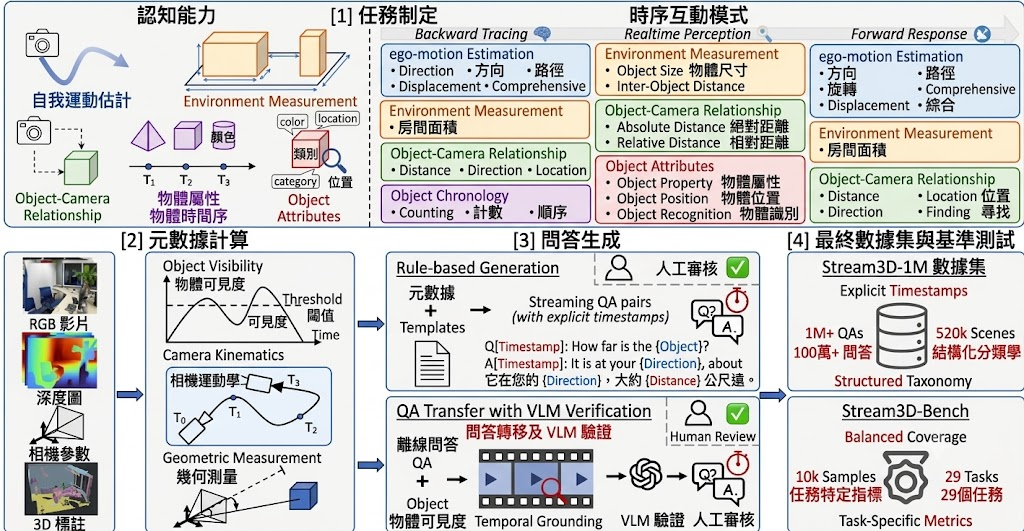
處理的不只是影片,而是邊看邊理解空間。Stream3D-VLM把串流畫面、幾何資訊與語言回應連起來。

Stream3D-VLM Logo

Stream3D-VLM 是一個 online 3D vision-language model,重點是直接從串流影片做即時空間理解,而不是等整段影片或整個場景收集完才分析。對想研究機械人、空間問答,或 3D 場景互動的人來說,這個項目處理的是「模型可否一邊看、一邊建立場景概念,再即時回答問題」這件事。

使用這個項目時,核心資源包括已公開的 Stream3D-VLM-4B 模型、Stream3D-1M Dataset,以及 Stream3D-Bench。資料方面未有直接釋出原始媒體,但有提供標註、GLB 與 RRD 等重建結果;GLB 可放入一般 3D viewer 逐步查看點雲,RRD 則可配合相機姿態與點雲記錄觀察完整重建流程。

Stream3D-VLM 加入 incremental geometry priors,令模型隨時間吸收對齊的 3D 幾何線索。項目亦提出 Visual-Spatial Feature Integration(VSFI)模組,以及 Geometry-Adaptive Voxel Compression(GAVC)模組,前者負責把幾何資訊逐步注入視覺串流,後者用 3D 結構去壓縮 visual tokens,減少長序列推理負擔。

團隊亦建立了可擴展的資料生成流程,整理超過 1M online spatio-temporal 3D QA pairs,並設計涵蓋 29 項任務的基準。項目聲稱在 online 與 offline 的 3D spatial understanding、reasoning、grounding 任務上,表現優於部分 proprietary 與 open-source models;不過文章未在這份資訊中列出完整數字,閱讀結果時仍要配合論文與實驗頁面一起看。

  • 解決痛點:傳統 3D Large Multimodal Models 多數依賴離線處理,這個項目改為面向 streaming video。
  • 主要方法:結合 autoregressive streaming control、VSFI 與 GAVC。
  • 資料與基準:提供 Stream3D-1M Dataset 標註及 Stream3D-Bench,涵蓋 29 項任務。
  • 可視化資源:支援 GLB 與 RRD,方便檢查增量重建與相機軌跡。
  • 相關模型:已公開 Stream3D-VLM-4B,可作為了解整體能力的主要入口。

整體來看,Stream3D-VLM 最適合用來觀察 3D 多模態模型如何由「看完整段再答」走向「邊看邊答」。它未必是一般開發者即裝即用的輕量工具,但對研究串流場景理解、3D 問答、空間推理流程的人,這個項目有相當清晰的方向與實驗野心。

GitHub: https://github.com/hanxunyu/Stream3D-VLM

項目: https://stream3d-vlm.github.io/

Categories: 香港科技大學, 騰訊, 模型, 視覺模型, 多模態模型, NVIDIA, Robotic

AffordanceVLA:為機械臂加入「先想再做」的能力

這項目把視覺、語言與動作三者之間的落差,透過三段式可供性預測串起來,讓機械臂在執行指令前先理解該碰哪裡、怎麼碰。

AffordanceVLA overview

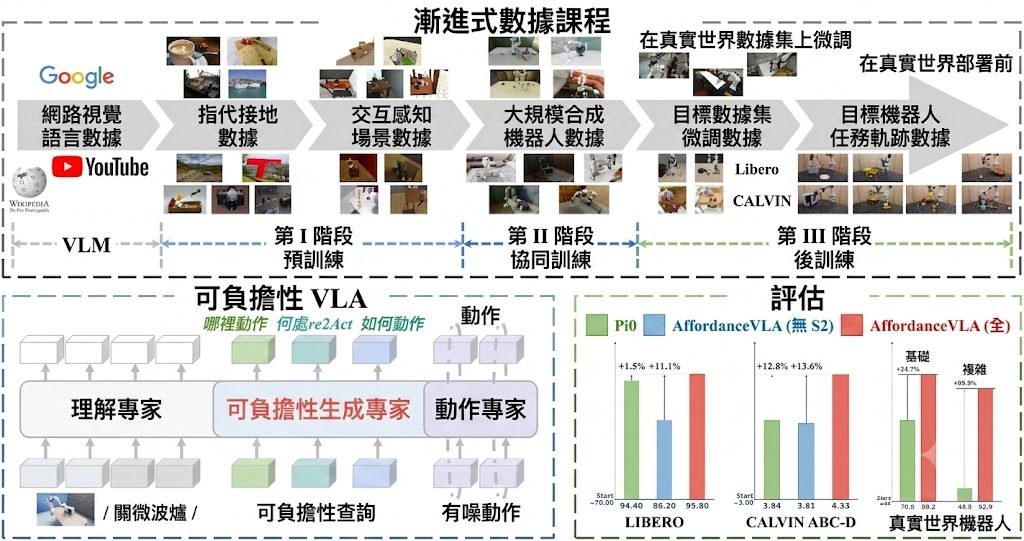
機械臂聽到「把杯子拿起來」這類指令時,傳統的視覺語言動作模型(Vision-Language-Action Model, VLA)往往要直接把影像和文字翻譯成關節角度,中間欠缺一個「思考」步驟。AffordanceVLA 嘗試在這個鴻溝上架一道橋:先讓模型預測結構化的可供性(affordance),再據此生成動作。

整個框架由三個專家模型組成,按單向的 UAA 注意力串接。Understanding Expert(M_und)以 PaliGemma(SigLIP + Gemma)為骨幹,把畫面、指令與機械臂自身狀態融合成統一的語意表示。Affordance Generation Expert(M_gen)以 Gemma 搭配可學習查詢,把上述表示解碼為三種可供性標記:Which2Act 判斷要操作的物件、Where2Act 標出二維互動熱區、How2Act 則推估三維幾何資訊。最後 Action Expert(M_act)以 flow matching 方式輸出整段動作序列(action chunk)。這個設計呼應了論文「Affordances serve as a perfect bridge」的核心想法。

由於現成機器人數據集中缺乏密集的可供性標註,作者額外提供了一條自動化標註管線,並以三階段漸進式課程訓練 MoT 架構。訓練時須留意 model.chunk_size 與 data.chunk_size 保持一致,否則動作 attention mask 會錯位;Which2Act 的 Flux loss 預設為 MSE,可在 src/models/which2act_decoder.py 頂端切換。

這個項目適合研究 VLA、機器人操作策略,或對可供性表示有興趣的開發者。需要一支能跑 PaliGemma 與 flow matching 的 GPU 環境,並準備好仿真或實機評測流程。論文中的模擬與真機實驗橫跨多種操作場景,顯示加入可供性中間層能提升泛化與精確度,但具體數字仍以官方報告為準。

重點摘要

  • 以 Which2Act、Where2Act、How2Act 三段式可供性作為視覺、語言與動作之間的中間橋樑。
  • 採用 MoT 架構,串接 PaliGemma 為基礎的 Understanding、Gemma 為基礎的 Affordance 與 Action Expert。
  • 配套自動化可供性標註管線,緩解機器人數據標註不足的問題。
  • 訓練採三階段漸進式策略,flow matching 輸出整段動作序列。
  • 模型、訓練與標註腳本皆隨開源項目釋出,歡迎社群延伸。

GitHub: https://github.com/Skywalker-yqz/AffordanceVLA

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, 模型, 多模態模型, 模型訓練

Lumos-Custom:DAMO 學院的影片生成套件

阿里巴巴達摩院(DAMO)開源的影片定制研究項目,涵蓋主體個性化生成、影像重新打光,以及推理驅動的統一影片生成框架。

ETV task prompt

Lumos-Custom 是阿里巴巴DAMO 學院的開源影片定制研究合集,把三個子項目整合在同一個儲存庫,方便研究者各自取用。三個子項目分別對應不同的影片生成難題:身份與屬性定制、打光控制,以及結合推理的統一生成。

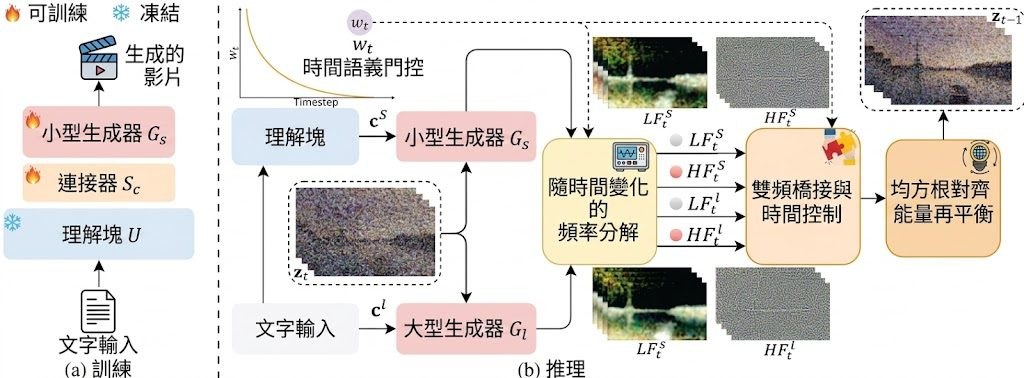
其中最受關注的是 Lumos-Nexus (arXiv 2605.31603)。它解決了一個長期痛點:把大型高保真生成器放進統一訓練迴圈成本太高,改為訓練一個輕量的連接器對齊理解模組,再用「Unified Progressive Frequency Bridging (UPFB)」在推論時把任務交接給預訓練的高容量生成器,既省訓練資源又保留視覺品質。為了補足推理類影片生成的評測空白,作者還發布了 VR-Bench

第二個項目是 LumosX,已被 ICLR 2026 接收。它的切入點是「多主體個性化影片生成」:先用字幕與 MLLM 抽取的先驗建構關係結構,再透過 Relational Self-Attention 與 Relational Cross-Attention 編碼主體與屬性之間的依賴。評測資源集中在 LumosX/benchmark/,權重已上傳 Hugging Face。

第三個項目是 UniLumos(NeurIPS 2025),專注於圖像與影片的統一重新打光,採用 RGB 空間幾何回饋配合 flow-matching 主幹,適合需要控制光影的研究與應用場景。

總結要點:

  • ** DAMO 是 Discovery, Adventure, Momentum and Outlook
  • Lumos-Nexus:輕量訓練搭配 UPFB 頻率交接,兼顧推理品質與視覺保真度
  • LumosX:以關係式注意力處理多主體個性化生成,附 benchmark 與 Hugging Face 權重
  • UniLumos:統一圖片與影片重新打光,採用 flow-matching 與幾何回饋
  • VR-Bench:補上推理驅動影片生成的評測缺口
  • 子項目獨立部署:每個子項目都有獨立 README,支援單獨安裝與重現

這個項目適合研究影片生成、多模態統一模型與個性化生成的研究者與工程師。如果你想驗證 Lumos-Nexus 的推理影片效果,可進入 Lumos-Nexus/ 跟隨 README 取得 OmniVideo 權重並跑批次推論;想評測打光則可參考 UniLumos 提供的流程。

✧ Repository layout ✧

Lumos-Custom/
├── README.md                 # This file: umbrella overview
├── LumosX/                   # ICLR 2026 · personalized multi-subject video generation
│   └── README.md
├── UniLumos/                 # NeurIPS 2025 · unified relighting + LumosBench/
│   ├── README.md
│   └── LumosBench/
└── Lumos-Nexus/              # arXiv preprint · reasoning-driven unified video generation + VR-Bench
    ├── README.md
    └── vr_bench_eval/

GitHub: https://github.com/alibaba-damo-academy/Lumos-Custom

項目: https://jiazheng-xing.github.io/nexus-lumos-home/

Categories: 開源, 香港科技大學, 清華大學, 阿里巴巴, 視頻模型, 影像模型

minWM:由影片生成走向 World Model

minWM不是單一模型,而是一套由資料到推理的 World Model 框架。它特別照顧初學者,也兼顧研究與改造彈性。

Repository image for shengshu-ai/minWM

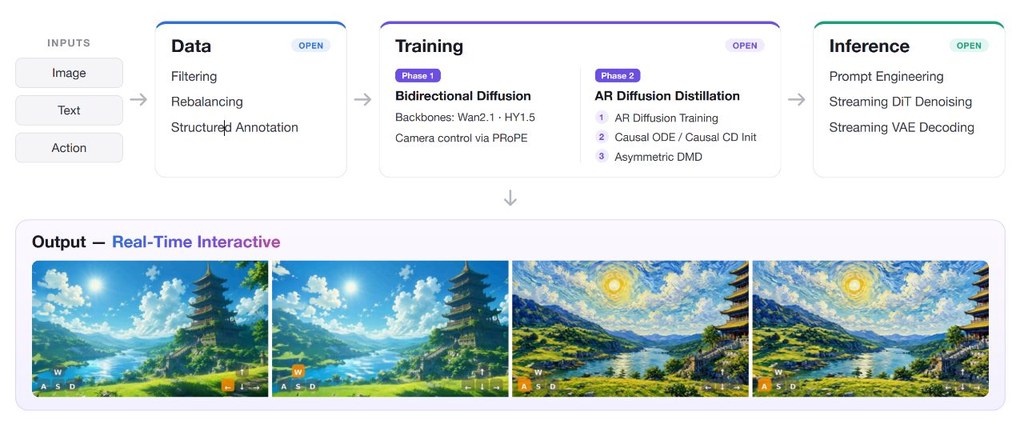
minWM 的定位很清楚:它不是再提供一個新模型,而是把建立 video world model 的整條流程拆開,讓人由 bidirectional T2V(Text-to-Video)或 TI2V(Text-and-Image-to-Video)基礎模型,一步步轉成 action-conditioned video world model。對剛接觸這個領域的人來說,這種完整路線比只放權重或單段程式碼更有幫助。

這項目重點不是「裝完即用」,而是按它提供的資料處理、訓練、蒸餾與推理流程逐段走。項目公開了 data → training → inference 的全流程,並提供 example data、runnable scripts、Claude Skills 與新手知識整理,方便你先跟一次標準流程,再按自己需要改 backbone、資料分佈或控制方式。

它要解決的問題,在於高質影片生成模型未必等同可互動的 world model。要做到低延遲、可因果 rollout、可回應鏡頭軌跡等操作,背後需要 camera control、autoregressive training、few-step distillation 及 streaming inference 等整套機制;minWM 正是把這些環節模組化,並用 Causal Forcing、Causal Forcing++、Teacher Forcing 與 asymmetric DMD 串連起來。

  • 支援 4-step DMD inference,並提到 multi-GPU sequence parallelism
  • 可用 pose strings 或 JSON 檔控制 camera trajectory
  • 提供 debug-world-model,整理 loss NaN、jitter、camera drift 等常見失敗模式
  • 提供 integrate-new-backbone,示範怎樣接入新的 video DiT
  • 參考 backbone 包括 Wan2.1-T2V-1.3B、HY1.5-TI2V-8B,亦提到 HY Action2V、HY TI2V、Wan Action2V

項目的新意在於它同時處理「怎樣訓練」與「怎樣改造」。除了支援不同 backbone 與 condition injection 方式,也把團隊累積的排錯經驗與 Claude 協作流程寫進項目,令研究者或工程人員不只看到結果,還能理解常見錯誤從哪裡出現。

它的目標是 real-time interactive video world models,並附有對 camera trajectory quality、controllability training steps、minimal batch-size requirements 的實驗分析。不過公開資訊較偏向框架與流程,若你想比較單一模型跑分,這個項目更適合當作建立、重現及擴展 World Model 的工作底座。

GitHub: https://github.com/shengshu-ai/minWM

Categories: 開源, 香港科技大學, Agentic, 模型, 視覺模型, 視頻模型, 世界模型, 模型訓練, 影像模型, 影像處理, 框架

EvalVerse 評估電影畫面美感、演出、鏡頭語言評測

EvalVerse 用專家標註重整生成影片評測。它由「是否正確」走向「是否夠好看」。

Hero image preview

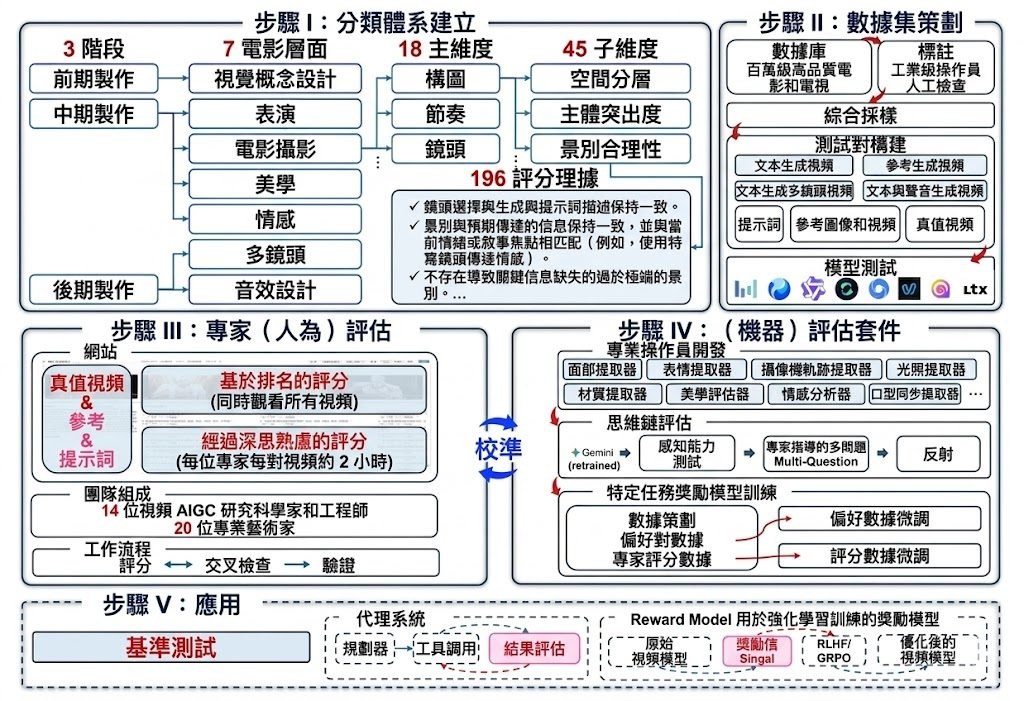
EvalVerse 是一個用來評估電影感生成影片的項目,重點不只看結果是否跟提示詞相符,亦會檢查畫面美感、演出、鏡頭語言和聲畫配合。對近年愈來愈多生成影片項目來說,它補上了「生成得對」與「生成得好」之間的落差。

EvalVerse 會先按電影製作流程理解評分架構,再用提示詞、參考圖或參考影片建立測試組合,之後配合人工標註與機器評估比較結果。論文把指標拆成前期、拍攝、後期三個階段,覆蓋 7 個面向、18 個主維度、45 個子維度和 196 條判準。

評分更細:不只看是否跟題,亦會看構圖、鏡頭大小、節奏、表演與聲音設計。
覆蓋更廣:支援文字生成影片、參考生成影片、多鏡頭影片及帶聲音影片。
可信度更高:加入大規模人工標註,再用專家判斷校準 VLM,縮窄機器評分與人眼感受差距。
用途更實際:除了排名,亦能提供診斷訊號,方便後續調整模型、獎勵模型或評估代理。

這項目特別適合做生成影片模型、影片工作流程工具或品質評測的人參考;如果你想比較不同系統,它也比單純看排行榜更有資訊量。論文重點在評估方法和資料整理,未見大量公開的生成表現數字,所以較適合作為評測基建,而不是單一分數工具。

EvalVerse 主要使用兩類模型:生成影片基礎模型,以及 Vision-Language Models(VLMs)。後者在這個項目中負責吸收專家評分經驗,作為機器評估的核心。

Paper: https://arxiv.org/pdf/2605.23271

Categories: 香港中文大學, 香港科技大學

LatentOmni 想重寫影音推理方式

這個項目嘗試讓模型不只靠文字思考,而是直接結合聲音與畫面推理。對複雜影音理解來說,方向相當值得留意。

LatentOmni

LatentOmni 是一個面向影音多模態大語言模型的研究項目,重點不是叫模型先把線索全都翻成文字再慢慢推理,而是讓聲音與畫面的資訊在同一個潛在空間內一起運作。簡單講,它想保留更多原始感官訊號,減少中途只靠語言猜答案的情況。

這個方向要解決的問題很明確:不少模型在看影片、聽聲音後,雖然能描述內容,但一遇到需要同時對齊時間、事件因果或細節關聯的題目,表現便會下跌。LatentOmni 提出的做法,是把文字推理流程與影音潛在狀態交錯進行,並用 OSPE 這類時間同步設計,幫助模型對準聲畫節奏。

從使用角度看,現時這個 GitHub 儲存庫仍以論文與概念介紹為主,訓練程式、推論程式、模型權重和資料集尚未正式釋出。因此較適合先拿來了解新一代多模態推理方法,或者作為研究與技術評估的參考,而不是立即部署到產品流程。

  • 核心亮點是統一聲音與畫面的潛在推理,而非只輸出文字式思路
  • 加入特徵層級監督與 OSPE,目標是保留時間對齊與跨模態關聯
  • 配套資料集為 LatentOmni-Instruct-35K,用來訓練交錯式影音推理軌跡
  • 論文指出它在多個影音推理基準上,表現優於明確文字 CoT 基線

整體來看,這個項目最吸引之處,是它把「模型怎樣思考」由文字中介,推前到更接近原始聲畫訊號的層面。適合關注 MLLM、影音理解、跨模態推理的人留意;若你想比較相關模型,也可把它與依賴文字 CoT 的開源多模態模型放在同一條線上觀察。不過現階段公開內容有限,性能細節仍應以論文報告為準,評估時要保持審慎。

GitHub: https://github.com/yfanDai/LatentOmni

Paper: https://arxiv.org/pdf/2605.22012

Categories: 開源, 香港科技大學, 北京大學, 清華大學, 模型, 視覺模型, 影像處理, 聲效, 中國

Artifact-Bench:幫你看穿 AI 影片破綻

這個項目不只問模型看懂影片內容,還進一步測試它能否分辨 AI 生成影片的細微破綻。對研究影片真實感判斷尤其有參考價值。

teaser

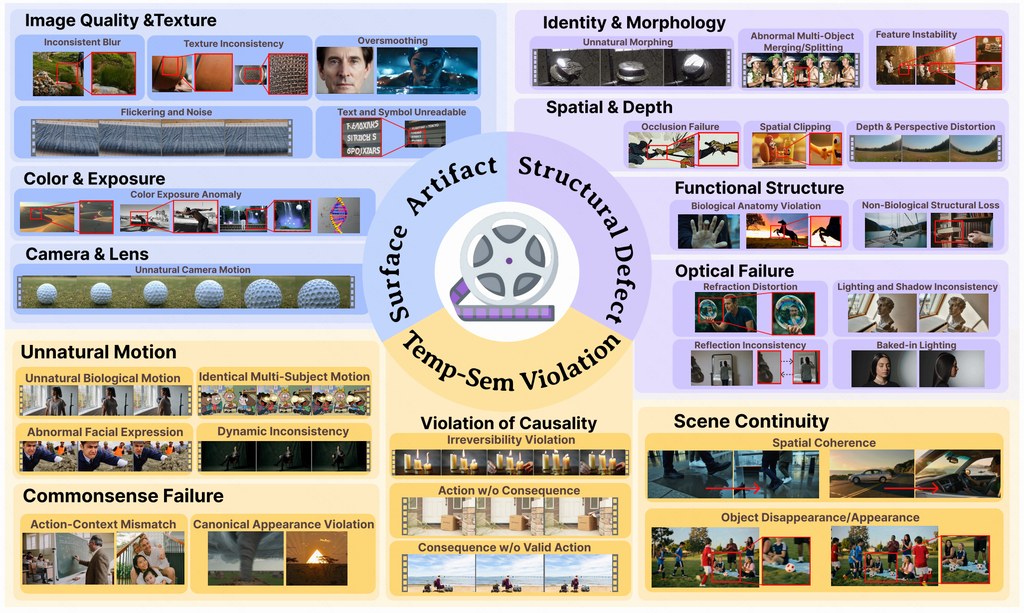
近年 AI 生成影片愈來愈像真,但「似真」不等於毫無破綻。Artifact-Bench 這個項目,重點就是評估多模態大語言模型是否真的看得出 AI 影片中的不自然痕跡,而不只是大概明白畫面講甚麼。

它把測試分成三類:分辨真影片與 AI 影片、比較兩段影片哪段更真實,以及指出影片中可能出現的瑕疵位置或類型。這種設計比一般只看語意理解的評測更細緻,因為它直接針對「真實感」與「畫面破綻」做分析。

動手使用這個項目時,先要準備對應的影片資料集,再按照三個任務的 metadata 檔組織輸入。儲存庫亦提供了針對 Qwen3-VL 的評估流程,並支援選擇指定任務、控制輸出長度,以及用多張 GPU 分工推理,對需要批量測試模型的人較方便。

  • 重點不在影片內容摘要,而在辨認 AI 生成痕跡
  • 包含三種評測角度,覆蓋分類、比較與瑕疵辨識
  • 已提供任務 metadata,較容易整理測試流程
  • 內建 Qwen3-VL 評估管線,亦可作為其他模型的參考框架

這個項目特別適合做影片生成、模型評測、內容審核與研究真實感判斷的人參考。從儲存庫資訊可見,現成流程主要圍繞 Qwen3-VL;相關模型範疇則可延伸到多模態大語言模型,例如不同尺寸或版本的 Qwen3-VL。若你關心模型是否只是「識圖識片」,還是真的能講出哪裡假,這個項目有相當清晰的測試價值。

GitHub: https://github.com/FrankYang-17/Artifact-Bench

Categories: 開源, 香港科技大學, 框架

KVPO 點樣提升影片生成對齊

KVPO聚焦自動回歸影片生成訓練,嘗試令結果更貼近提示內容。重點在於用分支探索加獎勵學習,改善畫面走向。

KVPO

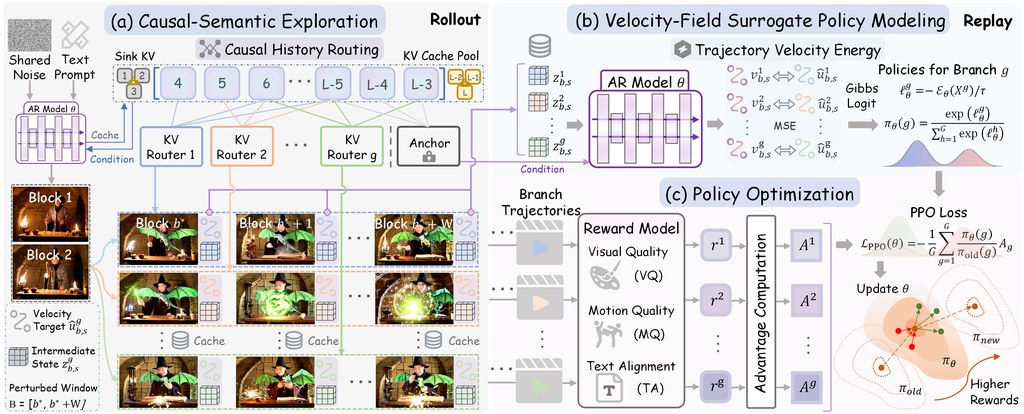
KVPO 係一個針對影片生成訓練流程嘅研究型專案,焦點唔係單純「生成到片」,而係令模型喺逐格、逐段生成嘅過程中,更穩定咁貼近文字提示同預期內容。對一般讀者嚟講,可以理解成:佢想改善 AI 影片成日出現嘅「開頭啱、之後走樣」問題。

呢個方法特別之處,在於佢唔只睇最後條影片好唔好,而係會喺生成途中做多條候選路線探索,再用獎勵模型判斷邊條路線更值得學。README 提到佢結合咗類似 PPO 嘅強化學習更新,以及對生成軌跡嘅機率估計,目標係令自動回歸影片模型學得更準。

實際了解同試用呢個專案,會由查看論文、專案頁面同釋出權重開始,再按設定準備對應環境、模型權重同資料。由於文件列出咗 H200、CUDA 12.8、Wan2.1 backbone,以及 HPSv3、VideoReward 等元件,較適合已有 GPU 資源、熟悉深度學習訓練流程嘅讀者,而唔係即開即用型工具。

  • 主要處理影片生成中內容偏離提示、時間一致性變差等問題
  • 核心做法係先探索多個生成分支,再用獎勵分數引導學習
  • 研究重點放喺自動回歸影片模型,而唔係一般圖片生成
  • 文件顯示會配合 Wan2.1-T2V-1.3B 等 backbone 使用
  • 仲會涉及 HPSv3VideoReward 呢類評分或獎勵相關模型

整體而言,KVPO 比較適合關注影片生成訓練方法嘅研究者、工程師,或者想比較唔同對齊策略嘅團隊。對非技術用家,佢未必係直接拎嚟出片嘅方案;但作為觀察新一代影片模型點樣「學識跟指令」嘅方向,呢個專案幾有參考價值。

GitHub: https://github.com/Richard-Zhang-AI/KVPO

Paper: https://arxiv.org/pdf/2605.14278

Categories: 開源, 香港科技大學, 清華大學, 影像模型, 影像處理

CM-EVS:用更少視角看完整個場景

CM-EVS 用較少全景畫面覆蓋更多室內場景,重點在挑選視角而非盲目多拍。對做 3D 資料整理的人特別實用。

Repository image for Strange-animalss/CM-EVS

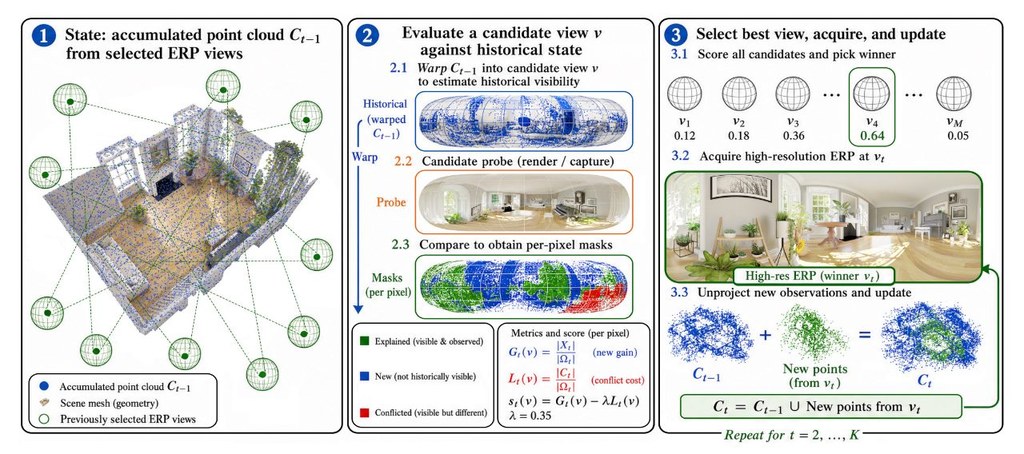
CM-EVS 係一個為 3D 場景整理全景 RGB、深度同姿態資料嘅流程工具,重點唔係不停輸出更多畫面,而係用較少但更有代表性嘅視角,盡量覆蓋完整場景。對需要建立訓練資料、檢查場景覆蓋度,或者整理室內空間視圖嘅工作,方向相當清晰。

實際使用時,較穩陣嘅做法係先由 Blender 室內場景路線開始,之後再按需要接 HM3D、一般 GLB 或 ScanNet++ PLY 這類來源。流程大致分成三步:先產生候選視角,再從中揀選衝突較低嘅視角組合,最後輸出已選畫面與相關記錄,方便重現結果同做後續核對。

呢個專案特別之處,在於佢唔單止計算「邊個視角睇到最多」,仲會考慮視角之間是否過分重疊,避免揀出一堆內容相似嘅畫面。對建立稀疏但有效嘅資料集尤其重要,因為畫面數量少啲,後續儲存、檢查同訓練成本通常都更易控制。

  • 支援統一資料格式,涵蓋 ERP RGB、range-depth 同 pose
  • 可處理多種來源,包括 Blender、HM3D/GLB、ScanNet++/PLY
  • 會輸出候選視角、逐步紀錄同已選結果,方便重做與比對
  • 核心模組拆分得較細,例如投影、深度與變形部分可獨立替換

適合對象包括做 3D 視覺、機械人感知、場景重建,或者要整理研究資料集嘅團隊。文中提到嘅相關資料來源與場景類型,主要有 Blender indoor、HM3D、generic GLB、ScanNet++,亦提及可延伸到戶外來源;不過從公開資訊睇,Blender 室內路線仍然係最建議先試嘅入口。

GitHub: https://github.com/Strange-animalss/CM-EVS

Paper: https://arxiv.org/pdf/2605.15597

Categories: 開源, 香港科技大學, 影像處理, 中國

Page 4 of 6
1 2 3 4 5 6