GTR 以循環架構壓低高解像度視覺推理成本

GTR 以無 softmax 的循環式視覺骨幹處理多種密集預測,在速度與精度之間尋找更實用的平衡。

teaser

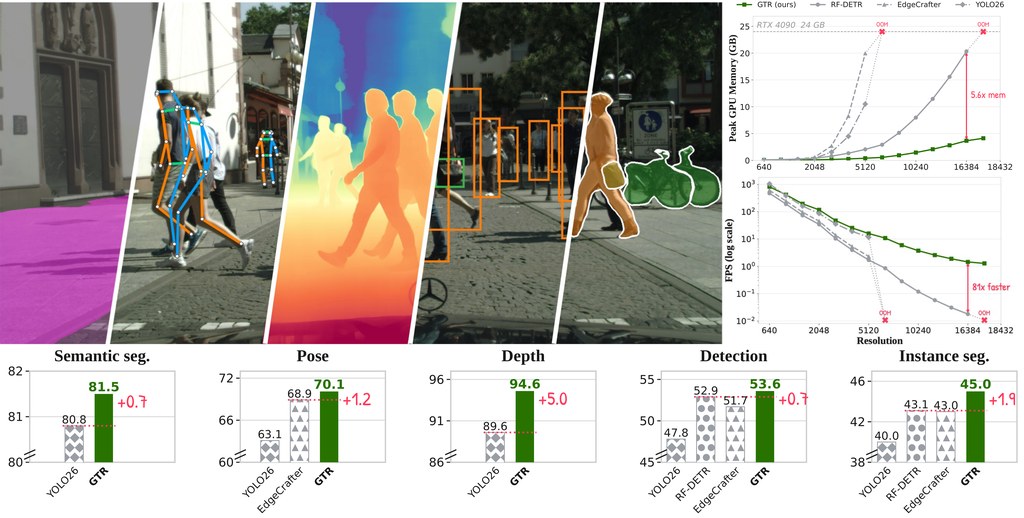
高解像度影像令全域 softmax attention 的計算量隨 token 數量平方增加,GTR 以無 softmax 的循環式視覺骨幹處理這個瓶頸,支援物件偵測、分割、姿態、深度及定向偵測。它屬於視覺模型,實際解決同一組影像特徵如何兼顧多種密集預測任務與推理速度。

GTR 由 12 層 Gated Linear Attention(GLA)組成,每層輪換二維掃描方向,再配合加入 3×3 depthwise convolution 的 Spatial SwiGLU,補足鄰近 patch token 的局部資訊。模型以 stride-16 單尺度特徵圖運作,並透過輕量三尺度 projector 和 query-based head 輸出不同任務所需結果。

  • 以單次平方 L2 loss,將學生模型最終 patch token 對齊 detection-specialized DINOv3 teacher
  • 同一個 GTR backbone 支援六類密集預測任務
  • RTX 4090、FP16、batch 1 下,GTR-L 達到 58.9 COCO box AP,median forward pass 為 1.908 ms
  • 提供 chunkwise CUDA operator,亦支援 TensorRT 部署到 DRIVE AGX Thor

倉庫包含環境準備、資料處理、訓練、評估、推理及 TensorRT 部署流程,適合研究高效視覺骨幹、車載感知或需要多任務共用模型的團隊。代價是 CUDA 專用算子及編譯流程提高了硬件依賴;官方延遲數字來自 RTX 4090 或 DRIVE AGX Thor 的特定設定,換用其他裝置時仍需重新量度。
項目主頁 · GitHub

Categories: 開源, 香港科技大學, 模型, 視覺模型, 模型訓練, NVIDIA, Image, 香港, 庫

WorldLine 讓機械人先看見動作後果

WorldLine 把機械人動作轉成影像及空間訊號,預測場景如何變化,再協助評估策略及規劃操作。

Repository image for Zhengsh123/WorldLine

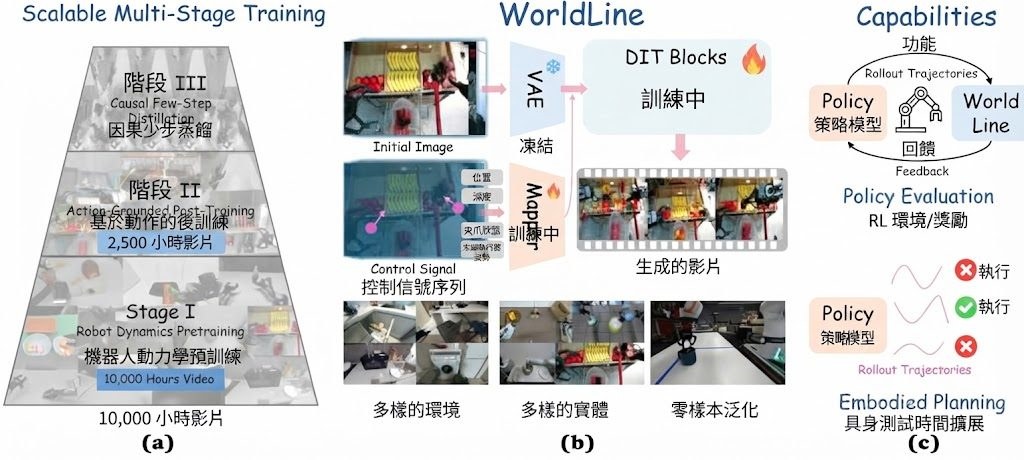
機械人要搬動物件前,WorldLine 可以先在視覺模擬中預測動作會如何改變場景,減少每次都依賴實體試錯。它屬於面向機械人操作的世界模型及視覺模擬器,處理的是「控制指令如何造成可觀察結果」這個核心問題,而不是按照任務文字生成畫面。

WorldLine 先用超過10,000小時的無動作標註機械人影片學習機械人與物件的互動,再把末端執行器的位置、深度、方向及夾爪狀態投影到經校準的相機視角。這些 image-space actions 成為不同機械人之間的共同介面;另外超過2,000小時、涵蓋10多種 embodiments 的動作軌跡,負責把通用 dynamics 對應到個別控制方式。

WorldLine 把 action grounding 分開處理,較有利於跨機械人及跨鏡頭遷移,代價是需要校準相機、動作軌跡及失敗案例。模型以 block-autoregressive 方式因果 rollout,每個區塊用四步 denoising 生成,兼顧互動速度與預測細節,但不代表能取代真實環境驗證。

  • 用於 policy evaluation、embodied planning 及實體操作前的預測
  • 以 image-space action 統一不同機械人的視覺控制介面
  • 透過 multi-view、failure-enriched training 及 relational regularization 強化互動敏感度
  • 以 few-step distillation 減少 rollout 所需計算

研究團隊包括香港科技大學、Joy Future Academy、北京大學及香港中文大學。較適合研究機械人學習、視覺規劃及模擬器的團隊先按程式碼建立推理環境,再以不同 camera view、embodiment 和失敗動作測試預測穩定性;需要即時控制的人員則應同時量度延遲、動作偏差及真實機械人的遷移落差。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, 北京大學, AI productions, 模型, 視覺模型, 世界模型, 模型訓練, Video, Image, 香港, Dataset 數據集

RULER 讓 SVG 生成更貼近人類判斷的評分

生成SVG時,圖像看似相似,未必代表指令已經做到。RULER用逐項評分改善模型訓練,毋須配對的標準圖像或人工偏好標籤。

RULER-generated eye icon with eyelashes and a blue iris

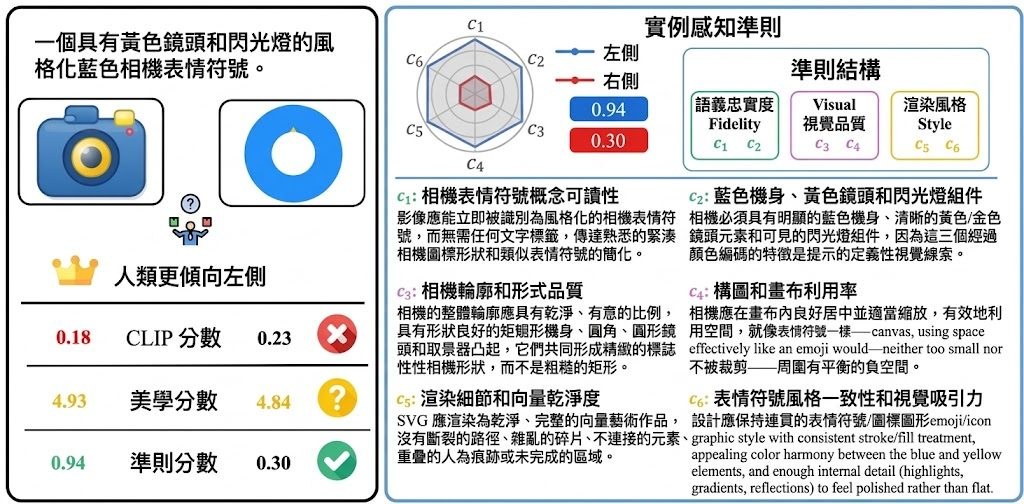
想把「畫一個指向東北的指南針」轉成SVG,模型要同時掌握主體、方向和風格;但這類開放式生成通常沒有唯一正確圖像,傳統分數未必能指出作品究竟錯在哪裏。RULER是一套用於SVG生成評估及強化學習訓練的方法,嘗試把籠統分數拆成可逐項檢查的要求。

它會只根據文字指令,為每個生成任務建立六項評分準則,涵蓋語意、視覺和風格,再由視覺語言模型評分渲染後的作品。各項得分按權重合成較細緻的獎勵,供 Group Relative Policy Optimization(GRPO)優化模型;整個流程不需要配對SVG標準答案或人工偏好標籤。

這種做法針對的是CLIP、Aesthetic等單一分數難以判斷SVG細節,也可能令強化學習模型迎合分數、產生 reward hacking 的問題。研究團隊表示,多軸評分比單一指標更貼近人類判斷;在MMSVG-Illustration和MMSVG-Icon上,rubric分數分別由0.432升至0.693,以及由0.395升至0.683,並超越專門SVG模型,表現可媲美規模大得多的DeepSeek-V3。

  • 每條指令會生成專屬評分準則,而非所有作品共用一把分數尺。
  • 評分同時檢查語意、視覺和風格,獎勵可用於GRPO訓練。
  • 不需要標準SVG圖像或人工偏好標籤,適合缺少標註資料的生成項目。
  • 評測結果顯示評分準則的設計是提升開放式SVG生成的重要因素。

項目主頁

Categories: 香港科技大學, Image, 提示詞, 香港

OST:可撤回串流推理的「過早下結論」

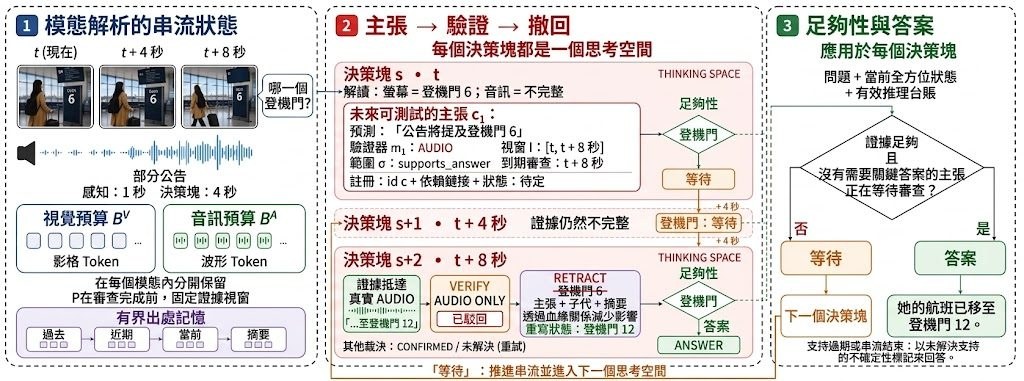
香港大學與香港科大(廣州)團隊開源 Omni-Streaming Thinking(OST)針對解決串流影音推理中視覺先到、聲音後到的錯位問題。

Repository image for EnjunDu/OST

看串流影片做即時推理,最常見的卡位是視覺線索先到位、聲音事件卻還在展開——模型若把視覺猜測當成事實寫進記憶,後續聲音即使推翻它,舊結論仍可能一路延續下去。OST 正是針對這個「提早跨模態承諾」的失敗模式設計:每一個未解的詮釋都被記成一條 claim,附帶預期事件、指定驗證模態、證據到期時段,以及依賴它的狀態;期限一到就用對應模態的證據覆核,被推翻時連帶下修相關狀態,再由引導式解碼產出修正後的回應。

OST 以凍結的骨幹模型為基礎,所有新增的部分都是 adapter、soft prompt 或輕量 head,骨幹參數完全不會被改動。聲音與視覺各自有獨立的保留緩衝區與配額,避免高密度的視覺 token 把聲音擠出記憶;舊狀態以四向折疊收進金字塔結構,讓推理上下文維持在有界範圍內。回答閘門則會延遲輸出,直到所有影響答案的 claim 都完成覆核。

適合研究串流多模態推理、想重播或審視 claim–verify–retract 循環的團隊,會比較容易從中受益。程式碼只涵蓋推論與執行記錄,不包含訓練、評測 harness 或診斷 benchmark。

重點摘要:

  • 類型:串流影音推理的推論實作,骨幹凍結,僅加掛 adapter 與 head。
  • 核心機制:claim–verify–retract,未確認詮釋附帶驗證模態與到期時段。
  • 記憶設計:聲音與視覺分開配額,舊狀態四向折疊維持上下文有界。
  • 輸出控制:answer gate 會等到關鍵 claim 覆核完成才放行。
  • 範圍限制:僅推論,不含訓練、評測 harness 與 OST-DiagBench 資料集。

項目主頁 · GitHub · 數據集

Categories: 開源, 香港大學, 香港科技大學, Agentic, AI productions, 模型, 多模態模型, 模型訓練, Video, Audio, 香港, Dataset 數據集

YuE2 用樂譜做中介 把 AI 寫歌變成可改寫的工序

由香港科大 M·A·P 團隊推出的 YuE2,把歌詞與風格提示先轉成旋律與和弦樂譜,再渲染成完整歌曲。比起直接端出成品的做法,這條路線讓編曲、翻唱與代理編輯都變得可介入。

YuE

AI 寫歌工具多數只給你一首成品,YuE2 想處理的是另一個問題:怎樣讓生成過程本身可被人讀懂和修改。M·A·P 與港科大的團隊把流程拆成兩步,先用歌詞加風格提示寫出一份旋律與和弦計劃,再用同一個模型把樂譜變成帶人聲與伴奏的完整歌曲。

Melody 和 chord 不再藏在黑盒裡,而是可以預覽、試播,甚至交給人或 AI 代理去修改。這意味著同一個 checkpoint 可以同時做三件事:從零寫歌、把一段錄音轉成新風格的翻唱、以及透過對話逐步修編曲與歌詞。零樣本翻唱與代理式編輯不再需要切換不同模型。

當多數音樂生成模型只能交出一條「不能再拆」的音檔時,YuE2 走出了一條比較少見的路:它先把歌詞和風格提示轉成一份明確的樂譜與和弦藍圖,再用那份藍圖去唱出完整歌曲。等於把創作流程切成「規劃」和「演奏」兩段,而那份中間的樂譜本身就是可讀、可播、可改的物件,創作者或 AI 代理都能直接在上面動手。

开源翻唱音乐模型-YuE2:你的专业程度=模型上限,没有suno的各种限制。演示《Butterfly》。
YuE2 in ComfyUI: AI Music with an Editable Piano Roll

衡量歌曲品質的 WildSongBench 上,YuE2 best-of-8 取得 6.9632 平均分,是目前該榜觀察到的最高均值,並在多個面向與 Suno v5/v6 拉成均勢。它不只追求像 Suno,而是把 Suno 做不到的那一步:讓成品背後的樂譜可被檢視與修改,當作核心能力。

獨立音樂人、編曲助理、以及想把 AI 寫歌串進更長工作流的開發者,都是比較直接的使用者。代理式編輯對於要快速試不同編曲方向、需要保留人聲或旋律骨幹再重做風格的場景特別有用。

重點摘要

  • 先樂譜後音效:歌詞與風格提示先產出 melody 與 chord 計劃,再渲染成完整歌曲
  • WildSongBench 最佳均值:YuE2 best-of-8 取得 6.9632 分,與 Suno v5/v6 在多個面向拉成均勢
  • White-box 控制:樂譜可預覽、可試播、可交由人或代理修改
  • 零樣本翻唱:同一個 checkpoint 支援把轉錄樂譜換成新風格詮釋
  • 代理式編輯:可用對話方式逐步修編曲、歌詞與編排

入門方面,項目提供 Hugging Face 上的 YuE2-3B 權重、Demos 頁面,以及 Discord 社群。舊版 YuE 的程式碼與授權保留在 YuE-v1 分支,方便比對兩代做法差異。

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 模型, 多模態模型, 工具, 音樂, 廣東話

Mask Forcing:雙重遮罩幫影片擴散模型

Mask Forcing 針對自回歸影片擴散蒸餾中嘅模式塌縮問題,利用雙重雜訊遮罩嘅 rollout 策略,令學生模型分佈覆蓋更多教師模式,同時唔使額外影片資料或後訓練。

Mask Forcing pipeline

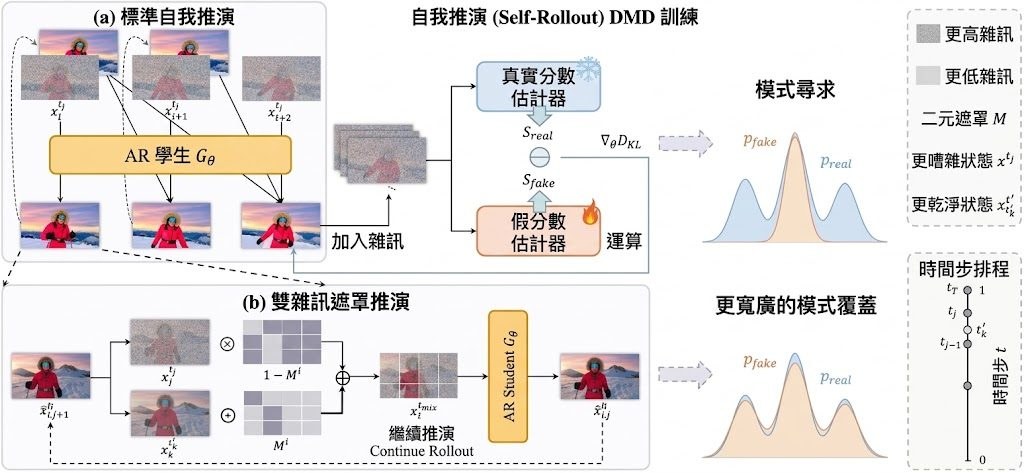
用 DMD(Distribution Matching Distillation)把雙向影片擴散模型蒸餾成自回歸(AR)學生模型時,影片往往出現過度飽和同過度平滑嘅情況,背後成因係 reverse-KL 目標嘅 mode-seeking 傾向,令學生分佈容易塌縮到教師模型嘅少數模式之上。Mask Forcing 嘅切入點正正係呢個矛盾:佢喺 AR 蒸餾嘅 self-rollout 過程中,沿空間同時間軸隨機遮罩、注入較乾淨嘅 token,藉此擾動 rollout 軌跡,令學生有機會探索教師分佈嘅更多區域。

呢個做法同時帶來兩個好處:擾動令 DMD 嘅學習訊號唔再局限於學生已經覆蓋嘅模式;而較乾淨嘅 token 亦可以作為引導,協助同一 chunk 入面較嘈雜嘅 token 去噪,等中間過渡更穩定,從而減少錯誤喺後續 denoising step 同 chunk 之間累積。整個方法唔需要真實影片監督、唔需要額外後訓練階段,亦唔會增加推論成本,純粹改動訓練期嘅 rollout。

Mask Forcing 屬於一種蒸餾增強策略,主要服務於想把 AR 影片生成做快、但又想避開 DMD 視覺質素下降嘅團隊,例如做實時或近實時影片生成嘅研究同產品線。佢同一般做法嘅取捨清晰:放棄模式集中所帶來嘅短期穩定,換取分佈多樣性同中間步預測嘅可靠性。

  • 針對 AR 影片擴散蒸餾中 DMD 嘅 mode-seeking 問題,用雙重雜訊遮罩擾動 rollout
  • 不需真實影片監督或額外後訓練階段,唔改動推論流程
  • 令學生分佈覆蓋更多教師模式,並以較乾淨 token 引導較嘈雜 token 去噪
  • 適用於追求實時影片生成、又想提升視覺質素嘅研究同產品場景

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 模型, 模型訓練, Video, 影像模型

SolarWM 開放視頻世界模型全流程基建

SolarWM 不只公開模型權重,連數據處理、訓練流程和長時推理方法一併開放,目標是降低互動式視頻世界模型的研究門檻。

SolarWM teaser: one framework for diverse interactive worlds

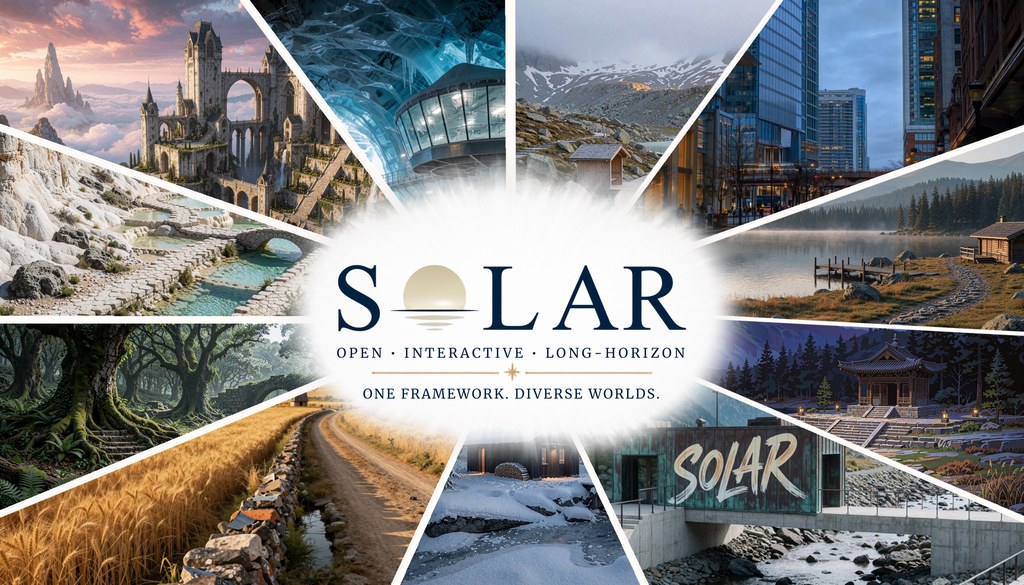
從數秒訓練片段推演出長達數分鐘甚至更長時間的互動視頻,一直是世界模型(World Model)發展中的難題。SolarWM 把焦點放在整個研發鏈條,而不只是單一模型,結合開放數據管線、訓練框架與推理流程,形成一個面向互動式視頻世界模型的完整研究基礎設施。

項目屬於世界模型訓練框架與開放研究基建,處理的問題是如何把不同來源的視頻資料整理成一致格式,並在不同模型骨幹之間建立可擴展的長時推理能力。團隊將來自 14 個資料集、約 143 萬段影片統一整理,讓資料準備與訓練配方可以分離,研究人員毋須重複建立資料處理流程。

與許多只圍繞單一架構設計的方法不同,SolarWM 強調保留原生骨幹能力,同時支援 Wan2.2、LTX-2.5 與 MiniMax-H3 等不同模型家族,涵蓋 5B 至 33B 規模。研究團隊提出三階段訓練流程,包括雙向適應、結合 AnyFlow 的教師強制訓練,以及長時互動推理策略,希望在不依賴超長訓練影片的情況下維持世界演化一致性。

  • 開放釋出資料處理管線、資料集及模型權重
  • 支援多個主流視頻生成骨幹,而非綁定單一架構
  • 利用約五秒片段訓練,目標達成分鐘級甚至小時級推理
  • 涵蓋 143 萬段影片與約 25TB 數據規模
  • 提供可重組資料配方與不同訓練策略組合

適合世界模型研究團隊、互動式模擬系統開發者,以及探索 World-Action Model 與長時視頻生成的學術機構。SolarWM 的價值不只在單次生成效果,而在於把過往難以重現的資料處理和訓練步驟公開,讓不同研究單位更容易比較方法與建立可重複驗證的實驗流程。長時間推理的一致性仍有待更多公開基準驗證,但這套框架已經把世界模型研究由單一模型競賽推向完整基礎設施層面。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, 世界模型, 模型訓練, NVIDIA, World-Action Model, 3D, LTX, Dataset 數據集, MiniMax

DiffusionOPSD:將自我蒸餾影像獎勵轉為可更新訓練目標

DiffusionOPSD 將影像級獎勵轉成可反覆更新的中間目標,補上 diffusion 訓練中間步驟的監督空白。它適合想在有限訓練預算下,改良生成質素同可診斷性的團隊。

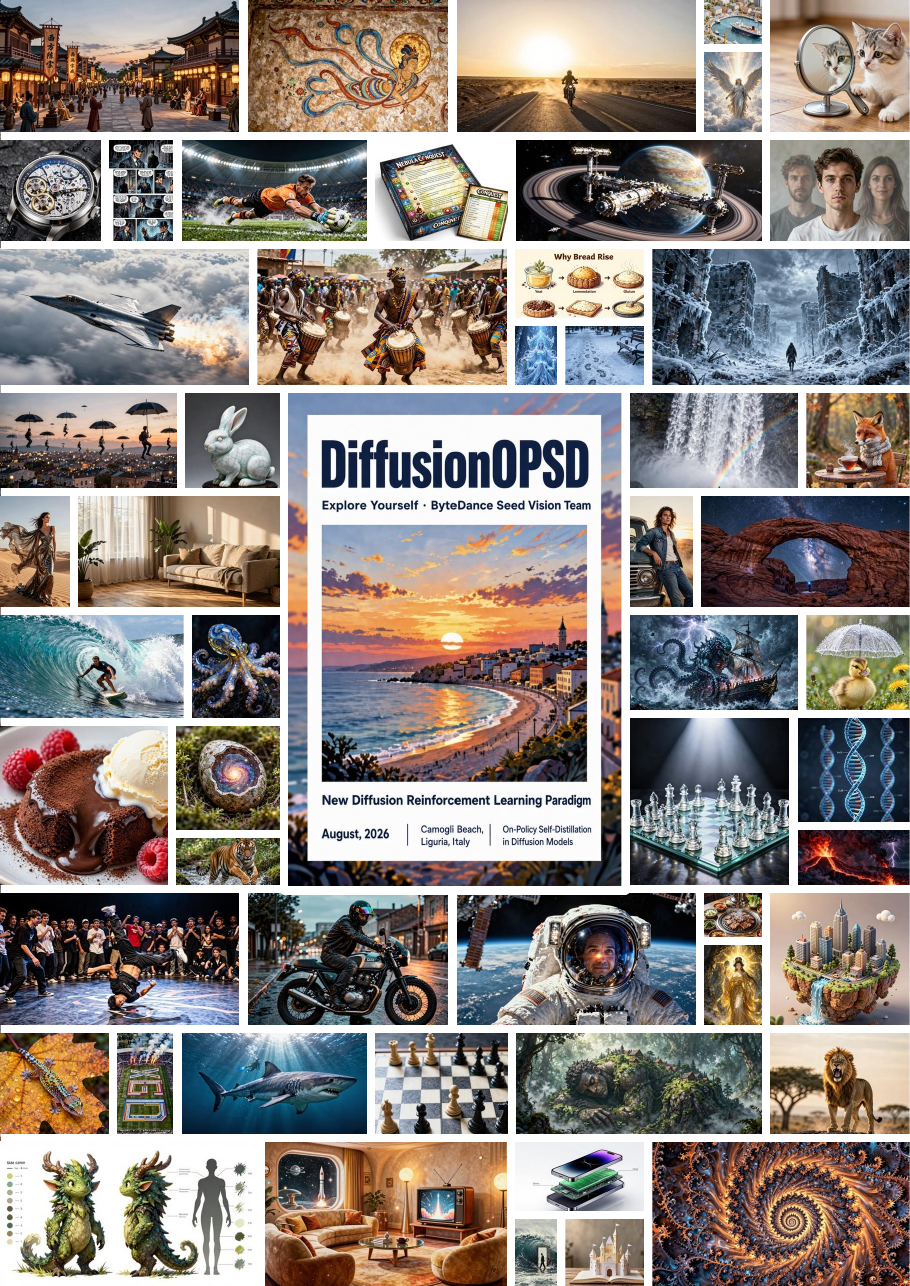
DiffusionOPSD qualitative gallery

DiffusionOPSD(ByteDance Seed) 主攻的是 diffusion 模型後訓練時,只有最終圖片分數、欠缺中間步驟指引的問題。它屬於一套用於模型後訓練的開源方法,透過 on-policy self-distillation,把影像級 reward 轉成可直接學習的中間目標。

它的做法不是單純追分,而是先用凍結的 behavior policy 收集低噪聲查詢狀態,再用 reward gradient 建出正負兩種 bounded target,最後由可訓練 policy 去擬合這些切斷計算圖的目標。這種安排把目標品質和模型更新分開處理,亦令 supervision 可以隨住模型演化持續刷新。

實作層面,公開版本支援 SD3.5-M 512²,同時覆蓋原生 few-step 的 Z-Image-Turbo 1024² 設定;文件亦提到可做單一 reward 或多個 reward 的加權訓練。原文未提供完整安裝流程或逐步使用指引,只能確認它有項目頁與程式碼釋出,適合自行拉取後依研究環境配置。

它和同類 diffusion reward optimization 的主要分別,在於用 on-policy 查詢配合 EMA 持續重建 supervision,而不是只依賴離線或固定噪聲替代狀態。官方結果聲稱在多個 evaluator 與兩種 backbone 上都有較強的最終 held-out 表現,亦以較少 GPU-hours 完成訓練;這令它特別適合做生成模型後訓練、獎勵對齊與方法比較的研究團隊。

  • 將 image-level reward 轉成可學習的中間目標
  • 用 EMA 反覆刷新 trajectory、anchor 與 target
  • 支援 SD3.5-M 與 Z-Image-Turbo 兩種 backbone
  • 可做單一 reward,亦可做多 reward 加權
  • 適合研究 diffusion 後訓練同 reward alignment 的團隊

項目主頁 · GitHub · 模型

Categories: 開源, 香港科技大學, 字節跳動, 模型訓練, Image, 影像處理, txt2img, 框架

GameXpert-Bench | Coding Agents for Game Development

騰訊團隊聯同多間院校提出 GameXpert-Bench,專門看 Coding Agents 能否做出、修好再優化可玩遊戲。它把生成、修復同多輪改進放入同一條流程去評估。

Og image

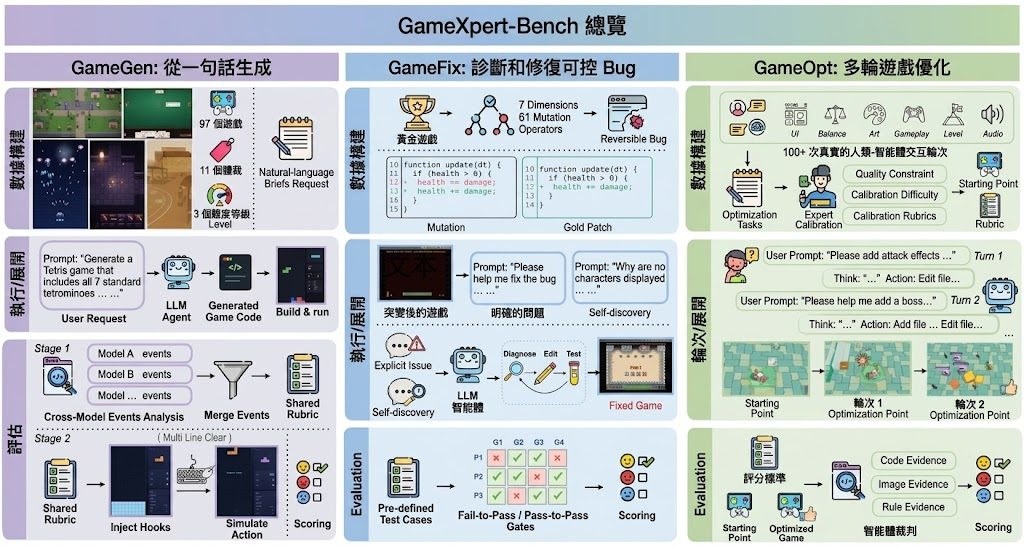
騰訊 Hunyuan Team、Lightspeed Studios,聯同 CASIA、清華大學、香港科技大學、香港中文大學深圳等團隊,提出 GameXpert-Bench,用來檢驗 Coding Agents 在遊戲開發上的真實能力。它不只看程式碼寫得像不像,還看能否真的做出可玩遊戲、找出錯誤,並在多輪修改後保持功能完整。

這個項目處理的是一個很實際的落差:很多代理可以生成看似合理的程式,但一到互動、畫面、音效、介面同可玩性要同時成立,就容易出問題。GameXpert-Bench 把整個生命週期拆成三條軌道,分別測首次生成、修復缺陷,以及連續優化,逼近真實開發流程。

  • GameGen 測試從零開始生成可玩遊戲,沒有預設引擎或素材
  • GameFix 測試對已知缺陷的診斷與修復,亦包括自行發現問題的情況
  • GameOpt 測試多輪改進時能否保住核心玩法與既有功能
  • 評估不只看程式,還結合互動行為、代碼檢查同人工判斷

目前公開資料提到共有 97 個生成任務、100 個修復任務,以及 17 條多輪優化鏈,涵蓋 2D 和 3D 遊戲。整體結果指向一個清楚結論:寫出看似合理的實作,比起交出經過驗證、又唔會在後續修改中壞掉的遊戲容易得多。

對做 Coding Agents、遊戲工具鏈、或研究 agentic software engineering 的讀者,這個基準特別有參考價值。它把「能寫」和「能交付」分開,令模型在真實工作流中的短板更容易被量度出來。

項目主頁

Categories: 香港中文大學, 香港科技大學, 清華大學, 騰訊, Agentic, Audio, 軟件, 3D, 編程, Dataset 數據集

Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

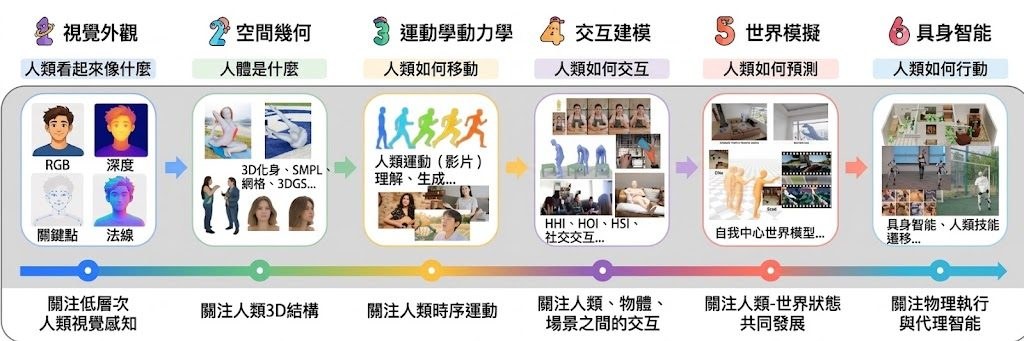
伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

Page 2 of 8
1 2 3 4 … 8