Human-Centric-AI:從人體觀察到具身代理

研究人本 AI 不再只靠零散論文搜尋,這個開源資源庫把分類、基礎設施與學習材料集中整理。

Human-Centric AI Resources logo

做人體分析、互動理解或具身智能研究時,最花時間的往往不是找到單篇論文,而是整理不同任務、模態與研究社群之間的關係。Human-Centric Artificial Intelligence(Human-Centric AI)Resources 屬於開源研究資源庫,配合《Human-Centric Intelligence in the Era of Foundation Models: A Survey》,集中處理人本 AI 的文獻探索、資料集與研究基礎設施整理問題。

資源庫並非可直接下載執行的模型或軟件,使用方式是瀏覽 GitHub 內容及項目首頁,按 Academic Knowledge、Research Infrastructure 和 Community Learning Hubs 等部分尋找材料。研究者亦可透過社群渠道提交或維護資源,因此內容會隨社群整理持續更新,但完整度和一致性仍取決於後續貢獻。

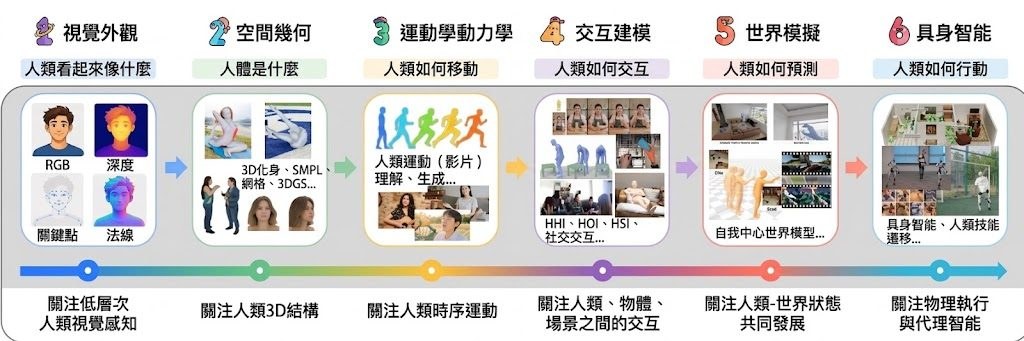
伴隨的 survey 以六層 human context taxonomy 串連研究脈絡,從可觀察的人體外觀與空間幾何,延伸至 dynamic actors 的動力學和互動建模,再到 situated agents、world simulation 與 embodied agency。它不會取代論文原有的實驗細節,價值在於把相關 datasets、benchmarks、evaluation metrics,以及 training 和 inference optimization strategies 放入同一個檢索框架。

  • 適合研究生和新加入領域的團隊:用作文獻導航及研究方向整理。
  • 適合做資料集或 benchmark 的研究者:較容易尋找相關評測資源。
  • 適合跨模態項目:協助連接視覺、動作、互動和具身智能研究。
  • 限制:它沒有提供可直接比較的 runtime performance,亦不是即裝即用的 AI 工具。

對需要建立研究地圖、設計 benchmark 或追蹤 foundation models 如何融入人本智能的讀者,GitHub 資源庫和 survey 應該一併閱讀;只想立即執行模型或測試 API 的使用者,則需要另找具體實作項目。
項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港理工大學, 北京大學, 阿里巴巴, Agentic, 模型訓練, API, 香港, 工具, Dataset 數據集

4DAnyone 把單鏡頭影片重建 4D 多視角

由一段普通單鏡頭人物影片開始,4DAnyone 生成具一致性的多視角影片,再交由 4DGS 重建可動人物。

4DAnyone

由未校準的 monocular video 出發,4DAnyone 可以為同一個人物生成多個目標視角,接着交給 4D Gaussian Splatting(4DGS)建立可渲染的 4D 人物。這個 GitHub 項目屬於 4D 人物重建工具,處理的是拍攝時沒有多部相機、相機內參或姿態資料,卻想取得多視角動態素材的問題。

它不只把畫面轉成另一個角度,而是嘗試維持不同視角之間的時間和外觀一致性,讓後續 4DGS 重建不必直接面對單鏡頭資料的視角缺口。相較於需要 rig、校準相機或固定三腳架的流程,這個方法換來的是對輸入影片質素和人物動作的依賴。

使用 inference.py 讀取影片,再以 views_per_layer、layer_pitches、start_yaw 和 yaw_span 控制相機層數、上下角度及水平覆蓋範圍。儲存庫提供 Python 3.11、requirements 和第三方 GVHMR 元件的安裝安排,缺少的模型及例子會在首次使用時自動取得;原始資料沒有交代硬件需求、推理時間或量化性能,因此不能把速度表現視為已被驗證。

  • 支援全身或上半身、畫面只包含一人的影片
  • 可生成 6、24、48 個或自訂數量的目標視角
  • 兼容輕微鏡頭移動,以及未知相機內參和姿態的素材
  • 可選 FlashAttention-3 或 SageAttention 加快推理

研究展示內容集中於不同人物影片、動作和場景的泛化能力。需要製作 4D 人物、研究自由視角影片,或建立動態人像資料的團隊;只想快速套用濾鏡或要求即時輸出的使用者,仍要先確認硬件、模型取得方式和影片條件是否符合要求。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 數字人, 視頻模型, Video, Python, 語音

ForgeWM 把遊戲世界模型推向 72 FPS 即時互動

由中大、騰訊等團隊開發的 ForgeWM,將遊戲畫面生成壓縮至一至四步,讓鍵盤、滑鼠及手掣輸入能即時改變虛擬世界。

ForgeWM

中香港中文大學、騰訊 PCG、復旦大學、上海人工智慧實驗室及香港科技大學的研究團隊,將 ForgeWM 做成開源的 action-conditioned video world models 訓練項目,處理遊戲輸入與連續畫面生成難以兼顧的問題。它以 Matrix-Game 2(MG2)為基礎,讓模型根據鍵盤、滑鼠或 gamepad 操作即時推演遊戲畫面。

ForgeWM 的價值在於把生成步數降至 1、2 或 4 步,換取更低延遲的互動體驗;取捨是畫面質素、控制準確度與推理速度仍要依賴訓練資料和硬件。相較只展示影片生成的做法,ForgeWM 直接處理 frame-aligned 的動作訊號,並將同一套流程移植到另一個 gamepad 驅動的 FPS 領域。

  • 一套四階段流程:bidirectional SFT、teacher-forced causal AR、consistency distillation、on-policy DMD
  • ForgeWM-1、ForgeWM-2、ForgeWM-4 分別對應一、二及四步生成
  • 單張 H20、352×640 畫面下,1-step 模型最高達 72 FPS
  • 完整公開 weights、training code 及 pre-encoded data

模型並非各自獨立訓練:Stage 0 先對目標遊戲作 bidirectional fine-tuning,之後固定為教師;Stage 1 將生成器改成 causal AR,Stage 2 壓縮 sampling trajectory,Stage 3 再用學生自行 rollout 的結果進行 on-policy matching。這個結構讓 ForgeWM-1、-2、-4 可從相同基礎流程按步數預算建立。

研究、遊戲 AI 及需要即時互動生成的團隊較容易受益,尤其適合測試鍵鼠控制的 Minecraft 或 gamepad FPS。資料提供的指標包括 168 ms per chunk、72 FPS 及 8×H20 完整訓練配置;模型及數據連結整理環境,要預留 8 張 H20 重現完整訓練流程。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, 上海人工智慧實驗室, 騰訊, 世界模型, 模型訓練, Video, World-Action Model

[技術文章] pixel-space 模型可以追平甚至超過 latent-space 對應模型

研究聚焦 pixel-space text-to-image diffusion models 的訓練卡位,找出點樣喺大規模條件下兼顧畫質同速度。作者用 latent-to-pixel 策略,令 pixel-space 模型更接近甚至超過 latent-space 表現。

Hero image preview

上圖是透過 pixel-space text-to-image diffusion models 的方法訓練的 Z-Image-Turbo (Pixel) 產生的圖像。在企業級 H800 GPU 上,推理延遲僅約 0.2 秒。

Pixel-space text-to-image diffusion models 一直有兩個吸引位:直接生成像素,唔受 VAE 壓縮上限限制,亦可以省去解碼步驟。但喺大規模訓練下,佢哋收斂速度明顯慢過 latent-space 模型,令「畫質、效率、可訓練性」三者之間嘅平衡一直唔夠成熟。

呢篇工作針對嘅正係呢個落差。作者先比較 pixel-space 同 latent-space 喺大規模 pre-training 下嘅行為,再提出 latent-to-pixel 策略:先喺 latent space 學到生成先驗,再轉去 pixel space 做 post-training,避免一開始就喺難度更高嘅像素空間硬推。

佢哋亦系統研究咗多個轉換設計,包括 weight initialization、data composition、prediction target、decoder architecture 同 noise schedule,整理出一套可行做法。結果顯示,做法調整得當之後,pixel-space 模型可以追平甚至超過 latent-space 對應模型,推理端仲有 3.18 到 4.75 倍嘅速度提升。

  • 直接處理 pixel-space diffusion models 喺大規模訓練時收斂慢嘅問題
  • 用 latent-to-pixel 路線,先學先驗,再轉入像素空間微調
  • 檢視多個關鍵訓練選項,搵出實用 recipe
  • 在畫質不退讓之下,換取更快的 end-to-end inference
  • 對想做高效文生圖系統、又在意生成細節保留嘅團隊最有參考價值

Paper

Categories: 香港科技大學, 南京大學, 阿里巴巴, 模型, 模型訓練, Image, txt2img, 香港

GenRouter AI 圖像生成變成會分流的工作流

它把 agentic image generation 由單一路徑改成可分流的工作流,按任務難度配對不同執行方案。對要兼顧畫質、文字準確度同運算成本的團隊,這種做法比硬套同一套流程更有彈性。

Figure1 00

安裝方式偏向研究原型工作流,先建立 environment.yml 對應的 Conda 環境,再按 scripts/services/ 和 scripts/serve.sh 需要下載本地模型。README 亦提到 OneIG 同 WISE 有獨立環境,代表它不是單一命令就能完整跑通的輕量工具,而是要跟着項目內的服務配置同基準測試流程去部署。

GenRouter 處理的不是單純「生成得靚唔靚」,而是把不同提示詞導向不同算力配置。當任務涉及多步空間推理、精準文字渲染,或者需要較高視覺質素時,GenRouter 會揀更合適的執行計劃;較簡單的請求則不必走沉重流程,這種取捨直接針對延遲同成本問題。

  • GenCanvas 將 agentic image generation 拆成通用原語,方便重用工作流
  • GenRouter 以需求分析、記憶輔助匹配同 Pareto filtering 做路由
  • 目標是減少「一刀切」流程造成的算力浪費
  • 比較適合做圖像代理、生成管線同研究型系統的團隊
  • README 未見完整公開的數值結果摘要,較適合當作框架型項目理解

GitHub

Categories: 開源, 香港中文大學, 香港科技大學, Agentic, Qwen, Image, 影像模型

RA-Bench 直指危機假影片檢測盲點

危機事件影片最麻煩之處,不是合成得花巧,而是看起來太像真。RA-Bench把檢測器拉回真實傳播場景,專門測試這個落差。

RA-Bench: Can we defend against generated crisis videos?

當一段災難、戰事或公共事故影片本身已有真實事件做錨點,檢測器往往無法只靠內容違和感分辨真偽。RA-Bench屬於影片檢測基準資料集,針對的正是 AI 生成危機影片貼近真實新聞片段後,現有偵測方法還能否守得住。

它的做法有一個關鍵判斷:不再拿脫離情境的合成片去測,而是把真實危機影片與對應生成版本配對,並且涵蓋四個開源與五個閉源生成器。資料規模有 17,886 段影片,當中包括 1,830 段 real anchors、16,056 段生成片,另設 RA-Bench-HumanProof 與 RA-Bench-LastMile,前者收錄連人工審查者都一致誤判為真的 633 段影片,後者再測試影片經過連續傳播處理後,檢測器會否失準。

這個項目把「像真」、「會誤導人」、「經社交傳播後失真」三件事放在同一套測試裡。相對於只看配對樣本的資料集,它多了一層來源泛化與傳播鏈穩健性的要求;代價是資料權限較複雜,完整版本有部分 real anchors 只提供原始 URL,未必人人都能直接重跑 full 軌道。

  • public-media 只評估可重新分發的真實錨點配對,較適合公開重現與初步比較
  • full 依照完整論文清單評估,也要求處理只提供 URL 的真實來源
  • Hugging Face 釋出公開媒體約 93.8 GB,生成影片完整提供,真實素材則經權利審核後部分保留來源連結
  • 評估採用 source-matched evaluation,會把每個生成來源放回其對應真實錨點脈絡判斷

對做影片鑑識、內容審核、新聞驗證與多模態安全研究的團隊,RA-Bench的價值很直接:它不是教模型辨認「很像假片的假片」,而是逼它面對會在人類審查與傳播流程中混過去的片段。限制也同樣清楚,這仍是 benchmark,不是現成檢測器;要得出可比較結果,仍要先準備預測輸出、下載資料,並處理部分真實來源無法重分發的存取條件。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 多模態模型, OpenAI, Video, Dataset 數據集

StreamArena 多模態長片代理的記憶與互動分析

來自香港科大、港大與中大及小紅書的團隊,把長達近 90 分鐘的影片理解拆成可持續觀察、回想、找工具與主動回應四種能力。

StreamArena overview

由 HKUST(香港科技大學)、The University of Hong Kong(香港大學) 與 The Chinese University of Hong Kong(香港中文大學) 及小紅書組成的開發團隊,將焦點放到一個很多多模態代理都未真正處理好的難題:影片唔再係幾秒剪輯,而係接近一個半鐘頭、仲要持續互動。StreamArena 屬於資料集與評測工具包,處理的是 continuous streaming video understanding,目標係用統一方法檢驗代理在長時間影音流之中,能否即時理解、隔一段時間後仍然記得內容,並在合適時機用工具或主動回應。

呢個項目最值得注意的地方,在於它唔用短片加選擇題去掩蓋模型弱點,而係用 243 段 full-length videos、平均 88.8 分鐘、合共 3,646 個 open-ended tasks,分成 Real-Time Perception (RTP)、Historical Retrospection (HR)、External Tool Use (Tool) 同 Proactive Interaction (Pro)。HR 與 Pro 仲按時間跨度分層,HR 最遠拉到 30 分鐘,直接把長期記憶與延遲控制的取捨攤開來測。

StreamArena Evaluation Toolkit:streamarena/ 放資料載入、媒體處理、tool-call protocol、OpenAIBackend、GeminiBackend 同 LLM-as-Judge scorer;method/ 則整理多種被測方法,包括 offline 的 Qwen、MiMo、Kimi、Qwen-Omni、Gemini,以及 MiniCPM-o-4.5、VST、StreamForest、ThinkStream。所有方法都寫入同一套 records JSONL schema,所以 judge/ 可以用同一把尺評分。安裝與執行細節在目前資訊裡未完全展開,但可確認它不是單一模型倉庫,而是用來重跑、對齊與比較不同方法的評測框架。

  • 覆蓋四類能力:RTP、HR、Tool、Pro,唔只問答,仲測持續監看與主動互動
  • 243 段長影片、平均 88.8 分鐘,資料規模明顯偏向長時序理解
  • 同一份 JSONL 輸出格式配合通用 judge,方便橫向比較不同方法
  • StreamMind 在同一 Qwen3.5-397B-A17B backbone 上,把 pooled query-to-answer latency 降低 66.2%

一個重要限制:StreamMind 在這次釋出裡只有 evaluation protocol docs,未附完整可直接重現的實作;AURA 亦只提供 client,server 仍要依賴官方 vLLM。換句話說,StreamArena 現階段更像研究團隊、代理系統開發者同多模態評測工作流會用到的基礎設施。想比較不同 streaming method、檢查長影片代理究竟卡在記憶、反應,還是工具調用,呢個項目比一般短片 benchmark 更接近部署前要面對的現實。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, Agentic, 多模態模型, Qwen, Gemini, Video, 香港, Kimi

DeepVoyager-VL 把視覺線索放回搜尋流程中

DeepVoyager-VL不只是睇圖再答題,而係會用新取得嘅視覺證據決定下一步搜尋。對長流程多模態檢索項目而言,呢個改動幾關鍵。

Comparison of multimodal search data synthesis paradigms

當一個多模態 agent 要連續查多步資訊,最易失準嘅位置往往唔係答題,而係中途搵錯線索。DeepVoyager-VL處理嘅正正係呢個問題:佢屬於長流程多模態 deep-search 框架,讓新取得嘅圖片證據直接影響下一輪檢索,而唔係只喺輸入開頭或答案結尾先用到視覺資訊。

呢種做法令佢同一般把視覺訊息包裝成前置條件嘅方法有明顯分別。DeepVoyager-VL背後用 EventVoyage-VL 生成帶有中間視覺依賴嘅長流程問題,再用整理過嘅 trajectories 做 Supervised Fine-Tuning(SFT),而唔加額外 reinforcement learning 階段;取捨好清楚,訓練流程較可重現,但效果仍然要靠資料合成質素同軌跡篩選撐住。

倉庫而家已經放出 paper、project page,同可重現嘅 Megatron SFT training bundle,亦提供 DeepVoyager-VL-8B 同 DeepVoyager-VL-30B-A3B 模型,以及 EventVoyage-VL dataset。想理解點樣驗證,最直接係沿住現成模型、資料集同訓練 bundle 睇完整流程;README 亦提到 SWIFT RUNTIME=bundled 會使用儲存庫內嘅 source trees,定位上比較接近研究與訓練復現項目,而唔係即開即用嘅消費級產品。

  • 核心改動:把 vision in the loop 放入搜尋中段,圖片可按需要先載入或裁切
  • 資料來源:EventVoyage-VL 先做 structure-before-language synthesis,再抽出可監督軌跡
  • 訓練路線:以 supervised-only 為主,冇再疊 reinforcement learning 階段
  • 結果:8B 同 30B-A3B 平均分別為 54.8 同 58.6,並在十個 benchmark 入面分別拿下八個同九個最佳成績

分數本身已經講到定位:DeepVoyager-VL不只是追求更大模型,而係想改善「見到新圖之後,下一步應該搵乜」呢個決策環節。較受益嘅會係做多步檢索、多模態問答、研究型 agent pipeline 嘅團隊;要留意嘅限制亦同樣直接,成效高度依賴合成資料點樣把中途視覺依賴編排得夠真實,離開相關 benchmark 之後,泛化深度仲要靠後續驗證。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 北京大學, 華為, Agentic, 模型, 多模態模型, 模型訓練, 框架, Dataset 數據集

See2Think 驗證多模態模型有冇「睇圖再諗」

多模態模型會畫輔助線、標示區域,未必代表後續推理真係依賴咗呢些中間視覺狀態。See2Think想量度的,正正就是這段常被忽略的過程。

See2Think — Do Multimodal Models Really Use Intermediate Visual States?

見到模型會畫線、裁圖、標記物件,很多人自然會當它「有睇過先答」。See2Think屬於基準測試加診斷框架,焦點不是只看最後答啱幾多,而是拆開檢查中間視覺狀態有冇被真正用到、渲染是否忠實,以及後續推理有冇因此改變,這點對多模態模型(Multimodal Models)尤其關鍵。

它的核心設計分成兩部分:See2ThinkBench 收錄 1,200 條 visually dependent 問題,涵蓋 2D structured reasoning、3D scene reasoning 同 real-world visual reasoning;另一部分是 Visual Action-of-Thought(VAoT)流程,會把文字思路、structured visual actions、rendered states 同之後的推理串連起來。這種做法比單看 final-answer accuracy 更有診斷力,因為可以分辨模型是在「做出圖像」還是在「依賴圖像」。

同類研究常停留在結果分數,See2Think較著重受控比較。它設有 CoT、NoRender、Full、WrongRender 等 matched comparisons,又會檢查 render-benefit、corrupted-feedback sensitivity,以及 process judging 裡的 relevance、faithfulness、uptake,換句話說,不只問模型答得對不對,還會問中間那一步是否相關、是否被正確執行、以及模型有沒有吸收回來的視覺資訊。

  • 適合研究多模態推理、agent 行為分析、視覺工具鏈設計的團隊
  • 強項在於把「中間圖像是否有用」變成可觀察、可干預的測試問題
  • 覆蓋圖表、幾何、符號結構、3D 空間關係到真實圖片場景
  • GitHub 已公開程式與 quick start 線索,但論文仍標示為 coming soon,細部實驗設定仍要以後續正式文件核對

對模型評估要求較細緻的情境,這個項目很有參考價值;想拿它直接當應用工具就未必是同一回事。它更像研究型基礎設施,幫團隊判斷多模態系統的推理鏈是否可信,而不是單純追求更高答題分數。

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 上海人工智慧實驗室, Agentic, 多模態模型, 3D, Dataset 數據集

AsySplat:3D 場景重建更省算力

長場景的新視角合成,常見難點是算力花得多,但畫面未必再明顯變好。AsySplat 直接把幾何和外觀分開處理,在保留細節之餘減少重複計算。

Teaser Image

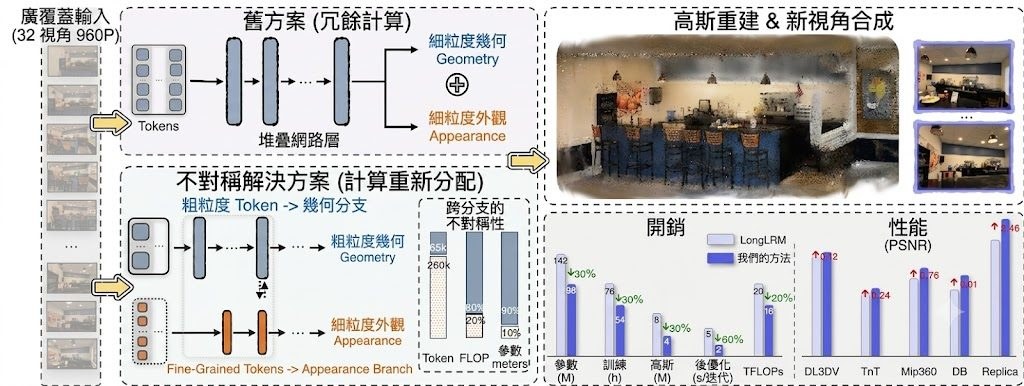
AsySplat 是一個用於 3D Gaussian Splatting 的重建框架,主力解決長序列、廣覆蓋場景做新視角合成時,訓練和推理都太重的問題。現階段這個 GitHub 儲存庫主要提供項目頁、論文連結和資源,程式碼尚未公開,所以要理解它,重點放在方法設計而不是直接安裝部署。

它的做法是把 geometry branch 和 appearance branch 分開,前者處理較粗粒度的資訊,後者用較少參數補回外觀細節,再用 bilateral connections 互相引導。這種取向和一般把所有資訊一起硬塞進去的做法不同,目標是把算力用在更值得的位置。

從現有資料看,AsySplat 比較適合做多視角場景重建、研究級新視角合成,或需要在較大輸入規模下控制訓練成本的團隊。同時使用 sparse attention module,結合 convolution blocks 和 self attention 來減少開銷,並在 32-view 960P 輸入上取得較少參數和較低訓練、推理負擔的結果。

  • 類型:3D Gaussian Splatting 重建框架
  • 目標:降低 wide-coverage scene modeling 的重複計算
  • 特色:幾何與外觀分流處理,再以 bilateral connections 協調
  • 效能:在 32-view 960P 設定下,宣稱比之前的 generalizable models 更省參數和開銷
  • 相關模型:3D Gaussian Splatting、generalizable 3DGS models、novel view synthesis (NVS)

項目主頁 · GitHub

Categories: 開源, 香港科技大學, 香港城市大學, 香港, 3D, Dataset 數據集

Page 3 of 8
1 2 3 4 5 … 8