Utonia – Point Cloud 的單一編碼器

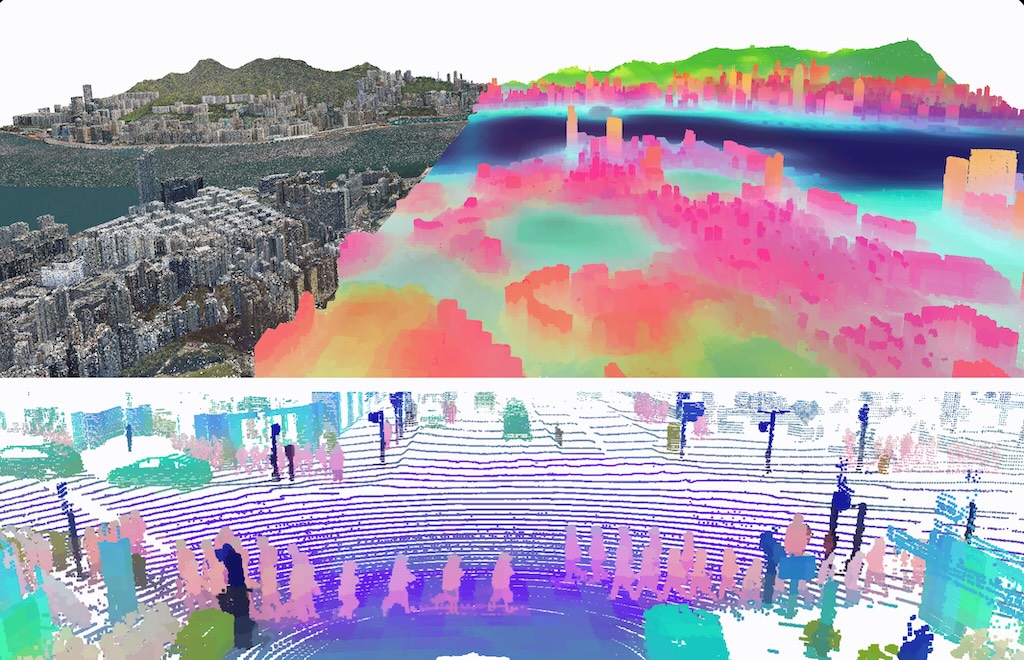
Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。 Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。 跨域資料混合:研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。

Utonia 是一個統一的自監督點雲 Transformer 編碼器,目標是「一個編碼器適用於所有點雲域」,也就是在不同感測器與場景(遙感、戶外 LiDAR、室內 RGB‑D、物件級 CAD 模型、單目視頻轉 3D 點雲等)上共享同一個 backbone,讓預訓練特徵能跨域遷移。

Utonia 在大量異構點雲資料上 jointly 預訓練一個單一的 Point Transformer V3 編碼器,不依賴 domain‑specific 的頭或模組,只用一個 shared representation space。

跨域資料混合:
研究中混合了遙感(衛星/航拍)、自駕車用 LiDAR、室內 RGB‑D 掃描、CAD 物件模型、以及從 RGB 影片 lift 上來的點雲,一起放入 masked autoencoding 式的自監督訓練流程。

Categories: 開源, 香港中文大學, 影像模型, 影像處理

PlenopticDreamer – NVidia 解決影片一致性

PlenopticDreamer 主要解決「鏡頭控制生成影片」的不一致問題。這是一個能讓 AI「像無人機一樣繞著物體飛」生成影片的技術。它可以應用在自駕車的模擬環境、機器人的視覺訓練,以及好萊塢等級的虛擬拍攝。 1.  Robotics(機器人):     *   情境模擬: 機器人需要理解物體在不同角度下的樣貌。這個技術可以根據單一攝影機的畫面,生成該物體在其他視角的影像,幫助機器人進行視覺導航或物體抓取的訓練。     *   模擬數據生成: 為機器視覺系統生成更多樣化的訓練數據。 2.  Self-Driving(自駕車):     *   場景理解: 自駕車通常有多個鏡頭。這個技術可以補足盲區,或者將一個鏡頭的畫面轉換成其他鏡頭的視角,幫助車輛更全面地感知周圍環境。     *   未來幀預測: 預測道路上物體在下一秒鐘會出現在哪個位置(從不同角度)。 3.  影視製作與 AR/VR:     *   新視角補全: 如果拍攝時漏掉了某個角度,可以利用這個技術「憑空生成」該角度的連續影片。     *   重定向(Re-direction): 可以將拍好的影片,根據新的鏡頭軌跡重新渲染(Re-rendering),讓同一段故事可以從不同角度重新看一遍。

PlenopticDreamer 主要解決「鏡頭控制生成影片」的不一致問題。這是一個能讓 AI「像無人機一樣繞著物體飛」生成影片的技術。它可以應用在自駕車的模擬環境、機器人的視覺訓練,以及好萊塢等級的虛擬拍攝。

1.  Robotics(機器人):

    *   情境模擬: 機器人需要理解物體在不同角度下的樣貌。這個技術可以根據單一攝影機的畫面,生成該物體在其他視角的影像,幫助機器人進行視覺導航或物體抓取的訓練。

    *   模擬數據生成: 為機器視覺系統生成更多樣化的訓練數據。

2.  Self-Driving(自駕車):

    *   場景理解: 自駕車通常有多個鏡頭。這個技術可以補足盲區,或者將一個鏡頭的畫面轉換成其他鏡頭的視角,幫助車輛更全面地感知周圍環境。

    *   未來幀預測: 預測道路上物體在下一秒鐘會出現在哪個位置(從不同角度)。

3.  影視製作與 AR/VR:

    *   新視角補全: 如果拍攝時漏掉了某個角度,可以利用這個技術「憑空生成」該角度的連續影片。

    *   重定向(Re-direction): 可以將拍好的影片,根據新的鏡頭軌跡重新渲染(Re-rendering),讓同一段故事可以從不同角度重新看一遍。

Categories: 開源, 香港中文大學, 視覺模型, 視頻模型, NVIDIA, 影像模型, 影像處理

ProEdit:開源圖片及影片編輯

ProEdit 透過 KV-mix 在注意力層融合源/目標特徵,及 Latents-Shift 擾動潛在空間,實現高保真編輯。 支援 FLUX、HunyuanVideo 等模型,同時亦整合 Qwen3-8B 解析自然語言指令。 ProEdit 解決傳統反轉編輯過度依賴源圖的問題,能準確變換主體屬性如姿態、數量、顏色,同時保持背景一致。 適用於圖像替換(如老虎變貓、襯衫變毛衣)與影片動態編輯(如紅車變黑車、鹿變牛)。適合 AI 內容創作者、影片後製,plug-and-play 相容 RF-Solver 等工具,在多項基準測試達 SOTA 效能。

ProEdit 透過 KV-mix 在注意力層融合源/目標特徵,及 Latents-Shift 擾動潛在空間,實現高保真編輯。 支援 FLUX、HunyuanVideo 等模型,同時亦整合 Qwen3-8B 解析自然語言指令。

ProEdit 解決傳統反轉編輯過度依賴源圖的問題,能準確變換主體屬性如姿態、數量、顏色,同時保持背景一致。 適用於圖像替換(如老虎變貓、襯衫變毛衣)與影片動態編輯(如紅車變黑車、鹿變牛)。適合 AI 內容創作者、影片後製,plug-and-play 相容 RF-Solver 等工具,在多項基準測試達 SOTA 效能。

ProEdit: Inversion-based Editing From Prompts Done Right

Categories: 香港中文大學, 香港大學, 視頻模型, 影像模型, 影像處理

SemanticGen 加入語意生成影片

SemanticGen 首先在高層語義空間中生成視頻,然後在 VAE 潛在空間中細化細節。SemanticGen 的核心觀點是,鑑於影片中固有的大量冗餘訊息,視訊生成應首先在緊湊的語義空間中進行全局規劃,然後再添加高頻細節——而不是直接對大量的底層視訊標記進行建模。

SemanticGen 首先在高層語義空間中生成視頻,然後在 VAE 潛在空間中細化細節。SemanticGen 的核心觀點是,鑑於影片中固有的大量冗餘訊息,視訊生成應首先在緊湊的語義空間中進行全局規劃,然後再添加高頻細節——而不是直接對大量的底層視訊標記進行建模。

Categories: 香港中文大學, 影像處理

RePlan 圖像編輯框架

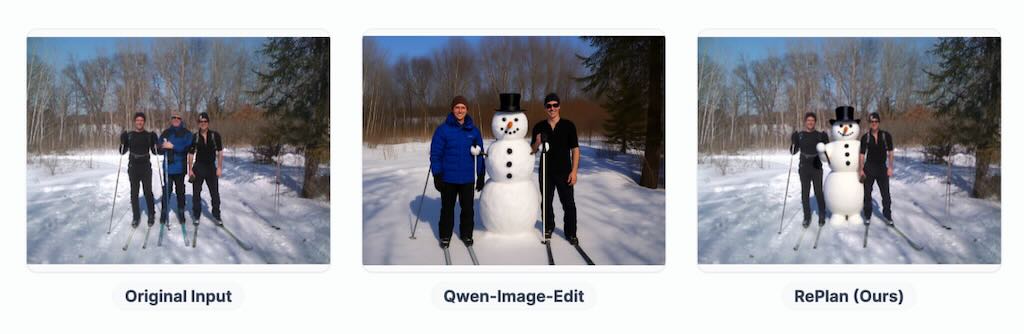
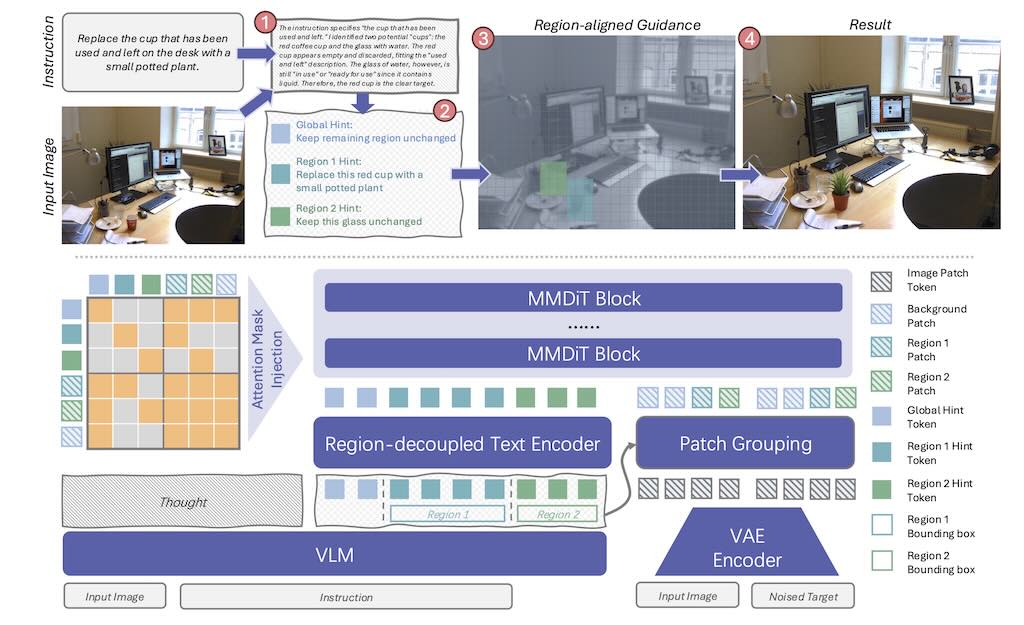
RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。 框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。

RePlan 是一個基於指令的圖像編輯框架,專門解決指令-視覺複雜度(IV-Complexity)挑戰,透過視覺語言規劃器與擴散編輯器結合實現精準區域編輯。

框架採用「規劃-執行」策略:VLM 規劃器透過逐步推理分解複雜指令,生成邊界框與區域提示;編輯器使用無訓練注意力區域注入機制,支援單次多區域並行編輯,避免迭代 inpainting。

Categories: 開源, 香港中文大學, 香港科技大學, 騰訊, 影像模型, 影像處理, Python, 新聞

Light-X 修正相片/影片光渲染及視角

Light-X 是個視訊生成框架,它能夠從視訊中實現可控渲染,並同時控制視角和光照。 Light-X 提出一種解耦設計,將幾何形狀和光照信號解耦:幾何形狀和運動通過沿用戶定義的相機軌跡投影的動態點雲來捕獲,而光照線索則由始終投影到相同幾何形狀的重新光照幀提供。這些明確的、細粒度的線索能夠有效地解耦,並指導高品質的光照。 為了解決缺乏配對的多視角和多光照視頻的問題,Light-X 引入了Light-Syn,這是一種基於退化和逆映射的流程,它利用自然場景下的單目視頻素材合成訓練對。此策略產生了一個涵蓋靜態、動態和 AI 生成場景的資料集,確保了訓練的穩健性。大量實驗表明,Light-X 在聯合相機光照控制方面優於基線方法,並且在文字和背景兩種條件下均優於以往的視訊重光照方法。

Light-X 是個視訊生成框架,它能夠從視訊中實現可控渲染,並同時控制視角和光照。

Light-X 提出一種解耦設計,將幾何形狀和光照信號解耦:幾何形狀和運動通過沿用戶定義的相機軌跡投影的動態點雲來捕獲,而光照線索則由始終投影到相同幾何形狀的重新光照幀提供。這些明確的、細粒度的線索能夠有效地解耦,並指導高品質的光照。

為了解決缺乏配對的多視角和多光照視頻的問題,Light-X 引入了Light-Syn,這是一種基於退化和逆映射的流程,它利用自然場景下的單目視頻素材合成訓練對。此策略產生了一個涵蓋靜態、動態和 AI 生成場景的資料集,確保了訓練的穩健性。大量實驗表明,Light-X 在聯合相機光照控制方面優於基線方法,並且在文字和背景兩種條件下均優於以往的視訊重光照方法。

httpv://www.youtube.com/watch?v=ui9Lg2H–0c
Categories: 開源, 香港中文大學, 影像處理

MoC 突破時空限制:AI 長影片生成

AI 不僅能創造出栩栩如生的圖片,還能生成數分鐘、甚至更長,且故事連貫、情節流暢的影片。這曾是生成式AI領域一個巨大的挑戰。然而,一項名為「上下文混合」(Mixture of Contexts, MoC) 的創新技術,正逐步將這個夢想變為現實。這項由 Shengqu Cai 等研究人員提出的最新進展,為長影片生成帶來了革命性的解決方案,有效克服了現有模型在處理「長期上下文記憶」上的瓶頸。 生成長影片的核心挑戰,在於模型必須能夠在漫長的時間序列中,保持並檢索關鍵事件,同時避免資訊崩潰或內容漂移。現有的擴散變換器(diffusion transformers)雖然在短影片生成方面表現出色,但其自注意力(self-attention)機制的二次方成本,使得處理長序列時,記憶體和計算資源的消耗變得難以承受,導致效率低下且難以優化。這意味著,隨著影片時長的增加,AI模型可能會「忘記」影片開頭的人物身份、動作或場景設定,導致影片內容的連貫性、一致性大大降低。

AI 不僅能創造出栩栩如生的圖片,還能生成數分鐘、甚至更長,且故事連貫、情節流暢的影片。這曾是生成式AI領域一個巨大的挑戰。然而,一項名為「上下文混合」(Mixture of Contexts, MoC) 的創新技術,正逐步將這個夢想變為現實。這項由 Shengqu Cai 等研究人員提出的最新進展,為長影片生成帶來了革命性的解決方案,有效克服了現有模型在處理「長期上下文記憶」上的瓶頸。
生成長影片的核心挑戰,在於模型必須能夠在漫長的時間序列中,保持並檢索關鍵事件,同時避免資訊崩潰或內容漂移。現有的擴散變換器(diffusion transformers)雖然在短影片生成方面表現出色,但其自注意力(self-attention)機制的二次方成本,使得處理長序列時,記憶體和計算資源的消耗變得難以承受,導致效率低下且難以優化。這意味著,隨著影片時長的增加,AI模型可能會「忘記」影片開頭的人物身份、動作或場景設定,導致影片內容的連貫性、一致性大大降低。

(more…)
Categories: 開源, 香港中文大學, 字節跳動, 影像模型

ToonComposer:簡化動畫製作

傳統的卡通/動漫製作耗時耗力,需要技藝精湛的藝術家進行關鍵影格、中間畫和上色。 ToonComposer 利用生成式 AI 簡化了這個流程,將數小時的中間畫和上色手動工作簡化為一個無縫銜接的流程。

傳統的卡通/動漫製作耗時耗力,需要技藝精湛的藝術家進行關鍵影格、中間畫和上色。 ToonComposer 利用生成式 AI 簡化了這個流程,將數小時的中間畫和上色手動工作簡化為一個無縫銜接的流程。

ToonComposer: Streamlining Cartoon Production with Generative Post-Keyframing
Categories: 香港中文大學, 視頻模型, 影像模型, 影像處理, 動畫

NVSpeech 處理副語言聲音

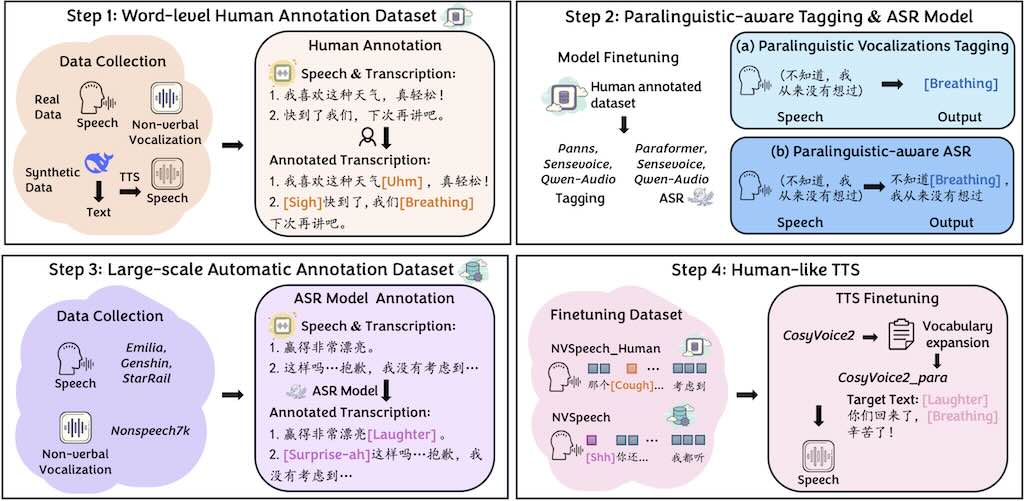
NVSpeech 用於處理副語言聲音(paralinguistic vocalizations),包括非語言聲音(如笑聲、呼吸)和詞彙化插入語(如「uhm」、「oh」)。這些元素在自然對話中至關重要,能傳達情感、意圖和互動線索,但傳統自動語音辨識(ASR)和文字轉語音(TTS)系統往往忽略它們。

NVSpeech 用於處理副語言聲音(paralinguistic vocalizations),包括非語言聲音(如笑聲、呼吸)和詞彙化插入語(如「uhm」、「oh」)。這些元素在自然對話中至關重要,能傳達情感、意圖和互動線索,但傳統自動語音辨識(ASR)和文字轉語音(TTS)系統往往忽略它們。

Categories: 開源, 香港中文大學, 模型, Mac, 語音, Win, 聲效

HPSv3 基於視覺語言模型

HPSv3(Human Preference Score v3)是一個由 Mizzen AI、香港中文大學 MMLab、倫敦國王學院、上海交通大學及上海人工智能實驗室等機構合作開發的項目,目標是建立一個全面的人類偏好評估系統,用於評估文本到圖像生成模型的表現。 HPSv3 旨在解決現有圖像生成模型評估中與人類感知對齊的問題,現有方法常受限於數據覆蓋範圍不足、特徵提取不佳及損失函數效率低下的問題

HPSv3(Human Preference Score v3)是一個由 Mizzen AI、香港中文大學 MMLab、倫敦國王學院、上海交通大學及上海人工智能實驗室等機構合作開發的項目,目標是建立一個全面的人類偏好評估系統,用於評估文本到圖像生成模型的表現。

HPSv3 旨在解決現有圖像生成模型評估中與人類感知對齊的問題,現有方法常受限於數據覆蓋範圍不足、特徵提取不佳及損失函數效率低下的問題

Screenshot

Categories: 香港中文大學, 香港

Page 7 of 8
1 … 5 6 7 8