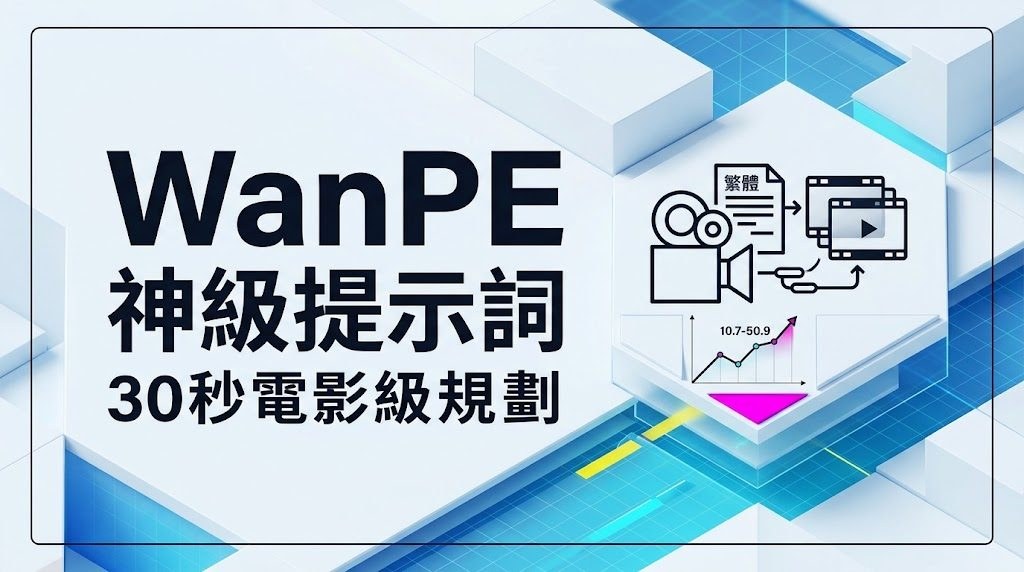
阿里 WanPE 用 397B 參數重寫電影級提示詞

阿里 Wan Team 推出 397B 參數嘅電影級提示詞增強模型 WanPE,專門幫影片生成模型把簡單描述擴寫成導演級腳本。

Wan logo

用文字寫出導演水準嘅提示詞係一道高牆。普通用戶多數只會輸入「一個人喺森林行」,但頂級模型需要更細緻嘅鏡頭語言、動作編排同節奏控制,先至能夠生成高質素嘅 30 秒成片。阿里 Wan Team 推出嘅 WanPE,正正瞄準呢個痛點:佢會將用戶輸入嘅簡短描述,自動擴寫成包含鏡頭運動、燈光變化、動作節奏嘅電影級分鏡腳本,再交俾下游影片模型執行。

WanPE 採用「Video-grounded reverse construction」做法,先從真實影片反向建構出鏡頭規劃,再學習點樣由提示詞出發重建同樣嘅結構,比起由前向改寫提示詞更能保留導演意圖。同時,佢透過 Semantic-Consistency GRPO(SC-GRPO)訓練方法,確保長鏡頭、多分鏡之間嘅語意唔會走樣。整個模型以約 105 萬條真實影片訓練而成,參數量達到 397B。

沒有 WanPE

使用 WanPE 之後

團隊構建咗人類標註嘅 WanPEval 測試集,覆蓋 5 至 30 秒唔同時長同意圖粒度,並用約 11,000 組盲測配對評分做對比。當配搭 Wan3.0 影片生成器時,WanPE-397B 喺 5 至 15 秒影片將人類偏好分數提升 10.7 至 18.8 分;喺 30 秒嘅長片場景,偏好分數更大幅躍升 50.9 分。喺 5 至 15 秒組別,佢領先所有受測嘅商業方案;30 秒組別則與 Seedance 2.5 保持競爭水平。

對內容創作者、短影片團隊或者想做 AI 廣告片嘅人嚟講,呢類自動「導演助手」能夠省卻大量分鏡草稿時間;對開發者而言,佢亦可作為外掛增強模組,套用到 LTX-2.5、MiniMax-H3 等其他生成器身上做格式適配。

重點摘要

  • 397B 參數專職寫分鏡:WanPE 將用戶簡短提示擴寫為導演級電影腳本,再交俾下游影片模型執行
  • 逆向建構 + SC-GRPO:從真實影片反向學習鏡頭規劃,並透過強化學習保持長片語意一致
  • WanPEval 評測:人類標註、5 至 30 秒覆蓋、約 11,000 組盲測配對評分
  • 30 秒長片偏好激升:搭配 Wan3.0 時,人類偏好分數提升 50.9 分
  • 可遷移:經格式適配後,可應用於 LTX-2.5、MiniMax-H3 等其他生成器
項目主頁 · Paper

Categories: 南京大學, 清華大學, 阿里巴巴, AI productions, 模型, 模型訓練, Video, 提示詞, Content Creator, LTX, 中國, Dataset 數據集, MiniMax

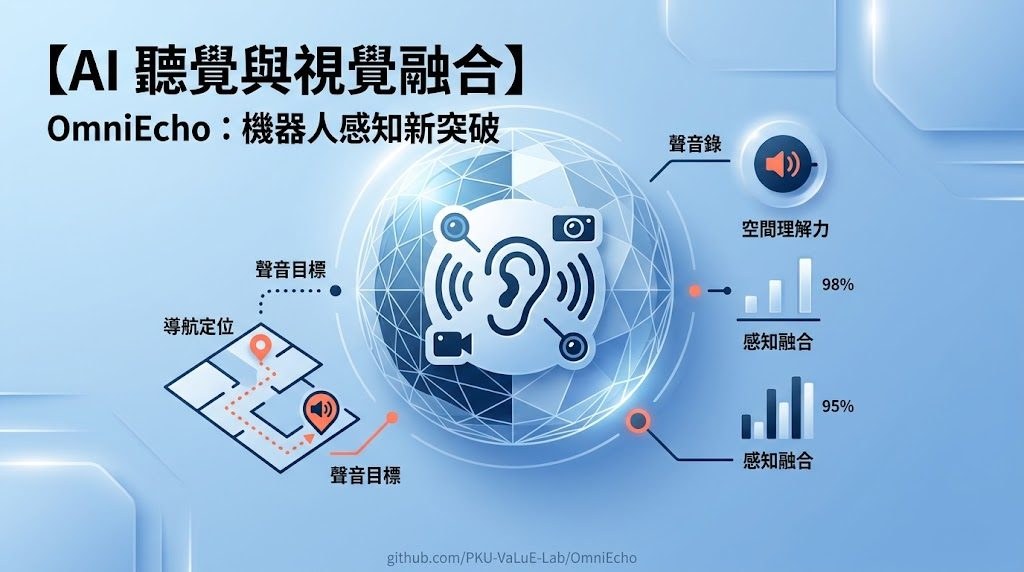
OmniEcho:讓智能體真正「聽聲辨位」的全方位音視覺模型

聲音從哪個方向來、距離多遠,是人類憑本能就能判斷的事,對機器人卻是一道難題。OmniEcho 把一階 Ambisonics 空間音訊、視覺與語言整合到同一個智能體,專門研究這類空間感知與聲源導航。

Repository image for PKU-VaLuE-Lab/OmniEcho

OmniEcho 是一個面向 embodied agent 的音視覺空間感知項目,由北京大學 PKU-VaLuE-Lab 開源。它要解決的問題很直觀:當一個智能體同時聽到聲音、看到畫面,它能否判斷聲源在哪個方向、距離多遠,並進一步循聲走去?這件事對人類毫不費力,但要讓 AI 真正做到,過去並不容易。

項目同時提供三樣東西:統一基準 OmniEchoBench、可控的空間音訊渲染管線,以及基於 Qwen3-Omni 改進的 OmniEcho 模型。後者最關鍵的設計,是在 Qwen3-Omni 既有語意音訊通路之外,加掛一個專門處理 FOA(一階 Ambisonics)空間資訊的編碼器,讓模型同時理解「聽到什麼」和「聲音從哪來」。

基準涵蓋六類任務,合共 197 個真實音視覺場景、2,972 條 QA 與 900 條導航樣本,全部由人工核對標註。OmniEcho 在空間音視覺感知上達到 state-of-the-art,而循聲導航的表現已經逼近傳統「靠文字指示」的視覺語言導航。不過細粒度的方位判定與距離估計,仍被作者列為尚未解決的難題。

對做機器人導航、音視覺融合研究,或需要智能體在真實場景中聽聲定位的團隊,這套項目提供了一個可以直接拿來跑評測、訓練、再挑戰的起點。原文並未附上完整的安裝或下載流程,相關代碼與模型權重目前標示為即將釋出。

重點摘要

  • 空間音訊加視覺語言:以 FOA 為輸入,與視覺、語言一起餵進 omni-modal agent。
  • 雙編碼器設計:在 Qwen3-Omni 之上新增 FOA 空間編碼器,保留原有語意音訊能力。
  • 真實世界基準 OmniEchoBench:六類任務、近 3,000 條 QA 與 900 條導航樣本,人工核對。
  • 循聲導航貼近文字導航:在 Nav 任務上接近傳統 VLN 水平,但方位與距離仍偏弱。
  • 代碼與權重待發佈: 標示 Coming Soon,暫無公開安裝步驟。

GitHub

Categories: 開源, 北京大學, Agentic, 模型, 視覺模型, 模型訓練, Qwen, VLA, Audio

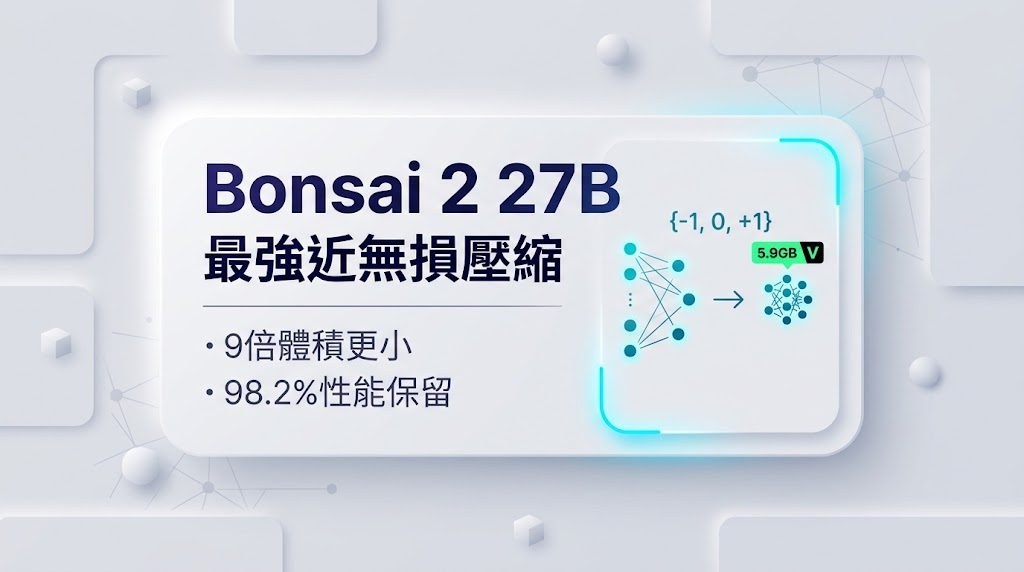
Bonsai 2 27B:5.9GB 模型,筆電可本地處理視覺、PDF 與工具調用

Bonsai 2 27B 以近乎完整的推理能力縮至 5.9GB,兼顧視覺、工具調用與超長上下文。

Bonsai

想在筆記簿或單張 GPU 上處理 27B 級模型,Bonsai 2 27B 提供了一條更貼近本地工作的路線。這項目屬本地運行的低位元多模態語言模型示範工具,實際處理推理、圖片及 PDF 問答,以及需要工具往返的代理工作流。

Ternary Bonsai 2 27B 建基於 Qwen3.8 27B,使用 {-1, 0, +1} 三值權重和 FP16 group-wise scaling,模型大小約 5.9GB,達到 1.76 effective bits per weight。項目聲稱保留完整精度模型 98.2% 的整體基準表現,數學能力只相差約半分,編程表現亦接近基線;代價是必須使用 PrismML 的 llama.cpp binaries,stock llama.cpp 無法直接載入相關檔案。

• 262K-token context,配合 hybrid-attention backbone,較適合長文件處理
• 支援照片、截圖及 PDF 問答,llama.cpp 與 MLX 均可運行
• 原生 OpenAI-style tool_calls,並支援 MCP servers
• PTQ1_0 約 1.75 bits per weight;PQ2_0 以增加約 1.3GB 換取較快提示處理

由 setup 流程取得對應模型及自訂後端,再透過示範介面開啟聊天、視覺和工具功能。Mac 可用 Metal,Linux 或 Windows 可選 CUDA、Vulkan、ROCm,亦可用 CPU;介面可調節 reasoning effort,方便比較回應速度與推理深度。

適合需要離線處理文件、想在有限記憶體硬件運行較大模型,或要把本地模型接入 MCP 工具的開發者和小型團隊。項目提供的多個 Bonsai、Bonsai (1-bit) 及 Ternary-Bonsai 型號,讓硬件容量與能力之間有更多取捨。

項目主頁 · GitHub · 模型

Categories: 開源, MCP, 模型, 多模態模型, Qwen, NVIDIA, OpenAI, Image, 工具, Mac, Linux, LLaMa, 編程, Dataset 數據集

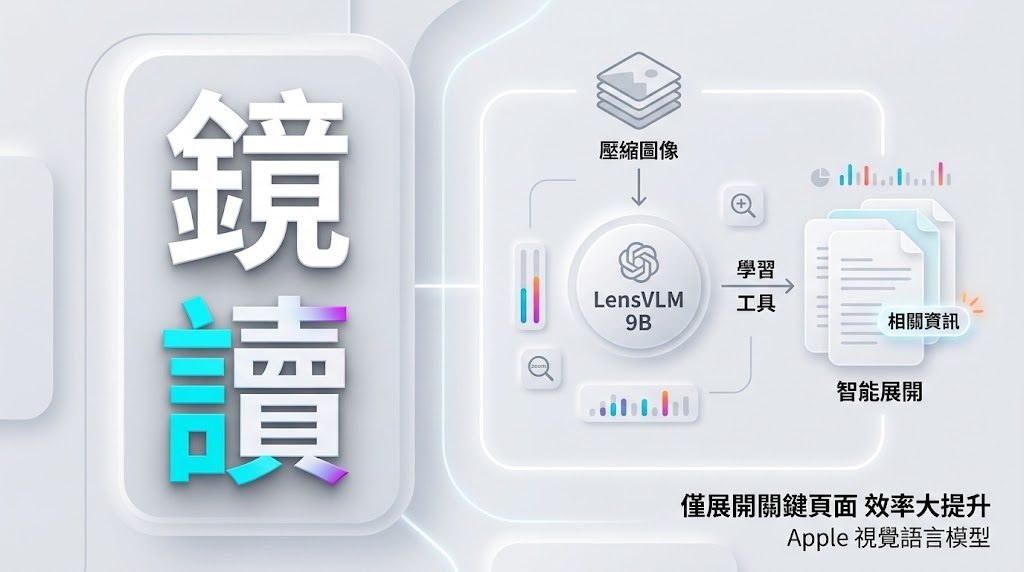
LensVLM 用壓縮頁面減少長文閱讀成本

LensVLM先掃描低成本頁面圖,再只讀取與問題相關的完整頁面,將長文件問答的視覺輸入壓縮成按需取用。

Repository image for apple-aiml-research/ml-lensvlm

面對多頁文件問答,LensVLM不必一開始把每頁完整內容送入模型,而是先以壓縮頁面圖定位線索,再讀取相關頁面的全文。這個項目屬於多模態 Vision Language Model(VLM),實際處理的是長文件輸入過大、文字內容難以一次放入上下文的問題。

LensVLM是經微調的 Qwen3.5-9B,配合學習得到的 read_page 工具,讓模型在掃描頁面縮圖後按需擴展內容。示範包括模型檢查15頁文件,只讀取第10頁,經兩輪互動便由人物資料連結到答案;壓縮比例可選5x、10x或15x,取捨是壓縮越高,初步掃描成本較低,但頁面細節亦可能減少。

  • 先處理壓縮頁面圖,再按問題讀取完整頁面
  • 支援自訂文字文件及 HuggingFace 評估數據準備
  • 輸出頁面圖與結果檔案,方便檢查推理軌跡
  • 適合長報告、資料集問答及文件檢索測試

項目提供 requirements 安裝方式、示範流程及自訂文件參數,結果會寫入指定輸出目錄;原始資料沒有交代硬件要求、推理速度或記憶體消耗。提供的示例能說明工作流程,但未有完整準確率、延遲或與其他長文件 VLM 的量化比較,因此較適合作為研究原型和評估基礎,而非已證實在所有文件類型上都更快或更準的方案。

需要處理大量頁面、又希望控制視覺 token 成本的研究者和工程團隊,較容易從這種按需展開機制受益。文件版面複雜、關鍵答案分散,或問題需要跨頁整合時,仍要留意壓縮圖能否保留足夠線索,以及 read_page 讀取到的文字是否完整。

GitHub · 模型

Categories: 開源, 視覺模型, Qwen, 蘋果

Ming-Image 把設計圖拆成可編輯圖層

Ming-Image 同時處理視覺設計生成與圖層還原,令 UI、海報和簡報內容更容易交由代理程式接手修改。

Ming-Image-0.1-Design on the Artificial Analysis UI/UX Design leaderboard

由文字生成完整 UI、資訊圖表、海報,再把扁平化圖片拆回透明可編輯圖層,Ming-Image 0.1 Design 系列處理的是設計稿難以延續修改的問題。它屬於視覺設計生成模型系列,實際用途是協助代理程式建立、檢查和重組圖像內容,而不只產生一張不可拆分的圖片。

系列包括兩個 6B 參數模型,Ming-Image-0.1-Design 負責生成文字密集的完整視覺構圖,Ming-Image-0.1-Design-Layer 則把成品分解成獨立、透明背景的圖層。後者支援將文字和簡單形狀抽出,配合 Image to Editable PPT 工作流程,把一頁設計或簡報圖片重建成可編輯 PowerPoint 元素;Ling UI Design 工作流程則利用生成參考圖和圖層分解,協助代理程式編寫及視覺檢查 UI 程式碼。

模型支援 RGBA 輸出,透明背景生成需使用指定的 RGBA 提示語。公開模型卡列出 1024 或 2048 解析度、12 sampling steps、CFG scale 1.0 及 BF16 等建議設定;2048 x 2048 生成在一張具備 80 GiB VRAM 的 CUDA GPU 上驗證,較適合有圖形運算資源的設計團隊,而非一般辦公室電腦即時使用。

Ming-Image-0.1-Design GGUFs | LOW VRAM Workflow
  • 生成 UI、資訊圖表、海報及其他文字密集設計
  • 將扁平圖片拆成獨立透明圖層
  • 可支援 UI 程式碼視覺檢查及可編輯 PPT 重建
  • 需要 Python 3.10+、CUDA-capable PyTorch 和模型 checkpoint

完整推理仍需按 companion Ming-Image 項目的依賴和模型服務配置處理。適合需要從參考圖快速建立設計草稿、處理透明素材,或把 AI 生成結果交回設計工具繼續修改的團隊;對只有一般 GPU 資源的使用者,VRAM 要求會是主要限制。

GitHub · 模型

Categories: 開源, 模型, Qwen, NVIDIA, Image, 工具, Python, UI/UX

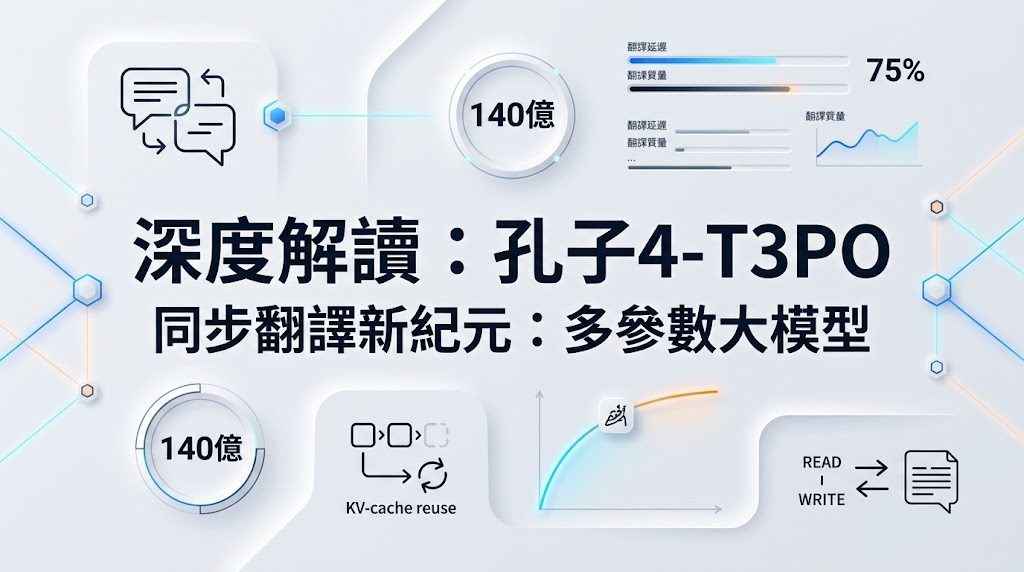
Confucius4-T3PO:14B 即時翻譯模型,邊聽邊譯並兼顧延遲

逐段輸入文字後,模型以 AI 判斷何時繼續等候、何時輸出譯文,減少即時翻譯必須在速度與語境之間二選一的情況。

Confucius4-T3PO

會議口譯或直播字幕需要盡快顯示譯文,但太早翻譯又可能欠缺上下文。Confucius4-T3PO 是一款 140 億參數的文字即時翻譯模型,接收細粒度文字片段後,會決定繼續等候還是輸出部分譯文,支援中英互譯。

它以 READ/WRITE 決策控制等待與輸出,並提供不同延遲模式,讓使用者按即時性需要調整速度與翻譯質素的取捨。已提交的譯文只會逐段追加,不會回頭改寫;交錯式歷史紀錄亦可重用 KV cache,減少重複計算。模型以 Qwen2.5-14B 為基礎,經串流翻譯冷啟動及 Pareto-aware 強化學習,兼顧翻譯質素與延遲。

模型本身只處理文字,並不原生接收語音。語音翻譯需要串接串流自動語音辨識(ASR);項目另有 R2T2 ASR 模型,可組成語音轉文字翻譯流程。推理介面包括逐段文字翻譯 API,以及接收 16 kHz 單聲道 PCM16LE 音訊的 WebSocket 串流示範。

  • 適合需要逐步顯示字幕或翻譯結果的串流應用及口譯流程。
  • 可按低、原生或高延遲模式調整輸出節奏;延遲與翻譯質素需要取捨。
  • API 可查詢分段統計及 WAIT/TRANS 統計,方便觀察單次工作階段的決策情況。
  • 儲存庫提供推理程式碼,並連結模型頁及線上示範;所列資訊未提供硬件需求或效能基準,正式部署前宜先測試目標語言、音訊流程及延遲。

對字幕平台、遠端會議及串流口譯團隊而言,逐段輸出有助減少等待完整句子才見到譯文的落差;但語音流程仍依賴外部 ASR,部署成本亦會受 14B 模型及推理環境影響。

GitHub · 模型

Categories: 開源, 模型, Qwen, API, Audio, 語音

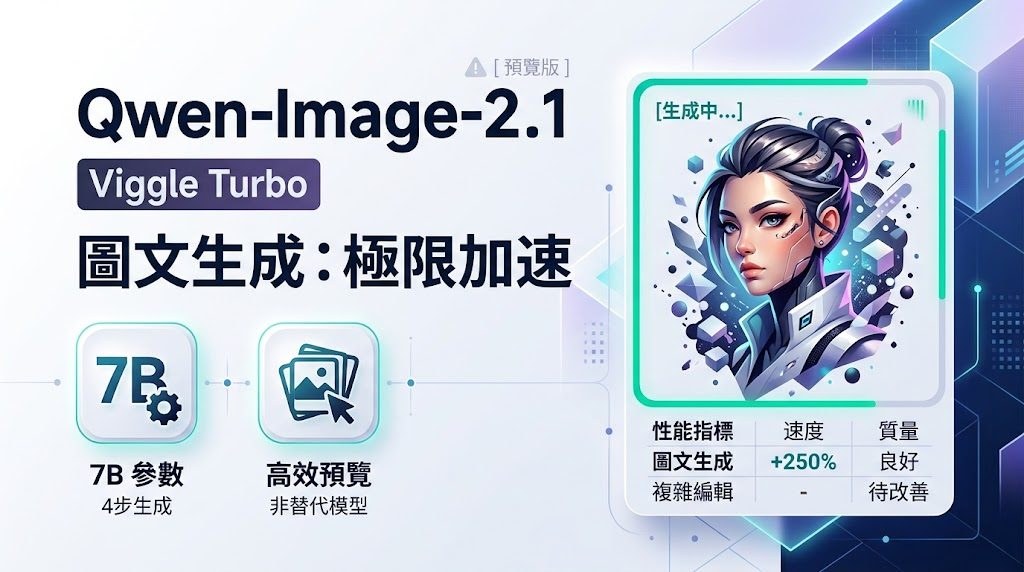
Qwen-Image 2.1 四步生成加速,但複雜編輯仍未完善

Viggle 將 Qwen-Image 2.1 蒸餾至四步生成,換來速度提升,同時保留編輯能力上的取捨。

Og image

面對需要較快出圖、又要按文字指示修改圖片的場景,Qwen-Image-2.1-viggle-turbo 把原始 Qwen/Qwen-Image-2.1 由 40 次 Transformer passes 壓縮至 4 次,支援 text-to-image 及 image-to-image 編輯,亦可配合 1 至 3 張參考圖。模型屬於基於 Qwen/Qwen-Image-2.1 的 adapter 項目,由 Viggle 使用 Distribution Matching Distillation(DMD)訓練,並取消 classifier-free guidance。

項目提供兩個學生模型,取捨集中在下載體積與編輯精準度:

  • transformer/:完整微調的 bf16 Transformer,約 14.2 GB,會取代基礎 Transformer;頁面目前推薦這個版本,質性比較中編輯更忠實。
  • Qwen-Image-2.1-viggle-turbo-4step-lora-r64.safetensors:rank 64、約 340 MB 的 LoRA adapter,載入基礎 Transformer 後運行,下載較快但效果稍弱。
  • peft/:同一 LoRA 的 PEFT key format、F32 權重;LoRA 不會合併入 Transformer,運行時載入可避免 bf16 合併造成的損失。
  • text encoder、VAE 及 processor 沒有隨項目重新發布,會從基礎模型儲存庫載入。

完整微調版本的 DMD objective 加入 low-frequency teacher anchor,兩個版本都是各自訓練流程的 step-400 EMA checkpoint。Text-to-image 在四步下已具可用性,但 v0.1 仍是 preview;多參考圖合成、換臉、保留身份,以及同時包含多項限制的指令,明顯不及原本 40 步的 base model,因此不能視為完整替代品。

因為 QwenImage21Pipeline 尚未納入已發布的 diffusers;同時要安裝 peft、PyTorch、Transformers、Accelerate、Safetensors 及 Pillow。提供內容沒有 GGUF 檔案、GGUF 檔案大小、量化級別、mmproj、上下文長度、Ollama、LM Studio 或 llama.cpp 支援資料,亦沒有 MTP draft speculation 或正式 benchmark 數字;硬件需求只能按完整 Transformer 約 14.2 GB bf16 權重另行規劃。

模型

Categories: Qwen, Image, 影像模型, 影像處理, txt2img, Python, 庫, Dataset 數據集, LoRA

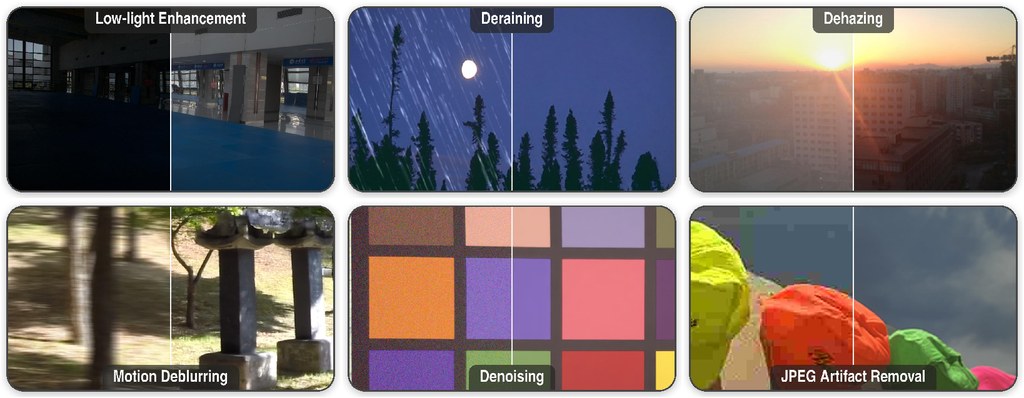
ImIR 免提示詞處理六類影像修復,

ImIR 讓同一個影像修復模型自行判斷輸入問題,毋須提示詞或降級標籤,涵蓋六種常見修復工作。

ImIR examples for low-light enhancement, deraining, dehazing, deblurring, denoising, and JPEG artifact removal. Each til

遇到低光、雨痕、霧化或 JPEG 壓縮痕跡時,ImIR 會只從輸入影像推算修復指令,不要求使用者先判斷問題類型。這個項目屬於影像修復模型與推理工具,實際處理的是一個模型難以同時應付多種退化、又依賴文字提示詞的工作流程。

ImIR 把影像分成兩條路徑送入 Qwen-Image-Edit-2511:VAE 保留空間結構,Qwen2.5-VL 配合輕量 token mapper 產生接近乾淨影像的語義指令;主幹模型保持凍結,只訓練一個共享 LoRA adapter。指令強度可以調節,低光增強等答案不唯一的任務,因而能在不同修復程度之間取捨。

項目提供 CLI 和 Python API,使用 Python 3.10 或更新版本、具 CUDA 能力的 NVIDIA GPU,並可從 Hugging Face 自動下載 checkpoint。顯存不足時可啟用 CPU offload,但需要足夠系統記憶體。

  • 一個 adapter 覆蓋除雨、低光增強、去霧、去模糊、去噪及 JPEG 瑕疵移除
  • 不需要文字提示詞,也不需要 degradation label
  • 單一 adapter 約三小時、以一張 GPU 完成訓練
  • 匹配比較中,影像指令優於文字 conditioning

對研究人員而言,這種做法適合測試 task-agnostic restoration;影像處理團隊則可用它簡化多任務推理流程。不過項目需要 NVIDIA CUDA 硬件。

項目主頁 · GitHub · 模型

Categories: 開源, Qwen, NVIDIA, Image, 影像模型, 影像處理, Python, LoRA

Taste-Bench :避免把時間和計算資源花在錯路上

AI Agent 要做的選擇,當下往往看似合理,代價卻可能在很久之後才浮現。Taste-Bench 把這類決策分岔整理成測試,檢查模型能否及早選對方向。

Taste-Bench

AI Agent 做長任務時,選錯方向可能要到多個步驟之後才看得出代價。Taste-Bench 是一套評測資料集,讓模型閱讀任務背景、分岔前的操作紀錄,以及兩個候選下一步,再判斷哪個選擇較好;它測試的不是單步答題,而是能否避免把時間和計算資源花在錯路上。

資料集有 502 題,從軟件工程與機器學習研究任務的操作軌跡中整理而成,沒有逐題由專家標註。題目分為兩類:不同嘗試在同一位置分岔,最後結果提供判斷依據;或同一次執行中,Agent 遇到失敗後放棄原路並恢復。研究團隊從 4,657 個候選分岔中剔除過於簡單或無法判定的題目,並以後續結果標示較佳方向。

測試時可從 Hugging Face 取得資料集,按題目提供的紀錄比較模型選擇;程式碼庫亦提供 Python 3.11 以上的快速開始方式。評分要求模型在兩種選項排列順序下都答對,減低單靠固定選位置取得高分的可能。較貼近方向判斷能力,但題目仍集中於 SWE-bench、SWE-bench Pro,以及 METR 的 MALT 研究軌跡,未必涵蓋所有長任務場景。

14 個前沿模型中,最高平均正確率為 59.7%,仍有約四成題目判斷錯誤;當關鍵證據要到更後段才出現,準確率會由 62.3% 降至 21.0%,增加推理預算亦未能改善結果。研究亦報告,透過事後答案蒸餾訓練的 Qwen3.6-27B,在未見任務上的正確率由 30.0% 升至 47.9%;用它提供建議後,SWE-bench Pro 成功率由 14.6% 升至 33.7%。這些結果顯示評測不只用來比較模型,也提供了改善 Agent 決策的訓練方向。

  • 評測核心:在結果尚未揭曉時,從兩個下一步中選出較佳方向。
  • 題目來源:軟件工程與機器學習研究任務的真實操作軌跡。
  • 主要限制:目前 502 題的領域與任務來源有限,不能代表所有 Agent 工作。
  • 適合對象:研究長任務 Agent、比較模型決策能力,或訓練工具使用策略的團隊。

項目主頁 · GitHub

Categories: 開源, Agentic, 模型訓練, Qwen, 工具, Python, Dataset 數據集

OmniVChat:測試 AI 能否同時聽懂及看懂

直接把聲音和影像交給AI,回覆是否仍有根據?OmniVChat 提供評分工具,但測試與訓練分數不能混用。

OmniVChat: Synthesizing, Benchmarking, and Training for Native Audio-Visual Dialogue

讓AI直接接收用戶的聲音和影像,再以文字回答,OmniVChat(Omni Video Chat)提供了檢驗這類對話的評估與訓練獎勵工具。問題藏在影音之中,不另附文字提問、外部影像描述或自動語音辨識(Automatic Speech Recognition,ASR)轉錄,適合測試多模態模型能否連結所見所聞。

OmniVChat-Bench包含2,800段合成對話,按分層準則評分,涵蓋五類能力:

  • Dialogue-State & Link Perception(DSLP):理解對話狀態與連結。
  • Multimodal Entity Alignment(MEA):把說話對應至正確的可見實體。
  • Model Self-Awareness(MSA):交代自身身分與物理限制。
  • Anti-Hallucination(AH):回答以影音證據為依據。
  • Emotion Recognition(ER):結合面部與聲線辨識情緒。

評估分數r(y)介乎0至1,以Subcategory Mean匯報;OmniVChat-RL共用評分核心,另加格式、效率與風格獎勵,範圍為0至1.5,兩者不能直接比較。

研究團隊可先查看儲存庫的評分程式與範例,再到Hugging Face取得完整標註及媒體。這個項目只提供程式碼、範例與文件;合成對話的結果亦不足以單獨判斷模型在真人影音互動中的可靠程度。

GitHub

Categories: 開源, 香港中文大學, 阿里巴巴, 多模態模型, Video, Audio, 工具, 庫, 語音

Page 8 of 27
1 … 6 7 8 9 10 … 27