LLM_Modularity:MIT 研究拆解 LLM 模組化認知架構

同一類推理會反覆動員同一批神經元,跨領域則明顯分開。這個項目把 LLM 內部的「分工」做成可重跑的分析流程。

probe.py types a reasoning prompt for each cognitive domain; the model

人腦展現出顯著的功能特化程度,不同的神經網路分別支持語言、形式推理、對他人心智的推理以及對物理世界的推理。這種模組化組織是智慧系統建構的基本原則,還是生物大腦特有的進化偶然現象?本文檢驗了大型語言模型(LLM)——另一類透過截然不同的最佳化過程所建構的智慧系統——是否也呈現出類似的組織結構。

值得留意的不是它再講一次模型會推理,而是它嘗試回答:大型語言模型做語言、數理、物理同社交推理時,內部是否真的有近似人腦功能網絡的分工。Pengrui-Han/LLM_Modularity 屬於研究分析工具與資料流程項目,核心工作是用 attribution patching、neuron overlap 同 causal ablation,定位 46 個任務在四個認知領域各自依賴的神經元群。

結論唔止停留在可視化。項目整理出六個 24B 至 123B frontier LLMs 的一致結果:同領域任務的神經元重疊高出 4.3 倍,ARI = 0.78;把某個領域相關神經元做 lesioning 或 ablation,該領域準確率下降幅度比跨領域高 10.3 倍。換句話說,模組化唔係單靠圖像解讀,而係有因果干預支持。

跟一般只看 attention pattern 或 embedding 聚類的做法相比,這個項目更著重「哪些單元真的支撐任務完成」,所以會用 full-sequence teacher-forcing metrics、corrupted-activation ablation,同按模型家族調整的 nnsight 載入流程。代價亦很直接:它不是輕量級 demo,需要 Linux、torch 2.10.0、nnsight 0.4.1,同 NVIDIA GPU;24B 至 123B 模型更要多 GPU 才較可行。

  • 覆蓋 Language、Formal reasoning (Multiple-Demand)、Physical reasoning、Social reasoning (Theory of Mind) 四類推理
  • 提供 46 個任務配置、clean/corrupted data pair、分析腳本與已整理 results CSV
  • 重點不在訓練新模型,而在檢查現有 LLM 內部神經元是否出現穩定分工
  • 已附 figures、overlap matrix 同 ablation analysis,適合延伸做復現或二次研究

較適合做 mechanistic interpretability、認知科學、AI 安全,或者想比較 Qwen、其他大型模型內部推理結構的研究團隊。它暫時更接近研究管線,而不是即裝即用產品;不過資料夾結構、config、scripts 同 results 已經足夠完整,對想重跑實驗、改任務集,或者把 OSWorld 以外的複雜推理基準接入分析流程的人,參考價值相當高。
項目主頁 · GitHub

Categories: 開源, Embedding, Qwen, NVIDIA, Linux, 安全

SimpleOPD 把長思維蒸餾帶到異 tokenizer 學生模型

長上下文教師模型唔難找,難的是點樣穩定轉移到短上下文學生模型。SimpleOPD聚焦呢個落差,做法比一般蒸餾更貼近訓練現場。

Repository image for hhnqqq/SimpleOPD

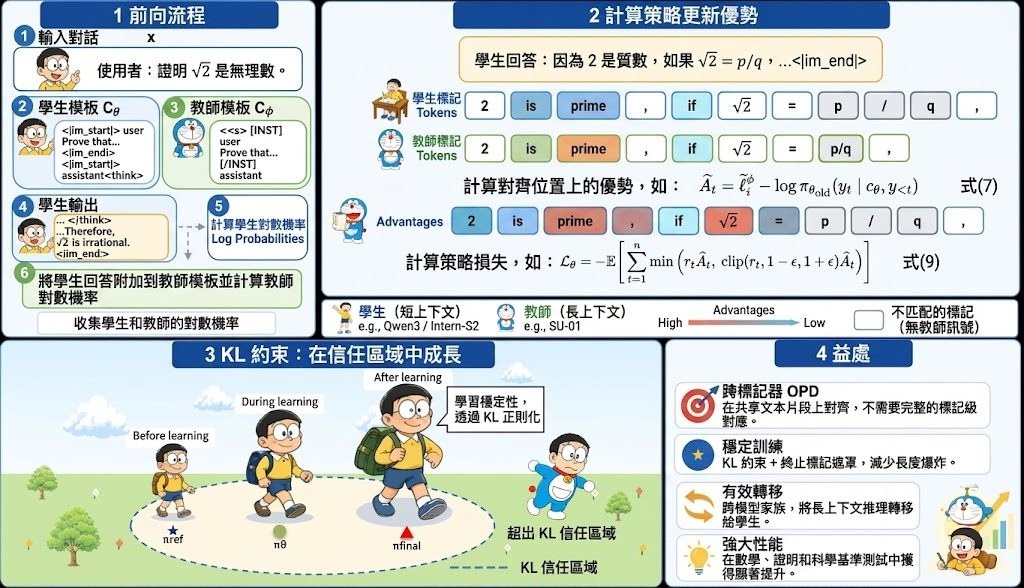
想把長上下文推理能力交到較細、較短上下文的學生模型,卡位往往唔係只有模型強弱,而是 tokenizer 不同、輸出愈蒸餾愈長,最後連訓練都變得唔穩。SimpleOPD屬於模型訓練方法項目,處理的是 long-context reasoning teacher 到 short-context student 之間的 On-policy distillation(OPD)轉移,重點放在跨 tokenizer 仍然可以學到推理能力。

它冇硬做 token-level 對齊,而是改在 shared text space 對齊,只監督師生 tokenizer 剛好切出相同文字跨度的位置。呢個取捨很務實:少了強行對齊帶來的噪音,代價是可監督位置會收窄,但換來 arbitrary teacher-student tokenizer combinations 也能成立,對 Qwen3、Qwen3.5、Intern-S2、GLM-4.7、Gemma4 這類不同家族學生模型都更有通用性。

另一個關鍵,是它直接處理「答案愈生愈長」這個訓練現象。SimpleOPD加入 student-reference KL loss,再對 </think><|im_end|> 這類終止 token 做 advantage masking,目的不是單純加正則化,而是壓住學生模型偏離初始 policy 太遠,減少 teacher-student distribution mismatch、截斷率上升與訓練失穩。

  • 支援 long-context teacher 產生 100K+ token reasoning chains
  • 以 shared text space 對齊,避開 tokenizer 不一致帶來的蒸餾障礙
  • 透過 student-reference KL loss 與終止 token masking 控制長度膨脹
  • 在 ProofBench 對 Intern-S2-Preview 帶來 +21.2 分,升至 55.2
  • 結果已超過 Gemini-2.5-Pro,並提到對 HLE、HiPhO 也有外溢收益

它不是即裝即用的線上服務,而是偏研究與訓練流程的開源項目;環境依賴 SLIME 0.2.3、Python 3.10+、PyTorch 2.0+,並為 GPU、HTTP-based teacher inference、timeout、concurrency、batch processing 留好接口。受益最大的會是做蒸餾訓練、想把強教師推理能力壓到較易部署學生模型的團隊,尤其是要跨 tokenizer、又不想被超長 reasoning chain 拖垮訓練穩定性的情境。

項目主頁 · GitHub

Categories: 開源, Qwen, OpenAI, Gemini, Python

S²VOPD 讓小模型看少一點,Qwen3.5-4B 反而看得更準

S²VOPD 透過削弱學生模型的視覺資訊,在零標註下提升細粒度感知與數學推理表現。

UC San Diego

小模型面對圖片時,減少它能看到的資訊,竟然可以帶來更好的學習訊號。Self-Supervised Visual On-Policy Distillation(S²VOPD)是一種視覺模型訓練方法,透過讓學生模型觀看低解析度、加入隨機 Gaussian noise 的圖片,處理沒有標註、獎勵或更強教師模型可用的限制。

訓練期間,學生模型會根據受干擾的圖片產生回答;採用 Exponential Moving Average(EMA)的教師模型則以原始圖片評分相同的生成前綴,再利用 top-k generalized Jensen-Shannon divergence(JSD)把較完整的 token 分佈傳給學生。教師與學生之間的資訊差異,來自學生少看一點,而不是額外加入 privileged information。

• Qwen3.5-4B 在六項細粒度感知基準的平均準確率,由 70.7% 升至 77.4%
• 4B 模型表現高於 Qwen3-VL-Instruct-235B 的 75.8% 和 GPT-5.4 的 72.8%
• 不需要 labels、rewards、region annotations 或更強教師模型
• 4B 同時提升感知表現 5.7% 和數學推理 3.7%

S²VOPD 使用學生視角縮放至原圖 0.3 至 0.6 倍,並加入 stochastic Gaussian noise。結果顯示,這種做法不只改善視覺感知,也能避免部分 privileged-information 方法在數學推理上的退步;例如 Oₚₛd 和 ZwZ 在部分 MathVision、MathVerse 測試中出現明顯下降。

這項方法較適合研究小型多模態模型訓練、視覺推理和自監督學習的讀者。現有結果集中於六項細粒度感知基準及數學推理測試,能否穩定延伸至其他資料、模型架構和更複雜影像任務,仍需要進一步驗證。

項目主頁

Categories: 開源, 模型訓練, Qwen, Image, Dataset 數據集

Qwen3.8 系列的 27B 開放權重模型

Qwen3.8-27B以 27B 密集模型同時處理文字、圖片與影片,重點不只在識別內容,而是更穩定完成多步驟任務。它延續 Qwen3.5 架構,但頁面公開的本地量化與 GGUF 資訊仍未齊。

Og image

Qwen3.5 的架構基礎延伸而來,Qwen3.8-27B把長流程推理、Agentic 任務同原生視覺理解放入同一個 27B dense 模型。使用時最直接的差異,是它不只看圖答題,亦針對編程、專業工作、研究與多步驟任務完成度作強化,並保留可調整的 thinking control。

模型層面採用 Causal Language Model with Vision Encoder,屬於經過 pre-training 與 post-training 的 image-text-to-text 模型。27B 參數、64 層、hidden size 5120,以及混合 Gated DeltaNetGated Attention 的 hidden layout,反映它不是單純沿用傳統 dense Transformer 堆疊,而是針對長程依賴與效率作結構調整。

Qwen 3.8 27B BLOWS MY MIND! Best Local AI Model Yet! Basically Opus Locally! (Fully Tested)

對開發者而言,較有用的是推理行為控制:thinking mode 預設開啟,可按請求關閉;reasoning_effort 可調整推理深度;preserve_thinking 可保留歷史訊息中的 reasoning context。

  • 基礎模型可確認為 Qwen3.5 架構系統上的後訓練版本,而非獨立另起爐灶
  • 原生支援圖片與影片理解,定位比純文字模型更貼近 Agentic 與多模態工作流
  • 相容 Transformers、vLLM、SGLang、TokenSpeed,方便接入現有堆疊
  • 頁面未提供 GGUF 格式、量化檔名、mmproj、Ollama/llama.cpp/LM Studio 建議配置
  • 亦未見 MTP draft speculation、v2 檔名變更或 chat template 注意事項的具體說明

與同系前代相比,Qwen3.8主打的是可靠完成整段任務,而不只是單輪回答更聰明;與一般視覺語言模型相比,它更強調 environment feedback 下的自主規劃。目前公開的是 Transformers 格式權重與設定檔,未足以直接判斷本地量化部署門檻,所以硬件需求、推薦量化等級與不同量化之間的取捨,現階段只能等後續模型檔或社群移植版本補上。

模型

Categories: Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, API, 編程

Qwen3.8-2.4T-A95B 超大型開放權重文字推理模型

Qwen3.8 把 Qwen-Max 級別能力帶到開放模型,強項不只是答題,而係更穩定完成多步驟工作。

Og image

Qwen3.8-2.4T-A95B 把 Qwen-Max 級別的能力開放出來,而且明確建基於 Qwen3.5 的架構底層,BF16 safetensors 格式及1M上下文。定位上屬於 Causal Language Model,面向文字生成、編程、研究工作與長流程 Agentic 任務;相比只追求單輪回答,它更著重規劃、接收環境回饋,以及把多步驟工作做完。

Qwen3.8-2.4T-A95B 的核心規格相當進取:總參數 2.4T(2.4 trillion)參數,但每次啟動 95B,屬於典型大型 Mixture of Experts(MoE)路線,用較高總容量換取較可控的推理成本。模型經過 Pre-training 與 Post-training,並採用 Qwen3.5 架構延伸而來的層設計,包括 Gated DeltaNet、Gated Attention 與 MoE 組合,重點不是單純堆大,而是提升長鏈推理與任務完成的穩定性。

Qwen3.8-2.4T-A95B 主要來自兩個控制點:reasoning_effort 可調整推理深度,preserve_thinking 可保留歷史訊息中的 reasoning context。這代表它比較適合需要反覆修正、逐步執行的工作流,而唔係只看一次輸出的場景。頁面亦提到它對常見 harness 與開發工具有更廣泛支援,模型檔案可配合 Transformers、vLLM、SGLang、TokenSpeed 等推論堆疊。

  • 基礎模型可確認是建基於 Qwen3.5 architectural foundation。
  • 已知開放的是 Hugging Face Transformers 格式的 post-trained 權重。
  • 官方另有 Qwen3.8-Max 版本,功能更多,包含 vision input、non-thinking support、內建工具,以及預設 1M context length;但這些能力屬於官方服務版本,不應直接視為此頁權重全部具備。
  • 從已公開資訊看,它的優勢在於長流程 Agent 執行與專業工作可靠度提升;限制是硬體需求、完整上下文長度與量化部署細節未在此頁交代,離本地輕量部署仍有距離。

跟一般只強調 benchmark 分數的模型相比,它更強調任務完成率、規劃能力與工具鏈兼容性。由於缺少量化版本、推理記憶體需求與更完整評測數字,現階段較適合把它理解成面向高階推論服務與大型基建環境的開放權重,而不是即插即用的本地模型項目。

模型

Categories: 開源, Agentic, 模型訓練, Qwen, API, LLaMa, Ollama, 編程, Dataset 數據集

NanoVDR:70M 文字編碼器取代 2B VLM:視覺文檔檢索的輕量化新嘗試

NanoVDR 把 2B 參數嘅視覺語言模型蒸餾成 69–151M 嘅純文字編碼器,查詢時完全唔需要視覺模型,CPU 51 毫秒即可完成。

NanoVDR

處理幾十萬張文件圖片嘅時候,每次查詢都要過一次 2B 嘅視覺語言模型(VLM),開銷大到令人卻步。NanoVDR 想解決嘅就係呢個落差:文件索引由教師模型離線建好,查詢階段只用一個 DistilBERT 規模嘅純文字編碼器,CPU 上 51 毫秒出結果,2048 維嘅單一向量直接做點積,扔得入 FAISS。

佢嘅做法係將 Qwen3-VL-Embedding-2B 凍結做教師,提早把目標向量快取落嚟,學生只係學一個餘弦距離嘅 loss——即係 loss = 1 - cos(student, teacher)。訓練時冇相關性標註、冇負例採樣,兩邊完全解耦,所以查詢端同索引端可以分開換組合。DistilVDR 進一步把文件端都換走,做到成個流程都唔再需要教師。

對於做企業 RAG、法律文件搜尋、學術庫檢索嘅團隊,最大吸引力係每頁索引得 4 KB,比 ColPali 嗰類多向量檢索慳 64 倍儲存,而且唔使 GPU 即可頂住查詢負載。ViDoRe v1 上面,NanoVDR-S-Multi 拎到 82.2 NDCG@5,保留咗教師大約 95% 嘅能力,呢個取捨對批量部署嚟講好實際。

重點摘要:

  • 極輕量查詢端:文字編碼器僅 69–151M 參數,無需視覺模型參與查詢
  • 高效索引:每頁僅 4 KB(float16),比多向量方案節省約 64 倍儲存
  • 簡易整合:輸出為單一向量,FAISS 即可處理,無需 MaxSim 池化
  • 教師-學生解耦:目標向量預先快取,兩端可獨立訓練與組合
  • 完整資源:模型、訓練數據集、線上 Demo 同論文均已開源

多向量查詢塔嘅程式碼已就位,但 checkpoint 要等 NanoVDR-v2 先出齊,想要更高召回嘅人需要留意後續更新。

項目主頁 · GitHub

Categories: 開源, RAG, Embedding, 模型, 視覺模型, 多模態模型, Qwen

Ex-Omni-2D 直接對話生成同步發聲與表情的數字人影片

Ex-Omni-2D 讓對話模型同時輸出文字、個人化語音與表情同步的頭像影片,以多碼本語音單元串接語音與畫面,並提供 Teacher 與 Prefix-Streaming Student 兩種部署模式。

Ex-Omni-2D framework

想讓 AI 數字人不只是「會打字」,而是真的「邊說邊演」?香港中文大學(深圳)與 LIGHTSPEED 合作開源的 Ex-Omni-2D,正是針對這個目標設計。它是一個開源對話框架,接受多模態查詢、參考圖像與參考音訊後,先由語言模型輸出一份結構化的 Visual Thought Plan(VTP),再依此生成文字回應、個人化語音,並產出嘴形與動作同步的頭像影片。

傳統做法通常把語音合成與人物影片視為兩條獨立管線,需要額外對齊文字、聲音與嘴形,容易出現時間錯位。Ex-Omni-2D 的差異在於採用 16 個 codebook 構成的原生多碼本語音單元,作為語音與影片共享的聲學與時序介面:同一組語音單元既驅動 TTS,也作為影片生成器的緊緻條件,從而降低跨模態錯位的風險。

影片生成路徑提供兩種互補模式:Full-sequence Teacher 採雙向注意力,追求最高畫質;Prefix-Streaming Student 則是蒸餾而來的少步數 block-causal 版本,支援 2、4、8 步串流推論,方便在工作站、GPU 伺服器甚至 Hugging Face Spaces 上做漸進式部署。

這個項目的重點:

  • 對話原生影片:視覺行為直接從多模態對話上下文規劃,不必再手動撰寫影片提示詞。
  • 結構化 VTP:明確定義首幀、場景、情緒、動作風格與動作細節,方便後續控制與除錯。
  • 共享語音介面:16 個 codebook 同步驅動語音合成與人物動作。
  • 品質與效率取捨:Teacher 負責最高畫質,Student 支援 2/4/8 步串流。
  • 彈性部署:同一套代碼可在個人工作站、GPU 伺服器或 HF Spaces 執行,並提供線上 Demo 試玩。

在串流場景中,作者指出 Prefix Streaming 從第 9 至 16 chunk 的一致性明顯較強,將 last-to-first consistency error 降低 21.4%,這對需要長時間維持角色身份一致的應用相當關鍵。論文亦提到 Prefix Streaming 能減少長序列累積形變,同時保留參考圖像的人物外觀。

較適合的對象包括需要快速打造可對話 AI 助手、虛擬主播、客服分身或教學數字人的團隊;對研究多模態對話、語音驅動動畫的人來說,這份開源代碼、模型權重與 arXiv 論文也是一個方便的起點。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 騰訊, 文字轉語音, AI productions, 數字人, 多模態模型, 視頻模型, Qwen, 香港, 語音

RynnValue 用秒估計機械人完成時間

它不只判斷機械人有冇做對,仲會估計距離完成仲差幾多秒。呢種時間式價值訊號,令強化學習獎勵設計變得直接得多。

RynnValue overview

機械人操作最難的不只是識別動作成敗,而是要持續知道距離完成指令仲有幾遠。RynnValue 就是針對呢個空缺而來的模型項目:它把機械人影片連同文字指令一齊讀入,逐格預測剩餘完成時間,並輸出自然語言分析,讓進度估計、失敗偵測與 VLA(vision-language-action)policy 的獎勵建構可以共用同一套訊號。

它和常見進度分數或偏好標註做法的分野很清楚。RynnValue 不靠人工標出「較好」軌跡,也不把進度硬壓成 0 到 1,而是直接學習 goal-conditioned cost-to-go 的物理時間;標籤來自時間戳,配合子任務切分與 cutoff relabeling,於是能擴展到 7,000 多小時、約 300 萬段 instruction-conditioned clips 的異質機械人資料。這個取捨帶來的好處是可擴展,代價則是模型必須更好地處理長尾任務時長與不同視角、不同 embodiment 的差異。

RynnValue 連同完整工具鏈一併提供。你可以把它理解成一套由 HuggingFace 相容模型、影片推理示範,到 reward-model benchmark 與強化學習介面都包起來的研究型工具組;當中 RynnValue 建基於 RynnBrain,實作在 Qwen3-VL architecture 之上,除了預測 absolute 與 relative temporal value,亦會生成影片描述,並判斷 instruction–video 是否匹配、任務是否成功。

  • 核心能力是把「距離完成尚餘幾多秒」變成稠密 value signal
  • 訓練毋須 preference 或 progress annotations,較易放大量異質資料
  • 8B 版本在 RBM-EVAL-OOD 的平均 Kendall’s τₐ 達 0.675,高於文中對照的 fully preference-supervised 方法 0.655
  • 可直接接到 reward shaping,用作 policy ranking、evaluation 與 reinforcement learning critic

為免模型偷看序列位置去猜進度,作者加入 temporal-order shuffling、random temporal sampling,以及 value-isolation attention;消融結果亦顯示這些設計不是裝飾,拿走後指標會明顯下跌。再進一步,它把輸出的 value 轉成 potential-based shaping reward,在雙臂 Franka 的真實機械人學習中,無論 online 定 offline 都比最強 reward-model baseline 有更高成功率。

最受惠的會是做機械人操作、VLA 訓練、reward modeling 與 embodied AI 評測的團隊,尤其想減少人手標註成本、又需要跨資料來源泛化能力的人。限制同樣存在:這類時間距離訊號雖然比二元成敗更細緻,但對任務切分、影片品質與觀測覆蓋仍然敏感,而且它目前聚焦於 robot manipulation,不代表可直接外推到所有 agent 場景。

項目主頁 · GitHub · 模型

Categories: 開源, 阿里巴巴, Agentic, 視覺模型, 多模態模型, 模型訓練, Qwen, Video, VLA, Robotic, Dataset 數據集

StreamArena 多模態長片代理的記憶與互動分析

來自香港科大、港大與中大及小紅書的團隊,把長達近 90 分鐘的影片理解拆成可持續觀察、回想、找工具與主動回應四種能力。

StreamArena overview

由 HKUST(香港科技大學)、The University of Hong Kong(香港大學) 與 The Chinese University of Hong Kong(香港中文大學) 及小紅書組成的開發團隊,將焦點放到一個很多多模態代理都未真正處理好的難題:影片唔再係幾秒剪輯,而係接近一個半鐘頭、仲要持續互動。StreamArena 屬於資料集與評測工具包,處理的是 continuous streaming video understanding,目標係用統一方法檢驗代理在長時間影音流之中,能否即時理解、隔一段時間後仍然記得內容,並在合適時機用工具或主動回應。

呢個項目最值得注意的地方,在於它唔用短片加選擇題去掩蓋模型弱點,而係用 243 段 full-length videos、平均 88.8 分鐘、合共 3,646 個 open-ended tasks,分成 Real-Time Perception (RTP)、Historical Retrospection (HR)、External Tool Use (Tool) 同 Proactive Interaction (Pro)。HR 與 Pro 仲按時間跨度分層,HR 最遠拉到 30 分鐘,直接把長期記憶與延遲控制的取捨攤開來測。

StreamArena Evaluation Toolkit:streamarena/ 放資料載入、媒體處理、tool-call protocol、OpenAIBackend、GeminiBackend 同 LLM-as-Judge scorer;method/ 則整理多種被測方法,包括 offline 的 Qwen、MiMo、Kimi、Qwen-Omni、Gemini,以及 MiniCPM-o-4.5、VST、StreamForest、ThinkStream。所有方法都寫入同一套 records JSONL schema,所以 judge/ 可以用同一把尺評分。安裝與執行細節在目前資訊裡未完全展開,但可確認它不是單一模型倉庫,而是用來重跑、對齊與比較不同方法的評測框架。

  • 覆蓋四類能力:RTP、HR、Tool、Pro,唔只問答,仲測持續監看與主動互動
  • 243 段長影片、平均 88.8 分鐘,資料規模明顯偏向長時序理解
  • 同一份 JSONL 輸出格式配合通用 judge,方便橫向比較不同方法
  • StreamMind 在同一 Qwen3.5-397B-A17B backbone 上,把 pooled query-to-answer latency 降低 66.2%

一個重要限制:StreamMind 在這次釋出裡只有 evaluation protocol docs,未附完整可直接重現的實作;AURA 亦只提供 client,server 仍要依賴官方 vLLM。換句話說,StreamArena 現階段更像研究團隊、代理系統開發者同多模態評測工作流會用到的基礎設施。想比較不同 streaming method、檢查長影片代理究竟卡在記憶、反應,還是工具調用,呢個項目比一般短片 benchmark 更接近部署前要面對的現實。

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 香港大學, 香港科技大學, Agentic, 多模態模型, Qwen, Gemini, Video, 香港, Kimi

Wan-Animate-2 把角色動畫推向即時互動

同一張角色圖,已經可以跟住驅動影片做出更穩定動作,連鏡頭角度都可另外控制。Wan-Animate-2想解決的,不只是畫面靚唔靚,仲包括直播同數字人能否即時用。

Og image

一張角色圖片配合一段驅動影片,便可以生成動作自然、表情細緻的角色動畫,這正是 Wan-Animate-2 想處理的核心場景。它屬於角色動畫生成框架,重點不只放在畫質,還試圖解決身份容易走樣、動作細節流失,以及難以支援即時互動這幾個長期卡位。

跟不少依賴中間動作表示的方法不同,Wan-Animate-2 直接把 driving video 餵入重新設計的 Diffusion Transformer,避開 motion extractor 帶來的誤差與 identity drift。這種端到端做法的好處,是角色外觀保持得更穩,細微表情、複雜肢體動作,甚至角色與場景之間較合理的互動,都更容易保留下來。

它另一個值得留意的能力,是加入 text-driven viewpoint control,令輸出鏡頭角度可以跟驅動影片分開控制。對數字人、直播主持、虛擬角色演出這類互動工作流來說,這代表同一段驅動內容不一定要綁死原本視角,使用時更容易配合不同畫面需求。

  • 直接使用 driving video,而不是先抽取中間動作表示
  • 主打更穩定的 identity preservation 與 motion fidelity
  • 支援 text-driven viewpoint control,可分離鏡頭視角與驅動動作
  • 推出 Wan-Animate-2-Lite,目標是把推理延遲壓到即時門檻
  • 預告公開 Wan-Animate-2-Base 權重,方便社群延伸研究

為了走向即時應用,團隊亦提出 Wan-Animate-2-Lite,並用三階段訓練流程去降低 inference latency,包括 teacher forcing pretraining、error buffer mechanism,以及 Self-Forcing distillation 配合 chunk-wise backpropagation。現有結果與使用者研究顯示,它在多種角色和動作模式下都有不錯的高保真表現;不過目前公開資訊仍以研究展示為主,部署成本、硬件需求與長時間串流穩定性,仍要等更多公開細節驗證。

項目主頁

Categories: 阿里巴巴, 視覺模型, Video, Image, 動畫

Page 5 of 18
1 3 4 5 6 7 18