Qwen-VLA 用單一模型打通機械人任務

Qwen-VLA把操作、導航與軌跡預測放入同一個模型。重點在跨機械人平台與跨場景泛化能力。

Hero image preview

Qwen-VLA 是一個把視覺、語言與動作整合起來的項目,目標是用同一套模型處理機械人操作、導航,以及軌跡預測。過往很多 embodied intelligence 系統都只針對單一任務或單一機械人設計,結果是能力分散,換場景、換任務或換機體後便難以沿用。

這個項目以 Qwen3.5 Vision-Language Model 為基礎,再加入 DiT-based action decoder,令模型不只看圖和理解文字,還能產生連續動作與軌跡。研究團隊亦加入 embodiment-aware prompt conditioning,用機械人專屬文字描述去標示當前機體與控制方式,讓同一模型可支援多種 robot embodiments。

核心概念是把不同類型資料一同訓練,包括 robotics manipulation trajectories、human egocentric demonstrations、synthetic simulation data、vision-and-language navigation data,以及 auxiliary vision-language data。對開發者來說,這代表項目不是只做問答或只做控制,而是把 manipulation、navigation 與 trajectory prediction 放進同一個 action-and-trajectory prediction 框架。

重點可先看以下幾項:
– 用單一 Vision-Language-Action Model 處理多類 embodied 任務
– 同時支援文字回應、動作生成與軌跡生成
– 透過 embodiment-aware prompt conditioning 適配不同機械人平台
– 強調 out-of-distribution generalization,涵蓋光線、背景、物件配置與機體變化
– 適合研究通用機械人控制、跨任務遷移與多平台部署的人員

論文列出 Qwen-VLA-Instruct 在多個基準上有不錯表現,包括 LIBERO 97.9%、Simpler-WidowX 73.7%、RoboTwin-Easy/Hard 86.1/87.2%、R2R 的 69.0% OSR、RxR 的 59.6% SR;在真實世界 ALOHA 實驗亦錄得 76.9% average OOD success,在 DOMINO dynamic manipulation 有 26.6% zero-shot success rate。若你關注的是一個可橫跨任務、環境與 robot embodiments 的通用型項目,展示了統一式 Vision-Language-Action Modeling 的清晰方向。
Paper: https://arxiv.org/pdf/2605.30280

Categories: 阿里巴巴, Agentic, 模型, 世界模型, 中國

CollectionLoRA:把多個效果 LoRA 濃縮成一個

把 50 甚至 180 個效果 LoRA 集中到單一 LoRA,減少部署成本,也降低多重 adapter 疊加帶來的干擾。

Repository image for Qwen-Applications/CollectionLoRA

CollectionLoRA 是一個針對 LoRA 管理成本而設的項目,核心做法是用 multi-teacher on-policy distillation,將多個效果 LoRAs 的概念,以及 few-step generation 能力,一次過蒸餾進單一 LoRA。對一般使用者來說,意思就是原本要為不同效果切換或串接多個 adapter,現在有機會改用一個整合版本處理,流程會更簡潔。

使用這個項目時,重點不是由零開始訓練,而是先按項目提供的 ckpt/ 結構放好權重,之後以 50_in_1/ 作推理用途。倉庫亦提供公開的 training and inference code,而 data/manga_tone/ 內有起步用的 teacher LoRA 和示範訓練資產,方便了解整個資料與模型配置方式。

它解決的問題相當明確:當效果 LoRA 數量愈來愈多,部署、切換與疊加都會變得麻煩,配合 acceleration modules 時,還可能出現互相干擾。CollectionLoRA 嘗試把「多效果」與「少步數生成」合併到同一個 LoRA,這比單純收藏大量 LoRA 更像是重新整理整個工作流。

項目公開的重點包括幾個方向:
– 可把 50→1,甚至 180→1 的效果教師整合到單一 LoRA
– 在 EffectBench 上,文中稱其於 8 NFE 下可取得較高 VSA 與較低 BCR
– 支援 zero-shot 的 A ⊕ B 組合效果,推理時可配對兩個已訓練教師,無需額外訓練
– 已開放 training and inference code,但 model weights 仍標示為未全面開放

這個項目較適合會接觸生成效果控制、需要管理大量 LoRA 的研究者與開發者,也適合想減少部署複雜度的團隊。若你關心的是把多種風格或效果整合成較易分發的模型形式,CollectionLoRA 展示的方向很有參考價值;不過現階段公開資訊主要集中在框架、指標與示範資產,完整權重供應情況仍要留意項目後續更新。

GitHub: https://github.com/Qwen-Applications/CollectionLoRA

Categories: 開源, 阿里巴巴, 視覺模型, 影像模型, 影像處理, 框架

TransitLM:點樣評估生成巴士地鐵路線

這項目不是用來規劃路線,而是專門檢查模型生成的路線是否合理。它把評分拆細,較易看清模型錯在邊一層。

Repository image for HotTricker/TransitLM

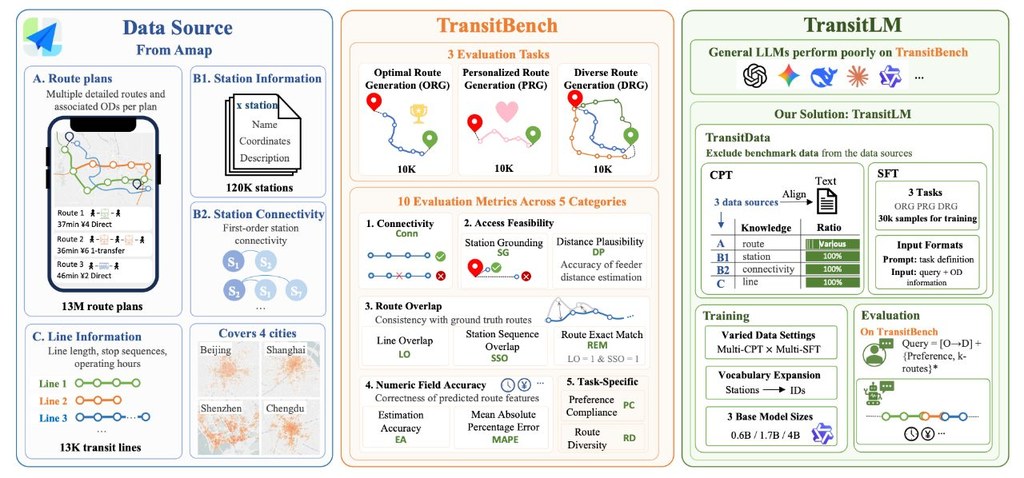
TransitLM 重點不是直接幫你找車程,而是提供一套評估流程,專門量度模型生成公共交通路線的表現。它配合同名論文與資料集使用,主要服務「不靠地圖引擎、直接由資料學出路線」這類研究方向。

項目已經附上示例 CSV,並按不同情境分成幾個評估腳本,包括單一路線、偏好路線、多路線多樣性,以及透過遠端 API 評估一般大語言模型輸出。因為只依賴 Python 標準函式庫,環境要求相對輕巧,想重現論文評估流程的人會較容易開始。

這個項目最值得留意的地方,是它不只給一個總分,而是把結果拆成多層來看,例如路線是否可達、站點是否對應得上、整體結構是否一致,以及時間、距離、票價估算是否可信。對比只看「答得似唔似」,這種分層做法更容易找出模型到底是認錯站、接錯線,還是只在數值估算上失準。

  • 支援四類評估情境,覆蓋論文基準與一般 LLM 輸出
  • 評分拆成多個維度,比單一總分更有診斷價值
  • 可檢查偏好是否符合,例如少轉車、避開地鐵等
  • 多路線模式會額外比較替代路線與多樣性
  • 安裝負擔低,適合重現與快速驗證

從論文資訊看,TransitLM 背後資料規模相當大,涵蓋超過 1,300 萬筆公共交通規劃紀錄、四個中國城市、120,845 個站與 13,666 條路線;相關研究亦提到模型可在沒有明確地圖對接下,學到站點對應與路線結構。不過這個儲存庫本身偏重「評估」而非「訓練」,所以較適合研究人員、做交通路線生成的模型開發者,或者想比較 GPT、Qwen 這類一般模型在路線任務上表現的人。

整體來看,TransitLM 的價值在於把一個很易流於主觀的任務,整理成可重現、可分解、可比較的評估項目。對非專業讀者來說,可以把它理解成一把較精細的尺:不是幫你直接畫路線,而是幫你判斷模型畫出來的路線,到底有幾可信。

GitHub: https://github.com/HotTricker/TransitLM

Paper: https://arxiv.org/pdf/2605.22355

Categories: 開源, 阿里巴巴, 框架, 中國, Dataset 數據集

FashionChameleon 讓換衫影片更即時

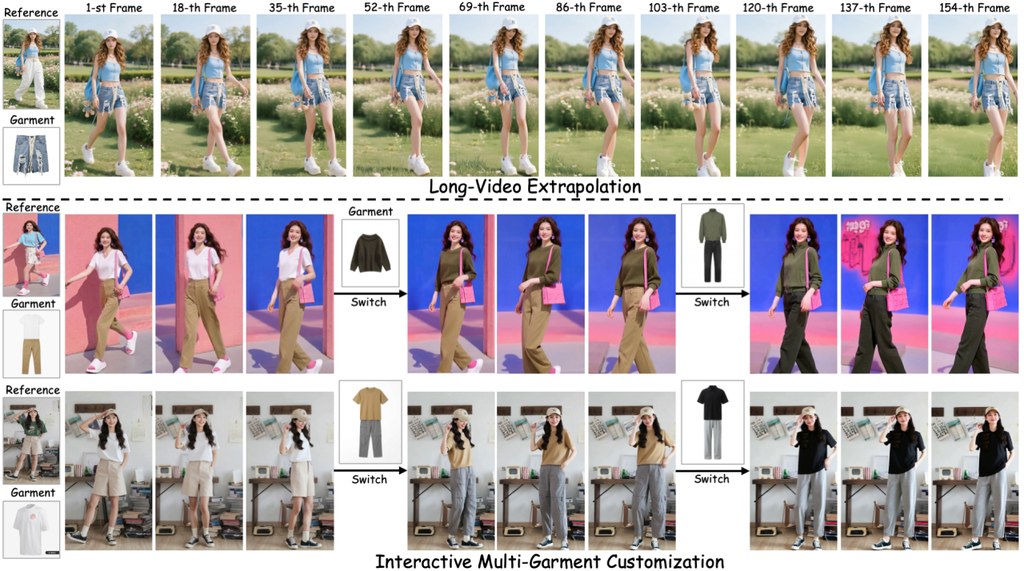
這個研究型專案主打即時換衫影片生成,重點是邊生成邊切換服飾,同時盡量保持動作連貫。

fashionchameleon

FashionChameleon 針對的是一個很實際的問題:想將人物影片中的服飾換款,但又不想等太耐,亦不想一換衫就令動作、姿勢或畫面穩定性明顯走樣。它把重點放在「生成途中仍可互動調整」,對電商展示、短片製作和虛擬試衫概念都幾有參考價值。

現階段較適合把它當成研究成果去了解,而不是即裝即用工具。公開資訊顯示,作者已提供論文和專案頁,但模型權重、前訓練與後訓練程式碼仍未完全釋出;想實際跟進,可先看示範頁面與技術報告,理解它點樣處理單件服飾影片資料,再留意後續更新。

它較特別的地方,在於不用依賴大量「同一人物不停換多套衫」的影片去訓練,改為先用單一參考圖與服飾圖建立學習方式,再透過串流式蒸餾提升長片段一致性。另一個亮點是生成期間可重整快取機制,令服飾切換更貼近即時互動,而不只是預先算好一條片。

重點可留意以下幾點:
– 主打人物服飾層面的影片客製化,而非單純換背景或整體風格
– 強調即時生成,論文提到單張 GPU 可達 23.8 FPS
– 目標是在換衫時保留動作連貫,減少前後畫面跳動感
– 訓練思路偏向用單件服飾資料學出可切換能力
– 現時較多是研究展示,部署門檻仍視乎後續釋出的程式與權重

相關模型方向可聯想到 image-to-video、人像影片生成、服飾替換與自回歸影片模型;文中亦明確圍繞 teacher model、streaming distillation 和 KV cache rescheduling 幾個核心設計。整體來說,FashionChameleon 最吸引之處不只是「識換衫」,而是朝住可互動、低延遲、長片仍較穩定這三件事同步推進,對需要即時預覽效果的應用尤其值得留意。

GitHub: https://github.com/quanjiansong/FashionChameleon

Paper: https://arxiv.org/pdf/2605.15824

Categories: 開源, 阿里巴巴, 視覺模型, 視頻模型

Orthrus如何令Qwen3生成更快

這個專案嘗試在不改變原本輸出品質下,加快大型語言模型生成速度。對想用Qwen3做推理的人尤其值得留意。

Orthrus logo

Orthrus 是一個圍繞 Qwen3 模型建立的生成框架,重點不是做全新聊天模型,而是想辦法令文字生成更快,同時保持與原本基礎模型一致的輸出分佈。對一般讀者來說,可以理解成它想保留傳統逐字生成的準確感,又借用擴散式並行生成的速度優勢。

這類工具主要針對大型模型生成時「要逐個字等」的樽頸。Orthrus 提出雙重架構做法,讓同一個模型同時具備兩種觀看方式,並強調結果是無損的,也就是目標並非用近似答案換速度;根據專案資料,生成可有最高約 7.8 倍加速。

如果你想上手,最直接方法不是自行訓練,而是先試用作者提供的模型檢查點,再用 Hugging Face 的常見載入流程做推理。現時公開型號包括 Orthrus-Qwen3-1.7BOrthrus-Qwen3-4BOrthrus-Qwen3-8B,分別對應 Qwen3 的 1.7B、4B 與 8B 基礎模型。

值得留意的是,它不是靠把整個模型重訓來換速度,而是只微調部分參數,基礎 LLM 保持凍結,同時兩種生成視角可共用同一套高保真 KV cache。對部署者來說,這代表它除了講求快,亦有意控制額外記憶體成本,這點對長輸出或高頻推理場景特別實際。

  • 以 Qwen3 為骨幹,現有 1.7B、4B、8B 幾個版本
  • 重點在提升生成吞吐,而非改變模型用途
  • 強調結果與原基礎模型保持一致,而非近似加速
  • 額外記憶體開銷較低,較適合推理部署評估
  • 對研究者、模型工程師及需要大量文字生成的團隊較有參考價值

整體來看,Orthrus 最吸引之處在於它把「快」與「不走樣」放在同一個方案內處理。若你正關注本地或伺服器端 LLM 推理效能,尤其已經在使用 Qwen3 生態,這個專案很適合作為實驗與比較基準;至於與 vLLM 或 SGLang 的更原生整合,則似乎仍在後續規劃中。

網址: https://github.com/chiennv2000/orthrus

Categories: 開源, 模型, 模型訓練, Qwen, 中國

PAE:令擴散模型更快收斂的潛在空間設計

PAE不是只追求重建清晰度,而是重新整理潛在空間本身。對想提升生成質素與訓練效率的人,這個方向值得留意。

pae teaser

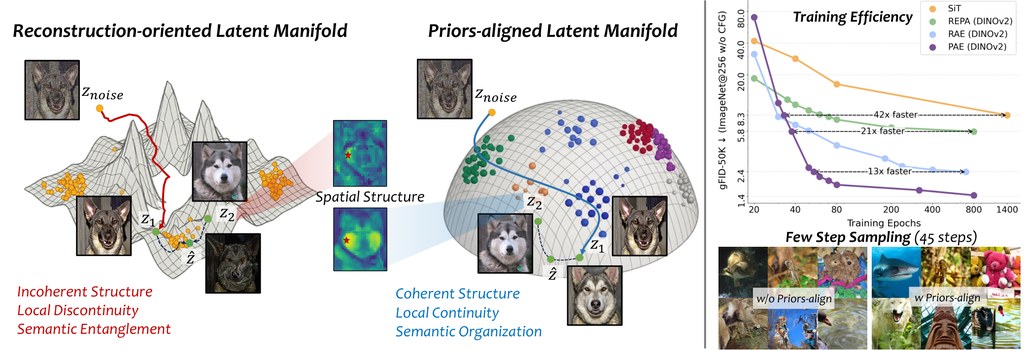
PAE 是一個為潛在擴散模型而設的自編碼器框架,重點不只是把圖片壓縮再還原,而是先把潛在空間整理成更適合擴散模型學習的形態。簡單講,它關心的不是「壓得靚唔靚」,而是「模型之後生圖時會唔會更順、更穩定」。

實際使用上,PAE 可理解為擴散模型前面的 tokenizer 或影像編碼模組:先把圖片轉成 latent,再交畀後續生成模型訓練。這種做法特別適合本身已在做 latent diffusion、但覺得收斂慢、訓練成本高,或者生成效果未夠穩定的研究與開發流程。

這個專案較有意思的地方,是它明確提出三個「對擴散友善」的潛在空間特質:空間結構一致性、局部流形連續性,以及全域語意組織。作者不是假設這些特質會自然出現,而是用三種 prior-alignment regularization 去主動約束,這比單靠重建誤差的傳統思路更進一步。

根據專案提供的結果,PAE 在 ImageNet 256×256 上做到 gFID 1.03,並且在相同 LightningDiT 設定下,收斂速度最高可比 RAE 快 13 倍。對非研究人員而言,這代表同樣資源下有機會更快見到可用成果;不過這些表現仍應視乎資料集、訓練設定與骨幹模型而定。

  • 核心定位:為 latent diffusion 準備更易學的潛在表示
  • 主要創新:把「擴散友善」拆成三個可優化的性質來訓練
  • 實際價值:有機會縮短訓練週期,提升生成質素與少步數採樣表現
  • 適合場景:影像生成研究、需要高效率訓練的生成系統、比較不同 tokenizer 設計
  • 可配骨幹:支援多種編碼器方向,包括 DINOv2、SigLIP2、DINOv3、MAE

如果你關心的是「如何令擴散模型學得更快,而唔係只換更大模型」,PAE 的切入點相當值得參考。它最適合有一定生成模型流程的人採用;對一般用家而言,未必是即裝即用工具,但作為下一代 latent tokenizer 的設計思路,含金量相當高。

Source: https://github.com/ZhengrongYue/PAE

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 模型訓練, 影像模型, 中國

Qwen3.6-Plus 專為 Agentic AI 設計的模型

Qwen3.6-Plus 顯著增強了模型的智能體(Agent)編程能力。無論是前端網頁開發,還是複雜的代碼倉庫級問題求解,Qwen3.6-Plus 均樹立了全新的業界標桿(SOTA)。此外,Qwen3.6-Plus 對世界的感知更加精准,多模態推理能力也更為敏銳。本次發佈直接回應了社區在 Qwen3.5-Plus 部署期間反饋的意見,為開發者生態提供了高度穩定可靠的基礎,帶來真正具有變革意義的“氛圍編程”(Vibe Coding)體驗。 官方已提供 OpenClaw 整合,編輯 ~/.openclaw/openclaw.json

Qwen3.6-Plus 顯著增強了模型的智能體(Agent)編程能力。無論是前端網頁開發,還是複雜的代碼倉庫級問題求解,Qwen3.6-Plus 均樹立了全新的業界標桿(SOTA)。此外,Qwen3.6-Plus 對世界的感知更加精准,多模態推理能力也更為敏銳。本次發佈直接回應了社區在 Qwen3.5-Plus 部署期間反饋的意見,為開發者生態提供了高度穩定可靠的基礎,帶來真正具有變革意義的“氛圍編程”(Vibe Coding)體驗。

官方已提供 OpenClaw 整合,編輯 ~/.openclaw/openclaw.json

{
  "models": {
    "mode": "merge",
    "providers": {
      "bailian": {
        "baseUrl": "https://dashscope.aliyuncs.com/compatible-mode/v1",
        "apiKey": "DASHSCOPE_API_KEY",
        "api": "openai-completions",
        "models": [
          {
            "id": "qwen3.6-plus",
            "name": "qwen3.6-plus",
            "reasoning": true,
            "input": ["text", "image"],
            "contextWindow": 1000000,
            "maxTokens": 65536
          }
        ]
      }
    }
  },
  "agents": {
    "defaults": {
      "model": {
        "primary": "bailian/qwen3.6-plus"
      },
      "models": {
        "bailian/qwen3.6-plus": {}
      }
    }
  }
}

Categories: 阿里巴巴, Agentic, Vibe Coding, OpenClaw, 中國

Qwen3.5-Omni 多模態模型

Qwen3.5-Omni 是 Qwen 最新一代全模態大模型,支持文本、圖片、音頻、音視頻理解。結構上,Qwen3.5-Omni 的 Thinker 與 Talker 均採用 Hybrid-Attention MoE 架構。Qwen3.5-Omni 系列包含 Plus、Flash、Light 三種尺寸的 Instruct 版本,支持 256k 長上下文,模型支持超過 10 小時的音頻輸入及超過 400 秒的 720P(1 FPS)音視頻輸入。模型在海量文本、視覺以及超過 1 億小時的音視頻數據上進行原生多模態預訓練,該模型展現出卓越的全模態感知與生成能力。相比 Qwen3-Omni,Qwen3.5-Omni 多語言能力大大增強,能夠支持 113 種語種和方言的語音識別和 36 種語種和方言的語音生成。目前可通過 Offline API 和 Realtime API 進行體驗。 Qwen3.5-Omni Thinker 通過 Vision Encoder 和 AuT 接受視覺和音頻信號輸入,音視頻信號通過 interleave 交織並搭配 TMRoPE 編碼位置信息。Thinker 負責處理全模態信號並輸出文本,Talker 負責接收來自 Thinker 的多模態輸入以及文本輸出,進行 […]

Qwen3.5-Omni 是 Qwen 最新一代全模態大模型,支持文本、圖片、音頻、音視頻理解。結構上,Qwen3.5-Omni 的 Thinker 與 Talker 均採用 Hybrid-Attention MoE 架構。Qwen3.5-Omni 系列包含 Plus、Flash、Light 三種尺寸的 Instruct 版本,支持 256k 長上下文,模型支持超過 10 小時的音頻輸入及超過 400 秒的 720P(1 FPS)音視頻輸入。模型在海量文本、視覺以及超過 1 億小時的音視頻數據上進行原生多模態預訓練,該模型展現出卓越的全模態感知與生成能力。相比 Qwen3-Omni,Qwen3.5-Omni 多語言能力大大增強,能夠支持 113 種語種和方言的語音識別和 36 種語種和方言的語音生成。目前可通過 Offline API 和 Realtime API 進行體驗。

Qwen3.5-Omni Thinker 通過 Vision Encoder 和 AuT 接受視覺和音頻信號輸入,音視頻信號通過 interleave 交織並搭配 TMRoPE 編碼位置信息。Thinker 負責處理全模態信號並輸出文本,Talker 負責接收來自 Thinker 的多模態輸入以及文本輸出,進行 contextual 語音生成,語音表徵通過 Qwen3-Omni 提出的 RVQ 編碼來替代繁重的 DiT 運算。由於 chunk-wise 的流式輸入設計和流式 Talker 設計,整個模型可以進行 realtime interaction。不同於上一代 Qwen3-Omni 的雙軌 Talker 輸入,Talker 在輸入的組織方式上採用了 ARIA(自適應速率交錯對齊,Adaptive Rate Interleave Alignment)來動態對齊文本與語音單元,然後進行交錯排布,以避免由於文本與語音 Token 編碼效率差異導致的語音不穩定性,如漏讀、誤讀或數字發音模糊等問題。

Categories: 阿里巴巴, 多模態模型, 中國

LumosX 精準個性化數字人

LumosX 是一個針對 個性化多主體視訊生成(personalized multi‑subject video generation)提出的框架,重點在: 簡單說:一樣可以做 text‑to‑video + ID conditioning,但對多個人物、每個人對應什麼屬性,控制得更精細、更一致「可控視訊生成」與「多主體個性化內容」場景,例如多角色劇本生成、廣告、虛擬試衣、多角色 VTuber 相容演出等。

LumosX 是一個針對 個性化多主體視訊生成(personalized multi‑subject video generation)提出的框架,重點在:

  • 讓每個「身份」(例如不同人物)和其對應的屬性(年齡、外貌、服飾、動作等)有明確、精準的對齊;
  • 用關係性注意力機制來強化「組內一致性」(同一組人物屬性一致)和「組間區分度」,減少多主體時的屬性糾纏(attribute entanglement)。

簡單說:一樣可以做 text‑to‑video + ID conditioning,但對多個人物、每個人對應什麼屬性,控制得更精細、更一致「可控視訊生成」與「多主體個性化內容」場景,例如多角色劇本生成、廣告、虛擬試衣、多角色 VTuber 相容演出等。

Categories: 開源, 阿里巴巴, 數字人, 視頻模型

Code2World 基於動作預測的 GUI 代理

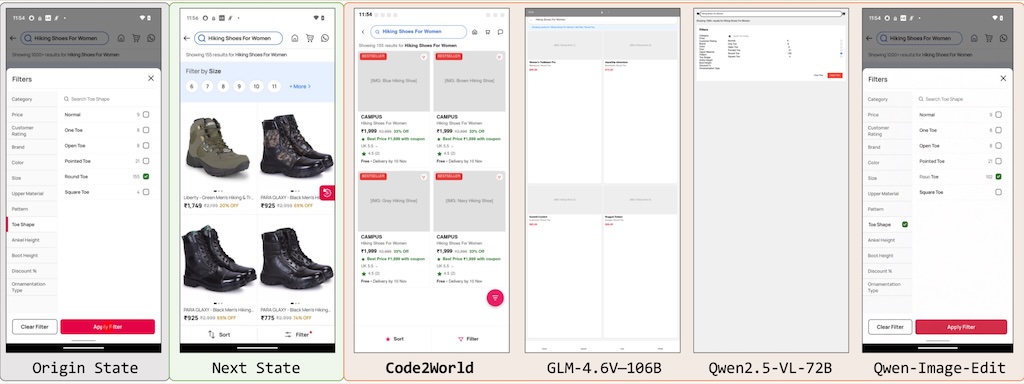
Code2World 本身不是一個「GUI 設計工具」,但它可以用在「優化 GUI 設計」的流程裡,特別是幫你 驗證設計是否好操作、是否容易出錯、是否符合使用者行為預期。Code2World 以靈活的方式顯著提升了下游導航的成功率,在 AndroidWorld 導航方面,其性能比 Gemini-2.5-Flash 提升了 9.5%。 它透過產生可渲染的程式碼來模擬下一個視覺狀態。實驗表明,Code2World-8B 在下一界面 UI 預測方面表現卓越,足以媲美 GPT-5 和 Gemini-3-Pro-Image 等競爭對手。(Huggingface 模型及數據集出現 404)(圖為預測介面的結果)

Code2World 本身不是一個「GUI 設計工具」,但它可以用在「優化 GUI 設計」的流程裡,特別是幫你 驗證設計是否好操作、是否容易出錯、是否符合使用者行為預期。Code2World 以靈活的方式顯著提升了下游導航的成功率,在 AndroidWorld 導航方面,其性能比 Gemini-2.5-Flash 提升了 9.5%。

它透過產生可渲染的程式碼來模擬下一個視覺狀態。實驗表明,Code2World-8B 在下一界面 UI 預測方面表現卓越,足以媲美 GPT-5 和 Gemini-3-Pro-Image 等競爭對手。(Huggingface 模型及數據集出現 404)(圖為預測介面的結果)

Categories: 開源, 阿里巴巴, Agentic, 模型, 編程

Page 16 of 18
1 14 15 16 17 18