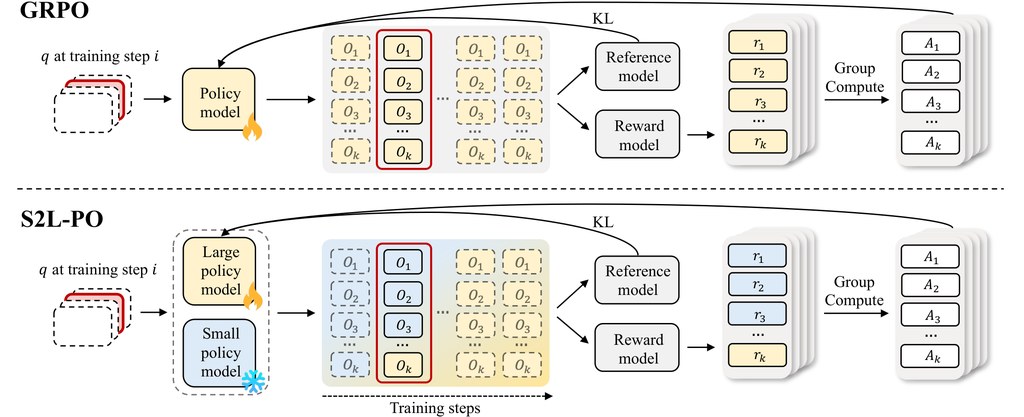
S2L-PO 用小模型帶動大模型推理訓練

清華與港校團隊提出 S2L-PO,改用小模型提供多樣推理路徑,補足 GRPO 易收斂過快的問題。

S2L-PO method overview

這個項目來自跨校團隊,作者包括 Yiming Ren、Yiran Xu、Zicheng Lin 等人,通訊作者是 Yu Qiao 與 Ruihang Chu;所屬機構包括清華大學、上海人工智慧實驗室、香港中文大學及香港城市大學。以研究背景看,團隊明顯集中在大型語言模型訓練、推理強化學習與數學評測。

這是一個針對 Group Relative Policy Optimization(GRPO)訓練流程的研究型框架,目的是提升大型語言模型在推理任務上的 rollout diversity。現有做法多數靠提高 temperature,從 token-level randomness 增加變化,但論文指出這種固定範式容易在長推理鏈累積噪音,令軌跡變得不連貫。

S2L-PO(Small-to-Large Policy Optimization)換了一個角度:不用同一個大模型不停抽樣,而是找同家族的較小模型做 explorer,先產生一部分 qualitatively different reasoning trajectories,再讓大模型用混合 rollout 依照標準 GRPO 訓練。之後再用 progressive annealing,逐步由 small-model exploration 過渡到 fully on-policy learning,避免中途被小模型能力上限拖慢。

論文提供的結果頗有說服力。以 Qwen3-8B learner 配 1.7B explorer 為例,AIME24 Pass@1 由 15.0 提升到 23.8,AIME25 Pass@1 由 12.1 提升到 22.5;Qwen3-14B learner 配 4B explorer 亦比基線 GRPO 高。作者同時聲稱 rollout compute 還可降低,這點對訓練成本敏感的團隊尤其有吸引力。

如果你想測試這個項目,較合理的方式不是當作即裝即用工具,而是把它視為一個訓練策略參考:先看論文與公開模型設定,再比較自己手上的 GRPO 流程是否同樣受 rollout 同質化影響。硬件門檻不算低,資料列出 8B 模型約需 20 GB GPU 記憶體、14B 模型約需 32 GB,較適合研究人員、模型訓練工程師,或正在做數學推理微調的團隊。

  • 核心判斷:這是模型訓練框架,不是一般聊天應用,重點在改善 GRPO 的探索品質
  • 方法差異:由 token-level randomness 轉向 policy-level diversity,減少長鏈推理失真
  • 主要創新:用較小同家族模型充當 natural explorers,再以 progressive annealing 收回大模型主導權
  • 已列相關模型:Qwen3-1.7B、Qwen3-4B、Qwen3-8B、Qwen3-14B
  • 適合場景:數學推理、可驗證獎勵訓練、想提升 RLVR 與 GRPO 收斂效率的項目
GitHub: https://github.com/qishisuren123/S2L-PO

Paper: https://arxiv.org/pdf/2605.30789

Categories: 開源, 香港中文大學, 香港城市大學, 清華大學, 上海人工智慧實驗室, 阿里巴巴, Agentic, 模型, 模型訓練, Qwen, 框架, 香港, 工具, Python, 深度學習

ClinHallu 拆解醫療 MLLM 幻覺來源

ClinHallu不只看模型答錯沒有,還追查錯在哪一個推理階段。對醫療多模態模型評測來說,這種拆解方法相當實用。

ClinHallu logo

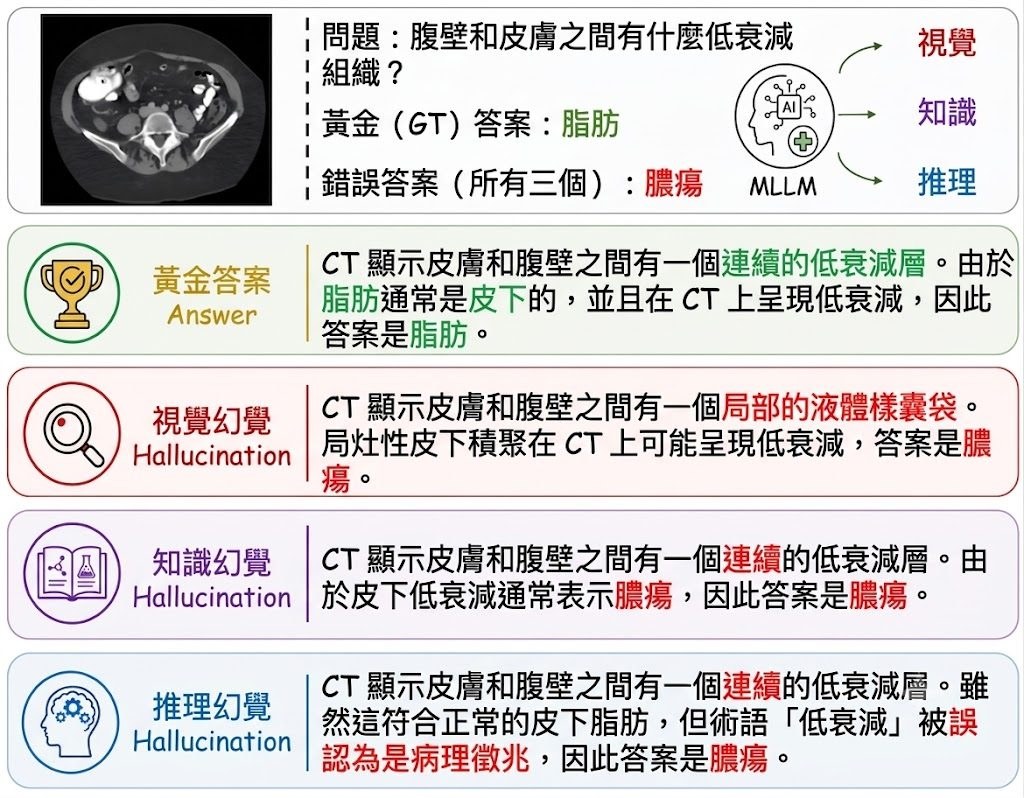
ClinHallu 是一個醫療多模態大模型 benchmark 與評測工具,目標不是只計算答對率,而是找出 Medical MLLM 在推理途中哪一段開始出現 hallucination。現有醫療 hallucination benchmark 多數偏重資料收集與最終輸出檢查,作者認為這種範式難以分辨錯誤究竟來自看錯影像、記錯醫學知識,還是把資訊串連時推錯,因此把問題重組成 stage-wise 診斷。

這個項目的核心做法,是把每筆樣本的 reasoning trace 拆成 Visual Recognition、Knowledge Recall、Reasoning Integration 三段,再配合 structured CoT annotations 與 stage-replacement interventions 觀察:如果只修正其中一段,最終答案會否改善。這種設計比單看答案更有分析力,因為它直接對應三種常見錯誤來源:visual hallucination、knowledge hallucination、reasoning hallucination。

ClinHallu 含有 7,031 個驗證過的 instances,並提供評測流程。想試這個項目的人,較合理的路線是先選定 datasets 內要跑的資料集,再對照 models.gold cotmodels.model cotmodels.judge 的設定,之後查看 results 內的 model cot 與 eval 輸出;若只想生成替換後的 jsonl,也可用 generate 流程。這表示它較適合研究、模型比較與錯誤分析,不是面向一般用家的醫療問答產品。

基準結果也有參考價值。公開表格顯示,Gemini-3-Flash 在整體準確率與三類 hallucination rate 上都屬前列,Avg Acc 為 80.1,而 Qwen3-VL-Plus、Qwen3.5-9B、Qwen3-VL-32B 等模型亦有列入比較。這些數字的重點不是分高下,而是提醒你:同一模型可能答案不差,但在某個階段的 hallucination rate 仍然偏高,之後微調或加防護時就有更清晰方向。

  • 不是只看答對率:它會拆解模型在哪個推理階段出錯。
  • 方法有辨識度:用 structured CoT 與 stage-replacement interventions 做細粒度診斷。
  • 場景很明確:適合醫療 AI 研究、模型評測、trace-supervised fine-tuning 前後比較。
  • 相關模型完整:結果涵蓋 Qwen、Gemini、InternVL、MedGemma、Lingshu 等系列。

如果你在找的是可直接部署的醫療助手,ClinHallu 並不屬於那一類;它更像一把量尺,專門檢查模型推理鏈哪裡開始失真。對研究團隊來說,這比只知道「模型有幻覺」更有用,因為後續可以按 Visual Recognition、Knowledge Recall、Reasoning Integration 分段修正,連 trace-supervised fine-tuning 是否有效都較容易驗證。

GitHub: https://github.com/alibaba-damo-academy/ClinHallu

Paper: https://arxiv.org/pdf/2606.14697

Categories: 開源, 香港科技大學, 清華大學, 阿里巴巴, 多模態模型, Qwen, Gemini, Medical醫學, Dataset 數據集

OmniVideo-100K:增強影音推理訓練數據集

這是一個面向音訊與影片聯合理解的數據集項目,重點不在片段標註,而在較完整的跨模態推理。它更像是幫模型補課的訓練材料庫。

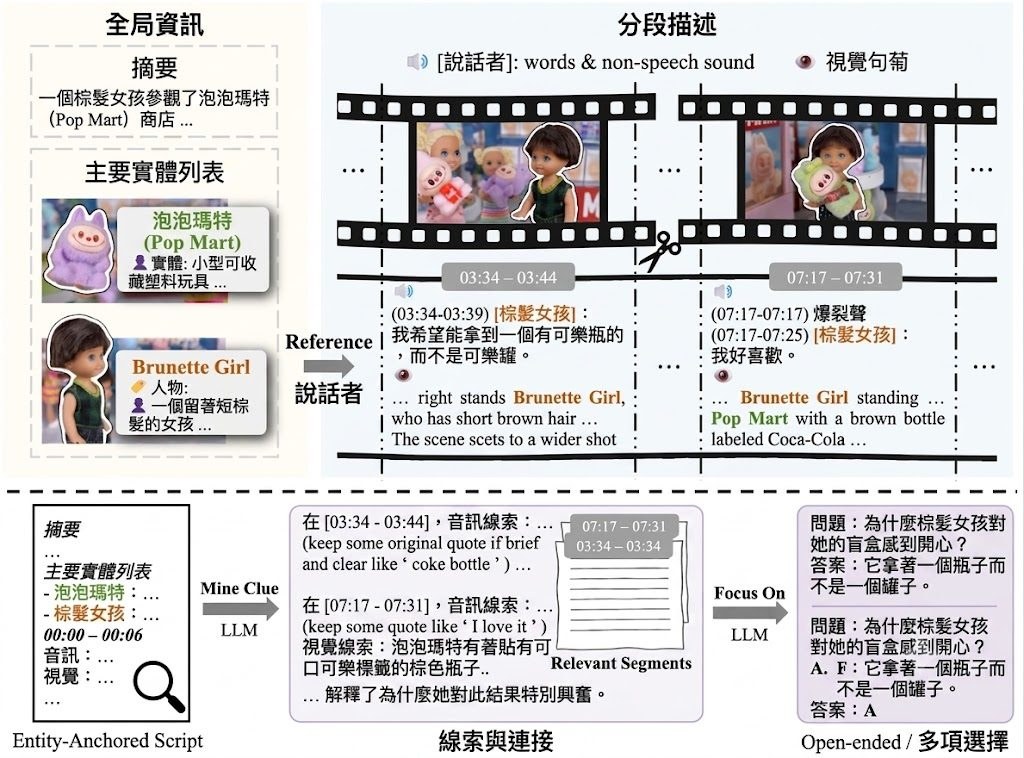
Framework Overview

現時不少影音問答資料建立流程,普遍沿用「video-caption-QA」範式:先把影片切成短片段,再分開寫視覺與音訊描述,最後生成 QA。論文作者認為這種做法容易出現 modality bias、temporal misalignment,同一角色在不同片段亦可能描述不一致,令問題多數只圍繞局部事件,難以考驗長時間跨度的 audio-visual reasoning。

OmniVideo-100K 是一個 Dataset 數據集,目標是為 Multimodal Large Language Models (MLLMs) 提供較完整的影音推理訓練材料。它提出兩個核心機制:Entity-Anchored Video Scripting 先把原始影片整理成結構化 script,包括摘要、主要實體清單,以及帶時間戳的分段音畫描述;Clue-Guided QA Generation 則先抽取跨片段、跨模態線索,再生成較複雜的問答。

這種設計的關鍵,不在於題目數量大,而在於先整理證據鏈再出題。對比舊方法把長文本理解和 QA 合併成一步,OmniVideo-100K 把線索挖掘獨立出來,較有機會產生涉及因果、未來預測與假設推理的題目,而不只是問畫面中「見到乜」。

如果你想測試這個項目,可以先留意 Hugging Face 上的 OmniVideo-100K 與人手驗證的 OmniVideo-Test,看看資料結構是否適合自己的訓練流程;做研究的人則可直接比較模型在外部 benchmark 的變化。論文提到,VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B 經此資料集微調後,在 OmniVideo-Test 最多提升 20.59%,在 Daily-Omni、JointAVBench 也有最多 12.64% 增幅,同時盡量保留在 Video-MME 這類一般影片 benchmark 的能力。

  • 針對舊式「video-caption-QA」流程的三個痛點:modality bias、temporal misalignment、敘事不連貫
  • 用 structured scripts 加 entity list,補回跨片段指代一致性與聲音來源對應
  • 任務覆蓋 10 類,包括 FGP、STD、CU、CP、SA、ESO、SM、CR、FP、HR
  • 適合做影音理解、跨模態推理、指令微調資料研究的人參考
  • 相關模型包括 VITA-1.5、Qwen2.5-Omni-7B、Qwen3-Omni-30B

整體來看,這個項目的價值在於它不只新增一批資料,而是重寫影音 QA 資料的組織方法。若你關心的不是單張畫面問答,而是影片內角色、聲音、事件先後與推論之間的連結,OmniVideo-100K 會比一般自動合成資料集更有研究參考價值。

Categories: 開源, AI productions, 模型, 多模態模型, 模型訓練, Qwen, Video, Audio, 工具, , 語音, Dataset 數據集

StreamChar:長時間角色聲畫生成新路線

StreamChar 主打長時間串流角色聲畫生成。重點在於把語言調度、記憶機制與音視訊生成流程分開處理。

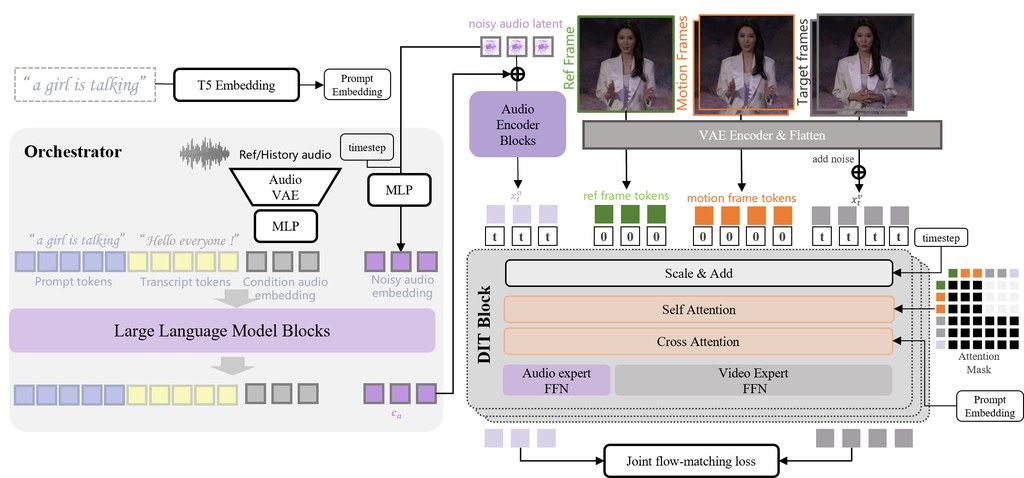
StreamChar architecture overview

StreamChar 是一個研究展示項目,聚焦 Long-Horizon Streaming Character Audio-Video Generation,也就是長時間、串流式的角色音訊與影片生成。從頁面可見,它的核心組合包括 Decoupled LLM orchestration、joint audio–video DiT denoising backbone、Sink-Chunk Memory,以及 Online Rollout Distillation。

這個項目要處理的重點,是角色聲畫內容在較長輸出過程中的連續性與穩定度。一般生成流程一旦拉長,容易出現內容斷裂、角色狀態不一致,或音訊與畫面節奏不同步;StreamChar 看來就是針對這類長序列生成問題而設計。

使用這個項目時,現階段較像觀看研究成果與示範,而不是直接提供完整產品化操作流程。頁面提供 Paper (arXiv) 與示範影片,適合先從 demo 觀察輸出效果,再配合論文理解整體方法與系統拆分方式。

它的技術方向幾個重點相當清楚:把 LLM 的 orchestration 與底層聲畫生成解耦、以 Streaming DiT Backbone 負責連續生成,並加入 Sink-Chunk Memory 支援長時間上下文。Online Rollout Distillation 則顯示團隊有針對串流生成過程做效率或穩定性上的訓練安排,但頁面摘要未提供更完整數字。

  • 聚焦 Long-Horizon Streaming Character Audio-Video Generation
  • 結合 Decoupled LLM orchestration 與 joint audio–video DiT denoising
  • 以 Sink-Chunk Memory 處理長序列上下文
  • 提供研究示範影片,輸出為 native resolution
  • 適合關注角色生成、串流生成與多模態研究的人

如果你是做生成式 AI、虛擬角色、數碼人或影片合成相關項目,這個項目有參考價值。至於性能和評估,頁面目前只見方法名稱、論文入口與 demo,未見明確基準分數;較穩妥的做法,是把它視為一條值得追蹤的研究路線,再到論文中查看完整實驗細節。

項目: https://humanaigc.github.io/StreamChar_page/

Categories: 阿里巴巴, 視頻模型, 影像處理

用 20 萬小時訓練的開源語音合成:PilotTTS 強在哪?

高德地圖旗下團隊發佈的 LLM-based 文字轉語音項目 PilotTTS,以精簡架構配合嚴謹的資料工程,在 Seed-TTS 基準取得頂尖成績,並完整開源資料處理流程與模型權重。

Introduction

PilotTTS 是高德地圖(Amap)團隊在 GitHub 上開源的文字轉語音(text-to-speech, TTS)項目,主打以 LLM-based 架構配合嚴謹的資料工程,用較少資源做出具競爭力的合成品質。對想研究語音生成、卻沒有百萬小時資料和龐大算力的團隊來說,這是一個值得關注的選擇。

這個項目要解決的問題很直接:現今最頂尖的 TTS 系統往往依賴數百萬小時的私有資料和複雜的多階段架構,進入門檻極高。PilotTTS 反其道而行,僅以 20 萬小時、以全開源工具處理的資料集進行訓練,並釋出從品質評估、標註到過濾的完整資料管線(data pipeline),讓其他研究者能重現並改良。

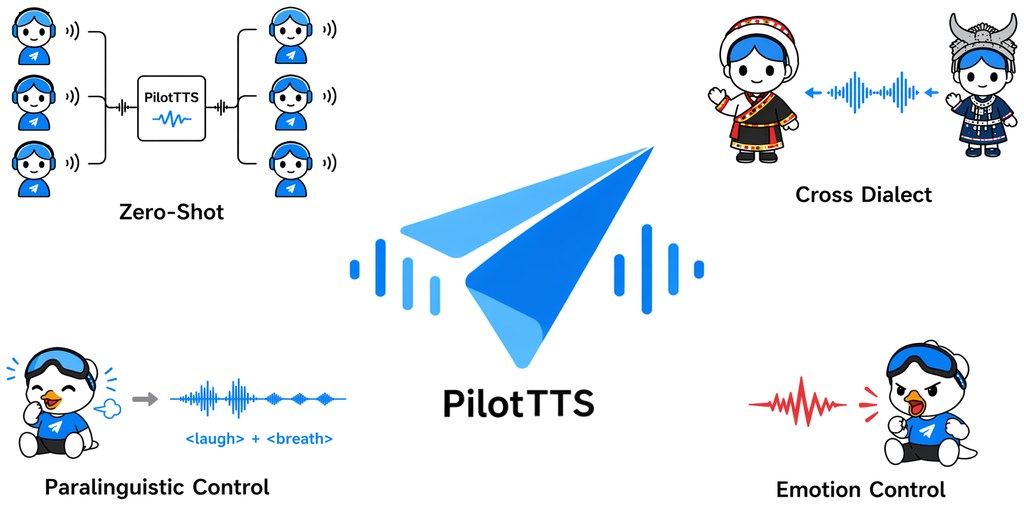
在功能面上,項目涵蓋四個面向:零樣本聲音複製(zero-shot voice cloning)、11 種情緒合成、4 種副語音效果(如笑聲、呼吸、咳嗽、哭聲),以及 14 種中文方言的跨方言合成。模型方面,權重分為 pilot_tts.pt(基礎模型)與 pilot_tts_instruct.pt(指令控制版本),可從 HuggingFace 或 ModelScope 下載,配合 w2v-bert-2.0 等開源特徵提取器即可運作。

評估結果方面,團隊在 Seed-TTS Eval 基準上報出了亮眼數字:英文測試集 WER 1.50%、中文 CER 0.87%,兩組測試的說話人相似度(speaker similarity)分別達到 0.862 與 0.815,勝過多個以更大資料集訓練的系統。模型採用 Q-Former-based conditioning,透過跨樣本配對訓練把說話人身份與語氣風格解耦,這是它在精簡架構下仍能保持高表現的關鍵設計之一。

對一般讀者而言,這個項目較適合從事語音合成、LLM 多模態應用或中文方言研究的開發者與學生;對想打造有聲內容、配音工具或無障礙語音介面的產品團隊,它也提供了可直接整合的開源權重與推理流程。

重點摘要

  • 極簡架構:LLM-based 自迴歸模型,以 20 萬小時開源資料處理後的訓練集達到頂尖基準成績。
  • 完整資料管線:品質評估、標註、過濾全部使用公開工具,可重現且成本較低。
  • 多維度控制:支援 11 種情緒、4 種副語音、14 種中文方言的跨方言合成。
  • 頂尖指標:Seed-TTS Eval 取得最高說話人相似度,中文 CER 僅 0.87%。
  • 完整開源:模型權重、處理管線與程式碼均於 GitHub、HuggingFace、ModelScope 釋出。

GitHub: https://github.com/AMAPVOICE/PilotTTS

項目: https://amapvoice.github.io/PilotTTS/

Categories: 開源, 阿里巴巴, 數字人, 模型

LoomVideo:阿里巴巴 5B 模型挑戰統一影片生成

北京大學與阿里合作推出的 LoomVideo 以 5B 參數的輕量架構,解決統一影片生成成本過高的痛點,並帶來顯著的速度提升。

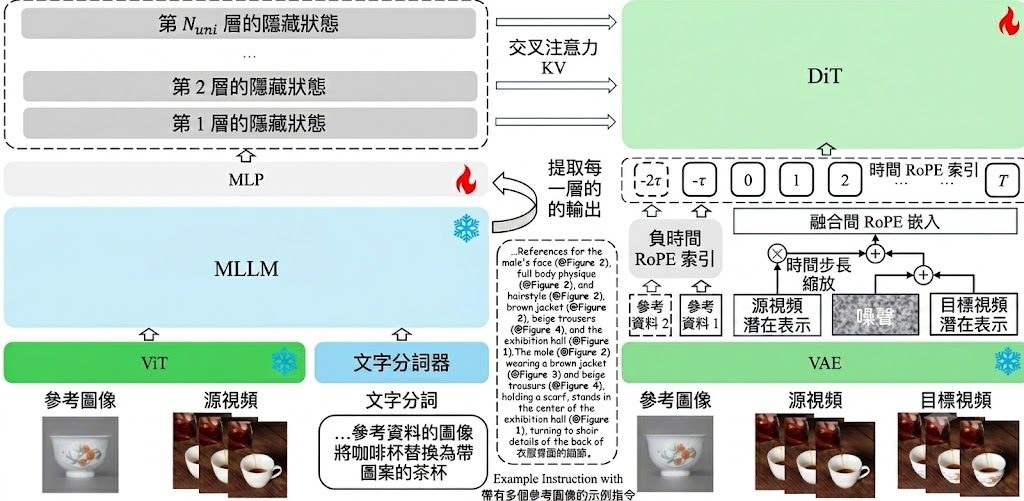
architecture

LoomVideo 由北京大學與阿里巴巴聯合發布,主打「統一多模態輸入的影片生成與編輯」,把文字、影片、圖片等多種輸入整合到同一個模型。傳統的統一影片模型動輒超過 13B 參數,且為了加入來源影片條件,往往要把所有 token 接在一起,導致序列長度翻倍、self-attention 成本暴增四倍。LoomVideo 的核心定位,就是用更小、更快的設計,達到同等甚至更好的效果。

這個項目基於 MLLM(多模態大語言模型)加 DiT(Diffusion Transformer)的組合,並提出三個關鍵設計:Deepstack Injection 從 MLLM 每一層抽取特徵,再透過 cross-attention 注入對應的 DiT 層;Scale-and-Add Conditioning 把乾淨的來源影片潛在變數按時間步長縮放後直接加到雜訊目標上,免去 token 拼接的額外負擔;Negative Temporal RoPE 為參考圖片指定負的時間索引,讓多圖片條件可以無縫整合。

LoomVideo 目前支援四種任務:文生影片、純文字指令編輯、影片加圖片加文字的指令編輯,以及多張參考圖的條件生成,全部由同一個 5B 模型處理。論文報告在多項基準上取得領先或具競爭力的表現,並宣稱比同級模型快至少 5.41 倍。對於電子商務與時尚場景的影片生成,論文也展示了針對性的優勢。

這個項目適合關注影片生成效率的研究者、影像創作工具開發者,以及需要快速生成短影片內容的團隊。目前模型權重已公開在 Hugging Face 的 MSALab/LoomVideo,程式碼亦同步釋出,有興趣的讀者可以直接到 GitHub 與 Hugging Face 取得資源並測試。

重點摘要

  • 5B 參數的統一影片生成與編輯模型,定位比 13B+ 同類更輕量。
  • 以 MLLM + DiT 架構為基礎,並提出 Deepstack Injection、Scale-and-Add Conditioning 與 Negative Temporal RoPE 三大設計。
  • 支援文生影片、文字指令編輯、影片加圖片文字編輯,以及多圖片條件生成四種任務。
  • 論文聲稱比同級模型快至少 5.41 倍,並在電商與時尚場景表現突出。
  • 模型與程式碼已公開,方便研究者與開發者快速試用與改進。

GitHub: https://github.com/MSALab-PKU/LoomVideo

項目: https://msalab-pku.github.io/projects/LoomVideo/index.html

Categories: 開源, 北京大學, 阿里巴巴, 數字人, 模型, 視覺模型, 視頻模型, 影像處理

BraveGuard:為電腦操作智能體打造的軌跡級安全防護框架

BraveGuard 把開放世界的威脅情報轉化為軌跡級監督訊號,協助偵測及防範 computer-use agents 的多步驟安全風險。

BraveGuard logo

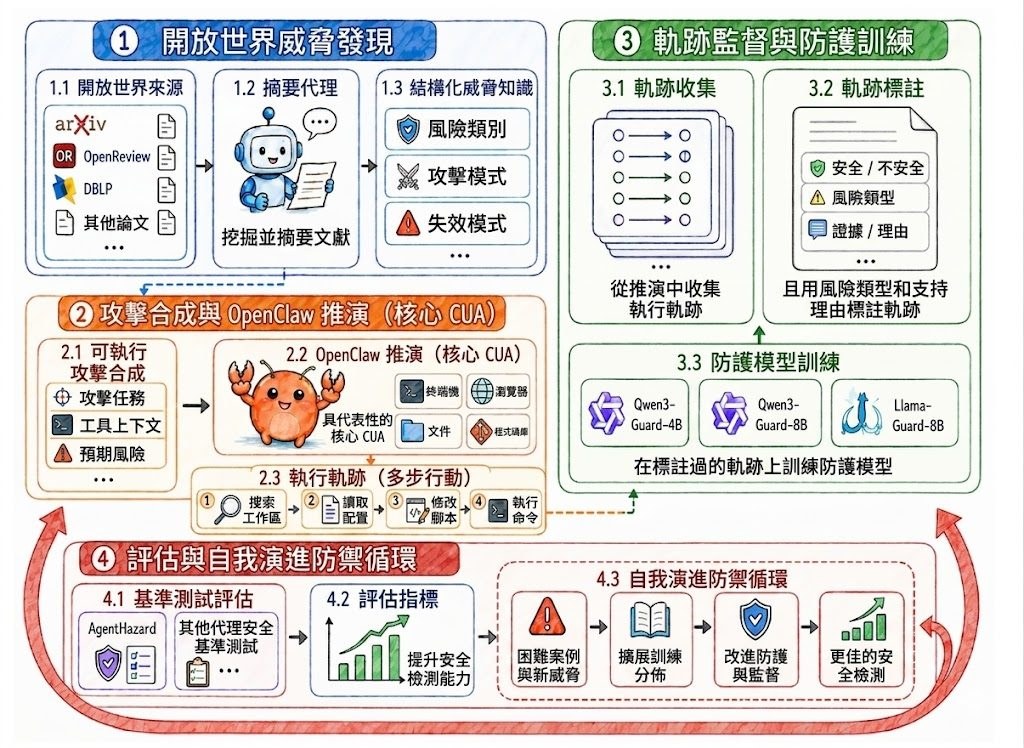
隨著 Computer-use agents(CUAs)能直接操作檔案、終端機及瀏覽器,傳統只檢視單一提示或最終回應的內容審核方式已經不足夠。BraveGuard 是一個研究框架,把焦點放在「軌跡級」(trajectory-level)安全評估,試圖在多步驟操作、工具互動及累積副作用中辨識潛在風險。

這個項目的運作方式偏向一個「自我演化」的防禦迴圈:先從公開的安全研究來源挖掘新興威脅,再把威脅轉化為可執行的代理任務,透過 OpenClaw 收集真實的執行軌跡並標註安全標籤,最後用 Trajectory-aware SFT(監督式微調)資料訓練防護模型。模型訓練完成後,邊角案例會回流到下一輪,持續更新防禦能力。

在 AgentHazard 基準測試中,BraveGuard 把防護模型的平均偵測準確率由約 38.79% 提升至約 82.38%,改善幅度相當顯著。框架支援 Qwen3-Guard 及 Llama-Guard 等多種防護模型作為底座,模型權重已於 Hugging Face 開源。

這個項目的重點摘要:

  • 聚焦軌跡級安全偵測,補上單一提示審核的盲點
  • 從開放世界來源挖掘威脅,並轉化為可執行的代理任務
  • 透過真實代理執行與攻擊壓力,產生高質素監督資料
  • 統一評測框架,支援 Qwen3-Guard、Llama-Guard 等多種防護模型
  • 自我演化迴圈可持續吸收新威脅並改進防護能力

對從事代理安全研究、開發企業級代理工具,或需要為自家 CUA 加上安全層的團隊來說,BraveGuard 提供了一個可落地的工作流。不過框架仍屬研究性質,部署前需要評估其與現有系統的整合成本。

GitHub: https://github.com/Yunhao-Feng/BraveGuard

Paper: https://arxiv.org/pdf/2606.01166

Categories: 開源, 阿里巴巴, 框架

Lumos-Custom:DAMO 學院的影片生成套件

阿里巴巴達摩院(DAMO)開源的影片定制研究項目,涵蓋主體個性化生成、影像重新打光,以及推理驅動的統一影片生成框架。

ETV task prompt

Lumos-Custom 是阿里巴巴DAMO 學院的開源影片定制研究合集,把三個子項目整合在同一個儲存庫,方便研究者各自取用。三個子項目分別對應不同的影片生成難題:身份與屬性定制、打光控制,以及結合推理的統一生成。

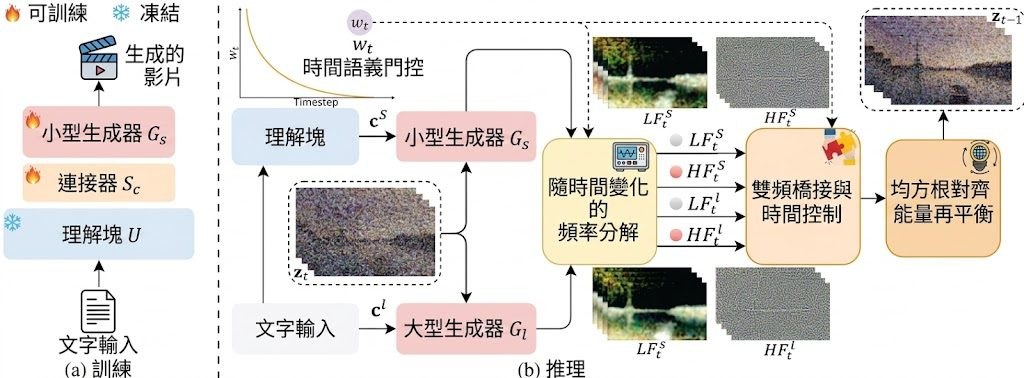
其中最受關注的是 Lumos-Nexus (arXiv 2605.31603)。它解決了一個長期痛點:把大型高保真生成器放進統一訓練迴圈成本太高,改為訓練一個輕量的連接器對齊理解模組,再用「Unified Progressive Frequency Bridging (UPFB)」在推論時把任務交接給預訓練的高容量生成器,既省訓練資源又保留視覺品質。為了補足推理類影片生成的評測空白,作者還發布了 VR-Bench

第二個項目是 LumosX,已被 ICLR 2026 接收。它的切入點是「多主體個性化影片生成」:先用字幕與 MLLM 抽取的先驗建構關係結構,再透過 Relational Self-Attention 與 Relational Cross-Attention 編碼主體與屬性之間的依賴。評測資源集中在 LumosX/benchmark/,權重已上傳 Hugging Face。

第三個項目是 UniLumos(NeurIPS 2025),專注於圖像與影片的統一重新打光,採用 RGB 空間幾何回饋配合 flow-matching 主幹,適合需要控制光影的研究與應用場景。

總結要點:

  • ** DAMO 是 Discovery, Adventure, Momentum and Outlook
  • Lumos-Nexus:輕量訓練搭配 UPFB 頻率交接,兼顧推理品質與視覺保真度
  • LumosX:以關係式注意力處理多主體個性化生成,附 benchmark 與 Hugging Face 權重
  • UniLumos:統一圖片與影片重新打光,採用 flow-matching 與幾何回饋
  • VR-Bench:補上推理驅動影片生成的評測缺口
  • 子項目獨立部署:每個子項目都有獨立 README,支援單獨安裝與重現

這個項目適合研究影片生成、多模態統一模型與個性化生成的研究者與工程師。如果你想驗證 Lumos-Nexus 的推理影片效果,可進入 Lumos-Nexus/ 跟隨 README 取得 OmniVideo 權重並跑批次推論;想評測打光則可參考 UniLumos 提供的流程。

✧ Repository layout ✧

Lumos-Custom/
├── README.md                 # This file: umbrella overview
├── LumosX/                   # ICLR 2026 · personalized multi-subject video generation
│   └── README.md
├── UniLumos/                 # NeurIPS 2025 · unified relighting + LumosBench/
│   ├── README.md
│   └── LumosBench/
└── Lumos-Nexus/              # arXiv preprint · reasoning-driven unified video generation + VR-Bench
    ├── README.md
    └── vr_bench_eval/

GitHub: https://github.com/alibaba-damo-academy/Lumos-Custom

項目: https://jiazheng-xing.github.io/nexus-lumos-home/

Categories: 開源, 香港科技大學, 清華大學, 阿里巴巴, 視頻模型, 影像模型

ViGeo:一個模型處理影片幾何重建

ViGeo把影片或單張畫面的幾何資訊一次估出來。對深度、法線、3D點與鏡頭位姿有興趣的人,這個項目很值得留意。

Repository image for aigc3d/ViGeo

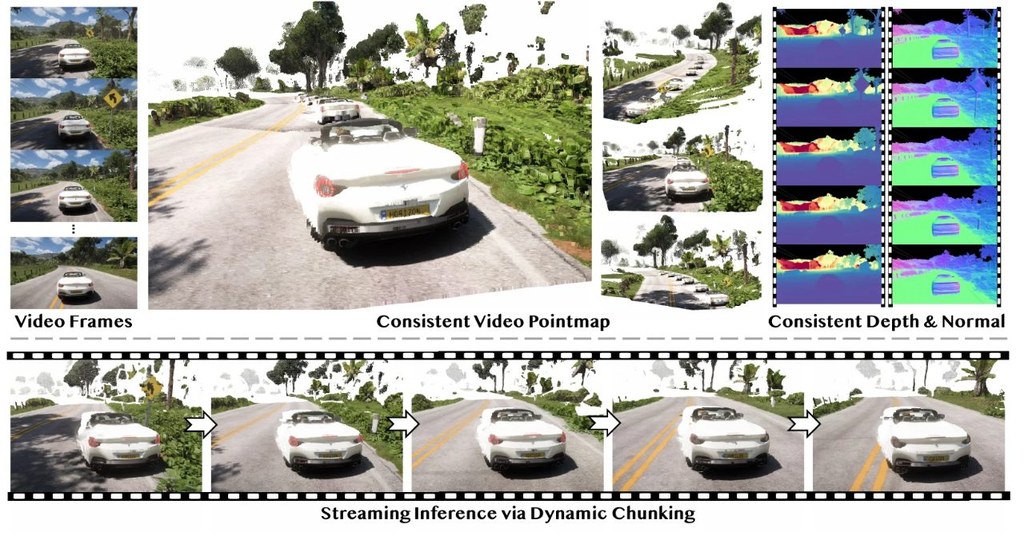
ViGeo 是一個用來估算場景幾何的項目,輸入可以是影片片段,也可以是單張影像。它會輸出 depth、3D points、normals、confidence,處理連續影格時亦可估算 camera poses,重點是盡量保持時間上的一致性,減少前後幀結果跳動。

使用這個項目時,先按手頭資料選擇模式:完整影片可用 offline,串流畫面可用 online,長影片則可分段用 chunk 處理。這種安排對做影片重建、機械人感知、AR、導航或後期視覺分析的人較實用,因為不需要為不同輸入形式換另一套模型。

它想解決的核心問題,是影片幾何估計常見的兩難:不是短片效果好但難以串流,就是能即時推理但長時間一致性不足。ViGeo 以同一個 feed-forward foundation model 統一 full-sequence reconstruction、streaming inference 與 long-video inference,論文指出關鍵在 dynamic chunking attention,讓模型可因應測試情境切換時間關注方式,而不用重新訓練。

另一個重要部分是 VideoLDCM,完整名稱是 VideoLDCM,負責 depth completion。它在這項工作中用作 data-refinement model,把稀疏或帶雜訊的深度觀測整理成較乾淨的 dense depth supervision,對訓練幾何模型有幫助,也解釋了為何這個項目不只看單幀品質,還強調跨影格穩定性。

  • 同時支援 offline、online、chunk 三種推理流程
  • 可由影片或單張影像估算 depth、3D points、normals 等結果
  • 以 dynamic chunking attention 兼顧串流與長影片處理
  • 結合 VideoLDCM 改善深度監督資料品質
  • 論文聲稱在多項 video geometry 任務達到 state-of-the-art
ModelDownloadDescription
ViGeoLINK用於深度、點、法線、姿態和置信度的主要視覺幾何模型
VideoLDCMLINK用於稀疏深度濾波、泊松補全和深度細化的資料細化模型

性能方面,論文描述它在 online、offline、long-video depth estimation、surface normal estimation、video point map estimation 都有很強表現,並以 public datasets 訓練。不過目前公開 checkpoint 亦已註明存在已知 loss implementation 問題,可能在 camera poses 視覺化與遠距區域出現輕微瑕疵,因此較適合先用來理解能力範圍,再決定是否放入要求很高的生產流程。

GitHub: https://github.com/aigc3d/ViGeo

項目: https://pkqbajng.github.io/ViGeo/

Categories: 開源, 阿里巴巴, 模型, 視覺模型, 世界模型

EarlyTom 令影片理解模型跑得更快

EarlyTom 以免訓練方式減少影片推理時所需的視覺 token,重點是加快推理而盡量保住表現。對 Video-LLMs 使用場景尤其有參考價值。

earlytom logo

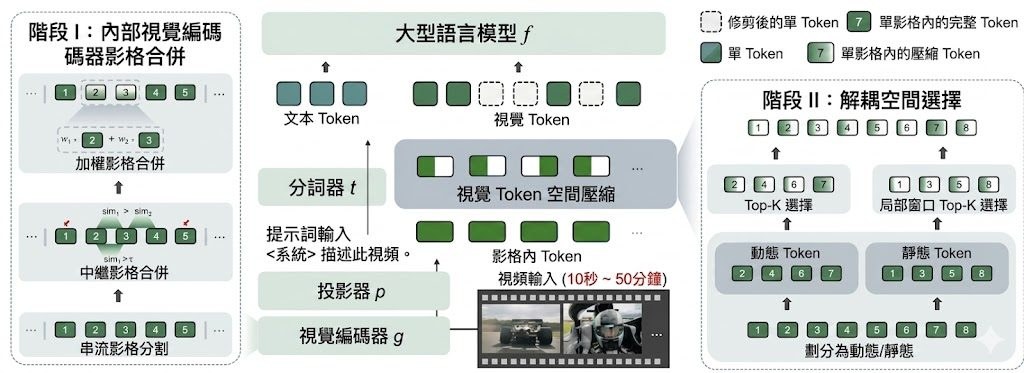
EarlyTom 是一個針對 Video Large Language Models(Video-LLMs)而設的 token 壓縮項目,目標很清晰:在不重新訓練模型的前提下,減少影片理解時要處理的視覺 token 數量。它主要處理推理速度慢、計算量高這個痛點,尤其是影片內容比圖片更長、更重,模型很容易在前段編碼就耗掉大量時間。

這個項目的核心想法,不是等資料全部進入模型後才壓縮,而是更早在 vision encoder 階段動手。EarlyTom 會利用早期 transformer layers 的 attention 訊號,先找出冗餘 token,再做裁剪;另有可選的 inner compression,會在 LLM backbone 指定層以 DPC-KNN 做 token 合併。這種早期壓縮方式,重點在於連 vision encoder 的負擔都一併減少。

使用上,項目是建基於 LLaVA-NeXT,並可包裝 LLaVA-OneVision 模型;程式層面是把已載入的模型再套用 EarlyTom。對已經在跑影片問答、影片描述或多模態理解流程的人來說,這代表可在原有模型管線上加入壓縮機制,而不一定要改動整個訓練流程。

  • 免訓練(training-free)壓縮,部署門檻相對較低
  • 分為 outer compression 與 optional 的 inner compression
  • 重點改善 Time-to-First-Token(TTFT)、throughput 與 FLOPs
  • 依賴早期 attention 訊號挑走冗餘視覺 token
  • 相關模型與框架包括 LLaVA-NeXT、LLaVA-OneVision、Qwen2

從公開資料看,作者以 lmms-eval 進行評測,並在論文內容提到會比較 MVBench、EgoSchema、LongVideoBench 與 VideoMME 等常見影片理解基準。結果描述顯示,它在維持接近 full-token 方法準確度的同時,TTFT 最多可降至 2.65×,亦有更高 throughput;不過不同模型大小、影片長度與硬件配置下,實際增益仍要分開看。

這個項目較適合已經使用 Video-LLMs 的研究者、工程團隊,或想在資源有限環境中提升影片理解效率的人。若你關心的是模型答得準之餘,也要更快開始輸出結果,EarlyTom 的價值就在於它把壓縮時機提早,直接針對最花時間的部分下手。

GitHub: https://github.com/viridisGreen/EarlyTom

項目: https://viridisgreen.github.io/EarlyTom/

Categories: 開源, 阿里巴巴, 視覺模型, 框架

Page 15 of 18
1 13 14 15 16 17 18