FreeLLMAPI V2 模型整合成單一 API

想同時試多個免費模型,但唔想逐間服務商處理金鑰、路由同管理介面,呢個項目就係針對呢個痛點而來。它用 OpenAI-compatible API 包住多家供應商,方便你用同一套接法測試與切換。

Repository image for nglmercer/freellmapiV2

同一個應用想接 Google、Groq、Cerebras、SambaNova、NVIDIA、Mistral、OpenRouter、GitHub Models、Cohere、Cloudflare 同 Z.ai,最煩通常唔係呼叫模型本身,而係供應商差異、可用模型變動,同埋管理方式分散。FreeLLMAPI V2 屬於開源 API 工具,用 Rust 寫後端,將多個免費層模型整合成 OpenAI-compatible API,旁邊再配一個 React/Vite 管理介面,處理查詢、切換同基本營運資訊。

它不只是做 API 轉發。crates/getmodelsapi 會負責 model discovery、scraping、filtering、enrichment、caching 同 serialization,代表項目本身會整理不同來源可用模型;crates/server 就接手 provider adapters、routing、SQLite persistence、health checks、analytics 同 graceful shutdown。呢個分工幾實際,因為你唔需要自己再砌一層模型清單同步服務。

項目比較像自架本地服務:後端預設監聽 127.0.0.1:3001,管理介面可另外用開發模式啟動,也可先 build client 再由伺服器提供內容。另有 desktop tray launcher,會喺本機啟動 server,再用瀏覽器開 dashboard;它唔內嵌 webview,亦唔依賴 Tauri。金鑰保護亦有交代,供應商憑證會用 AES-256-GCM,加密金鑰需用 64 個十六進位字元提供。

取捨同樣明顯。它集中火力解決「多供應商免費模型統一接入」呢件事,對於想快速驗證工作流、建內部工具、或者做模型切換測試的團隊會幾有幫助;但模型可用性本身受外部平台影響,所以 network-dependent provider smoke tests 不會放入一般測試,要另外開 GETMODELS_NETWORK_TESTS=1 驗證。換句話說,API 介面可以統一,免費模型是否穩定供應,仍然要跟住各家服務狀態走。

  • 用 Rust 包辦後端與 model discovery,重點放在穩定服務、路由同資料持久化
  • 提供 OpenAI-compatible API,較容易接入原本已支援 OpenAI 介面的應用
  • 內建 React/Vite 管理介面,唔使自行補一套後台
  • 支援 SQLite,較適合本地測試、小型團隊或輕量內部項目
  • 免費模型來源多,但供應商連線與可用性仍需獨立驗證

GitHub

Categories: 開源, API, 工具

ComfyUI-FL-MiniMaxH3 時間軸節點

這套 ComfyUI 節點把 MiniMax H3 的提示詞、音訊與影片生成整理成可重拍、可分鏡及可組裝的時間軸工作流。

想控制影片每一秒出現甚麼畫面、配合節拍切分鏡頭,或者只重做其中一段而保留其餘內容,FL MiniMax H3 提供的是一套 ComfyUI workflow nodes,實際處理 MiniMax H3 影片與音訊 latent 的時間軸編排、取樣和合成問題。

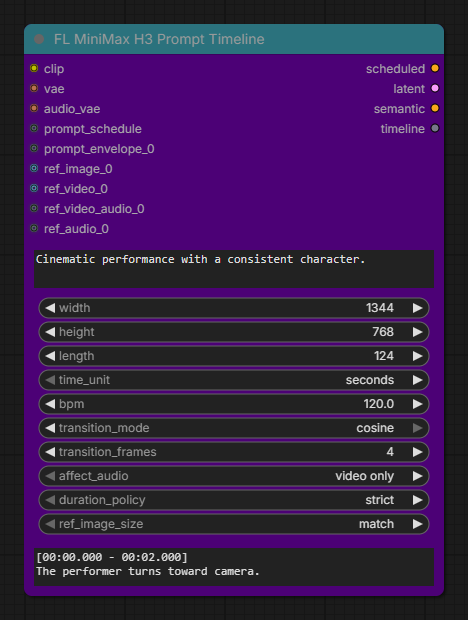
核心節點會建立原生的 nested H3 video/audio latent 及 prompt conditioning。你可以手動設定 timeline,亦可接入 FL PROMPT SCHEDULE;系統支援以秒、frame 或 beat 安排提示詞,並把 H3 image、video、video audio、soundtrack 及獨立 audio reference 編碼到同一條可重用時間軸。

FL MiniMax H3 Prompt Timeline

與先將資料攤平再處理的流程相比,項目保留 MiniMax H3 原有的巢狀影片及音訊結構,並提供 native latent upscaling,調整影片 latent 的高度和寬度時毋須經過 VAE 往返。需要更細緻修整時,pixel-space refinement 才會執行 decode、resize、re-encode,再於指定 sampling-step window 內細化結果。

  • 可按節拍規劃獨立或明確分組的 shots
  • 支援 frame-exact temporal reshots,只重生成指定區間
  • 可把上一個 render 的 authored tail 作為 hard-cut motion context
  • 內置 sampler previews,並可按時間軸組裝最終影片

使用者需要已有節點所需的 H3 text encoder、video VAE 和 audio VAE;適合需要精確控制分鏡、重拍範圍和聲畫結構的 ComfyUI 創作者及影片工作流程,而非用作性能比較。

GitHub

Categories: 開源, ComfyUI, Video, Image, Audio, MiniMax

Semantica 用圖譜為 AI 決策加上可追溯證據

Semantica 把分散企業資料整理成 Context Graph 和知識圖譜,再為 AI 決策保留可審計的來龍去脈。對需要解釋原因、追查來源的團隊,這比單靠向量索引更實用。

Semantica

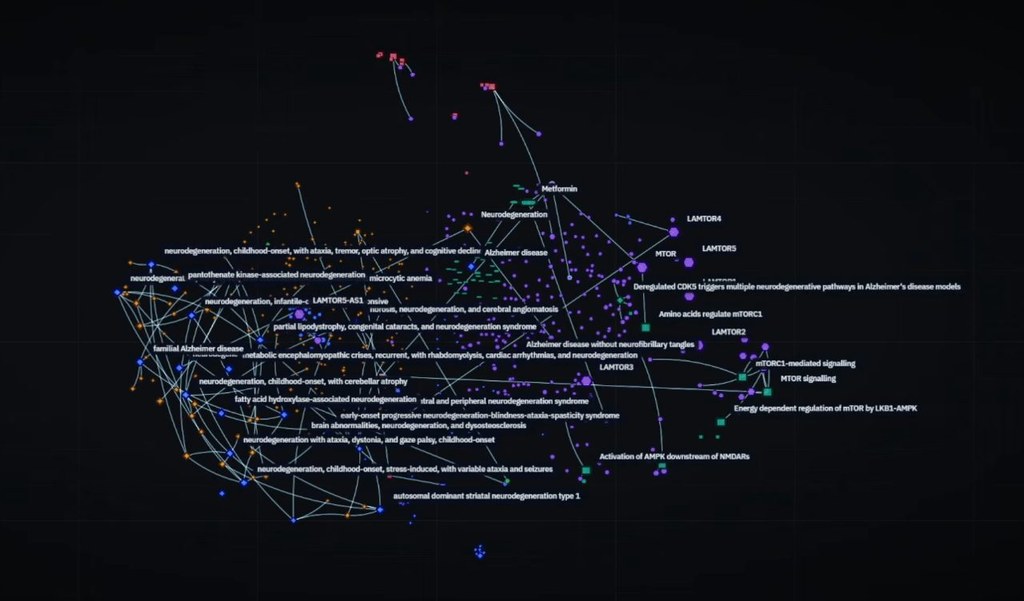
Semantica 是一個開源 Python 庫,做的是把企業資料整理成可查詢的 Context Graph 與 knowledge graph(KG),再把推理、決策與來源脈絡一併留下。它特別適合需要回答「AI 為何這樣判斷」的場景,因為每一步都能追到資料來源與處理過程。

它的做法不是只做檢索,而是先從零散資料抽取實體、關係和衝突資訊,再處理去重、譜系與本體管理,讓圖譜可直接承接 GraphRAG、因果推理和決策分析。官方也提到可自架,並支援 RDF 與 LPG,方便接入既有資料平台。

Semantica Platform Tour | Knowledge Graphs, Reasoning & Decision Intelligence

對 Databricks、Snowflake,或者受監管行業的資料與平台團隊,比把資料送去第三方 SaaS 更貼近實際要求。它不只服務 AI/ML platform teams,也照顧合規、風險和審計需求,因為 provenance 和 lineage 不是事後補寫,而是系統的一部分。

目前文件強調的是可解釋、可追溯與可自託管,並沒有把自己包裝成單純的模型套件。若團隊已經有 LangGraph、CrewAI 或 LlamaIndex,Semantica 比較像補上「上下文治理」與「決策證據」那一層,而不是取代原本的 LLM 流程。

  • 把碎片化資料轉成可查詢的 Context Graph 和 KG
  • 保留決策來源、譜系與審計軌跡
  • 支援 GraphRAG、因果推理與本體管理
  • 可自架,避免資料先送出企業邊界
  • 適合合規、風險與 AI 平台團隊

項目主頁 · GitHub

Categories: 開源, Agentic, KnowledgeGraph, LangGraph, Python,

MiniMax H3 迎來 19 款 LoRA,影片生成速度與風格同步擴展

MiniMax H3 的 LoRA 生態逐步成形,從加速推理到角色動作與畫面風格,為 ComfyUI 工作流提供更多選擇。

AVvXsEjfkOvyf5h2H5Z vYu8kIES0pGOidPGIbqyszhocYoXkK67 2yzenUgugZ9qtXe3Hzn5kB0K6Sdy36A78G4DPO1 veLpRRoPuSivw3r4Vdw zSOSgs1

想用MiniMax H3製作影片時,速度、動作表現和視覺風格往往難以同時兼顧。這項整理聚合19款MiniMax H3 LoRA(Low-Rank Adaptation)模型及變體,讓使用者按工作流需要調整生成方式,而不只依賴基礎模型。

加速類模型以Alibaba的MiniMax-H3 Acc LoRAs為例,透過Parallel Decoding Distillation(PDD)支援FL2VA與Ref2VA工作流,目標是在較少推理步數下維持影像質素。MiniMax H3 Turbo Sparse Linear Attention LoRA則採用Sparse Linear Attention(SLA),以85%注意力稀疏比例提升效率,在NVIDIA RTX 5090上約可達2.5倍推理速度。

其他變體針對不同創作需求,包括1930年代手繪動畫質感、Z-Image風格帶來的紋理和較自然的粗獷感,以及更適合本地執行的4-bit版本。模型需要配合MiniMax H3基礎模型與ComfyUI工作流,LoRA檔案則放入ComfyUI/models/loras資料夾。

• 以少量步數加快影片生成
• 支援FL2VA及Ref2VA工作流
• 涵蓋動畫、寫實、動作和鏡頭風格
• 提供VRAM較友善的4-bit選項
• 速度提升仍需按硬件與畫質要求取捨

適合已使用ComfyUI,並希望細緻控制生成速度、角色移動、鏡頭行為或整體美術方向的創作者。不同LoRA針對的任務差異很大,選擇時應以工作流兼容性和輸出要求為先。

項目主頁

Categories: 開源, ComfyUI, NVIDIA, Video, Image, 教學, 動畫, MiniMax

OpenMAIC:把課堂內容變成多代理互動教學

把主題或文件直接轉成可互動課堂,連投影片、測驗和小組活動都一併生成。它更像一個面向教學流程的多代理 AI 平台。

OpenMAIC

OpenMAIC 是一個多代理 AI 教學平台,處理的是把零散素材快速整理成可教、可互動的課堂內容。使用者只要輸入主題,或者上傳文件、音訊、影片,再加上網頁搜尋素材,系統就會組織出投影片、測驗、互動模擬和專題式學習活動,並由 AI 老師和 AI 同學在課堂內即時互動。

它和一般內容生成工具的分別,在於不只產出講義,而是把整個教學流程串起來。OpenMAIC 內部採用 chat-first 的工作區,支援持久化 session,任務可以在伺服器重啟後繼續,亦可中途取消、回復和調整,較適合需要反覆修訂課程的教育團隊、培訓人員和內容製作人。

  • 可由文字主題或外部素材直接生成完整課堂
  • 支援投影片、測驗、互動模擬、PBL 和 .pptx 匯入
  • 接入 OpenClaw 後,可由 Feishu、Slack、Telegram 等訊息工具建立課堂
  • 可自行接入模型、媒體、搜尋供應商和儲存後端
  • 官方提供 Live Demo,亦可用 Vercel 一鍵部署
OpenMAIC GitHub Setup Guide: From Text Prompt to Local MP4 Classroom Export

OpenMAIC 以多代理協調做編排,並結合 LangGraph、Next.js、React 和 TypeScript。超過 20 項內建技能,定位不是單純聊天機械人,而是把教學內容生產、互動和發佈收束到同一條工作流。

GitHub

Categories: 開源, Agentic, 框架, 教學, LangGraph, OpenClaw

四步生成同步音畫:FastH3 預覽模型拆解

非官放加速 MiniMax FastH3 以四次 Transformer forward 生成同步影片與音訊,但需要專用 VSA-H3 後端及多張高階 GPU。

Og image

文字提示輸入後,FastVideo-FastH3-4-step-Preview-v1-VSA-DataFree 可在四次 Transformer forward 內生成同步影片與音訊,適合測試快速 text-to-audio-video 工作流程。模型明確基於 MiniMaxAI/MiniMax-H3 微調及蒸餾,並以 data-free DMD2 和 VSA-H3 訓練至 step 1300,在 90% sparsity 下換取較少取樣步驟。

模型需要 FastVideo 的 VSA-H3 attention backend,不能只下載權重後以一般推論工具直接執行。官方測試配置使用四張 B200 GPU;其他多 GPU CUDA 系統可改用 Triton kernel,但 GPU 數量必須能整除 H3 的 56 個 attention heads。頁面沒有提供 llama.cpp、Ollama 或 LM Studio 支援,也沒有列出 GGUF 檔案、量化級別、檔案大小或 mmproj 附加檔案,因此不能據此建議 Q4_K_M 或其他量化方案。

  • 四次 forward 生成音訊與影片,速度取向明確
  • DMD2、VSA-H3 及 90% sparsity 用於 data-free 蒸餾
  • 目前只支援 text-to-audio-video,FL2VA 和 Ref2VA 尚未蒸餾
  • 困難動作、細節及部分音訊可能不及 MiniMax H3 base model
  • 頁面未提及 MTP draft speculation、v2 更新或檔名變更

這個 Preview checkpoint 仍可能在動態、細節和音訊穩定度上落後原始 MiniMax H3,定位較接近快速生成與研究測試版本。使用時要留意 MiniMax H3 Community License,以及 FastVideo 安裝流程對 CUDA 13、Blackwell 路徑和專用 kernel wheel 的要求。

模型

Categories: 開源, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, MiniMax

GLM-5.3 開放權重,卻為大型雲端供應商設門檻

GLM-5.3 (753B 參數),已在 Hugging Face 發佈權重,但新授權條款不再採用 MIT,並要求大型提供商接受安全審查。

Og image

想自行下載模型權重、在本地或私有環境運行 GLM-5.3 753B 參數的團隊,現在多了一項不能忽略的授權考量。Z.ai 已把 GLM-5.3 上載到 Hugging Face,讓研究者和開發者取得模型權重,但同時撤下過往的 MIT license。

這個安排令「開放權重」與「完全不設限制的開源授權」出現清楚分別。模型檔案可以取得,不代表所有公司都能按照相同條件提供服務;收入超過 100 億美元的提供商,需要先接受安全審查,條款明顯針對大型雲端及 AI 服務供應商。

對小型團隊、研究人員和需要控制資料流向的企業,GLM-5.3 的權重仍可能方便本地推理、模型整合及內部測試。不過,將模型包裝成公開 API、雲端推理服務或大規模商業產品前,必須先核對新 license 的適用範圍和審查要求。

  • 權重已放上 Hugging Face,降低取得模型的門檻
  • GLM-5.3 不再使用 MIT license
  • 開放權重不等於不受授權條款限制
  • 收入超過 100 億美元的提供商須接受安全審查
  • 商業服務和大規模分發需要額外檢查合規要求

模型

Categories: 開源, 模型, 中國

write-then-publish:自動 .md 排版成為圖文卡

寫完文章後,毋須再分別排版圖片、卡片和長文格式,這個項目把發布前的整理工作集中在同一個工作區。

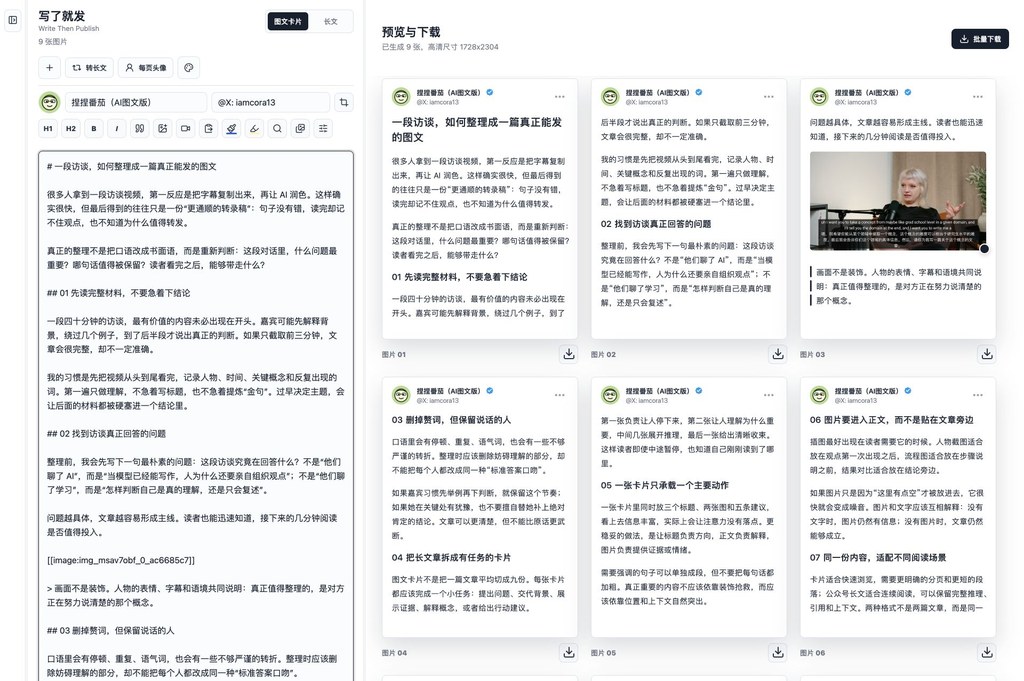
写了就发全屏工作区,左侧是长篇文章编辑框,右侧是三列并排的九张图文卡片,第三张卡片包含真实视频截图

由寫作到發布,最花時間往往不是產生內容,而是重新分頁、整理圖片和適配不同平台格式。這個項目屬於內容製作工具,讓同一份 Markdown 正文同步輸出圖文卡片與公眾號長文,並保留原有結構,不會因為切換模式而改寫內容。

項目採用 Vanilla HTML/CSS/JS,亦提供本地運行方式。圖片支援上傳、貼上、拖放和批量導入,Wiki 圖片引用則可讀取 Obsidian 的 ![[圖片.png]]、![[附件/圖片.png]] 及標準 Markdown 圖片語法。瀏覽器獲得目錄權限後,Markdown 會寫回「寫了就發」,新增圖片則放到「寫了就發/附件/」;未能寫入時會降級為 Markdown 加附件 ZIP。

圖文卡片會自動分頁,標準輸出為 1728 × 2304 PNG;公眾號模式保留標題、列表、引用、程式碼、表格和正文圖片,亦可調整主題、字體、字號與主題色。Live Photo 透過 WebCodecs 處理,可按小紅書或公眾號設定片段時長、比例、裁剪及聲音,並按原始頁序批量下載。

  • 同一份正文切換兩種發布格式
  • 支援 Obsidian 雙向同步及附件整理
  • Live Photo 可剪輯、預覽及批量打包
  • 未授權目錄時提供 ZIP 降級方案
  • Supabase 登入模式以 Row Level Security 按 auth.uid() 隔離資料

項目不涉及生成模型,因此不會替作者寫稿或改寫內容,價值集中在發布前的排版與素材整理。內容創作者、經常維護 Obsidian Vault 的作者,以及需要同時經營公眾號和圖文平台的小型團隊會較容易受益;macOS 本地版另可在配置完成後同步到公眾號草稿箱,但跨平台發布能力仍受瀏覽器權限和平台整合限制影響。

GitHub

Categories: 開源, Image, Mac, 安全

Diffusion Studio:智能影片剪輯工作流

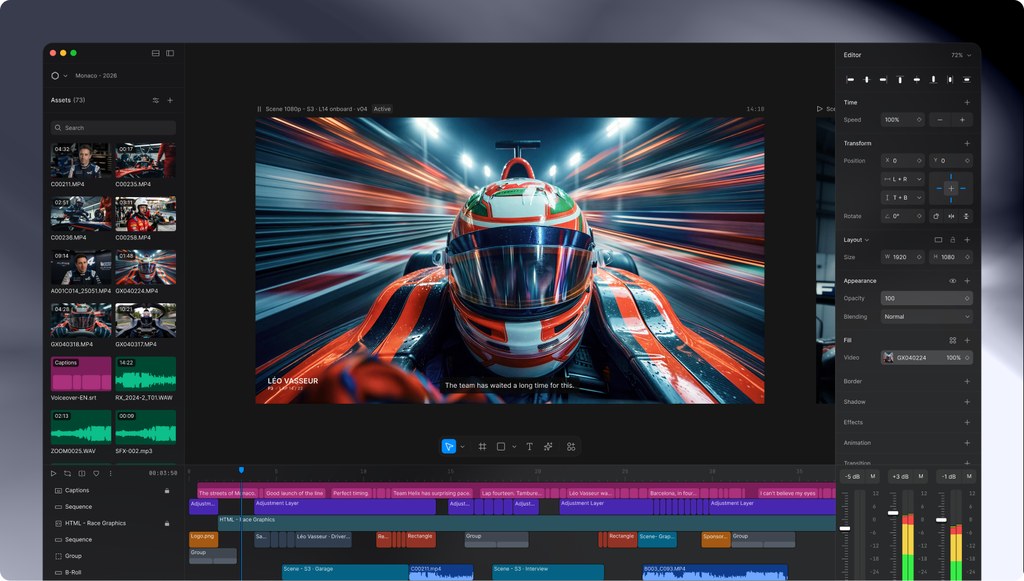
Diffusion Studio 將時間軸剪輯與 SolidJS 程式碼互相同步,讓 AI agents 可以直接協助製作影片。

Diffusion Studio

想用自然語言叫 AI 整理素材、剪出精華片段,甚至加入動態圖像和旁白,Diffusion Studio 提供了一條由命令列控制影片編輯器的工作流。它屬於開源影片編輯工具,核心是以 SolidJS modules 作為文件來源,處理由原始片段到成片的剪輯、合成和影片理解。

畫布與程式碼可以雙向修改:在畫布調整內容,變更會寫回程式碼;直接編輯程式碼,影片畫布亦會重新繪製。配合 dapi CLI,Claude Code、Codex、Cursor、Copilot 或 Gemini CLI 等 agents 能以文字指令操作時間軸,亦可要求系統摘要影片、搜尋場景,或找出附有時間戳的引述。

  • 影片剪輯、Motion graphics、社交平台短片重製
  • 以程式碼宣告圖片、影片和 voiceover,再合成到時間軸
  • 由命令列觀看及聆聽素材,交由 agents 協助處理
  • 可在 macOS Apple Silicon 使用桌面版本,並透過 skills 接入工作流

相比只在時間軸介面操作的編輯器,程式碼成為可保存、修改和交給 agents 處理的文件來源,較適合需要重複產出、批量改版或以生成式資產組成影片的團隊。代價是使用者要同時理解畫布、SolidJS modules 和 CLI 的關係;項目資料亦未提供獨立性能指標或完整平台支援範圍,不能單憑介紹判斷長片剪輯效率。

Diffusion Studio 連接 AI agents 之後可透過程式碼與影片時間軸進行編輯。內容創作者可先下載 macOS Apple Silicon 版本,再安裝官方 skills,透過自然語言要求建立影片,並在畫布中檢查結果;熟悉編程的團隊則可直接維護可重用的影片程式碼。

GitHub

Categories: 開源, Agentic, AI productions, IDE, Mac, 蘋果, Skill 技能

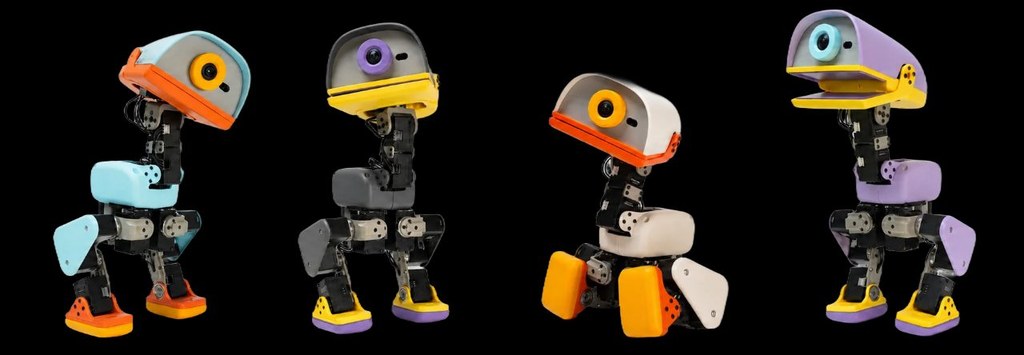
Microduck:細小雙足機械鴨的 RL 控制腦

Microduck 把雙足行走、拾取、起身與遙控操作收進同一套控制系統。它更像一個可落地的機械人控制項目,而不只是展示動作的樣機。

Repository image for pollen-robotics/microduck

Microduck 係一個機械人控制項目,核心係為約 25 厘米、800 克嘅雙足機械鴨提供執行層,解決步行、起身、拾取同模式切換呢類動作控制問題。它唔只做單一演示,而係把無線電、相機、更新流程同 50 Hz 控制迴圈一齊放入同一個執行環境。

呢個項目嘅做法係喺 Rockchip RK3566 上跑幾個 daemon,並用神經策略驅動 15 個伺服。策略本身喺另一個項目 microduck_rl 訓練,採用 MuJoCo、PPO 同 sim2real,再匯出做 ONNX 俾這邊載入;原始資料未提供完整安裝或部署步驟,只能確認佢有 cheat sheet 同 duckctl 等操作入口。

同一般遙控機械人相比,Microduck 將控制、感知同更新機制綁得更緊,重點係讓細小雙足平台可以穩定接收新軟件,而唔會刷壞機器。它亦支援兩套行走形態,行走同輪式模式可以切換,顯示出硬件形態同策略之間嘅配合。

  • 以 RL policies 驅動雙足動作,而唔係只靠固定腳本
  • 在 RK3566 上運行,控制迴圈為 50 Hz
  • 由 microduck_rl 提供訓練與 ONNX 匯出
  • 具備相機、無線電同更新管理
  • 目標場景偏向機械人開發、控制驗證同現場操作

對做機械人研究、控制系統整合,或者想測試 sim2real 流程嘅團隊,呢個項目會較有參考價值。評估數字喺提供資料入面唔多,但已經可以見到它把「細體積、雙足、可更新」呢幾個限制同時處理。

項目主頁 · GitHub · 項目

Categories: 開源, 模型訓練, Robotic

Page 9 of 90
1 7 8 9 10 11 90