文字生成影片時,模型不只要描寫眼前一幕,還要推斷未提供的時間變化,並在角色、場景、動作和鏡頭之間維持一致。FAPL(Factor-Aware Predictive Learning,因素感知預測學習)是一套訓練方法,旨在讓多模態大型語言模型(Multimodal Large Language Model,MLLM)的表示真正參與影片生成,而非被解碼器繞過。
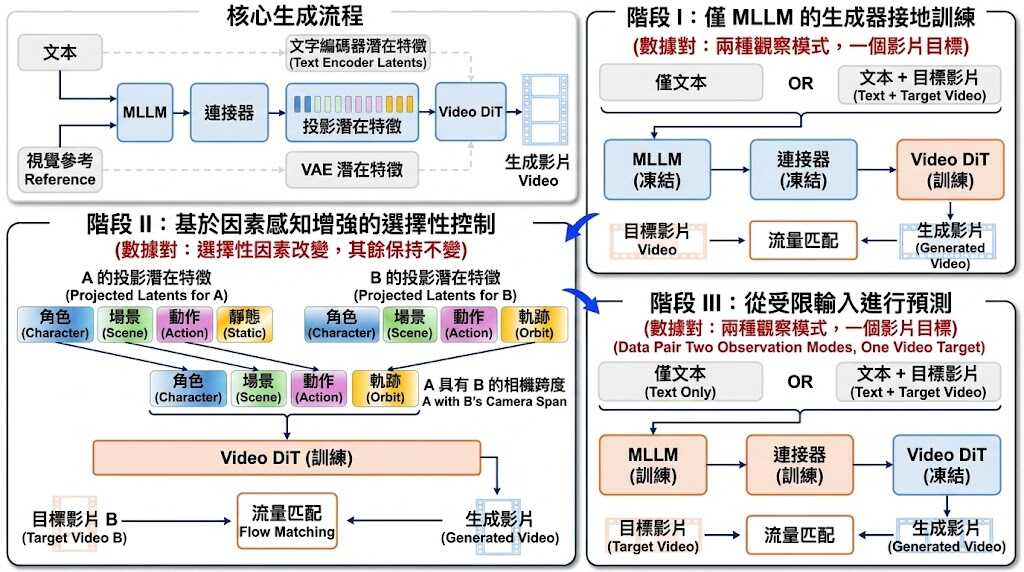
它以 UniVideo 的 13B Video DiT 為基礎,不改動模型架構,而是分三階段訓練:先令 DiT 以 MLLM 潛在表示作為內容條件,再透過成對的因素編輯資料,教模型只改指定內容、保留其他因素;最後固定 DiT,訓練 MLLM 與連接器,讓只有文字或文字加完整影片的輸入都能對應同一影片目標。這讓方法同時處理文字推斷影片細節,以及按因素選擇性控制的需求。
研究團隊可用自己的模型 API 執行全部任務,預設採用 Responses API 模式,亦可切換至 Chat Completions、Anthropic 或 Gemini 端點。項目要求 Linux x86_64 和 Python 3.10,安裝程序會設定 CPU 渲染並透過 apt/sudo 安裝系統套件;場景資源則需另行下載及掛載。它適合研究主動感知、機械人空間理解或多模態代理的團隊作比較測試,但目前提供的是評估基準,不是可直接取代建圖系統的模型。