Paper2Video 能從輸入的論文(LaTeX源碼)、一張圖片和一段音頻,生成完整的學術報告視頻。集成了幻燈片生成、字幕生成、游標定位、語音合成、講者視頻渲染等多模態子模塊,實現一條龍的演示視頻製作流程。支持並行處理以提升視頻生成效率,推薦GPU為NVIDIA A6000(48G顯存)及以上。
需要設定 GPT-4.1 或 Gemini2.5-Pro 等大型語言模型 API Key,支持本地 Qwen 模型。
Paper2Video 能從輸入的論文(LaTeX源碼)、一張圖片和一段音頻,生成完整的學術報告視頻。集成了幻燈片生成、字幕生成、游標定位、語音合成、講者視頻渲染等多模態子模塊,實現一條龍的演示視頻製作流程。支持並行處理以提升視頻生成效率,推薦GPU為NVIDIA A6000(48G顯存)及以上。 需要設定 GPT-4.1 或 Gemini2.5-Pro 等大型語言模型 API Key,支持本地 Qwen 模型。
Paper2Video 能從輸入的論文(LaTeX源碼)、一張圖片和一段音頻,生成完整的學術報告視頻。集成了幻燈片生成、字幕生成、游標定位、語音合成、講者視頻渲染等多模態子模塊,實現一條龍的演示視頻製作流程。支持並行處理以提升視頻生成效率,推薦GPU為NVIDIA A6000(48G顯存)及以上。
需要設定 GPT-4.1 或 Gemini2.5-Pro 等大型語言模型 API Key,支持本地 Qwen 模型。
musubi-tuner 提供使用 HunyuanVideo、Wan2.1/2.2、FramePack、FLUX.1 Kontext 和 Qwen-Image 架構訓練 LoRA(低秩自適應)模型的腳本。
musubi-tuner 提供使用 HunyuanVideo、Wan2.1/2.2、FramePack、FLUX.1 Kontext 和 Qwen-Image 架構訓練 LoRA(低秩自適應)模型的腳本。

GitHub Copilot 編碼代理的強大功能直接帶到您的終端。透過 GitHub Copilot CLI,您可以在本地與能夠理解您的程式碼和 GitHub 上下文的 AI 代理程式同步工作。
GitHub Copilot 編碼代理的強大功能直接帶到您的終端。透過 GitHub Copilot CLI,您可以在本地與能夠理解您的程式碼和 GitHub 上下文的 AI 代理程式同步工作。

Chrome MCP 伺服器是一款基於 Chrome 擴充功能的模型上下文協定 (MCP) 伺服器,它將您的 Chrome 瀏覽器功能開放給 Claude 等 AI 助手,從而實現複雜的瀏覽器自動化、內容分析和語義搜尋。與傳統的瀏覽器自動化工具(例如 Playwright)不同,Chrome MCP 伺服器直接使用您日常使用的 Chrome 瀏覽器,利用現有的使用者習慣、配置和登入狀態,讓各種大型模型或聊天機器人控制您的瀏覽器,真正成為您的日常助理。
Chrome MCP 伺服器是一款基於 Chrome 擴充功能的
模型上下文協定 (MCP) 伺服器,它將您的 Chrome 瀏覽器功能開放給 Claude 等 AI 助手,從而實現複雜的瀏覽器自動化、內容分析和語義搜尋。與傳統的瀏覽器自動化工具(例如 Playwright)不同,
Chrome MCP 伺服器直接使用您日常使用的 Chrome 瀏覽器,利用現有的使用者習慣、配置和登入狀態,讓各種大型模型或聊天機器人控制您的瀏覽器,真正成為您的日常助理。

CWM 由 Meta 開發,是個 320 億參數 (32B) 的密集自回歸解碼器語言模型(dense decoder-only autoregressive LLM) 特別強調如何建模與推理「程式和指令」對環境狀態的影響,被設計為能理解 agentic workflow(即 LLM 與計算環境互動過程中的軌跡) 專注於程式合成與程式理解、代碼推理等研究相關任務。不適合拿來做常規知識問答、閒聊助理、或生產環境 AI。(相關論文) (GitHub)
Wan-Animate,一個用於角色動畫和替換的統一框架。給定一張角色圖像和一段參考視頻,Wan-Animate 可以透過精確複製視頻中角色的表情和動作來為角色製作動畫,從而產生高保真度的角色視頻。或者,它可以將動畫角色整合到參考影片中替換原始角色,複製場景的光線和色調,實現與環境的無縫融合。
Wan-Animate,一個用於角色動畫和替換的統一框架。給定一張角色圖像和一段參考視頻,Wan-Animate 可以透過精確複製視頻中角色的表情和動作來為角色製作動畫,從而產生高保真度的角色視頻。或者,它可以將動畫角色整合到參考影片中替換原始角色,複製場景的光線和色調,實現與環境的無縫融合。
開源 Cosmos DiffusionRenderer 是一個視訊擴散框架,用於高品質影像和視訊的去光和重光。它是原始DiffusionRenderer 的重大更新,在 NVIDIA 改進的資料管理流程的支持下,實現了顯著更高品質的結果。 最低要求 Python 3.10 NVIDIA GPU 至少配備 16GB VRAM,建議配備 >=48GB VRAM NVIDIA 驅動程式和 CUDA 12.0 或更高版本 至少 70GB 可用磁碟空間 教學:
開源 Cosmos DiffusionRenderer 是一個視訊擴散框架,用於高品質影像和視訊的去光和重光。它是原始
DiffusionRenderer 的重大更新,在 NVIDIA 改進的資料管理流程的支持下,實現了顯著更高品質的結果。
最低要求
Python 3.10
NVIDIA GPU 至少配備 16GB VRAM,建議配備 >=48GB VRAM
NVIDIA 驅動程式和 CUDA 12.0 或更高版本
至少 70GB 可用磁碟空間

教學:

HuMo 是一個以人類為核心的多模態條件影片生成框架,能夠根據文本、圖片和音訊三種輸入產生高品質且可精細控制的人物影片。專案由清華大學與字節跳動智創團隊聯合開發 主要特色 快速安裝及使用
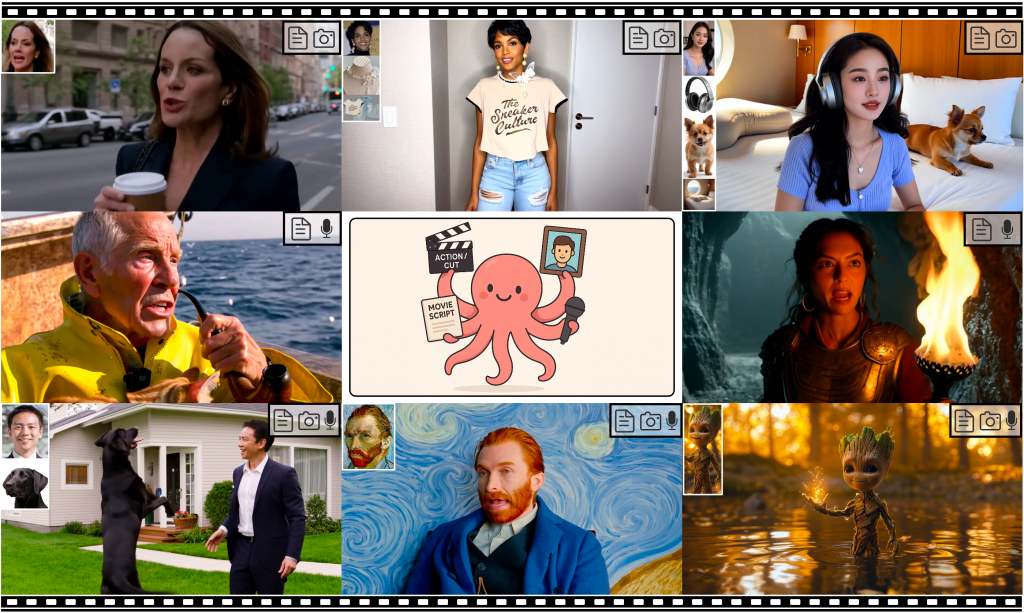
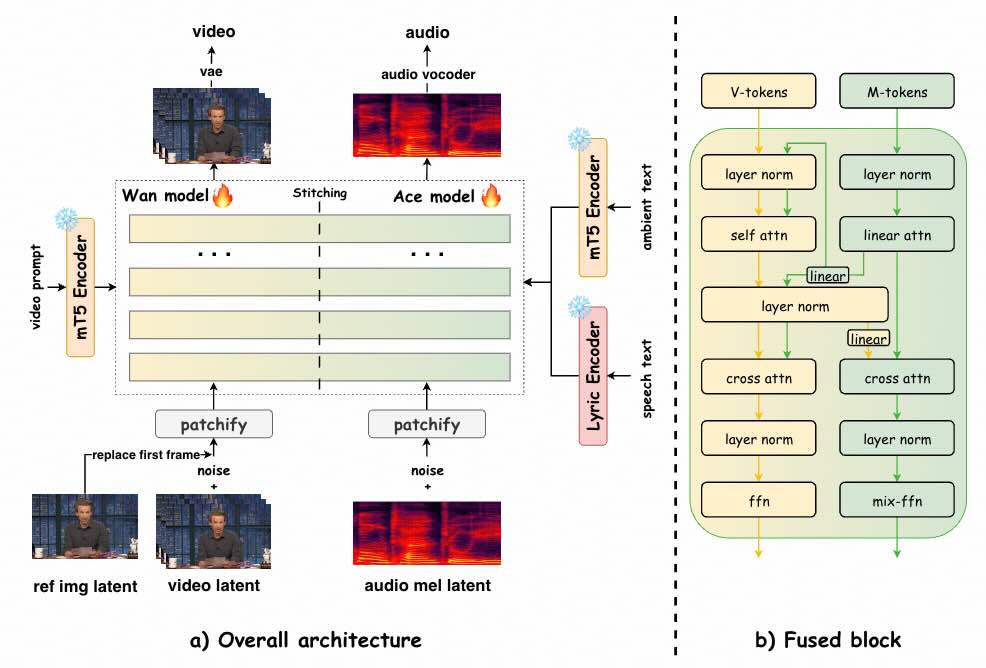
UniVerse-1 是個類似 Veo-3 的模型,可根據參考圖像和文字提示同時產生同步音訊和視訊。
UniVerse-1 是個類似 Veo-3 的模型,可根據參考圖像和文字提示同時產生同步音訊和視訊。
opencode 是一個基於終端機的 AI 工具,專注於協助開發者在終端機環境中進行編碼、除錯等任務。它提供了一個互動式的終端使用者介面(TUI),並支援多種 AI 模型和語言伺服器協議(LSP),以提供程式碼智能功能。 不同於其他工具(如 Claude Code),opencode 不依賴特定 AI 提供商,支援超過 75 個大型語言模型(LLM)提供商,包括 OpenAI、Anthropic Claude、Google Gemini、AWS Bedrock、Groq、Azure OpenAI 等,甚至支援本地模型。 主要功能
opencode 是一個基於終端機的 AI 工具,專注於協助開發者在終端機環境中進行編碼、除錯等任務。它提供了一個互動式的終端使用者介面(TUI),並支援多種 AI 模型和語言伺服器協議(LSP),以提供程式碼智能功能。
不同於其他工具(如 Claude Code),opencode 不依賴特定 AI 提供商,支援超過 75 個大型語言模型(LLM)提供商,包括 OpenAI、Anthropic Claude、Google Gemini、AWS Bedrock、Groq、Azure OpenAI 等,甚至支援本地模型。