Hermes WebUI 把代理搬到瀏覽器

想長開一個會記住上下文的 AI agent,又不想長期困在 terminal,Hermes WebUI 正好補上這個缺口。它保留 CLI 能力,同時把多裝置存取整理得更順手。

Workspace file browser with inline preview

把一個長時間運行、會累積記憶的 autonomous agent 放到瀏覽器,而且幾乎不削弱原本 CLI 操作,正是 Hermes WebUI 最值得留意的地方。它屬於 Agent 介面工具,實際處理的是 Hermes Agent 在日常使用裡不夠方便的互動問題,讓你不必只靠 terminal 或訊息 app 才能管理對話、工作區與設定。

跟不少另起一套前端堆疊的 Web 介面不同,Hermes WebUI 走得相當克制:不用 build step、不用 framework、也不用 bundler,只靠 Python 和 vanilla JS。這種取捨帶來的好處很直接,部署比較輕、維護點較少,亦更貼近原本 Hermes Agent 的運行方式;代價是它的重點明顯放在功能對齊,而不是做一個花巧的前端展示層。

介面設計本身也有明確工作流考量。三欄布局把 session、聊天區與 workspace 檔案瀏覽分開,模型、profile 同 workspace 控制則固定放在 composer footer,減少來回切換;再加上 token context ring、Hermes Control Center、voice、mobile 與主題切換,較適合需要長時間跟 agent 協作、又要隨時查看檔案與工具呼叫紀錄的人。

  • 1:1 對齊 Hermes CLI,終端可做的操作基本都能在 WebUI 完成
  • 支援 session、workspace、voice、profiles、安全設定與手機存取
  • 可用自動探索、手動啟動、SSH tunnel、Tailscale、Docker、Nix 等方式部署
  • 建基於既有 Hermes Agent 與現成模型,毋須另設一套推理環境

安裝理解上,它不是獨立 agent,而是 Hermes Agent 的瀏覽器前端,所以前提仍然是先把 Hermes 本體跑在伺服器,再用 bootstrap、start/ctl 腳本、Docker 或 Nix module 把介面掛上去。在存取方式、部署彈性與跨裝置操作一致性;對於已經在自架 AI agent、想把 CLI 工作流延伸到桌面與手機的人,這個項目的價值相當明確。

GitHub

Categories: 開源, Agentic, 框架, Python, 語音

LISA:讓 MEG 語音解碼由準確走向可解釋

LISA 把腦磁訊號配對到語音嵌入,並保留空間、時間與聲音特徵線索。

LISA architecture and analysis pipeline

將一段 3 秒、208 通道的腦磁圖(magnetoencephalography,MEG)訊號配對到聽到的語音,同時追查證據來自哪個腦部位置與時間段,正是 LISA 要處理的問題。它屬於可解釋神經解碼模型,透過對比式檢索目標,把 MEG 片段映射至對應音訊的 Wav2Vec2 表徵。

LISA 的價值不只在於找出正確語音片段,而是把空間濾波器、時間濾波器和分支結構直接保留下來,方便轉換成感測器空間或皮質來源的分析結果。它採用幾何感知的空間注意力,配合 25 個可解釋分支,每個分支使用 150 ms 時間核心,再接兩個時間卷積區塊。

在 MEG-MASC 實驗中,模型於 1,005 個候選語音片段取得 39.75 ± 0.34% Top-1 準確率及 70.4% Top-10 準確率;完整解碼器有 486,619 個可訓練參數,約為 Défossez et al. 方法的二十分之一。配對 MEG 遮蔽分析亦發現,19 項測試聲音特徵中有 15 項對檢索有貢獻,惟這些結果仍屬特定資料集與實驗設定,不能直接推廣至所有腦訊號任務。

  • 可抽取空間及時間濾波器,支援後續神經科學分析
  • 內置 preprocessing、training、evaluation 與 analysis 程式
  • Python 3.11 的 LISA 環境可用於 synthetic demo 或新資料集
  • CPU 可以執行,訓練階段使用 CUDA-capable GPU 會較合適
  • 重現 MEG-MASC 清理流程,儲存空間峰值約需 300 GB

研究人員可先用 synthetic demo 熟習張量流程,再按文件改接其他 EEG(electroencephalography,EEG)或 MEG 資料。相較只追求檢索準確率的深度解碼器,LISA 以較小模型換取可追溯性;需要完整重現結果的人,仍要準備資料集、環境及較大的儲存空間。

項目主頁 · GitHub

Categories: 開源, 模型訓練, 框架, Medical醫學, 語音

VocalRender 用樂譜直接生成人聲歌唱

寫歌唔再要逐音節對時長。VocalRender用歌詞、MIDI同節奏,直接把譜面轉成更自然的歌聲。

Comparison of duration-based, reference-based, and the proposed score-native singing voice synthesis inputs

寫旋律同填詞的人,最在意往往唔係逐個 phoneme 對時間,而係輸入一份像作曲流程會用到的譜面後,能否聽到有表情、會跟拍子走、又唔會太死板的人聲。VocalRender就瞄準呢個位置:它屬於 singing voice synthesis(SVS)模型,處理的是把歌詞、MIDI pitches、note values 同全域 tempo,連同一段提示音色片段,直接渲染成 48 kHz 歌唱音訊。

它和常見 duration-based SVS 或 reference-based 系統的分野相當明確。前者通常要為每個字或 phoneme 準備精確時長,後者又依賴 time-aligned audio 或 F0 curve;VocalRender改為讀 composer-oriented symbolic scores,讓模型自己在跟譜之下安排較自然的 timing 與 expressive deviations。對作曲、demo 製作、旋律草稿驗證,這種做法比硬性對齊更貼近創作流程。

技術路線亦有清楚取捨。它先用 interleaved lyric-note representation 保留字詞與音符對應,連 melisma 這類一個音節跨多個音都能明確表示;再由 Audio VAE 壓成 continuous acoustic latents,保住 pitch、timbre 同 articulation 細節,之後交給 autoregressive diffusion 建模,其中 AR Transformer負責較整體的 prosody sketch 與長度預測,LocDiT再補回高保真局部聲學內容。

  • 支援資料前處理、訓練同推理,屬於可重現研究流程的最小開源版本
  • 可配合 Hugging Face 模型、CrawlSinger-OS 資料集同官方 Audio Demo 一齊理解效果
  • 輸入核心是 word / pitch / note interleaved score prompt,而唔係逐 phoneme 時長標註
  • 評估線索包括 SingMOS 與 AES,當中 AES 會看 content enjoyment(CE)同 production quality(PQ)

部署時要準備提示音色片段,亦要理解它重視的是「按譜生成有表情歌聲」,不是完全取代後期混音或商業級歌手複製。對需要快速聽到作曲結果、又唔想先做大量時間對齊標註的團隊,VocalRender的價值相當直接,限制亦同樣清楚:它把創作入口大幅簡化,但音色條件、資料品質同最終審美仍然會左右成品。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Audio, 語音

RVC WebUI:低門檻變聲框架的實用與代價

這個語音音色轉換框架把訓練、推理和即時變聲放進同一個網頁介面,重點是讓少量語音資料也能做出可用效果。它的強項在於速度、易用性和模型融合,代價是硬件與延遲條件仍會影響體驗。

Repository image for RVC-Project/Retrieval-based-Voice-Conversion-WebUI

RVC(Retrieval-based Voice Conversion)WebUI 把語音音色轉換、變聲推理和即時變聲收進同一套 Web 介面,適合要快速做 AI 歌聲、配音修音或聲音風格替換的人。它不是單純展示效果,而是把訓練、檢測、推理和即時輸出串成一條可操作流程,降低了進入門檻。

這個項目主打少量資料也能訓練出可用模型,官方建議至少準備 10 分鐘低底噪語音。它採用 top1 檢索去替換輸入特徵,減少音色洩漏,並用 InterSpeech2023-RMVPE 做人聲基頻提取,處理哑音問題時速度快、資源占用也較小。

支援 Python 3.12 x64;Ubuntu 24.04、Windows 與 Linux 都有對應路徑,A 卡和 I 卡則走 CPU 依賴方案,Windows 亦可用 DirectML。即時變聲延遲官方標示可達端到端 170ms,配合 ASIO 輸入輸出設備時可進一步降到 90ms,但對硬件驅動支援要求較高。

  • 可用少量語音資料訓練,門檻比傳統聲音模型低
  • WebUI 同時覆蓋訓練、推理與即時變聲
  • ckpt-merge 允許用模型融合去調整音色
  • 可接入 pymss/MSST 分離人聲與伴奏
  • 更適合配音、歌聲轉換、直播變聲與聲音原型測試

GitHub

Categories: 開源, 數字人, 模型, Linux, Python, 語音, 中國

AVE-Compass:音畫編輯終於有了更嚴格的驗收尺

AVE-Compass 把音效、畫面與指令完成度放在同一套測試中,揭示編輯模型最容易忽略的失真與不同步問題。

AVE-Compass overview

音畫編輯模型最難兼顧「改得夠準」與「其他內容不走樣」。AVE-Compass 是一套針對自由格式音訊影片編輯的診斷基準及評估工具,檢查模型有沒有完成指定修改,同時保留非目標畫面和聲音,亦會捕捉音畫不同步與感知瑕疵。

測試範圍包括145段來源影片、196條經人工核實的音畫指令、2,688項細緻 checklist,以及28種編輯操作,涵蓋聯合音畫、語音、純影片和純音訊修改。它以 Multimodal Large Language Model (MLLM)-as-Judge 配合跨模態、影片及音訊自動指標,分開計算 Instruction Following、Fidelity Preserving、Editing Intent 和 Realism。

MiniMax H3 Turbo LoRA Faster Sampling Steps & Prompt Agent Skill

使用者可從 AVE-Compass-v2 資料集取得樣本,再按設定檔和輸入模板交予評估 pipeline,輸入來源影片、指令、checklist 及模型產生的編輯結果。樣本以共享的識別值配對,來源影片則由 instruction JSON 解決;未啟用或缺失的客觀指標會維持未設定,不會被當成虛構的零分。

重點可整理為:
– Editing Intent 同時要求完成修改及保留非目標內容,避免模型不作修改卻取得偏高保存分數。
– 音訊執行和音畫時間同步是常見失分位置。
– AVE-Agent 加入 planning 和 self-reflection,對複雜指令的 Editing Intent、Instruction Following 及音訊處理有較明顯改善。
– 基準適合研究團隊比較模型,也適合影片生成產品建立回歸測試。

它的價值不在於只給一個總分,而是把「改錯了甚麼」拆開呈現;代價是需要模型輸出影片、完整評估資源及相應 MLLM,部署門檻高於單純像素或音質比較。對正在開發跨模態編輯模型的團隊,AVE-Compass 更像一套找出失敗原因的驗收框架,而不只是排行榜。

項目主頁 · GitHub

Categories: 開源, 南京大學, Agentic, 多模態模型, 語音, Dataset 數據集

SwanTale 以場景佈局生成

SwanTale 把語音與音訊研究集中成一個入口,重點放在更有表達力的生成能力。

swan logo

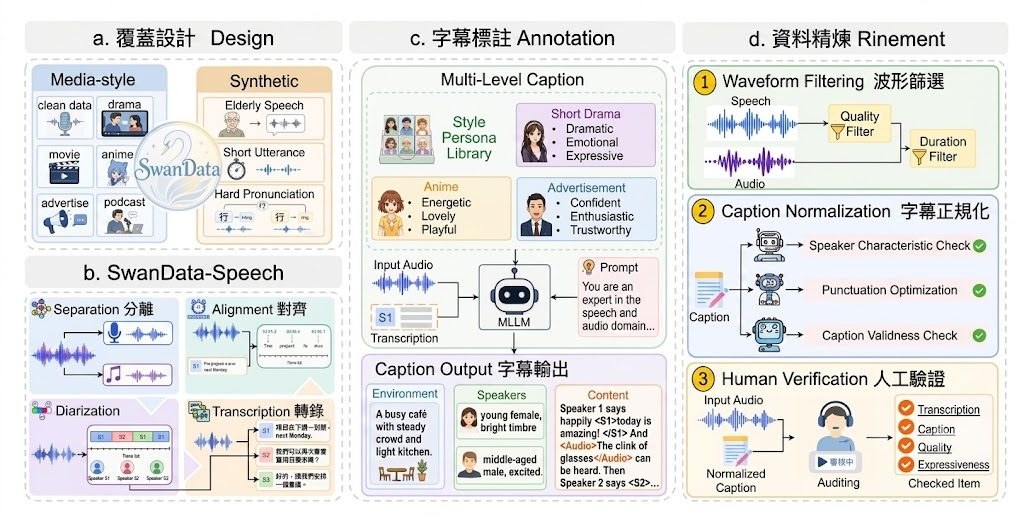
比起只追求把字讀出來,字節跳動的 SwanTale 更著重聲音是否自然、有情緒,亦能否處理多人說話生成。這個由 ByteDance 推出的研究項目,焦點放在 expressive audio、speech 與 multi-speaker generation。

現有資料不算多,但已見到它不是單一模型頁,而是一個集合式研究入口,整合 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere 等子項目。對做語音產品、數字人、配音內容與語音互動工作流的人來說,這類整理方式較易追蹤同一研究線的進展。

  • 聚焦 expressive audio、speech 與 multi-speaker generation
  • 由 ByteDance 發佈,定位偏研究整合入口
  • 站內列出 SwanTale、SwanVoice、SwanBench-Speech、SwanSphere
  • 目前公開資訊有限,性能與方法細節仍要逐個子項目再看

它的價值在於把聲音生成從「可用」推向「更像真人表達」,同時覆蓋多人語音場景。現階段較適合先把它視為字節跳動音訊與語音研究的總覽入口,而不是已完整公開規格的單一產品頁面。

項目主頁

Categories: 字節跳動, 數字人, Audio, 語音

NVIDIA FastGen 平行解碼的加速擴散生成訓練

NVIDIA 團隊把擴散模型加速訓練與蒸餾流程整理成同一套框架,重點不止是跑得快,亦方便跨影像與影片任務重用方法。

Watch the video

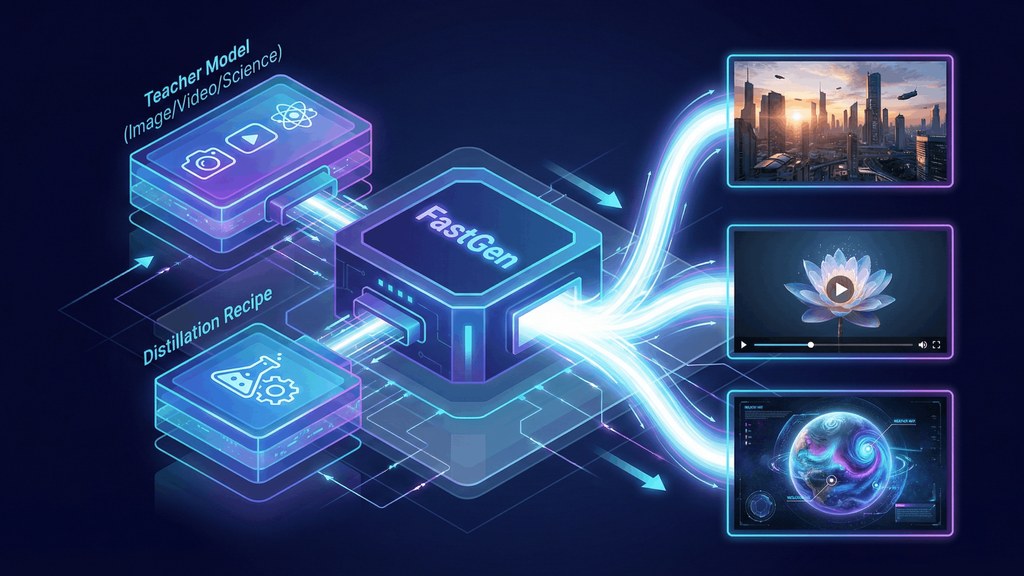
由 NVIDIA 團隊主導,Weili Nie、Julius Berner、Chao Liu 與 Arash Vahdat 是署名作者,核心貢獻者亦包括 Weili Nie、Julius Berner、Chao Liu。這個項目放在 NVlabs 名下,定位很明確:它不是單一生成模型,而是用 PyTorch 建成的訓練框架,集中處理 diffusion models 的加速與蒸餾,讓影像與影片生成可以用較少步數完成推理,同時保留大規模訓練能力。

與一般只提供某一種加速技巧的研究代碼不同,FastGen 把 consistency models、distribution matching distillation、self-forcing、KD 等方法放進同一套結構,並且覆蓋 T2I、I2V、V2V 多種任務。這種設計的價值,在於研究團隊可以在相近配置與資料流程下比較不同蒸餾路線,而不是每試一種方法就重砌整套訓練管線。

基本理解方式:代碼庫包含 datasets、methods、networks、trainer 與 scripts,顯然以訓練、推理、評測三部分分開整理;環境方面建議用 Docker,也保留 conda 安裝路線,並支援 W&B 記錄。不過公開資訊未有列出完整 quick start 細節、現成模型清單或基準成績,現階段較像面向研究與工程團隊的基礎框架,而不是開箱即用的消費級生成工具。

Prompt:
4 NFE PDD on Wan2.1 14B: A joyful child, 
with a big smile and arms spread wide, 
swings energetically on a rusty old swing set in a sunlit backyard. The swing set, with peeling paint and creaking chains, 
contrasts against the vibrant green grass and blooming flowers surrounding it. 

The child's laughter echoes as they swing higher and higher, 
their feet barely touching the ground at the bottom of each arc.
 
The scene is captured from a low angle, 
emphasizing the height of the swings, 
with the sun casting a warm glow over everything.
Medium shot focusing on the child and the swing set.
  • 屬於框架型項目,處理的是 diffusion models 如何更快生成,而不只是再訓練一個新模型
  • 支援 ≥10B 參數的大規模訓練,較適合有多卡資源的團隊
  • 任務涵蓋 T2I、I2V、V2V,對跨模態生成研究較有吸引力
  • 方法層同時納入 consistency models、distribution matching distillation、self-forcing 等路線,方便做橫向比較

配合 NVIDIA 研究頁面的 FastGen-PDD 脈絡來看,這個項目也像是承載後續加速生成方法的底座,尤其面向 image 和 video generation 的 parallel decoding distillation。對想建立自家快速生成訓練流程、測試不同蒸餾策略,或者需要把大型 diffusion 項目整理成可維護代碼庫的團隊,FastGen 的參考價值高;但想直接下載即用、立刻看到完整評測結論的人,現有公開資料仍然偏少。

項目主頁 · GitHub · Paper

Categories: 開源, 視頻模型, NVIDIA, Video, Image, txt2img, Python, 語音

MiniMax H3 頂級高清影片生成

MiniMax H3 提供咗一套較完整的影片生成 API。它重點不只是出片,仲包括參考生成同影片編輯控制。

Og image

做影片內容時,最麻煩往往不只是「生成一段片」,而係點樣令角色、鏡頭起承轉合同參考素材保持一致。MiniMax H3 屬於多模態影片模型,處理的正正係呢類控制力需求:除咗 Text-to-Video,亦支援以首幀、尾幀、參考圖片、參考影片同音訊去引導生成結果。

對內容團隊、短片創作者同需要自動化出片流程的開發者而言,呢個項目的吸引力在於輸入方式夠彈性。你可以由一段 prompt 起步,也可以加入第一張或最後一張畫面去約束開場與收尾;當需要保留人物、動作、鏡頭風格、聲線或剪接節奏,則可改用 Reference Generation。

MiniMax Just Dropped a Open Source "Seedance Killer"
  • 支援 Text-to-Video、First/Last-Frame Image-to-Video、Reference Generation
  • 統一理解 text、image、video、audio,多種素材可混合輸入
  • 輸出最高為 2K,片長 4 至 15 秒,只接受整數秒
  • 參考輸入上限包括最多 9 張圖片、3 段影片、3 段音訊,混合檔案總數上限 12

規格上,MiniMax H3 支援常見長闊比,圖片、影片與音訊都有清晰的格式及大小限制,例如影片可用 H.264/AVC、H.265/HEVC,圖片可用 JPG、PNG、WEBP,音訊則支援 WAV、MP3。音訊不能單獨提交,必須配合圖片或影片一齊使用;而較大的素材更建議用 URL 方式傳入,避免 API request body 超出 64 MB。

現有資料集中在能力範圍、輸入限制同 API 使用方向,能夠幫你快速判斷適唔適合接入工作流。

項目主頁

Categories: MCP, 多模態模型, 視頻模型, API, Video, Image, Audio, 語音, MiniMax

Google 開源 GNM Head:更完整的人頭 3D 模型

做人頭 3D 建模時,最麻煩往往唔係外形,而係眼球、牙齒同舌頭呢類細節。GNM Head 把呢些結構一併納入,定位明顯唔止係傳統面部 3DMM。

GNM Teaser Image

只做臉部外殼,很多時已經唔夠用;去到動畫、重建同生成式影像控制,眼球、口腔同頭部姿態一旦分離得唔好,效果就會即刻穿崩。google/GNM 目前先開放的 GNM Head,屬於3D parametric statistical human model 項目,焦點是用更完整的人頭幾何表示,處理傳統 3D Morphable Models (3DMMs) 對內部 anatomy 覆蓋不足的問題。

這個項目的取向很鮮明:不只是追求一個可調參的人臉網格,而是把 head、face、neck、eyeballs、teeth、tongue 放進同一個生成式人體測量框架。作者在技術報告指出,現有公開模型多數只覆蓋外部幾何,亦容易受限於低保真掃描資料;GNM 則結合高解析 3D scans 與 anatomy-specific artist-made samples,並加入 ocular 同 intra-oral specialized sub-models,目的就是改善幾何品質同可控性之間的取捨。

現有儲存庫較像一個生態系入口,而唔係即開即用的單一應用程式。README 清楚列出 GNM Head 已提供 NumPy、JAX、PyTorch、TensorFlow 多後端支援,亦有 Linux、macOS、Windows 的 CI;但目前公開資訊以模型與技術報告為主,未見到很完整的產品化操作流程說明,所以較適合研究、角色生成、數碼人、3D 視覺或生成式影像控制團隊按其子目錄文件逐步接入。

  • 補足傳統 3DMM 常見缺口:不只外形,連眼球、牙齒、舌頭都可控
  • GNM Head 強調 identity、expressions、head pose 的 disentangled control
  • 同時支援 NumPy、JAX、PyTorch、TensorFlow,方便接去不同研究流程
  • 技術報告聲稱在 fitting target 3D face scans 達到 SotA 表現,但具體指標仍要回看原報告

它最吸引人的地方,在於把「可生成、可擬合、可作條件控制」三條路線拉到同一個模型家族內。現階段公開內容仍以 GNM Ecosystem 的起步版本為主,想拿來做完整 production pipeline,仍要自己判斷與現有重建、動畫或生成系統的整合成本;但作為高保真人頭 3DMM 的新基礎,這個項目的研究價值同延展空間都相當高。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Google, TensorFlow, Mac, 3D, Linux, Python, 語音, Dataset 數據集

FilmOps 將電影語言拆成可分析標籤

想認真分析影片鏡頭,而唔只看「好唔好睇」,FilmOps 提供一套更接近電影製作語言的開源方法。它將畫面拆成可讀標籤,方便做評測、整理同研究。

FilmOps logo

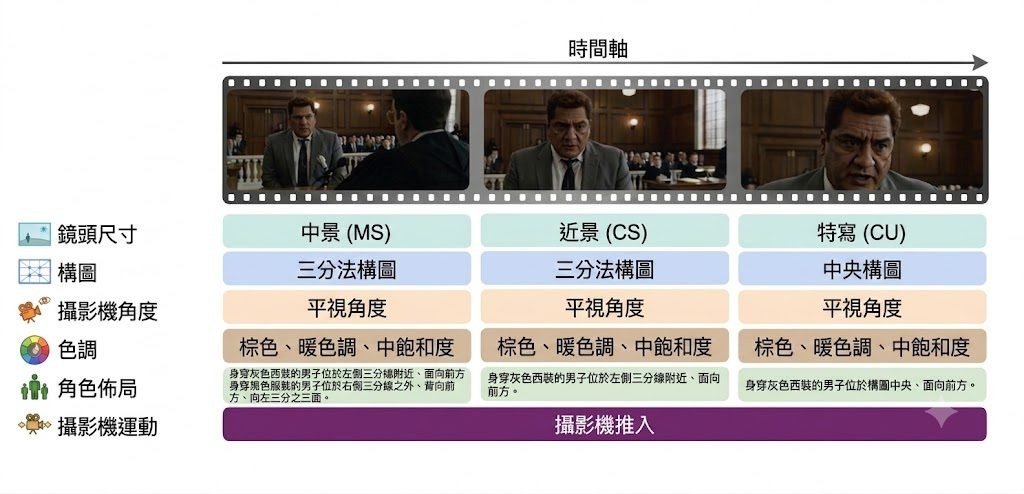
一段影片好不好,不一定只靠整體觀感判斷;鏡頭遠近、構圖、機位、色調同運鏡,往往先係影響觀感的核心。FilmOps 正正瞄準呢個缺口:它不是一般影片生成模型,而是一套開源 operator suite,用來把影片畫面映射成結構化的 cinematographic labels,處理的是電影語言難以被細緻分析與量化的問題。

現有影片 benchmark 多數集中在 general perceptual quality、text alignment 或 temporal smoothness,對專業 cinematographic language 仍然偏粗略;general-purpose MLLMs 又難以穩定辨認 film-specific attributes,而 aesthetic predictors 這類領域模型面對 cinematic content 亦有明顯 domain gap。FilmOps 的取向很清楚:不用單一大模型包辦所有判斷,而是把六個維度拆開,按任務特性分配不同 backbone,令 shot scale、composition、camera angle、color & tone、character layout 同 camera movement 可以分別處理。

它的價值在於更像一套分析管線,而不是只給你一個總分。項目覆蓋 55 個以上子類別,分類定義對齊 Film Art、ASC Manual、Cinematography: Theory and Practice,亦經過 practitioner 驗證;加上 modular architecture,可以獨立用單一 operator,或者走 unified pipeline。對要做影片生成評測、鏡頭標註、資料整理,甚至研究 FilmBench 呢類 cinematic benchmark 的團隊,這種拆解方式會比泛用多模態評分更有解釋力。

  • 屬於開源工具/模型組合,重點是把影片拆成電影語言標籤,而不是直接生成影片
  • 六個 operator 採用 task-specific backbone,包含 DINO ViT-B/14、BEiT Base、ResNet-18、InternVL3-14B
  • 支援 live-action、3D animation、2D animation 同 stylized content,強調 cross-genre consistency
  • 已交代基本部署條件,包括 Python、PyTorch、CUDA 與 ffmpeg,也提供 unified pipeline 與 checkpoints 準備方向

現有資料只明確指出它在所有維度都勝過 general-purpose MLLMs,但細節主要放在論文。配套的 FilmBench 亦用同一套 Cinematic Language 思路建立 benchmark,並聲稱 evaluator 在模型排名上與人工評分高度一致,說明 FilmOps 並非只為展示而做,而是服務整個影片評測流程。不過它始終偏向分析與標註基建,想直接拿來做完整產品,仍要自行處理 checkpoints 下載、推理資源,並接受部分 operator 對 CUDA 與較重模型的依賴。

GitHub · Paper

Categories: 開源, 阿里巴巴, AI productions, 多模態模型, NVIDIA, Gemini, 3D, Python, 語音, 動畫, Dataset 數據集

Page 6 of 11
1 … 4 5 6 7 8 … 11