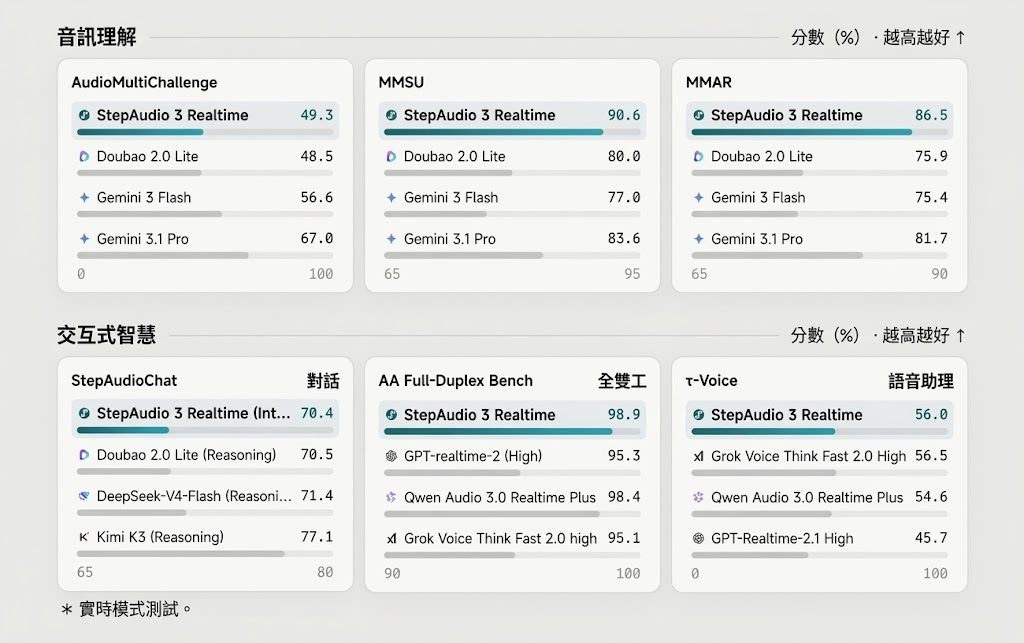
StepAudio 3 Realtime API 由 StepFun-Audio 團隊開發,定位為音頻語言基礎模型,專門處理實時語音互動中最棘手的取捨:既要快速回應,又要進行深度推理。傳統語音助手往往犧牲思考深度換取低延遲,這套模型用「Think-While-Speaking」(邊講邊想)機制,讓模型在語音輸出的同時私下執行推理,從而兼顧即時性與邏輯深度。
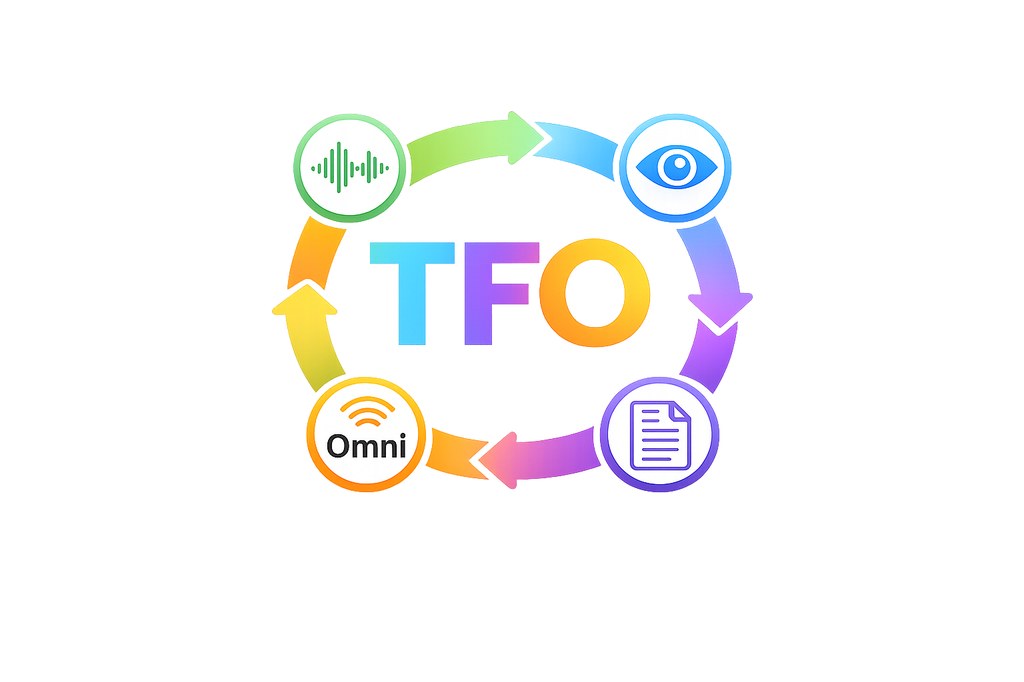
整體架構圍繞連續的「聆聽—對話—思考—行動」循環運作。Deep Perception 模組負責捕捉豐富的聲學線索,理解用戶意圖;Seamless Duplex 模組則同步處理音頻流,妥善應對停頓、插話、打斷等自然對話現象。在推理模式下,模型在 StepAudioChat 基準達到 73.0 的宏觀平均分數,啟用 Think-While-Speaking 後,對話與推理表現可媲美專門的推理模型,同時保持即時語音輸出。
這套方案的核心矛盾在於延遲與推理深度的對立,Think-While-Speaking 的並行設計試圖打破這個零和遊戲,讓語音助手不再需要在「答得快」與「答得深」之間二選一。
重點摘要:
– 核心架構:Deep Perception + Seamless Duplex + Think-While-Speaking 機制
– 效能表現:StepAudioChat 基準 73.0 宏觀平均分,推理模式對標專用推理模型
– 設計目標:解決語音對話中低延遲與深度推理的傳統矛盾
– 開發團隊:StepFun-Audio Team(StepFun 旗下)