anything2explainer:把任何主題變成科普影片

它不是 CLI,而是一套交給 AI 編碼 agent 用的方法包:從研究、旁白、字幕到分鏡,都用 Remotion 寫成 React 元件,產出可逐幀追溯的解說影片。

Repository image for Vincentwei1021/anything2explainer

當你丟一個主題或一篇文件給它,系統會先做資料蒐集並標註來源,再寫旁白、生成 TTS 語音,並把時間軸對齊到逐個鏡頭。接著多個建構 agent 平行運作,每個負責一個 Remotion(React + TypeScript)元件,QC agent 再依書面標準審查每一幀。輸出是 1280×720 H.264 MP4,配上字幕、章節卡與進度條,全程沒有現成影片或生成式影像模型的痕跡。

這套流程對創作者的最大意義在於可追溯。每個鏡頭都有自己的原始碼、QC 報告與研究文件,螢幕上出現的年份、數字、英文術語都要對得到來源 URL;live-action B-roll 也強制記錄在 MANIFEST 裡,附上 sha256、來源與授權。這種「紙本文書鏈」對需要審核的場景——例如企業內訓教材或品牌內容——比多數 AI 影片工具更有交代。

在同類做法裡,它明顯偏向工程化交付而非即興 demo。Remotion 元件庫、燈光與樣式規格、多 agent 協作協議都以可複用資產形式提供,並用一段完整的參考影片作為品質基準。對會寫程式、需要大量長版講解影片但又受版權與準確性束縛的團隊——例如 SaaS 團隊做產品教學、研究單位做技術普及——會比較感受到它的價值。

限制同樣明顯:不是 CLI,必須搭配 Claude Code 或 Codex 這類 agent 環境;TTS 要自備並處理對齊;中英文以外語言未提及支援;整個流程壁鐘 1 到 3 小時,瓶頸在並行建構鏡頭的數量與長度。授權採 PolyForm Noncommercial,商用前要先看清楚。

重點摘要

  • 全程程式碼繪製:用 Remotion 寫 React 元件產出每一幀,沒有生成式影片模型或現成素材。
  • 可審核的紙本文書鏈:研究文件、旁白、分鏡、鏡頭原始碼、QC 報告全部保留。
  • 多 agent 平行建構:研究、旁白、語音、分鏡後,由多個 agent 同時寫鏡頭元件,QC agent 再逐幀複查。
  • 多語言旁白:支援中文與英文,TTS 需自備並做強制對齊。
  • 非商業授權:採用 PolyForm Noncommercial,商用情境需自行評估。
GitHub

Categories: 開源, 文字轉語音, Agentic, AI productions, OpenAI, Video, Image, 工具, Content Creator, 庫, 語音, Anthropic, 動畫, Skill 技能

FireRedTTS3:廣東話與各地方言內容創作,覆蓋 24 種語言與 21 種方言

FireRedTTS3 是把零樣本克隆、語音編輯、聲線設計整合進同一個模型的開源 TTS 項目,支援 24 種語言及 21 種中文方言,亦可純靠文字描述生成全新聲音。

做多語言配音或本地化短片時,最麻煩往往不是翻譯,而是要為每種語言找一個聽起來自然的聲線,又要顧及四川話、閩南話、上海話等方言差異。FireRedTTS3 想處理的就是這個矛盾:它是一個統一式的語音生成框架,把零樣本聲線克隆、語音編輯、以自然語言設計全新聲線三件事放在同一個模型裡,靠的是語義增強的連續語音表徵。

項目分兩個版本。FireRedTTS3-Base 主打多語言克隆,覆蓋 24 種語言(包括粵語在內)以及 21 種中文方言;FireRedTTS3-Instruct 則做到純文字驅動的聲線設計,不需參考音頻,只要描述性別、年齡、音色、語速等特徵,就能合成全新聲音,並且支援語義層與聲學層的自由形式編輯,例如改寫某段對話、調整語速或音量。

相對同類做法,它的差異在於把克隆、編輯、聲線設計整合成單一流程,而非各自獨立訓練模型。在 MiniMax-MLS-Test 上平均 WER/CER 約 3.754%、說話人相似度約 84.8%;在 Seed-TTS-eval 上克隆 WER/CER 約 3.04%、相似度約 78.8%,從公開數字看在多語言與中文方言任務都做到當前較高的水準。

本地配音、廣東話與各地方言內容創作、Podcast 或短影片自動化產出,以及需要快速原型不同聲線的產品團隊,都比較容易受惠。程式碼以 PyTorch 開源,模型已上架 Hugging Face 與 ModelScope,可透過 Python API 呼叫,亦提供 Instruct API 處理聲線設計與編輯。

重點摘要:

  • 多語言零樣本克隆:覆蓋 24 種語言及 21 種中文方言,包括粵語、四川話、上海話、福建話等。
  • 統一語音生成框架:把克隆、聲線設計、語音編輯整合在同一模型內,避免切換多套工具。
  • 純文字聲線設計:以自然語言描述性別、年齡、情緒等特徵即可合成全新聲音,無需參考音頻。
  • 自由形式語音編輯:支援語義層改寫(插入、刪除、替換)及聲學層調整(語速、音量、音調)。
  • 開源易取用:PyTorch 實作、Apache 2.0 授權,模型於 Hugging Face 與 ModelScope 提供下載。

GitHub · 模型

Categories: 開源, 文字轉語音, AI productions, 模型, API, Video, Audio, 語音, 廣東話

OmniEvalKit:唔使重新訓練 VLM 都可以聽聲答問題

MBZUAI Oryx 團隊把 OmniEvalKit 開源出嚟,主打唔使改動 VLM 任何參數,就為佢加掛語音理解能力。對於想評估或部署多模態模型嘅團隊,可以直接拎現成骨幹即試。

Training-Free Omni

想為一個視覺語言模型加入語音理解,但又唔想重新訓練?MBZUAI Oryx 團隊開源嘅 OmniEvalKit(Training-Free Omni)就正正針對呢個痛點。它把語音先經 Whisper 抽取成帶時間戳、語言同信心分數嘅結構化文字,再連同圖片或影片幀一齊餵俾凍結嘅 VLM,所有推理都沿用原本嘅 prompt 接口,骨幹權重全程不動。換句話講,任何新嘅視覺骨幹都可以即插即用,毋須再做語音—視覺對齊微調。

它同時係一個統一嘅多模態評測框架,支援文字、圖片、影片、音頻同音視頻任務,並預載 118 個資料集適配器,涵蓋 Qwen、Gemma、MiniCPM、VILA、OmniVinci 等模型,方便做公平對齊測試。對研究人員同部署團隊而言,最直接嘅好處係可以一次過跑 56 個 benchmark、21 種語言,直接比較凍結骨幹同原生 omni 模型之間嘅差距,睇下語音能力究竟係新加出嚟定係由舊能力交換得嚟。

如果你關心 VLM 加掛語音後會唔會「失憶」,呢套框架正正提供 matched comparison,可以量化評估圖像理解、視覺定位、編碼、數學等原有強項有冇被削弱。額外支援嘅 CosyVoice3 文字轉語音輸出,亦令文本答案可以直接變成語音回覆。

要本地跑得起嚟,需要 Python 3.10+、ffmpeg,再針對 CPU、CUDA 或 ROCm 安裝對應嘅 PyTorch。之後透過 eval.sh 配環境變數指定模型同資料集即可開跑,加 MAX_SAMPLES=3 可以做煙霧測試,中斷後設 RESUME=True 可以接返。

以下係幾個值得留意嘅重點:

  • 凍結骨幹、零微調:所有 VLM 權重完全不變,語音理解透過 Whisper 抽取文字證據再加 prompt 融合達成。
  • 即插即用嘅 omni 能力:支援 Qwen2.5-Omni、Gemma、MiniCPM、VILA、OmniVinci 等多個模型適配器,方便横向比較。
  • 覆蓋廣嘅評測矩陣:內置 118 個資料集適配器,涵蓋 56 個 benchmark 與 21 種語言。
  • 原生 omni 同凍結骨幹嘅 matched 對照:可以清晰分辨新增能力同保留能力,避免重訓帶嚟嘅 capability drift。
  • 可選語音回覆:透過 CosyVoice3 把文字答案合成語音輸出,適合對話式場景。

項目主頁 · GitHub

Categories: 開源, 文字轉語音, AI productions, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, NVIDIA, Gemini, Video, Image, 框架, Python, 語音, Dataset 數據集

VibeVoice-ASR-Streaming-7B 即時辨識與轉錄合而為一

Microsoft Research團隊將講者辨識加入串流語音轉錄,讓語音助手更快知道誰在說甚麼。

Hugging Face

Microsoft Research 聯同中國科學院大學及上海交通大學研究人員,開發VibeVoice-ASR-Streaming。

模型以 Large Language Model(LLM)為核心的端到端串流Speaker-Attributed Automatic Speech Recognition(ASR)系統,連續處理到達中的語音,同時輸出文字及講者身份。傳統流程通常把ASR與speaker diarization分開處理;此模型將兩項工作放進單一模型,針對即時語音助手及語音代理需要低延遲回應的場景,減少等待完整錄音後才分析的限制。

VibeVoice-ASR-Streaming 會交錯處理固定大小的audio chunks,並加入少量lookahead,讓模型在保留未來聲音片段作判斷的同時,逐步產生轉錄結果。固定分塊有助控制處理延遲,但lookahead 與分塊大小之間仍要取捨:前者越多,講者切換及語句判斷可能更穩定,回應時間亦可能增加。

  • 以單一LLM-based端到端模型同步處理ASR與speaker attribution
  • 使用固定大小audio chunks及少量lookahead支援串流輸出
  • 針對即時語音助手及agents的低延遲需求設計
  • 量化檔案、推論框架、硬體需求及效能指標尚未在提供內容中交代

項目主頁 · Paper · 模型

Categories: Agentic, 微軟, Audio, Discord, LLaMa, Ollama, 語音, Dataset 數據集

Motion-Omni:「講嘢」同「做嘢」視為同一件事,直接生成全身動作

Motion-Omni 把語音和全身動作綁在同一個模型,講一句話就能即時生成對應嘅身體動作、表情同手势,適合需要邊講邊做嘅虛擬角色。

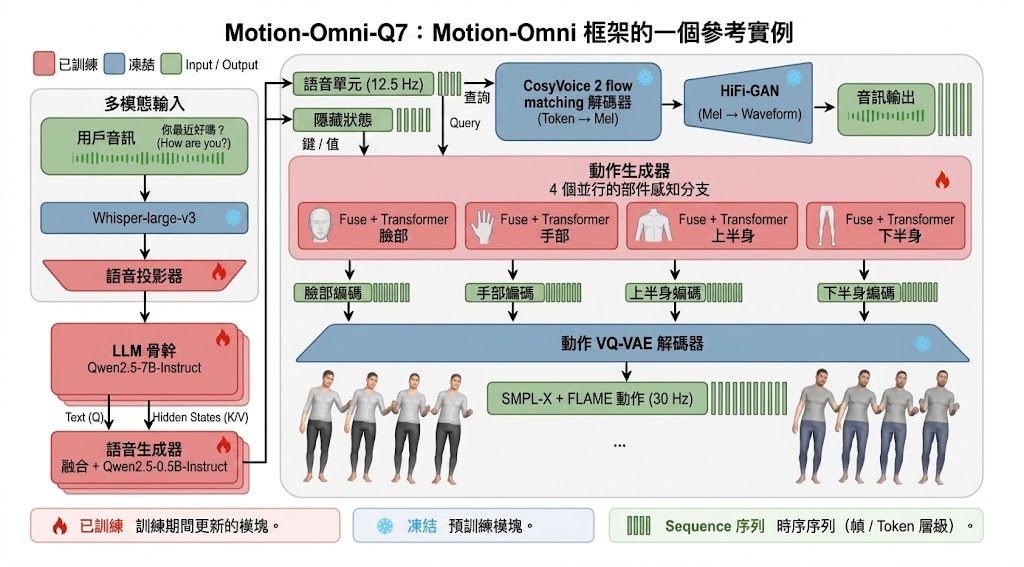
Motion-Omni framework

試過睇虛擬角色傾偈,個口形郁但身體硬晒,或者要逐段人手配動作?Motion-Omni 想解決嘅就係呢種「聲有、體無」嘅唔自然感。佢係一個端到端嘅多模態模型,輸入一段語音,輸出唔只有語音本身,仲有頭部、表情、手势以至全身姿態,全部喺同一個框架一齊生成,避免傳統做法分開處理再硬砌嘅斷裂感。

Motion-Omni 用咗一個統一嘅 tokenizer 把語音、文本同動作 token 化,配合 LoRA(Low-Rank Adaptation)adapter 等輕量微調技術,令模型可以同時學語音同肢體表達。生成嘅動作涵蓋手部、軀幹、面部表情,適合需要即時互動嘅場景,例如 AI 助手、虛擬客服、遊戲 NPC、語音驅動嘅動畫原型。

傳統動畫要先錄關鍵動作、再做 lip-sync 後製,而坊間部分開源方案往往只能控制頭部或者手部其中一樣。Motion-Omni 嘅做法係將「講嘢」同「做嘢」視為同一件事,所以動作會跟語氣、節奏同步變化,唔使額外人手調整。佢同時支援文字輸入,等開發者可以更直接控制角色行為。

對做 AI 角色、互動內容、語音動畫嘅團隊嚟講,呢種端到端做法可以慳唔少配動作同後製嘅工序,尤其適合需要快速原型嘅項目。讀者可以透過官方頁面睇影片 demo,評估生成動作嘅自然度同延遲表現,再判斷適唔適合自己嘅工作流。

重點摘要

  • Motion-Omni 係一個端到端多模態模型,同時輸出語音、表情同全身動作
  • 用統一 tokenizer 加 LoRA adapter 處理語音、文本同動作 token
  • 覆蓋頭部、手部、軀幹同面部表情,適合即時互動角色
  • 傳統做法分開配音同配動作,呢個模型將兩者合併生成
  • 適用於 AI 助手、虛擬客服、遊戲 NPC、語音動畫原型等場景

項目主頁 · GitHub

Categories: 開源, 香港中文大學, 北京大學, AI productions, 模型, 多模態模型, Video, 框架, 語音, 動畫

Hojo TTS Light 輕量語音合成,4000 萬參數就做到 15 種聲線

Hojo-TTS-Light 僅約 0.08B 參數,以 ONNX 格式在 CPU 即時合成 24 kHz 語音,並預載 15 種聲線,免依賴 PyTorch。

Og image

想把文字轉語音(TTS)嵌入邊緣裝置或本地腳本,最大阻力往往來自 PyTorch 依賴肥大、GPU 門檻高。Hojo-TTS-Light 直接以 ONNX Runtime 執行,連 PyTorch 都不用安裝,對只有 CPU 或資源受限的環境相當友善。模型檔約 4000 萬參數(0.08B),輸出 24 kHz 音訊,並內建 15 種預設說話人聲線,開發者只需切換 embedding 即可換聲,省下自行收集語料或微調的工序。

隨倉提供的 infer.py 與 onnx_model.py 展示完整推理流程,搭配 requirements.txt 即可用幾行程式碼完成合成。對需要快速在本地或伺服器側加入語音回饋的項目而言,這種「開箱即播」的設計,比傳統 TTS pipeline 更貼近部署需求。

不過,15 種聲線屬於 preset 性質,若要新增自訂說話人,就需要額外準備參考音訊與對應 embedding,無法像大型 TTS 模型那樣靠一句話克隆。整體取向偏向「輕量、即用」,而非追求擬真度或表現力。

重點摘要:

  • 參數量約 0.08B,屬輕量級 TTS 模型
  • 採用 ONNX 格式,免安裝 PyTorch 即可在 CPU 環境執行
  • 預載 15 種 speaker-conditioned 聲線,可即時切換
  • 隨附 infer.py、onnx_model.py、requirements.txt,方便快速整合
  • 發佈平台為 Hugging Face,授權與權重可至該頁查閱

適合需要把語音合成嵌進邊緣裝置、CLI 工具或本地自動化流程的開發者;對追求高擬真或自訂聲線克隆的場景,則需要再評估擴充成本。

項目主頁

Categories: 開源, 文字轉語音, Agentic, Embedding, 模型, Audio, 語音, Skill 技能

Hojo-ASR-Multi-V1:廣東話語音識別引擎

基於 Qwen3-4B-Instruct-2507 微調而成的多語言語音辨識模型,覆蓋歐亞九種語言,嘈雜環境與口語修正都有對應訓練。

Og image

如果你聽過一段嘈雜環境裡帶口音嘅外語對話,想即時轉成文字,Hojo-ASR-Multi-V1 就係針對呢類場景設計嘅。它並非由零訓練嘅語音模型,而係喺 Qwen/Qwen3-4B-Instruct-2507 之上做微調,把語音編碼器接駁到大語言模型嘅解碼端,形成 Encoder-Adapter-LLM 嘅典型結構,再加入多幀聲學融合模組去保留細粒度嘅聲音特徵。訓練過程分階段進行並結合強化學習,所以喺噪音、非標準發音、講錯即改口呢類真實情境下都唔會輕易崩潰。

多語言覆蓋係佢最突出嘅賣點。官方公布支援德、法、西、葡、意、日、阿拉伯、韓、俄等九種主要語言,並加入咗普通話、英語、廣東話同四川話等方言支援。從公開評測結果睇,佢喺多個 CoVoST、MLS 同 FLEURS 基準上都錄得相當低嘅 WER,例如意大利 FLEURS 2.30、法語 MLS 2.95、德語 CoVoST 3.85,整體表現平穩。

喺使用層面,開發者可以透過 PyPI 上嘅 hojo-asr 套件快速部署,亦支援 Hugging Face Transformers 後端。HOJO_ASR.load_model 介面可以直接接收 wav 檔案路徑、scp 清單或原始音訊 bytes,配合 CUDA 設備做批次推論。授權用 Apache-2.0,並提供商業整合支援,方便團隊接入產品線。

由於佢建基於 Qwen3-4B 體量,運行門檻比傳統大型 ASR 親民得多,但仍然需要 GPU 推論以維持批次速度。

重點摘要:

  • 基礎模型:以 Qwen/Qwen3-4B-Instruct-2507 為骨幹,採用 Encoder-Adapter-LLM 架構
  • 語言覆蓋:歐亞九國主要語言,加普通話、英語、廣東話、四川話
  • 訓練方式:多階段模組化訓練結合強化學習,針對噪音同口語修正優化
  • 評測表現:CoVoST、MLS、FLEURS 多語言 WER 普遍處於 2–5 區間
  • 部署方式:pip install hojo-asr 後用 HOJO_ASR.load_model 載入,支援檔案路徑、scp 或 bytes 輸入

需要留意嘅係,頁面並未提供 GGUF 量化檔案或本地推論引擎資訊,目前主要以 transformers 後端配合 GPU 運行;如果你想喺純 CPU 或邊緣裝置上使用,就要留意後續會唔會補上量化版本。

項目主頁

Categories: 開源, 模型, Qwen, Audio, 庫, 語音, Dataset 數據集, 廣東話

Qwen-Audio Realtime API 上線:以 WebSocket 即時串接語音對話

阿里巴巴雲 Model Studio 推出 Qwen-Audio Realtime API,用 WebSocket 串流處理語音輸入與輸出,支援 VAD 偵測與雙向文字回傳,適合即時語音助理開發。

Og image

想在應用程式裡加入即時語音對話,但又不想自己串接一堆音訊前處理、ASR、TTS 的流程?阿里巴巴雲 Model Studio 這次直接把 Qwen-Audio 做成可即時呼叫的 Realtime API,開發者只要透過 WebSocket 連線,就能處理語音輸入、文字輸入,並即時收到串流音訊與文字回應。

這個 API 的設計重點在於「一條連線做完整件事」。客戶端與伺服器以 JSON 事件雙向溝通,支援語音活動偵測(VAD),讓系統知道用戶何時開始與結束說話,省去自行判斷靜音的麻煩。對話中的每一則訊息會以 conversation item 形式保存,整個 session(即一條 WebSocket 連線)則負責維護設定與上下文狀態。

服務端點分為中國(北京)與新加坡兩個區域,皆已改用 workspace-specific 專屬網域,官方表示穩定度與推論表現都比原本的共用網域更好。連線時需使用 wss:// 協定,並在 request header 帶上 Authorization: Bearer <your_api_key>,API key 會在 WebSocket 握手階段驗證,若無效會直接回 HTTP 401/403。

若你的項目是語音助理、即時翻譯、客服 robot 或電話自動化,會感受到整合成本明顯降低——不用分別串 ASR、LLM、TTS,只要管理好 WebSocket 的事件流即可。舊網域雖然仍可用,但官方強烈建議遷移至新網域以取得更佳體驗。

重點摘要

  • 即時雙向串流:WebSocket 連線同時處理音訊輸入與串流輸出,搭配 VAD 自動偵測語音起止。
  • JSON 事件溝通:所有互動以結構化事件傳遞,方便除錯與日誌記錄。
  • 雙區域專屬網域:中國(北京)與新加坡皆提供 workspace-specific 端點,穩定度與推論表現提升。
  • 簡化整合流程:免去自行串接 ASR、LLM、TTS 的負擔,適合快速建構語音應用。
  • 原有網域仍可用:但官方建議盡快遷移以享受新網域的效能改善。

項目主頁

Categories: 阿里巴巴, 文字轉語音, Qwen, API, Audio, Robotic, 語音, 中國

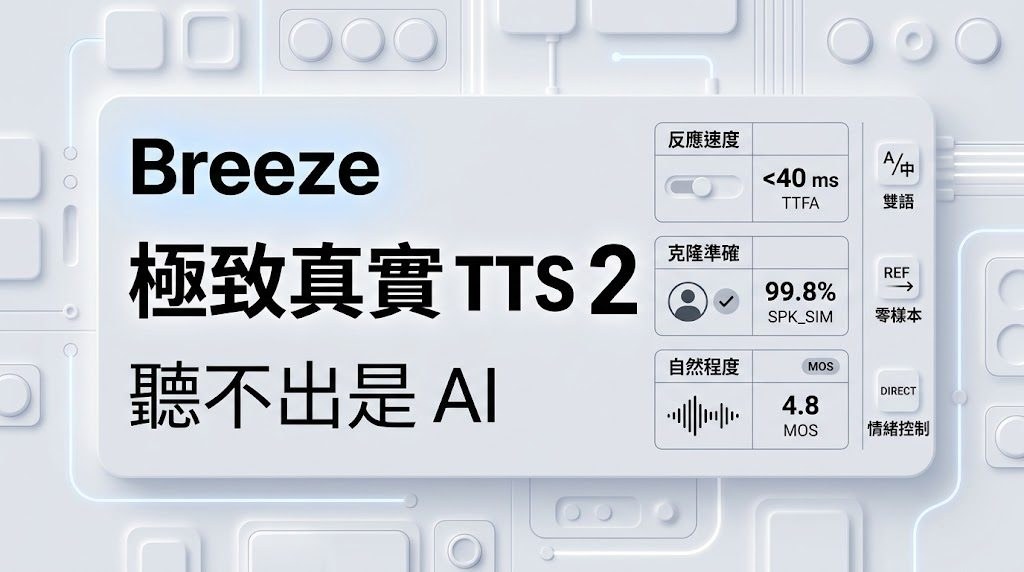
Breeze TTS 2 即時語音生成

Breeze TTS 2 主打即時語音互動,兼顧聲線設計、聲線模仿與低延遲串流。它把自然語言指令和參考音訊結合起來,令語音生成更靈活。

Og image

Breeze TTS 2 屬於 text-to-speech(TTS)模型,核心目標是把即時語音互動做得更自然,並同時處理聲線模仿、聲線設計和語氣控制。它基於自然語言指令,既可以用參考音訊去保留聲線特徵,也可以不靠參考音訊直接設計聲音,這令使用場景比一般單一路徑的 TTS 更廣。

模型權重只限研究與非商業用途,而原始程式碼則採用 Apache 2.0,這表示權重與程式碼的授權條款並不相同。

Breeze TTS 2 支援 Voice Clone、Voice Design、Voice Direction,同時提供 Vocal Events,讓使用者可在文字中加入 (laugh)、(cough) 之類的表現指令。頁面亦強調它有 ultra-low-latency streaming,適合需要即時回應的對話式語音互動。

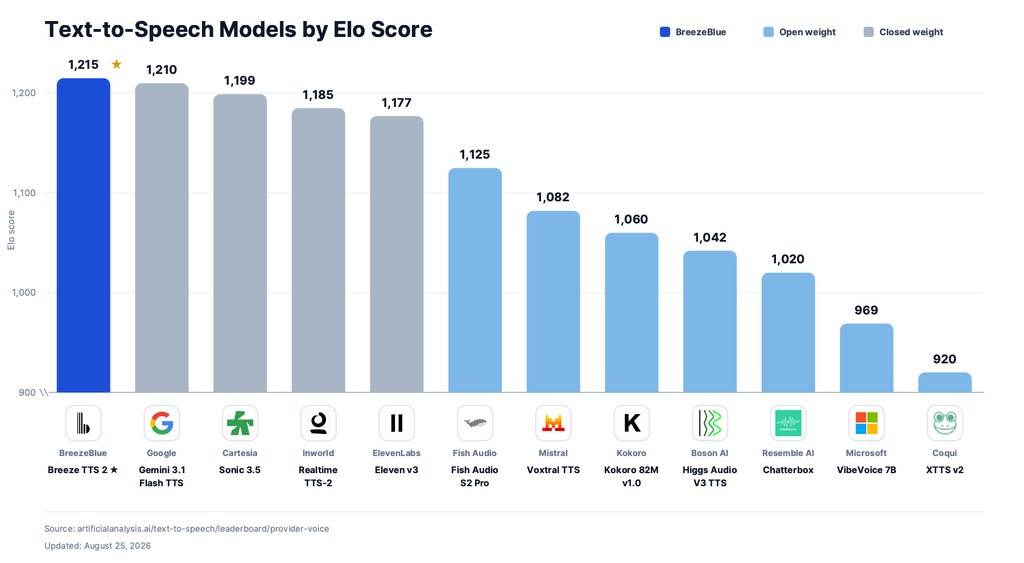
重點主要集中在功能和評測定位,沒有提供 GGUF 檔案、mmproj、量化版本、檔案大小,亦未提到 llama.cpp、Ollama 或 LM Studio。只見到它在 Artificial Analysis TTS leaderboard 排名第一,並聲稱表現超越部分閉源前沿系統;但由於頁面未展示完整測試細節,較適合把它視為一個以互動延遲、可控性和聲線表現力作賣點的語音模型。

  • 支援參考音訊模仿,也支援純文字描述生成新聲線
  • 可以用文字內嵌事件控制笑聲、咳嗽等表現細節
  • 主打低延遲串流,適合即時語音互動
  • 權重屬研究與非商業用途,授權限制要先看清
  • 頁面未提供量化、GGUF 或本地推論框架資訊

模型

Categories: 開源, 文字轉語音, 模型, 語音

Breeze TTS 2:低延遲語音生成再推一級

Breeze TTS 2 把即時語音互動、聲線設計同語氣控制放埋一齊,主打低延遲同高可塑性。它較適合要做配音、語音代理或互動內容嘅團隊。

BreezeBlue

Breeze TTS 2 係一個文字轉語音(text-to-speech, TTS)模型,重點唔止係把文字讀出,而係處理即時互動入面最難平衡嘅兩件事:聲音要自然,回應又要夠快。佢支援 Voice Clone、Voice Design 同 Voice Direction,代表可以由參考錄音複製聲線,亦可以純靠自然語言描述去設計新聲線,再按指令調整語氣、節奏同表達。

對內容製作、語音代理、遊戲角色配音同多語言產品來講,呢種做法比單純 TTS 更有彈性。文本內仲可以插入 Vocal Events,例如笑聲、咳嗽、清嗓子呢類表情提示,令生成聲音更接近真人演繹,而唔係只係平鋪直敘讀稿。

項目資料顯示,佢喺 Artificial Analysis TTS leaderboard 排名第一嘅 open-weight 模型,亦聲稱喺部分測試中超越商業系統。低延遲係另一個賣點:warming 後喺 NVIDIA H100 可做到少於 40 ms 的 time to first audio,RTF 約 0.32,適合即時對話場景。

不過,repo 同時寫明模型權重、衍生模型同 self-hosted outputs 只限研究同非商業用途,呢點對想直接落地嘅團隊影響好大。代碼層面提供 PyTorch inference code,但原始資料未交代完整安裝流程或部署細節,較合理嘅理解方式係先把佢視為一個面向研究與產品原型驗證的高性能 TTS 模型。

  • 支援參考錄音複製聲線,亦支援純文字描述設計新聲線
  • 可以用指令調整語氣、情緒、語速同演繹方式
  • 低延遲串流適合即時語音互動同 voice agent
  • 在 open-weight TTS 基準中聲稱領先,但授權限制較嚴
  • 適合配音、互動內容、多語言語音產品同研究團隊

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, Agentic, 模型, NVIDIA, Audio, Clone, Python, 語音, Dataset 數據集

Page 4 of 11
1 2 3 4 5 6 … 11