RubatoCodec:深入神經音訊編碼 – 殘差向量量化(RVQ)與高保真重構架構

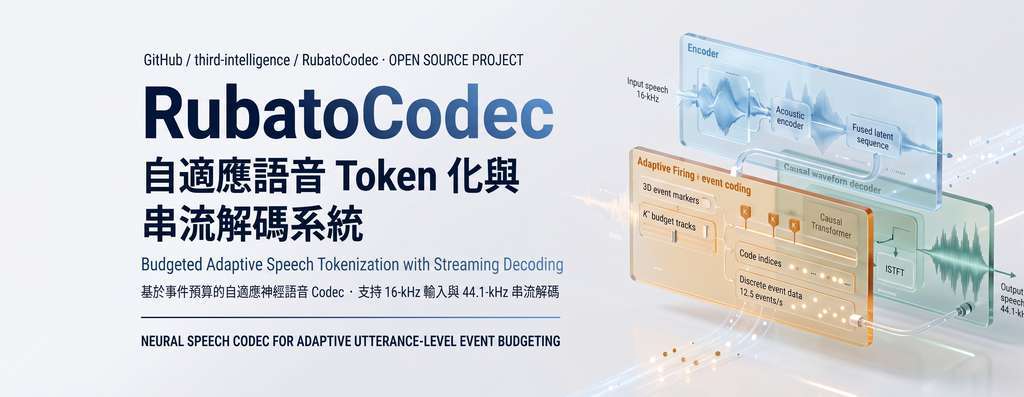
固定長度切分未必適合語音的每個片段;RubatoCodec 按訊號變化分配事件,並可逐段解碼,面向低位元率語音處理與串流生成。

RubatoCodec architecture

語音片段的資訊密度各有不同,若一律按固定長度切分,便難以按內容分配編碼資源。RubatoCodec 是神經語音編碼器,會把語音轉成帶有離散碼索引和持續時間的可變長事件,並支援逐段重建波形,適合需要控制碼率或串流輸出的語音系統。

它在 50 Hz 潛在表示上,參考多尺度潛在特徵差異和波形頻譜通量,累積分配事件;預設目標比例為 0.25,整段語音的事件數則按公式精確控制。這種做法毋須另設邊界預測器、邊界標籤或 rate loss,但仍需把事件持續時間一併納入編碼,不能只看碼索引的位元率。
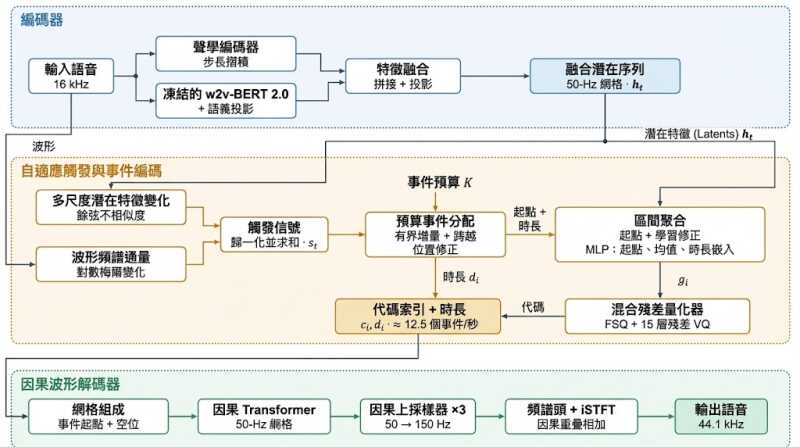
量化器採用 16 層混合式殘差結構:首層是接受語義監督的 FSQ,其後 15 層使用 DAC-style residual VQ。解碼時可選用 1 至 16 層的任意前綴深度,名義碼索引位元率約為 150 至 2,400 bit/s,另加持續時間資訊;模型以約每秒 12.5 個事件表示語音,輸入為 16 kHz,因果串流解碼器輸出 44.1 kHz。

每個事件代表約 80 毫秒音訊,在 H200 上解碼約需 11 毫秒,具備逐事件或分批解碼的條件。這是硬件與模型設定下的速度數據,不能直接當成其他設備上的延遲保證;現有資訊亦未提供足以比較音質取捨的具體評測結果。

研究人員、語音模型開發團隊,以及需要低碼率儲存或即時音訊處理的系統,可用公開模型和 Python API 載入語音、編碼,再按指定深度解碼。重點包括:
– 事件長度按語音訊號變化調整,整段事件數受目標比例控制。
– 支援逐事件或分批串流解碼。
– 可選不同量化器深度,在碼率與表示容量之間調整。
– 編碼資訊除離散碼索引外,亦包括事件持續時間。
– H200 上每事件約需 11 毫秒解碼,其他硬件表現未有提供。

基本使用範例(推論與重構流程)

專案通常遵循標準 PyTorch 神經編解碼介面,基本 Python 處理流程如下:

import torch
import torchaudio
from rubatocodec import RubatoCodec

# 1. 載入模型與權重
device = "cuda" if torch.cuda.is_available() else "cpu"
model = RubatoCodec.from_pretrained("third-intelligence/RubatoCodec").to(device)
model.eval()

# 2. 讀取並預處理音訊(重取樣至模型支援之採樣率)
waveform, sample_rate = torchaudio.load("input.wav")
if sample_rate != model.sample_rate:
    resampler = torchaudio.transforms.Resample(sample_rate, model.sample_rate)
    waveform = resampler(waveform)

waveform = waveform.unsqueeze(0).to(device)  # [Batch, Channels, Time]

# 3. 編碼:提取離散 Tokens (RVQ Codes)
with torch.no_grad():
    # tokens 形狀通常為 [Batch, Num_Quantizers, Frames]
    tokens = model.encode(waveform)

# 4. 解碼:由離散 Tokens 還原音訊波形
with torch.no_grad():
    reconstructed_waveform = model.decode(tokens)

# 5. 儲存重構音訊
torchaudio.save("reconstructed.wav", reconstructed_waveform.squeeze(0).cpu(), model.sample_rate)
GitHub · 模型

Categories: 開源, 模型, NVIDIA, API, Audio, Python, 語音, Dataset 數據集

PawCT:分拆四聲部合唱

把合唱錄音轉成可分辨女高音、女低音、男高音與男低音的 MIDI 音符,有助排練和樂譜重建。PawCT 直接輸出四部聲線,並以 YouChorale 測試其分部能力。

Ground truth, PawCT, PagCT, and PagCT plus Post-VA piano rolls

要從整隊合唱錄音還原各聲部,難處不只是聽出音符,還要判斷每個音符屬於哪一部。PawCT 是一套合唱自動音樂轉錄(Automatic Music Transcription,AMT)研究模型,會把混合錄音轉成女高音、女低音、男高音與男低音(SATB)的獨立音符軌,適合用於排練準備、音樂教育和樂譜重建。

PawCT 亦提供 PagCT,先轉錄不分聲部的合併音符軌;另一個基線 Post-VA 則在第二階段,按符號音樂資料為音符分配聲部。PawCT 把聲部辨識納入端到端轉錄,並以共享編碼器配合 SATB 專屬的起音、延音結束及音框輸出頭;音域先驗(RP)和有序連續性先驗(OC)則在訓練損失中限制不合理音域與旋律走向,推理時毋須額外模組。

YouChorale 的 PagCT 的單軌音符 F1 為 0.382,高於 Yu et al. (2024) 的 0.237;SATB 平均音符 F1 則由 PagCT 加 Post-VA 的 0.175,升至 PawCT 加 RP 與 OC 的 0.225。

  • 想取得單一音符軌,可測試 PagCT;需要分開四部聲線,則應看 PawCT 的輸出。
  • 模型、訓練、評估、視覺化及釋出檢查程式碼均已納入儲存庫,另有線上示範與程式碼導覽可供參考。
  • YouChorale 的音訊、標註、MIDI 檔案及生成預測並未一併公開,因此仍有待完整重現。

對音樂研究者、合唱團排練者及開發音樂教育工具的團隊而言,PawCT 提供了直接檢視分部轉錄的研究起點;若只需合併音符,PagCT 的定位較簡單。現有公開內容較適合檢查方法與程式流程,重現比較實驗前則要先核對資料、評估協定和歷史設定是否齊備。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Audio, 工具, 庫, 語音, 音樂, Dataset 數據集

DeepMind Sierra AI 原生即時語音

Google DeepMind 與 Sierra AI 討論原生音訊模型,聚焦即時語音互動的速度、自然度與工程限制。

Og image

語音助手要做到自然對話,關鍵不只是把文字轉成聲音,而是要在用戶說話期間理解內容、掌握語氣,並快速作出回應。Google DeepMind 的 Valeria Wu 與 Sierra AI 的 Soham Ray 透過對談,介紹原生音訊模型如何處理這類即時語音 AI 的核心問題。

討論內容集中於 native audio models,以及建立更流暢即時語音系統時遇到的挑戰。相較於把語音先轉成文字、再交由文字模型處理的流程,原生音訊模型直接處理音訊訊號,有機會保留更多語調、停頓和對話節奏;但系統仍要兼顧理解準確度、回應延遲和運算成本。

內容涵蓋的重點包括:
– 原生音訊模型如何支援更自然的語音互動
– 即時對話中延遲與回應流暢度的取捨
– 建立高質素 voice AI 所面對的工程挑戰
– Google DeepMind 與 Sierra AI 對下一代語音體驗的觀察

這段內容適合關注語音介面、客服自動化、AI agent 和多模態模型的讀者。影片沒有提供完整技術規格或獨立效能測試,因此較適合作為理解發展方向與產品設計難題的入門材料,而不是部署指南。

影片介紹

Categories: Agentic, AI productions, 模型, 多模態模型, Google, Gemini, Video, Audio, 語音, 安全

ManimGX 高速 3D 動畫渲染

面向 AI agents 的 Manim 相容動畫引擎,以 Rust 和 wgpu 大幅縮短 2D、3D 教學動畫的製作等待時間。

ManimGX

製作數學教學片時,渲染速度往往比寫動畫程式更容易拖慢流程。ManimGX 屬於開源 3D 動畫引擎,兼容 Manim CE API,讓 Python 使用者可用熟悉的文字、方程式、曲面和鏡頭,處理 2D 與 3D 動畫生成。

它以 Rust 和 wgpu 重寫渲染核心,並加入完整靜態類型、關鍵字參數及 .animate 鏈式寫法;LaTeX 或 Typst 不需另行安裝。項目亦支援瀏覽器執行,透過 Pyodide 讓示範、教學或 AI agents 生成的動畫毋須先配置完整本地環境。

• M4 Pro、1080p60、五個場景合計 36.2 秒影片,渲染需時 3.08 秒
• 同一測試中,比 Manim CE 快 90.6 倍、ManimGL 快 11.5 倍、Blender Workbench 快 18.7 倍
• manimgx inspect 可檢查 storyboard、2D 版面,以及指定時間或播放結束時的畫面
• 支援語音同步,方便按旁白內容安排動畫節奏

安裝可選 prompt、PyPI 或 npm,適合數學教育、技術內容製作,以及需要反覆生成和檢查畫面的 agent 工作流。速度數字來自 Apple M4 Pro 的固定場景測試,不能直接代表所有硬件、動畫複雜度或互動需求;對已深度依賴 Manim CE 生態的團隊,API 相容性可降低遷移成本,但仍應先驗證現有場景和第三方功能。

GitHub

Categories: 開源, Agentic, AI productions, API, Video, 教學, 3D, Python, 語音, 動畫, 蘋果

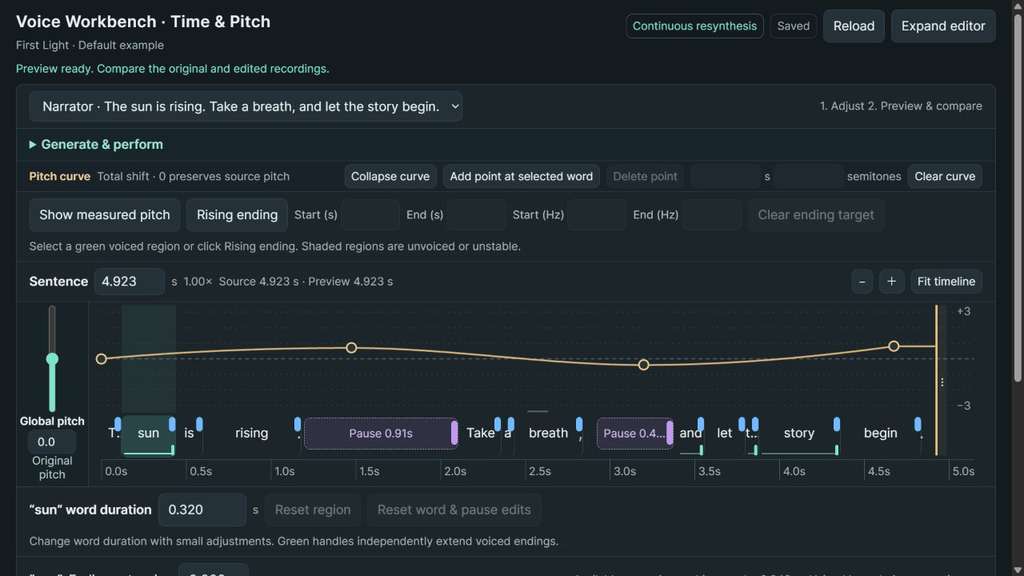
ComfyUI-VoiceWorkbench:本地語音工作台:逐句修正音高與節奏

不用剪碎音檔,便可逐句調整音高、字詞時長、停頓和尾音,並比較不同錄音版本。

Voice Workbench

想修正一句旁白的語速、音高或句尾拖音時,ComfyUI-VoiceWorkbench 讓你在完整錄音上直接編輯,毋須把每個字剪開再重新拼接。這個項目屬於本地語音編輯工具,實際處理的是生成語音和錄音後期微調之間的卡位;編輯器可作為 ComfyUI 底部面板使用,也能獨立在本機運行。

聲音處理採用一次 Praat resynthesis pass,同時套用整段錄音的時長和音高變化,未修改的預覽則保留原始 WAV bytes。介面可調整 0.75 至 1.25 倍全局速度、全局音高及最多 64 個局部曲線點,亦能處理現有停頓和可靠的 voiced ending;編輯完成後可比較 Original、Edited 與不同生成 take,再回到較早版本。

  • 不用下載模型:內置例子可直接開啟和編輯,Windows 亦可調用已安裝的英文系統語音。
  • 適合本地工作流:支援 Python 3.10 或更新版本,並可接入 ComfyUI custom nodes。
  • 保留人工判斷:字詞邊界只是估算,無聲或不穩定區域不能可靠提供音高目標。
  • 有明確範圍限制:單聲道錄音約 0.15 至 60 秒,AI take 最多 200 字元;服務只綁定 loopback,並非公開共享伺服器。

可選的本地適配器把能力延伸至語音生成和表演編輯:IndexTTS2 支援參考聲線及情緒生成,AuK Base 用於整段錄音的表演編輯,Qwen3 forced aligner 則協助估算字詞邊界。這些元件不是開啟基本編輯器的必要條件,系統語音也不提供聲線複製或情感控制。

適合旁白製作、語音原型和 ComfyUI 使用者處理少量錄音,而不是多人共用的雲端配音平台。尾音延長最多 200 毫秒,目標音高及 voiced 區域亦有上下限;自動對齊不代表每個字都讀得正確,接受修改前仍要逐段聆聽。

GitHub

Categories: 開源, ComfyUI, 模型, Qwen, Audio, 工具, Python, 語音

Meta 開源 Muse Gadgets SDK:把 ESP32 與樹莓派變成 AI 配件

Meta 把 Muse 的硬體擴充 SDK 放到 GitHub,讓你手邊的 ESP32 與 Linux 開發板直接接駁 AI 助理。從屏幕、音訊到感測器,開源玩法交給社群自己拼。

Muse gadgets: a Waveshare round AMOLED, an M5Stack StickS3, Muse Home Link, a Raspberry Pi and a Seeed reTerminal e-ink

想讓家裏的 ESP32 或樹莓派直接跟 AI 助理對話嗎?Meta 旗下 facebookincubator 開源的 Muse Gadgets SDK,正是針對這種「自製 AI 配件」場景而設的開發工具包。項目分為 ESP32 與 Linux 兩條主線,分別對應 MicroPython 級別的微控制器,以及樹莓派或一般 Linux 單板電腦,開發者可以按自己手邊的硬件選擇對應 SDK。

每塊板配對 Muse 應用前需要先在 gadgets.muse.ai 申請 SDK token,並開啟 App 內的 Developer mode,掃描「MuseGadget」前綴的裝置即可連線。ESP32 路線主打屏幕顯示、I/O 音訊與各類感測器,Linux 路線則偏向讓 Muse 處理 Home Assistant 自動化或系統管理指令,等於把語音助理變成 Home Lab 的遙控器。

項目定位屬於「工具+框架」混合體,核心價值是降低自製硬件的門檻,但要求開發者有一定焊接與刷機經驗,因為 README 已經明言副作用包括「bricked boards」、保養失效甚至電壓跌落。相對於坊間封閉式智能家居配件,它勝在完全開源並允許自定義指令,但又需要自備 token 與相容硬件,部署成本不低。

硬件玩家、Home Assistant 玩家,以及想用 AI 助理串連感測器或自製機械按鈕的開發者,最容易從中受惠。每個子目錄都附上 README.md 與供 AI 編程助手如 Muse Code 使用的 AGENTS.md,社群則集中在 Discord 交流改機心得。

項目重點摘要

  • 支援 ESP32 與 Linux(樹莓派)兩條開發路線,各自獨立 SDK
  • 配對 Muse App 需先申請 SDK token 並開啟 Developer mode
  • 涵蓋顯示、音訊、感測器、Home Assistant 自動化等多種擴充方向
  • 程式以 Apache 2.0 開源,第三方組件如 minimp3 保留上游 CC0-1.0 許可
  • 社群交流集中在 Discord,文件內附 AGENTS.md 方便 AI 編程助手介入

項目主頁 · GitHub

Categories: 開源, Agentic, API, Audio, 框架, Discord, Linux, 編程, 語音, Meta

Prism 令 2K 影音生成訓練加速 2.5 倍

Prism 將影片畫面與聲音互動納入稀疏注意力,令原生 2K 影音生成模型訓練更快,並兼顧生成質素。

model architecture

高解像度影音生成最難處理的地方,是畫面 token 大增後,Full Attention 需要付出平方級計算成本,聲音與畫面之間的有效互動亦容易被大量冗餘資訊沖淡。Prism 屬於 Dynamic Sparse Attention 框架,專門處理原生 2K Joint Video-Audio Generation Model Training,目標是減少訓練成本而不犧牲影音同步與細節。

Prism 將影片 token 按時空位置整理成 macro-zones,再利用影片特徵的 channel variance,以及 audio-to-video cross-attention 的 feature norm,判斷每個區域的畫面變化和聲音影響程度。變化較快或影音耦合較強的位置會採用更細的 block 分割,並透過 hybrid block selection 為不同 query 動態決定稀疏範圍,令每個 block 保留較一致的語義內容。

[Fudan&Tencent Hunyuan] Prism: Dynamic Sparse Attention for Native 2K Joint Video-Audio Training

同 Full Attention 相比,Prism 不再對所有 token 進行密集互相關注;同時,它亦不是單純套用只為推理加速而設的稀疏注意力。這個取捨針對聯合影音資料的結構作出調整,代價是訓練流程需要額外計算區域資訊和動態選擇,實作複雜度會高於標準注意力。

項目提供 Project Page、Hugging Face 模型和示範影片,可先透過合成結果、模型比較、消融研究及解析度擴展示範理解效果。提供的資料未列出完整本地安裝指令或硬件要求,因此暫時較適合研究團隊按論文與模型資源自行整理環境,而不是即時套用到一般影音工具。

  • 訓練速度較 Full Attention 提升 2.5 倍
  • 生成質素據報超越 Full Attention
  • 同時考慮視覺變化與 audio-visual coupling
  • 面向原生 2K 影音生成模型訓練

Prism 對需要訓練高解像度文字轉影片及同步聲音模型的研究團隊較有價值,尤其適合計算資源昂貴、影音互動集中於局部區域的工作。

項目主頁 · GitHub · 模型

Categories: 開源, 騰訊, AI productions, 模型, 多模態模型, 模型訓練, Google, NVIDIA, Video, Audio, 框架, 工具, 語音

VoxMem 測試音訊模型的記憶盲點

VoxMem 不只測模型記得講過甚麼,還檢查能否辨認說話者、語氣與背景聲音,直面多輪語音記憶的缺口。

VoxMem logo

當語音助手要回想幾次對話之前的內容,答案未必藏在文字轉錄稿內:誰說過一句話、當時的語氣,以及背景傳來甚麼聲音,同樣可能決定答案。VoxMem 屬於語音記憶評測基準,透過多次會話測試 Large Audio Language Models(LALMs)能否保留及運用這些非文字資訊。

項目把測試拆成兩條軸線:需要找回的聲音證據包括 speech semantics、speaker identity、paralinguistic cues 和 environmental sound;記憶操作則涵蓋 information extraction(IE)、multi-session reasoning(MSR)、temporal evolution tracking(TET)及 answer refusal(AR)。這個安排比只問模型能否找回一句原話更接近長期語音助手的工作情境。

VoxMem 提供 3,196 個評測實例,涵蓋 34,743 段、共 177小時的語音會話,並固定問題及證據,只改變8K、16K、32K 和 64K tokens的上下文長度。測試者可從 GitHub 項目取得程式碼,再配合 Hugging Face上的資料集重現評測;Python 3.9 或以上是已列出的基本環境,但不同 LALM仍可能需要各自的模型存取設定。

結果指出,15個 LALMs 在 32K 上下文下沒有模型達到 40% 整體準確率;模型記住文字內容的能力明顯高於辨認說話者、語氣及環境聲音,而且歷史越長,差距越大。這令VoxMem 更適合用來找出語音記憶系統的失效位置,而非單純作為模型排名工具。

• 同時測試聲音證據與記憶操作,涵蓋15個有效組合
• 以多會話歷史取代單一錄音,檢查跨場景整合能力
• 包含證據不足時拒絕回答,能檢視模型是否過度猜測
• 非文字聲音資訊在長上下文下明顯較難保留

研究語音代理、會話記憶、音訊模型或長上下文系統的團隊,能用這套基準分辨問題究竟出在聲音理解、跨會話推理、狀態追蹤,還是拒答判斷。資料採用 CC BY-NC 4.0,程式碼則使用MIT授權,商業產品整合前仍要獨立檢查資料使用條件。

項目主頁 · GitHub · 數據集

Categories: 開源, 模型, Audio, 工具, Python, 語音, Dataset 數據集

OpenAI dots:讓 AI 代理持續推進複雜工作

OpenAI 將 dots 設計成可持續工作的 AI 代理,協助處理跨應用程式的任務,同時保留人員審批權。

Og image

OpenAI 把 dots 交由 GPT‑6 Astra 驅動,定位成能長時間代辦工作的 AI 代理,處理項目跟進、應用程式操作和日常行政等容易中斷的工作。它擁有獨立雲端電腦,可按目標持續工作,亦會透過使用者回饋逐步掌握偏好與工作標準。

Dots 可經由插件連接超過 4,000 個應用程式,並在 ChatGPT、Slack 或 Teams 內使用。使用者可以直接提問、提供意見,或透過語音通話討論工作;在需要發送郵件、建立文件或執行其他操作時,系統會配合權限設定及審批流程,讓人員保留控制權。

OpenAI 分享的場景包括調查 Slack 中的程式錯誤、把新設計轉成可運作的應用程式,以及協助團隊追蹤規劃週期。早期測試者的 dot 亦曾發現漏開發票,準備文件後待使用者批准才寄出,反映它處理的是持續跟進而非單次問答。

目前 dots 正逐步向 Pro、Business Premium 和 Enterprise 計劃推出,完整的安裝步驟、收費細節及市場名單未有在提供的資料中交代。可先留意以下能力與限制:

  • 以 GPT‑6 Astra 為核心,配備獨立雲端電腦
  • 透過插件連接超過 4,000 個應用程式
  • 支援 ChatGPT、Slack、Teams 及語音互動
  • 可根據回饋學習偏好,持續推進工作
  • 權限、操作檢視和審批機制仍由人員掌控

項目主頁

Categories: Agentic, OpenAI, 語音

NVIDIA LongLive 把長片生成推向即時互動

NVIDIA 將三階段長片生成研究整合到同一個項目,涵蓋即時互動、量化推理及可重用蒸餾能力。

LongLive logo

NVIDIA 開發團隊把長片生成帶入即時互動、低精度推理和跨模型重用場景。LongLive 屬於開源影片生成研究項目,處理長時間生成容易變慢、下游模型需要重複蒸餾,以及互動控制成本偏高等問題。

項目分成三代,並各自放在獨立目錄,附有程式碼、文件和模型權重。LongLive 1.0 聚焦即時互動長片生成;LongLive 2.0 以 NVFP4 量化和 sequence parallelism 加速訓練及服務;LongLive-Plug 則把 few-step、CFG 和 long-context 能力蒸餾成可重用 LoRA,讓同一模型家族的下游模型減少重新訓練。

LongLive 2.0 支援 T2V/I2V AR training、multi-shot 或 single-shot videos,以及 NVFP4 inference、NVFP4 KV Cache 和 TorchAO FP8 PTQ inference,取捨是需要配合量化及平行化基礎設施。

  • LongLive-Plug:一次蒸餾能力,再在同一 backbone family 的下游模型重用
  • LongLive 2.0:以 NVFP4、BF16 和 sequence parallelism 支援長片訓練及推理
  • LongLive 1.0:讓使用者輸入提示詞後即時觀看並逐步控制長片生成
  • DreamForge-World 0.1:加入 residual action pathway,面向低算力、即時可控 world modeling

研究展示包括互動示範、長片 rollout 和不同 backbone family 的配對例子,但提供資料未載有可直接比較的統一 benchmark 分數。具備 NVIDIA GPU、需要研究影片生成系統,或希望在 Wan2.1、Wan2.2、MiniMax-H3 等模型家族上重用蒸餾能力的團隊,較容易找到合適切入點;一般使用者則要先接受它偏研究項目,操作細節仍取決於所選目錄。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 模型訓練, NVIDIA, Video, 提示詞, 語音, Dataset 數據集, MiniMax, LoRA

Page 2 of 11
1 2 3 4 … 11