Code World Model:以 coding agent 當大腦,video model 演畫面,世界不再失憶

Code World Model 讓 coding agent 負責推演世界狀態,再由 video model 將結果呈現成影像,支援更持續的互動場景。

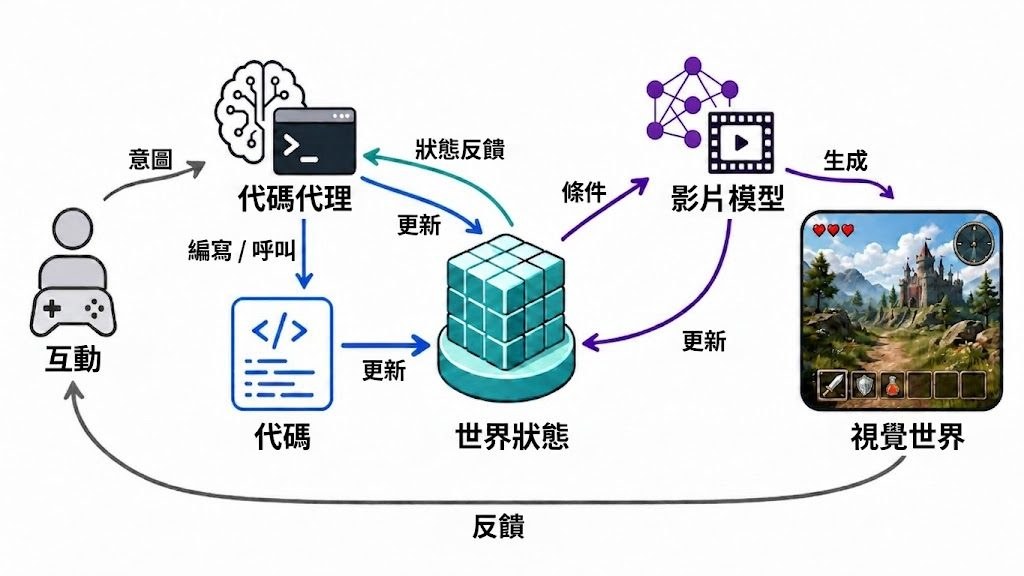
Pipeline of the proposed Code World Model

當影片模型只能呈現事件結果,卻難以記住規則、因果和長期後果,互動世界就容易變得不連貫。Code World Model 以 coding agent 作為「世界大腦」,透過可執行程式碼更新及控制世界狀態,再交由 video model 將狀態轉化為視覺觀察。

這種分工把世界演化和畫面生成拆開處理。coding agent 會根據事件推理後果、規劃變化並編寫程式;video model 則負責利用生成先驗呈現場景,讓同一個世界狀態可以延伸出不同視覺體驗。

項目展示了長時間生成及定期轉換風格的場景,包括海底港口、魔法學院、糖果運河和雲上海港等內容;展示中亦使用 RGB Proxy,並以約每60秒一次的節奏改變風格。這類架構適合研究開放式世界模擬、互動敘事,以及需要持續狀態和因果後果的視覺體驗。

• coding agent 負責規則、事件與世界狀態
• video model 負責將狀態實現為影像觀察
• 可支援較長時間的世界演化與持續後果
• 透過分離邏輯和畫面,減少只從影像學習動態的限制

目前資料集中於框架概念、展示場景及研究論述,因此不能視為已確認可自由下載的模型。使用者亦需要留意,視覺效果和世界狀態的一致程度仍會取決於 coding agent 的推理、規劃及編程能力,以及 video model 的生成能力。
項目主頁 · Paper

Categories: 開源, Agentic, 視頻模型, 世界模型, 模型訓練, Video, 框架, Vibe Coding, 編程, AGI, 動畫, MiniMax

阿里巴巴 PAI 以 PDD 加速 MiniMax-H3 影片生成

阿里巴巴 PAI 團隊把 MiniMax-H3 變成少步數就能出片的版本。你可以把它理解成針對影片生成速度做加速的 LoRA。

Og image

阿里巴巴 PAI 團隊針對 MiniMax-H3 做了 Parallel Decoding Distillation(PDD),目標是用更少推理步數完成影片生成。這份項目同時保留 MiniMax-H3 的兩條路線,分別對應 FL2VA 和 Ref2VA,方便按不同基礎版本套用加速 LoRA。

兩個官方 8-step Acc LoRA,檔名分別是 MiniMax-H3-FL2VA-Acc-8Step.safetensorsMiniMax-H3-Ref2VA-Acc-8Step.safetensors,兩者都標示 rank=64network_alpha=64,並以 BF16 形式提供。這表示它們不是完整底模,而是掛在對應 base model 上的加速適配器。

8-step Acc LoRA 可配合 768p 生成流程,並對比 baseline、Turbo 4-step 版本和 8-step Acc LoRA。

實務上,8-step Acc LoRA 代表在速度和畫面穩定度之間做取捨,重點是把影片生成的推理成本壓低,而不是追求最長流程。相較原始 MiniMax-H3,這類 LoRA 的用途更偏向快速出樣和迭代,適合需要較短等待時間的影片生成工作流。

  • 開發團隊是 Alibaba-PAI,並以 MiniMax-H3 做 PDD 加速
  • 提供兩個 8-step 官方 Acc LoRA,分別對應 FL2VA 和 Ref2VA
  • 檔案以 BF16、rank=64network_alpha=64 方式發布
  • 頁面有 768p Demo,但未交代 GGUF、mmproj 或硬體需求

項目主頁 · 模型

Categories: 開源, 阿里巴巴, AI productions, 多模態模型, 視頻模型, Video, MiniMax

MiniMax-H3 一次生成 120 秒長影片

它把單次輸出的 MiniMax-H3 變成可接續的長片段影片流程,連音效也一併處理。角色、服裝和道具都會沿鏡頭延續,減少畫面在鏡頭交界處走樣。

Og image

H3-LongVideos 針對的是 MiniMax-H3 在長片段生成時最容易出現的問題:每個 shot 各自生成,角色外觀、服裝和道具很容易在鏡頭交界處漂移。這個 ComfyUI 節點把一段文字拆成多個 beats,再把每個 beat 變成一個 shot,並以前一鏡最後一幀接到下一鏡,令整條影片可以維持連貫。

這個項目是基於 ComfyUI 的 H3 支援來做,不是獨立模型訓練;因此只能確認它面向 MiniMax-H3 工作流。它同時處理 FL2VA 與 REF2VA 兩種條件方式,前者用一幀作為鏡頭錨點,後者用參考圖描述角色外觀,方便同一角色在多個 shot 裡保持一致。

輸出最長可到約 120 秒,並提供 soundscapelatentinfo 等輸出。soundscape 會帶出場景實際使用的環境聲床,latent 則是按時間軸串接的 sampled latents,但在多 shot 情況下,它不是 images 的等價 latent 版本,因為 trim_seamhandoff_offset 截的是已解碼影格,H3 又會壓縮時間,所以 seam 附近的畫面仍會存在;只有單 shot 時才會完全對齊。

有用的是工作流層面的控制:prompt 第一段做 anchor,後續段落一段對應一個 shot;character_memory 管角色和服裝;resolutionmegapixels 分開控制形狀和尺寸;shot_seconds 是上限而不是固定長度,先用 plan_only 預覽拆鏡、時長和警告,會比直接渲染更穩陣。

  • 以 ComfyUI 把單次 shot 的 H3 生成改成多鏡頭串接,重點在長片段連貫性。
  • 同時處理角色、衣著、道具和旁白/環境聲,減少鏡頭切換時的漂移。
  • plan_only 可以先檢查拆鏡結果和警告,不用先燒算力。
  • 頁面沒有提供 GGUF、量化版本、base model 或推論框架清單。
  • latent 輸出只在單 shot 時可視作等價結果,多 shot 時要留意 seam 與時間壓縮。

項目主頁

Categories: 開源, ComfyUI, 視頻模型, Video, MiniMax

VA-Judger 生成更貼近人類偏好的影片與聲音

VA-Judger 以人類偏好比較影片和聲音生成結果,改善單靠獨立指標造成的失真與獎勵錯配。

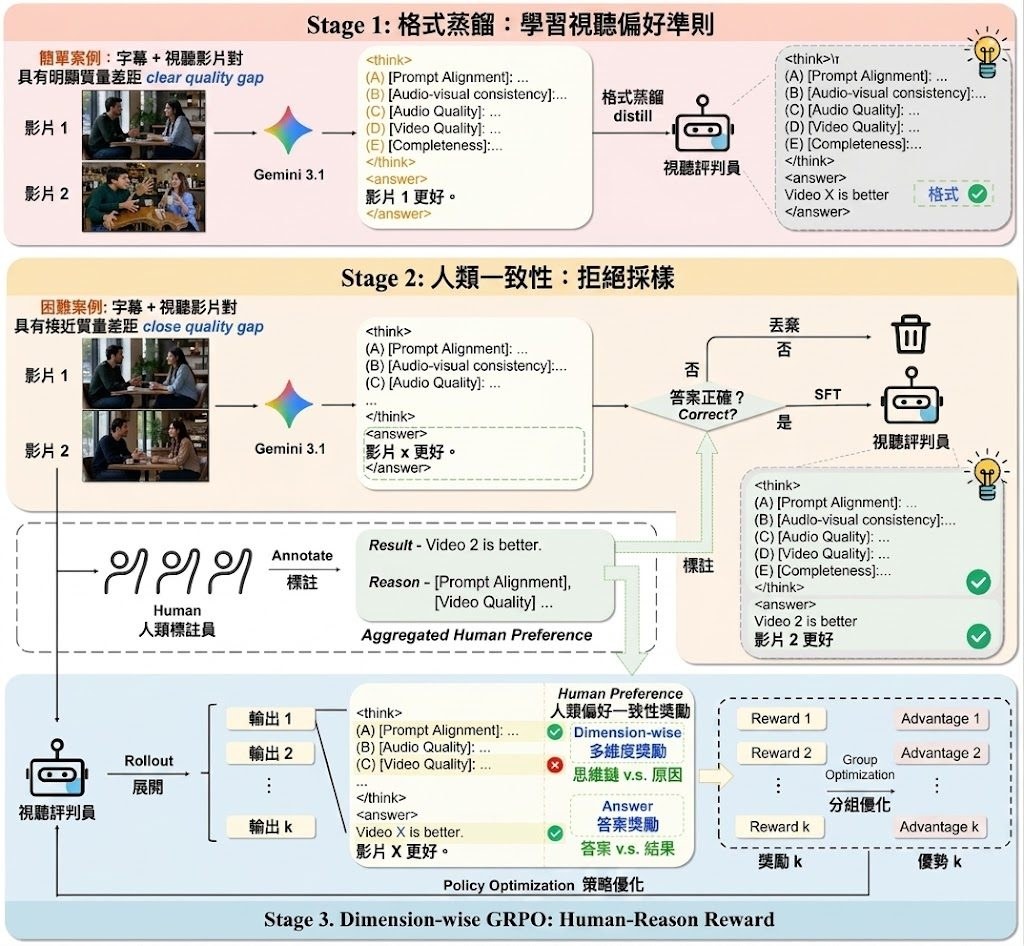
VA-Judger training pipeline

同一個提示詞產生兩段影音內容時,VA-Judger會比較哪一段更符合人類偏好,並拆解提示詞對齊、影音一致性、音質、畫質及內容完整度。它屬於聯合影片與音訊生成的 Reward Model,處理傳統指標難以捕捉整體連貫性的問題。

模型以 Qwen3-Omni 為基礎,先從品質差距明顯的配對學習比較準則,再透過拒絕採樣處理接近的結果,最後以 dimension-wise Group Relative Policy Optimization(GRPO)把人類回饋分配到不同品質維度。這比把音質、畫質及同步指標簡單相加更貼近觀看者的整體判斷,也減少生成模型鑽指標漏洞的機會。

VA-Judger-Bench包含同領域及跨領域模型比較,用來測試 Reward Model 是否能對齊人類選擇;研究結果指向它優於多項指標基線。VAPref-10K則包含9K提示詞及10.3K組細緻的影音配對比較,但資料集及部分訓練程式仍未發布。

項目提供 Reward Model 推理、Video Model 推理、模型 SFT,以及以 VA-Judger 分數優化 LTX-2 的流程;README亦列出合併已發布 RL LoRA 的 LTX-2 checkpoint。提供的資料沒有列出完整安裝步驟,使用者需要按項目頁面、checkpoint及程式碼狀態自行確認環境。

  • 適合場景:研究影音生成、偏好對齊及 RL post-training 的團隊
  • 可評估內容:提示詞對齊、影音一致性、音質、畫質及內容完整度
  • 主要取捨:比較人類偏好的方法較全面,但需要配對資料及額外訓練流程
  • 目前限制:dimension-wise GRPO 程式碼及 VAPref-10K 仍列為待發布項目

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 視頻模型, 模型訓練, Qwen, Video, LTX, Dataset 數據集

JoyAI-Echo: 拓展長音訊視訊生成技術

它把文字轉影片做成可跨鏡頭延續的音畫生成流程,重點不只是一段片,而是人物、聲音同場景連貫下去。ComfyUI 節點版本可配合官方推理管線,方便逐鏡調整。

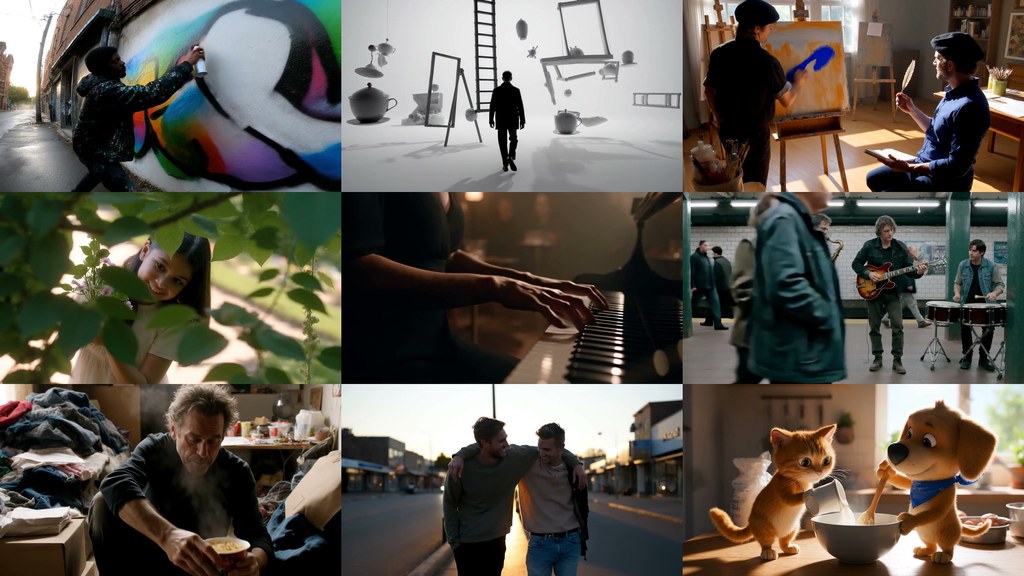
JoyAI-Echo generated video gallery

JoyAI-Echo 是一個面向 text-to-video(T2V)同多鏡頭長片段生成的模型項目,處理的是短提示詞難以撐住長篇敘事、角色外觀與聲音容易斷裂的問題。它的做法不是單段出片,而係用跨鏡頭 memory 去維持故事連貫,連動音畫一致性。

官方說明強調它走 full bf16 precision,唔採用 GGUF quantization,目標係貼近正式推理管線的輸出。現階段支援 T2V,同多鏡頭長視頻;image-to-video(I2V)未支援。另有 ComfyUI_JoyAI_Echo 節點包,適合想喺工作流入面逐鏡改 prompt、即時預覽、再串接後續鏡頭嘅人。

  • 可做長篇音畫故事,展示例子去到 10 分鐘
  • 支援少步數生成,長片與 causal world model 都偏向快速推理
  • cross-shot memory 會保留角色外觀、聲線同連貫性
  • ComfyUI 版本方便分鏡調整,同官方管線保持一致
  • 目前重點在 T2V,多鏡頭長片段,未覆蓋 I2V

它和一般單段影片模型最大分別,在於將「一段生成得像」推進到「多段接得住」。如果要放進實驗室、內容團隊,或者做互動世界、長敘事原型,這種可續接的記憶機制會比只看單次輸出更實用;但代價是對 GPU 記憶體要求高,官方節點提到 48GB VRAM 同 GPU memory hot-swap 才較穩陣。

項目主頁 · GitHub

Categories: 開源, ComfyUI, 多模態模型, 視頻模型, 世界模型, Video, Image, Audio

4DAnyone 把單鏡頭影片重建 4D 多視角

由一段普通單鏡頭人物影片開始,4DAnyone 生成具一致性的多視角影片,再交由 4DGS 重建可動人物。

4DAnyone

由未校準的 monocular video 出發,4DAnyone 可以為同一個人物生成多個目標視角,接着交給 4D Gaussian Splatting(4DGS)建立可渲染的 4D 人物。這個 GitHub 項目屬於 4D 人物重建工具,處理的是拍攝時沒有多部相機、相機內參或姿態資料,卻想取得多視角動態素材的問題。

它不只把畫面轉成另一個角度,而是嘗試維持不同視角之間的時間和外觀一致性,讓後續 4DGS 重建不必直接面對單鏡頭資料的視角缺口。相較於需要 rig、校準相機或固定三腳架的流程,這個方法換來的是對輸入影片質素和人物動作的依賴。

使用 inference.py 讀取影片,再以 views_per_layerlayer_pitchesstart_yawyaw_span 控制相機層數、上下角度及水平覆蓋範圍。儲存庫提供 Python 3.11、requirements 和第三方 GVHMR 元件的安裝安排,缺少的模型及例子會在首次使用時自動取得;原始資料沒有交代硬件需求、推理時間或量化性能,因此不能把速度表現視為已被驗證。

  • 支援全身或上半身、畫面只包含一人的影片
  • 可生成 6、24、48 個或自訂數量的目標視角
  • 兼容輕微鏡頭移動,以及未知相機內參和姿態的素材
  • 可選 FlashAttention-3 或 SageAttention 加快推理

研究展示內容集中於不同人物影片、動作和場景的泛化能力。需要製作 4D 人物、研究自由視角影片,或建立動態人像資料的團隊;只想快速套用濾鏡或要求即時輸出的使用者,仍要先確認硬件、模型取得方式和影片條件是否符合要求。

項目主頁 · GitHub · 模型

Categories: 開源, 香港中文大學, 香港科技大學, AI productions, 數字人, 視頻模型, Video, Python, 語音

Evoke 把世界模型推向可互動長片段

Evoke 讓生成世界記住鏡頭走過的地方,並可在畫面持續生成時改變指令,突破短片段與固定提示詞的限制。

logo light

鏡頭由使用者操控時,畫面不必每隔幾秒重新開始;Evoke 會保留場景幾何,按鏡頭位置取回需要的資訊,讓探索可以延續更長時間。它屬於開源的自回歸世界模型,實際處理的是互動影片生成中的空間記憶、持續生成與中途改變指令三個問題。

模型採用 14B 參數、三步採樣及 classifier-free guidance(CFG)免費的生成流程,在單張 H200 上以 2.11 秒生成 1.5 秒、384×640 影片。外部 camera-indexed world state bank 將世界狀態與 denoiser 分開保存,配合按需檢索令每一步的上下文維持有界;代價是推理需要依賴鏡頭姿態與狀態管理,並非單純輸入文字便可獨立生成長片。

Evoke 以 per-chunk conditioning 支援生成途中重新提示,例如在原有場景加入風暴、物件或事件,而不需要剪接或重啟。訓練端亦為長時段 self-forced supervision 重建 teacher,加入 chunk-wise grouping、distant-frame retrieval 和 linear-attention global state,讓記憶及計算量按長度線性增加;README 同時提醒,訓練與推理必須使用一致的 warp / attention 配方,否則可能出現不易察覺的失配。

WBench 上,Evoke 以三步世界模型取得目前最佳成績,並在 VBench-Long 及 VBench-2.0 維持競爭力,但項目資料未提供完整硬件需求、互動控制介面或不同 GPU 的速度比較。研究團隊、遊戲原型製作者及需要長時間可操控影片的開發者,可從 Hugging Face 權重、GitHub launcher 和 examples 開始測試;使用前應先確認 H200 級硬件、模型下載容量,以及本地環境是否符合程式依賴。

• 三步、CFG-free,單張 H200 每 2.11 秒生成 1.5 秒影片
• 以 camera-indexed world state bank 保存跨片段場景記憶
• 生成途中可重新提示,改變接下來的事件或環境
• WBench 領先,VBench-Long 與 VBench-2.0 保持競爭力
• 開源權重與程式可供研究及互動影片原型測試

項目主頁 · GitHub

Categories: 開源, AI productions, 視頻模型, 世界模型, Video

V-RAE 重整影片潛空間,生成更快更準

V-RAE把影片生成前最難處理的時間冗餘壓細,同時保住語意結構。對想做重建、生成同預測建模的團隊,呢個方向幾有參考價值。

V-RAE method

做影片生成時,潛空間一旦又大又雜,訓練速度、重建品質同後續生成都會一齊受拖累。V-RAE放喺呢個位置切入:它屬於影片表示自編碼器模型,將 frozen vision foundation model 的表徵再壓成更緊湊的 generative latents,處理的是影片表示太冗長、但又不能失去語意同動態連續性的問題。

V-RAE不是重新訓練整個視覺骨幹,而是接在 DINOv3、SigLIP2、V-JEPA2.1、EUPE 這類 frozen encoder 之上,用 lightweight temporal pooling module 減少時間維度上的重複資訊,再交由 video decoder 重建連續動作。這種做法的取捨在於,它更依賴現成視覺表徵的品質,但換來較輕量的影片 latent 壓縮流程,亦令 semantic latents 可以變成 directly decodable predictive state space。

V-RAE:重构视频潜在空间以实现高效生成 2026-08-16

項目提供了訓練、評估與重建示例所需的程式結構,安裝條件寫明要用 Linux、NVIDIA GPUs、CUDA 相容驅動、FFmpeg,以及 Python 3.10 或以上。可配合已釋出的 checkpoints 與對應 frozen encoder 做重建測試,但能否自由下載、下載範圍是否完整,仍要以當前發佈頁面為準,不適宜直接假設任何人都可無限制取得全部模型。

結果 V-RAE在 K600 reconstruction 取得 2.13 rFVD,數值優於文中比較的大型 pretrained video VAEs;class-conditional generation 則在 UCF101 與 K600 分別達到 117.86 與 19.16 gFVD,並提到可快最多 6 倍收斂。作者亦提出 tFVD,令它與人類判斷的一致性提升,在 UCF101 與 K600 的 Pearson correlation 分別達到 r = 0.621 與 r = 0.919,這點對影片生成評測有直接意義。

  • 接在 frozen vision foundation model 後面做壓縮,避免由零建立整套影片表徵
  • 用 temporal pooling 減少時間冗餘,同時保住 semantic structure
  • 同時覆蓋 reconstruction、class-conditional generation 與 predictive modeling 場景
  • 倉庫已包含 training、evaluation、sampling 所需結構,但部署前提偏向研究級 Linux + NVIDIA GPU 環境
  • 適合研究影片生成、世界狀態建模、長序列表示學習的團隊參考其 latent 設計

V-RAE較適合有影片模型實驗能力的研究團隊、做 VideoDiT 類生成流程的人,以及想把影片 latent 拿去做預測狀態空間建模的項目。對於怎樣把強大的視覺表徵轉成更可生成、可重建、可評測的影片 latent,已經給出一條相當具體的路線。

項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Linux, Python

Qwen-Video-Edit:開源影片編輯模型

它把文字指令式影片編輯做得更直接,透過現成的 image editing model 去改寫影片 latent。對需要長片段、分段修改同一條影片的工作流,會比重起一套 video transformer 更省力。

input contact sheet

Qwen-Video-Edit 是一個 instruction-based video editing 項目,核心做法是把 Qwen-Image-Edit 直接搬去處理影片 latent,再用兩個可訓練 projection 接上 Wan 2.1 的 video-VAE。這樣做的價值很清楚:不用再依賴 video-pretrained transformer,也能按文字指令改影片內容。

安裝和測試路線已經整理得相當明確。train.py 走單機多 GPU 訓練,infer.py 負責長影片逐段編輯與 Wan 2.2 denoising-enhancement,dataset.py 則讀取 Ditto 格式的 source、edited、instruction 配對。

和一般影片編輯方法相比,差異在於它不是從頭學影片理解,而是借用影像編輯模型的先驗,再用 warm-started projections 與 grid positional encoding 去補上時間維度。這代表訓練成本和架構複雜度較低,但限制也在於效果仍仰賴 Wan 2.1 latent 空間、Ditto-1M 資料,以及後段 enhancement。

  • 支援 LoRA 或 full fine-tuning,取捨在訓練成本與自由度之間
  • 長影片可以分段套用不同指令,適合剪接、局部修改、旁白對齊內容
  • 輸出 checkpoint 以 trainable-weights-only .safetensors 形式提供,載入流程較直接
  • 另有 zero-training demo,可先看 image-grid 與 latent-grid 編輯行為
  • 模型權重已公開,方便直接做復現或二次改造

項目主頁 · GitHub · 模型

Categories: 開源, 視頻模型, 模型訓練, Qwen, Video, Image, 影像模型, Dataset 數據集

MiniMax H3 整合成單一節點,ComfyUI 剪走繁瑣接線

把 MiniMax H3 的影片流程收成一個節點,省去搭工作流和找模組的時間。它更像一個整合入口,讓生成、延伸、關鍵幀同音訊驅動集中處理。

Buy Me a Coffee at ko-fi.com

在 ComfyUI 裡要跑 MiniMax H3 影片流程,最麻煩往往不是模型本身,而是工作流太碎。ComfyUI-ALLinONE-MinimaxH3 把這套流程收成單一節點,屬於 ComfyUI 的工具項目,目標是把文字生成影片、圖片轉影片、參考圖驅動、音訊帶動嘴型同影片延伸放進同一個入口。

安裝方式很直接:放入 ComfyUI/custom_nodes/ 後重啟 ComfyUI,再在畫布搜尋 ALL in ONE MiniMaxH3。項目主打幾個模式,包括 Image、T2V、I2V、R2V、Audio Drive、Keyframes、Extend 同 Chain,實際用法是先揀模式,再輸入 prompt 或參考素材,由節點接管後續流程。

官方 MiniMax H3 原生工作流、ComfyUI-H3-Motion-Context-MultiRef、MiniMax H3 Turbo pack,同埋 H3 Studio 的圖片模式都被包進同一個介面,對需要反覆試片段、接續鏡頭、處理多參考素材的影片製作流程特別實用。

  • 支援 T2V、I2V、R2V、Audio Drive、Keyframes、Extend、Chain
  • Chain 用 H3 Motion Context 做多段續接,走 latent path,避免重新編碼
  • 內建歷史、收藏同預覽,方便回看 prompt 同結果
  • 亦有 RTX / Seed2VR Video Super Resolution 的 upscale 接口
  • 作者標明仍屬 Beta,兼容性要跟指定版本和模型清單對齊

目前較適合已經在 ComfyUI 裡做影片生成、又不想每次重砌圖的人。官方工作流仍然是底層來源,呢個項目更像把常用路徑包成一個操作面,方便快速試片、改參考圖同續接片段。

GitHub

Categories: 開源, ComfyUI, 視頻模型, Video, Image, Audio, MiniMax

Page 2 of 16
1 2 3 4 16