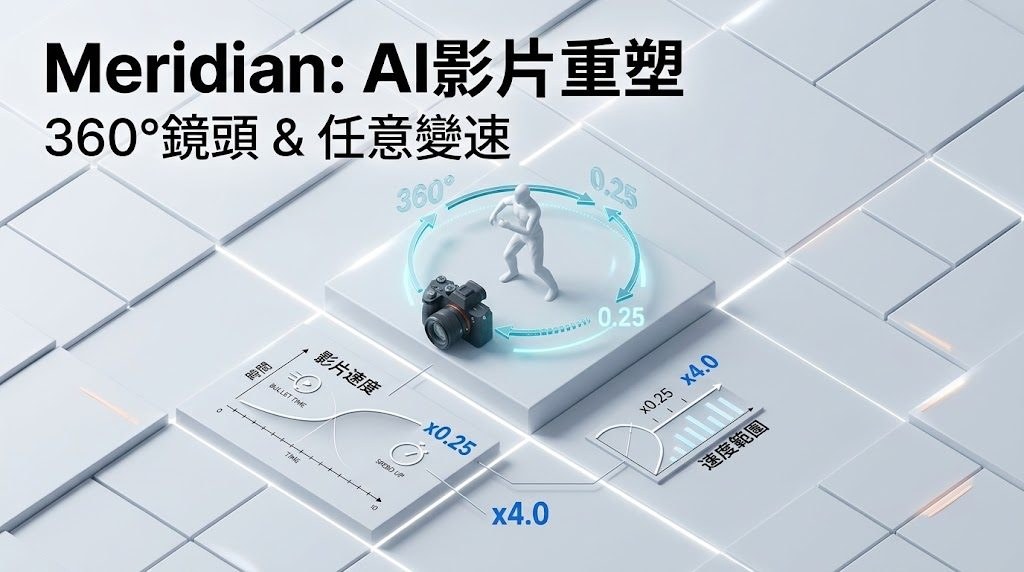
Meridian 讓 MiniMax H3 將時間與鏡頭重新編排 – Bullet time

Meridian 可從影片或單張圖片重新設計鏡頭路徑,重訪同一事件的不同視角。

Og image

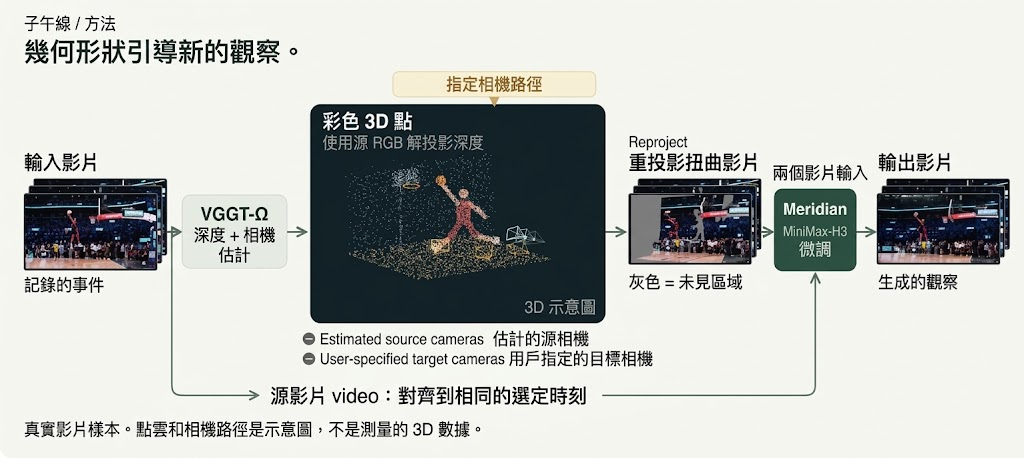
想將一段已拍攝的動作改成全新鏡頭,甚至暫停某個瞬間再繞行拍攝,Meridian提供了影片到影片(video-to-video)的處理方式。它基於 MiniMaxAI/MiniMax-H3,以 adapter 形式加入幾何控制能力,並結合 VGGT-Omega 幾何資訊,亦支援由單張圖片建立鏡頭移動。

Meridian 處理的是空間與時間的共同編排:鏡頭可沿指定路徑移動,原有動作則可繼續、放慢或暫停。Bullet time 只是其中一種時間與鏡頭組合,並非模型的邊界;要加快或放慢動作,應先重新調整輸入影片的時間,再按該時間軸設計 camera path。

頁面提供的例子包括以原片重新觀看 NBA 灌籃、在草莓片段中暫停動作並移動鏡頭,以及以芭蕾單張相片產生鏡頭運動。這種做法適合重構已有事件的觀察角度,但生成畫面與原片如何銜接、遮擋區域能否保持一致,仍取決於輸入內容與指定路徑。

  • 基礎模型:MiniMaxAI/MiniMax-H3;模型關係標示為 adapter
  • 幾何元件:VGGT-Omega
  • 任務標籤:video-to-video、novel-view-synthesis、camera-control、re-camera
  • 提供 installation.md 連結

項目主頁 · 模型

Categories: 開源, AI productions, 模型, 視頻模型, Google, NVIDIA, Video, Image, 框架, 教學, Discord, LLaMa, Ollama, Python, 蘋果, MiniMax

physics:拆解 Wan2.1 的物理失誤

籃球彈跳變成半空漂浮,問題可能早在去噪頭幾步由注意力決定。這個研究以 RoPE 調整改善影片動態。

teaser

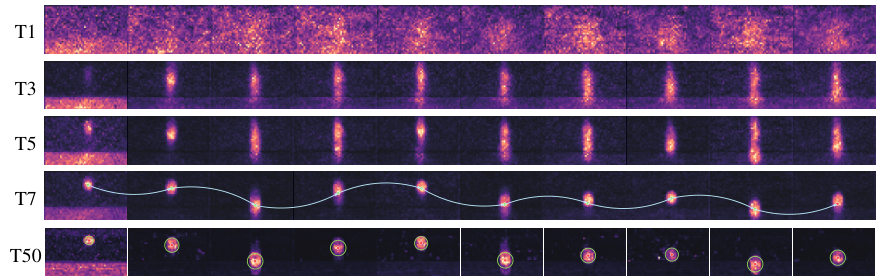
一個籃球由半空跌落後,理應撞地再彈起,Wan2.1-T2V 卻可能生成漂浮、突然停頓或半空反彈。這個 GitHub 項目屬於影片生成模型的可解釋性研究,實際處理的是 text-to-video diffusion models 如何在早期去噪階段規劃物件軌跡,以及錯誤位置為何會一路鎖定。

研究把視線集中在 Wan2.1-T2V-1.3B 的最初五個去噪步驟,透過 video-to-object-token cross-attention 追蹤物件位置,再配合 convergence speed 和 causal contribution 找出負責形成軌跡的 attention heads。分析指出,Self-attention 中的 Rotary Position Embedding (RoPE) 會令空間注意力衰減過快,早期錯誤候選位置因此壓過鄰近影格較合理的路徑。

修正方法不依賴外部物理模擬器或額外 foundation-model teacher,而是在早期步驟降低 height/width RoPE frequency,測試時前五步使用 λ^{h/w}=0.70;需要訓練時則以只作用於 self-attention 和 cross-attention 的 Low-Rank Adaptation (LoRA) 配合 λ^{h/w}=0.75。LoRA 設定為 r=64、alpha=32,並以首 10% 去噪步驟佔 0.9 機率的混合 timestep sampler 加強早期學習。

測試這個項目時可沿用 Wan 官方模型與提示詞,以不同 random seeds 比較原模型、training-free 頻率調整及 LoRA 版本的籃球跌落等片段;程式透過 runtime monkey patches 修改行為,不需要改動官方 Wan source。提供的資訊確認有 training-free 和 training-based 實驗,但未列出完整數值指標,因此更適合視為機制分析與可重現的研究原型,而非已證明能處理所有物理場景的通用修補方案。

  • 物件軌跡主要在最初五個去噪步驟形成
  • Cross-attention 負責引入物件語義,self-attention 協助選擇候選區域
  • RoPE 空間衰減過強,會令錯誤位置過早固定
  • 可用早期頻率縮放,或加入只改注意力層的 LoRA
  • 適合研究影片生成、模型可解釋性及物理一致性的團隊

項目主頁 · GitHub

Categories: 開源, AI productions, Embedding, 模型, 視頻模型, 模型訓練, Video, 提示詞

HyperFlow 自蒸餾影片生成省六成推論成本 – MiniMax-H3 八步出片

Video Rebirth 推出嘅 HyperFlow 係一個針對 MiniMax-H3 嘅 8 步 LoRA 適配器,透過 data-free flow self-distillation 將 50 步推論壓到 8 步,仲行得喺官方 diffusers Modular Pipeline 之上。

Repository image for Video-Rebirth/hyperflow

影片生成模型一直面對一個現實樽頸:想要更高品質,就要更多 sampling steps,亦意味住更長嘅等待同更高嘅運算成本。Video Rebirth 推出嘅 HyperFlow 就直接針對呢個取捨落手,喺 MiniMax-H3 官方權重之上加一個 8 步 LoRA(PEFT,rank/alpha 256,覆蓋 attention、feed-forward 同兩組 time embedder),將官方 50 點 sigma schedule 嘅 49 次前向推論壓到 8 次,而且唔需要額外訓練資料。

你可以把它理解成一個「加速層」:base weights、VAE、conditioner 同 t2va、fl2va、ref2va 三種 workflow(全部對應影片加音訊)都維持官方版本,呢個項目只負責載入 LoRA、兩個 time embedder 同固定嘅 8 步 sigma grid。官方修訂號、權重路徑、適用範圍等資料都收錄喺 hyperflow.json manifest 入面。LoRA 喺 Hugging Face 開源,授權沿用 MiniMax H3 Community License,呢個倉庫就提供 loader 同 example scripts,透過 hyperflow_blocks("fl2va") 等 API 直接接入 diffusers Modular Pipeline。

HyperFlow 嘅特點係 data-free:模型自己產生候選影片、篩走不合格嘅、然後用通過嘅樣本做 self-distillation,屬於佢哋 RSI(Recursive Self-Improvement)訓練範式嘅 self-distillation 部分。對比一般影片生成流程,呢種做法唔需要額外收集標註資料,亦唔需要人手標籤。實際運行時仲可以選擇加裝 NVIDIA Sol-Attn sparse attention(PyTorch ≥ 2.10、CUDA ≥ 12.8、Triton ≥ 3.6,支援 SM80–SM120),官方聲稱喺 H200 上比 dense attention 快約 13%,並可透過 Ulysses context parallel 擴展至最多 4 張 GPU。

對想用 MiniMax-H3 出片、又希望壓低推論時間嘅團隊或獨立開發者嚟講,HyperFlow 提供咗一個直接掛載嘅方案;對研究自蒸餾或自改進路線嘅從業者嚟講,佢亦係一個具體嘅開源參考。需要注意嘅係 num_inference_steps 唔應該手動指定,步數同 sigma grid 都由權重檔案內置決定。

項目主頁 · GitHub · 模型

Categories: 開源, AI productions, 模型, 視頻模型, NVIDIA, Video, Audio, Python, 庫, MiniMax

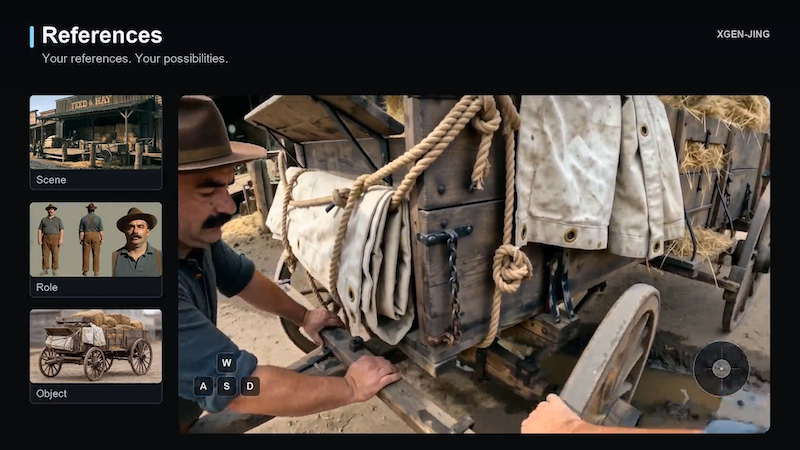
XGEN-JING 世界模型開源:邊走邊生成影片與音效

XGEN Labs 把互動式第一人稱世界模型 JING 開源:輸入動作與參考圖,就能邊走邊生成對應影片與環境音效,等於把世界模型變成可即時體驗的 demo。

過往的世界模型 demo 多半停留在「按一個鍵播一段片」,XGEN-JING 想把互動感再推一步:鍵盤操作鏡頭、輸入文字引導角色對話,模型即時生成第一人稱影片與配對音訊,並以參考圖約束人物、物件與場景的一致性。這個項目是一個以 MiniMax-H3 為骨幹的 egocentric interactive experience 模型,屬於世界模型 / 互動影片生成一類,目標是讓「在同一個起點做出不同選擇」這件事變得可視聽。

XGEN-JING 的核心差異在「四步雙向推論」與即時性:JING-Flash-v1 用四個步驟完成推論,再把動作、觀察歷史、參考圖同時餵進去生成下一段片段;鏡頭移動、物件互動、人物對話都由文字與按鍵驅動,而畫面與聲音同步輸出,所以更像「邊走邊生成」而不是「先想好再剪片」。

Step Into a World That Responds | XGEN Labs

這版本同時提供 Inference code、examples 與 Prompt skills,後者可以從故事與參考圖自動生成經過驗證的推論案例,降低試錯成本;但因果模型與技術報告尚未釋出,想深入架構細節的人需要再等等。硬件門檻亦偏高:項目方以六張 H100 做驗證,其中一張跑 text encoder、一張跑影音 VAEs、四張跑 DiT 加 sequence parallelism,並指定 FlashAttention-4 為預設後端。

以下幾類人會比較快從中受惠:做世界模型研究、需要互動 demo 的研究者;做遊戲 / VR / 沉浸式敘事、需要快速產出第一人稱體驗的開發者;以及關心 video generation xa in 2026 路徑、想理解「影片 + 音訊 + 動作」三軸如何耦合的團隊。對一般玩家或創作者而言,Hugging Face 上的模型頁與 xgenlabs.ai gallery 已足夠先看 demo,再決定是否投入本地部署。

重點摘要

  • JING 是以 MiniMax-H3 為基礎的第一人稱互動體驗模型,支援鍵盤控鏡、文字對話與參考圖約束。
  • JING-Flash-v1 以四步雙向推論同時生成影片與音效,比單向生成更貼近即時體驗。
  • 官方硬件門檻為六張 H100(1 text encoder + 1 VAEs + 4 DiT),預設 FlashAttention-4,後端依賴 SGLang 特定 commit。
  • Prompt skills 可從故事與參考圖自動產生驗證過的推論案例,方便快速試玩法。

項目主頁 · GitHub · 模型 · 影片集

Categories: 開源, AI productions, 模型, 視頻模型, 世界模型, Google, NVIDIA, Video, Audio, Content Creator, MiniMax, Skill 技能

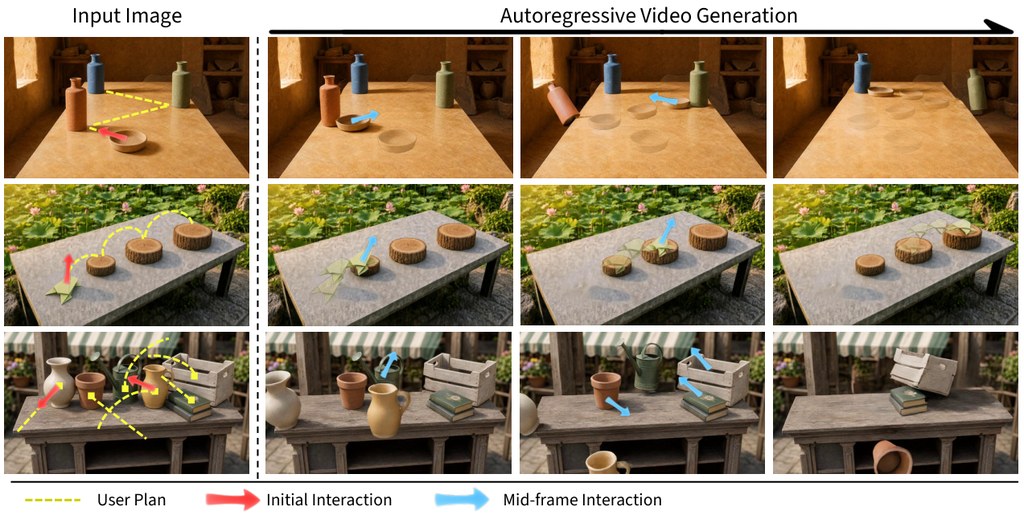
PhysStream:邊播邊拉物件,讓 AI 影片生成更貼近物理直覺

PhysStream 是一個物理導向的影片生成模型,用戶可以在生成過程中隨時拖動物件來改變它的運動方向,做到真正的中途互動控制。

Og image

以往想用 AI 生成一段符合物理規律的影片,往往需要在生成前就設定好整個控制排程,而且很多方法只懂在像素層面指定物件位置,未必真正理解「力」與「速度」這類物理量。PhysStream 的切入點正正落在這個空隙:它是一個自回歸的物理導向圖生影片模型,支援中途互動,容許用戶在生成過程中隨時拉動物件,改變它的運動方向。

核心做法分兩個階段。先用一個雙向模型做微調,加入速度增量(velocity increment)這類稀疏信號作控制條件,讓模型學到背後的動力學;再訓練一個因果自回歸模型,引入結構化場景記憶,記錄位置圖與物件追蹤圖,使每一幀生成都能參考歷史畫面的一致狀態。同時解決了「中途介入」與「物理一致性」兩個難題。

PhysStream 把運動分佈距離(FVMD)降低 33%、軌跡誤差降低 12%,而且在真實場景的人類評測中,超過 85% 的對比都獲得偏好。在多物件桌面剛體場景裡,這種邊生成邊控制的能力是目前其他方法做不到的。對做特效、動畫預覽或物理模擬預演的團隊來說,這種「拉到邊做」的互動模式會比較貼近日常工作流。

重點摘要:

  • 中途拖動控制:生成過程中可隨時改變物件運動方向,毋須事先設定控制排程
  • 物理導向信號:採用速度增量而非像素位置,讓模型學習真正的動力學
  • 結構化場景記憶:以位置圖與物件追蹤圖維持長影片一致性
  • 兩階段訓練:先雙向微調學控制條件,再因果自回歸強化物理一致性
  • 評測表現:FVMD 降 33%、軌跡誤差降 12%,人類評測偏好率逾 85%

項目主頁

Categories: AI productions, 視頻模型, 模型訓練, Video, World-Action Model, Robotic, 動畫

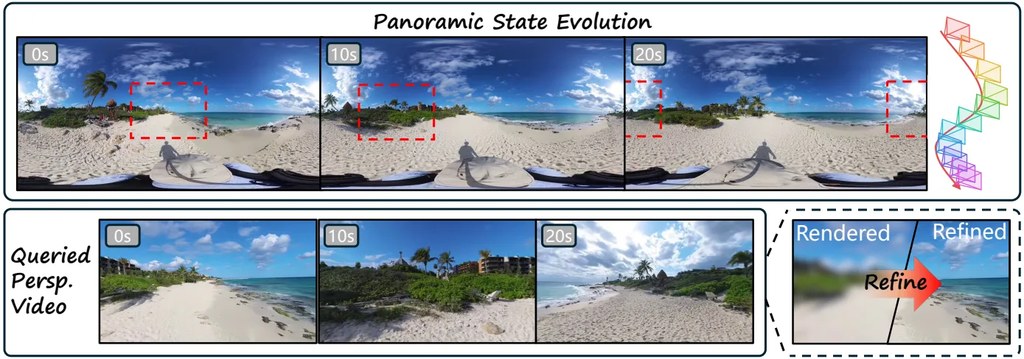
AlayaVista:全景潛態驅動嘅可串流世界模型

AlayaVista 從一張透視圖出發,建立 360° 全景先驗,再隨鏡頭動態演化作為視點潛態,逐區塊渲染並局部精煉所選畫面,做流暢且高保真嘅可控影片生成。

AlayaVista evolves panoramic states under camera control and renders and refines the requested perspective views.

想由一張普通圖片,邊拉鏡頭邊即時生成高質影片,而又唔丟失 360° 場景記憶?AlayaVista 就係為呢個矛盾而設計——佢屬於世界模型(World Model)類研究原型,處理嘅係可控、可串流嘅影片生成問題。

核心做法分三步:先用一張透視圖估出完整 360° 全景先驗,模擬出 VR 風格嘅場景記憶;之後鏡頭控制訊號會驅動呢啲全景潛態持續演化,保持全局一致性;最後系統只渲染用戶當前視角所在嘅區域,並用潛態視口渲染與局部精煉做高保真合成。為咗兼顧速度與質素,佢採用 chunk-autoregressive 逐區塊自迴歸生成,配合少步蒸餾(few-step distillation),令串流過程唔使逐幀重頭計,全部運算力集中在真正需要輸出嘅視窗。

比起傳統逐幀擴散或全景一次性輸出嘅做法,呢種「全景當記憶、視口當輸出」嘅分工換嚟兩個明顯取捨:視窗畫面更銳利、代價係鏡頭一轉就要重新做視口對齊;同時間全景一致性同幀率都受惠於 chunk 邊界設計,對長鏡頭平移類場景特別友好。

幾個重點摘要:

  • 全景記憶 + 局部渲染:以 360° 全景潛態維持場景上下文,鏡頭視口獨立精煉,避免整段重算。
  • 鏡頭可控串流:支援 user-controlled camera 訊號輸入,邊互動邊生成適合遊戲引擎、VR 預覽或 cinematic pre-vis。
  • 效率設計:chunk-autoregressive 加 few-step distillation,專注運算力於選定視窗。
  • 仍屬研究階段:roadmap 列明推理代碼同預訓練權重尚未釋出,目前只可睇 paper 與 project page 嘅 demo。

呢類模型對做互動敘事、VR 內容預覽、遊戲關卡 walkthrough 嘅團隊最有直接參考價值,因為佢直接處理「鏡頭會行、背景要穩」呢個常見卡位。對純做離線一鍵出片嘅用家嚟講,呢類串流設計嘅優勢未必即刻見效,但對需要低延遲、長時序一致嘅創作流程,呢條技術路線值得留意。

項目主頁 · GitHub

Categories: 開源, AI productions, 模型, 視覺模型, 視頻模型, 世界模型, Video, Image, 框架, 教學

EditVid:零訓練、單一框架處理五大影片編輯任務

伊利諾伊大學 PLAN Lab 推出 EditVid,毋須訓練即可在一個框架內完成風格轉換、屬性修改、物件插入等多種影片編輯。

PLAN Lab Logo

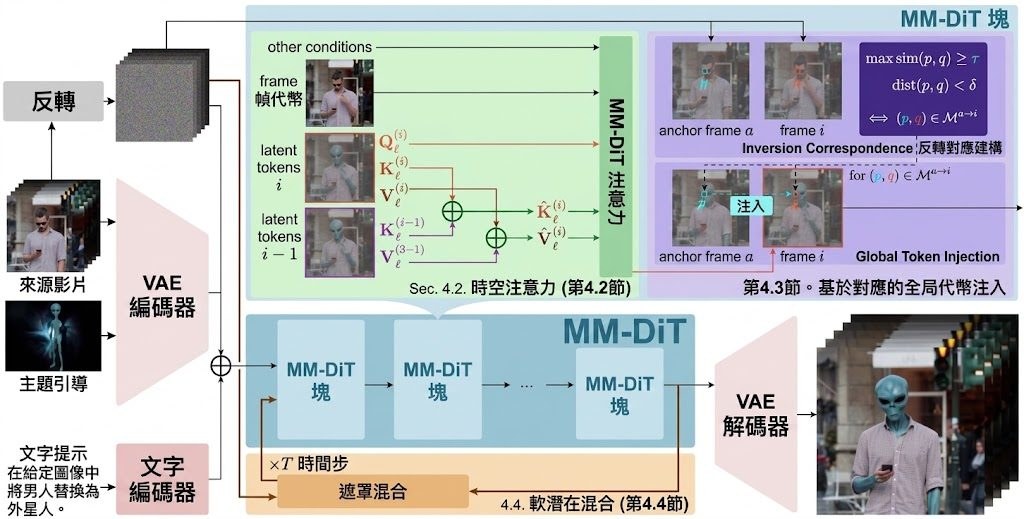
想用同一套方法幫一段影片換風格、改顏色、甚至換主體,又唔想為每種任務訓練專屬模型?PLAN Lab(伊利諾伊大學厄巴納-香檳分校)嘅 EditVid 正正就係為呢個煩惱而設計。佢屬於免訓練(training-free)嘅影片編輯框架,直接喺凍結嘅多模態擴散 Transformer(MM-DiT)圖像編輯器上動手術,同時支援文字指令引導同參考圖引導兩大路線。

對一般用家嚟講,最大體感差異係:一條原本只能用嚟改顏色嘅編輯鏈,現在仲可以做局部部件編輯、物件插入、主體替換等五類任務,唔使每樣重新煉模型。你叫佢「將大象變藍色」、「將海浪轉做黑色」、「將衣服轉紅色」,佢都能在同一條流程內完成。

佢能夠兼顧短距離同長距離一致性,關鍵在於三個互相配合嘅設計:

  • 稀疏因果記憶:每幀只向前一幀取視覺鍵值狀態,避免長距離 RoPE 交互變得唔穩定。
  • 後注意力 Token 注入:用置信度同循環一致性匹配把幀同錨點幀對齊,再注入匹配到嘅視覺表示,維持主體外觀一致。
  • 軟潛空間混合:根據時間步動態調整保留權重,源內容需要保留嘅地方唔會被強行覆蓋。

量化結果方面,喺 FiVE 基準上 EditVid 拎到 78.16 分 FiVE-Acc,比目前最強嘅訓練免費基準高出近 20 分;喺 IVEBench 上面亦取得具競爭力嘅成績。用戶研究入面,超過一半受訪者(51.8%)傾向揀 EditVid 而唔係其餘 7 種對比方法。

如果日常工作涉及大量短片二次創作、廣告素材改版、或者需要快速試驗唔同視覺風格,EditVid 提供嘅「零訓練、單一框架」思路可省卻大量前置準備成本。

項目主頁 · GitHub · Paper

Categories: 開源, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, 框架

MiniMax-H3 Singularity:提升影像轉影片品質

基於 MiniMax-H3 深度微調的多模態影片模型,針對動作模糊、遠景人臉失真與光影過油等痛點進行修補。

Minimax-h3_Singularity 是建基於 MiniMax-H3 的多模態影片生成模型,採用 Apache-2.0 授權,於 ComfyUI 環境原生支援 Text-to-Video(T2V)、Image-to-Video(I2V)、Reference-to-Video(Ref2V)以及 Video-to-Video(V2V)四種工作流程。開發者並非單純做一次 LoRA 貼片,而是將 ref、fl、b25-49 等多個關鍵 checkpoint 進行策略性融合,再以高步數深度微調,最後花三天做精準剪枝與權重優化,目的是在保留 MiniMax-H3 原生 prompt 適應力與泛化能力的同時,壓住高步數訓練帶來的鬼影與過擬合。

這個版本重點針對三類常見瑕疵:高動態場景的運動模糊、Medium-to-Long Shot 距離下的人臉崩壞與糊化,以及人物皮膚過油、光澤不自然的問題。在功能面上,它特別加強了武打對戰、魔法施法、粒子光暈等奇幻動作場景的動感張力,同時提升鏡頭語言對搖鏡、推拉、追蹤等運鏡指令的回應度。

模型以 ComfyUI 節點工作流為主要入口,並附帶 RunningHub 線上 Demo 以及 YouTube、Bilibili 展示頻道連結,方便先觀察實際輸出再決定整合方式。

MiniMax H3 Singularity开源!全面微调融合,基础能力还在!嗨,大家好,这里是啊ban!快去玩!纯推荐分享视频!

重點摘要:

  • 基礎模型:以 MiniMax-H3 為底,融合 ref、fl、b25-49 等 checkpoint 做高步數微調與剪枝
  • 支援工作流:T2V、I2V、Ref2V、V2V 四種 ComfyUI 多模態流程
  • 主要修正:HDR 影像品質、遠景人臉修復、去油感光影、強化武打與魔法 VFX 動感
  • 鏡頭控制:對 pan、tilt、zoom、tracking 等運鏡指令有更敏銳回應

項目主頁

Categories: 開源, ComfyUI, AI productions, 模型, 多模態模型, 視頻模型, 模型訓練, Video, Image, MiniMax

MiniMax H3 Semantic Bridge:單卡煉成的極輕量視頻生成適配器

約 11 MB 的小型適配器,可在不改動 H3 權重的情況下,把跨架構語意信號融入 MiniMax H3 的視頻生成流程。

Og image

由社群開發者 speach1sdef178 發佈的 MiniMax H3 Semantic Bridge,基於 MiniMaxAI 嘅 MiniMax-H3 進行延伸,定位係一個輕量嘅 conditioning-space 適配器,主要服務於標準 H3 FL2VA 文字生成視頻流程,整個項目僅用單張 NVIDIA RTX 3090 Ti 24 GB 完成訓練,並無動用多 GPU 叢集。

這並非 LoRa、checkpoint 合併或傳統的參數轉接。此適配器在影片Transformer之前轉換原生H3條件,並將學習到的語意表示以可控強度融合回H3。佢嘅核心做法係將原本用於 SenseNova U1.5 嘅語意表示,透過跨架構遷移與蒸餾,壓縮成一個獨立嘅小型檔案(MiniMaxH3_SemanticBridge_v1.safetensors)。使用時 SenseNova 完全唔需要載入,適配器會喺視頻 transformer 之前轉換 H3 嘅原生 conditioning,再以可控強度將學到嘅語意信號混合返入 H3。檔案本身只有約 11 MB,並唔係 LoRA、權重合併或者傳統參數嫁接,安裝方法係將 MiniMax_H3_Semantic_Bridge_v1.0.zip 解壓至 ComfyUI 自訂節點目錄,再將適配器放入新增嘅 ComfyUI/models/semantic_bridge/ 資料夾即可。

目前 v1 只支援文字條件嘅標準 FL2VA 流程,Ref2VA 參考圖生成或參考音訊工作流並唔適用。官方亦提到,喺參考音訊場景插入呢個適配器時,唱歌同嘴型同步表現會明顯下降,因此使用前要留意任務邊界,避免硬套落唔支援嘅流程。呢個項目提供咗 examples/ 對照素材、workflow JSON 同研究文章,方便用家直接喺 ComfyUI 內做 Native H3 同 Semantic Bridge 嘅 A/B 比較。

重點摘要:

  • 基礎模型:MiniMaxAI/MiniMax-H3,定位係 H3 嘅 conditioning-space 適配器而非權重合併。
  • 檔案規模:約 11 MB 嘅獨立 .safetensors,外加 ComfyUI 自訂節點 zip 同 workflow JSON。
  • 訓練條件:單張 RTX 3090 Ti 24 GB 完成,無需多 GPU 叢集,SenseNova 只用於訓練階段。
  • 支援範圍:適用於 H3 FL2VA 文字生成視頻,Ref2VA 同參考音訊流程未獲支援。
  • 整合方式:放入 ComfyUI custom nodes,並透過新增節點將 conditioning 同 latent 注入原有 H3 流程。

項目主頁

Categories: 開源, ComfyUI, 模型, 視頻模型, 模型訓練, NVIDIA, Video, Audio, MiniMax

VDN-H3 開源:14 秒 MiniMax 影片生成只花 11 秒

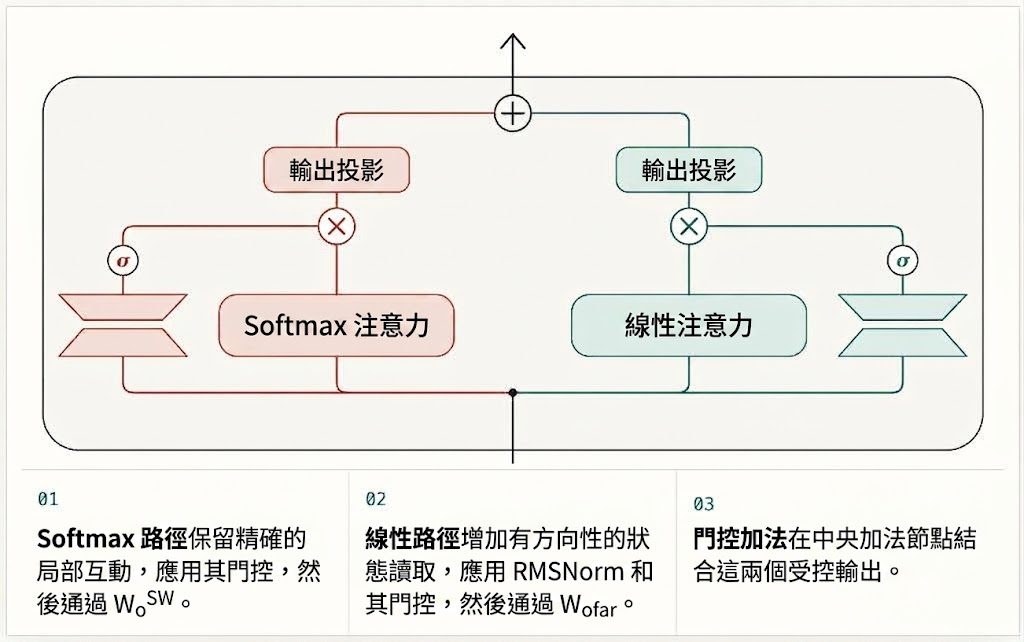
OpenVDN 團隊將 softmax 與線性注意力混合架構(hybrid attention)套用到 MiniMax H3 影片生成模型,在 8 張 B200 上以 8 步去噪產出 14.4 秒 768p 影片,速度比播放還快。

Repository image for OpenVDN/vdn-minimax-h3

影片生成最貴的部分往往不是參數量,而是長序列上的 softmax attention。VDN-H3 針對這個痛點,把 MiniMax H3 骨幹拆成兩條互補分支:滑窗 softmax 負責鄰近幀之間的精細對齊,線性注意力則接手長距離語境與主體一致性,並用 4 向邊界錨點補強全域結構。最終在 8 張 NVIDIA B200 上,用 8 步去噪就能在 11.23 秒內生成 14.4 秒 768p 片段,生成速度比播放還快。

與同類做法的差異在於「近乎無損」這個定位。純線性注意力雖然快,但長序列下容易丟失主體身份、場景佈局與時序依賴;VDN-H3 透過混合架構把這部分成本交回給局部 softmax,線性分支只負責長程記憶,因此視覺品質與原版 H3 幾乎難以區分,也比 MiniMax FastH3 有更好的指令跟隨能力。對需要高吞吐量同時不犧牲一致性的團隊,這個取捨相當實用。

部署面需要 PyTorch 2.13、CUDA 12.9 與 FlashAttention 4(含 nvidia-cutlass-dsl 預釋版依賴),另外還要安裝一份修補過的 Diffusers;骨幹權重不需更動,兩條 LoRA adapter 可在推理時合併進去,等同 plug-and-play 替換。程式碼、訓練流程與優化後的推理 stack 一併開源,研究者與影片生成產品團隊都能直接複用。

重點摘要

  • 8 步去噪、8 張 B200,11.23 秒生成 14.4 秒 768p 影片,生成快過播放。
  • 混合 attention:滑窗 softmax 保留局部細節,線性分支負責長距離語境。
  • 視覺品質與原版 MiniMax H3 近乎無損,比 FastH3 指令跟隨更佳。
  • LoRA adapter 可合併進骨幹推理,不需更動原始權重。
  • 權重、推理 stack 與訓練程式碼同步開源。

項目主頁 · GitHub · 模型· ComfyUI 節點

Categories: 開源, AI productions, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Video, Python, MiniMax

Page 3 of 18
1 2 3 4 5 … 18