Microsoft Mage:4B 多模態輕量路線

想做影像生成、編輯,甚至進一步研究多模態模型,但運算資源有限,Mage 會係一個值得留意的方向。它把 4B 規模壓到夠細,同時仍然追住更大模型的表現。

gallery

當你想喺有限 GPU 預算下做影像生成、編輯,甚至延伸到影像與影片理解,Mage 這個開源模型家族的定位就相當直接:用固定 4B 參數規模,處理多模態理解與生成兩條路線,目標唔係堆大模型,而係保留研究可控性同部署可行性。

Mage 目前最完整的是 Mage-Flow,屬於模型家族中的生成與編輯分支。它把 Mage-VAE 同 Native-Resolution Multimodal Diffusion Transformer 組合起來,前者負責更高效率的 latent tokenizer,後者負責文字生圖與指令式修圖;同時提供 Base、RL-aligned 同 4-step Turbo 版本,方便按畫質、對齊程度與速度取捨。另一條線 Mage-VL 對準 image/video understanding,但程式與權重細節仍待釋出。

同類開源影像模型很多都靠更大參數量換效果,Mage 的判斷明顯不同:它把重點放喺 codec-aligned efficiency,同一個 checkpoint 已可覆蓋 512 到 2048、不同長闊比,連 4:1 這類極端尺寸都原生支援,減少多套模型或額外縮放流程。它在生成、編輯表現上可與 Qwen-Image 20B、FLUX.2 32B、FireRed-Image-Edit 20B 等較大型開源系統競爭,但取捨是 Mage-VL 仍未完整開放,整個家族現階段更適合關注研究與工作流整合的人先行評估。

Super fast Image Edit model Mage-Flow on 8GB VRAM
  • 固定 4B 規模,主打可訓練、可微調、可部署
  • Mage-Flow 已覆蓋 text-to-image 與 instruction-based image editing
  • Mage-VAE 以更低 encode/decode MACs 減輕高解析度瓶頸
  • 單一 checkpoint 支援 512–2048 與多種 aspect ratio
  • Turbo 版本強調速度,1024² 在單張 A100 有明確推理數字

部署與測試方面,現有資料顯示 Hugging Face 已提供多個 Mage-Flow 與 Mage-Flow-Edit 權重,適合先用現成 checkpoint 驗證生成、修圖與速度,再決定是否進一步做微調。對做垂直領域影像項目、想研究後訓練方法,或者需要把高解析度生成放入較實際算力條件的人,Mage 的吸引力不在花巧包裝,而在它用一條輕量路線,把研究、性能與部署成本拉回較平衡的位置。
項目主頁 · GitHub · 模型

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, 微軟, Stable Diffusion, Video, Image, 影像模型, 影像處理, txt2img, Medical醫學

quote-and-retrieve:用「引文+檢索」的視覺文件理解

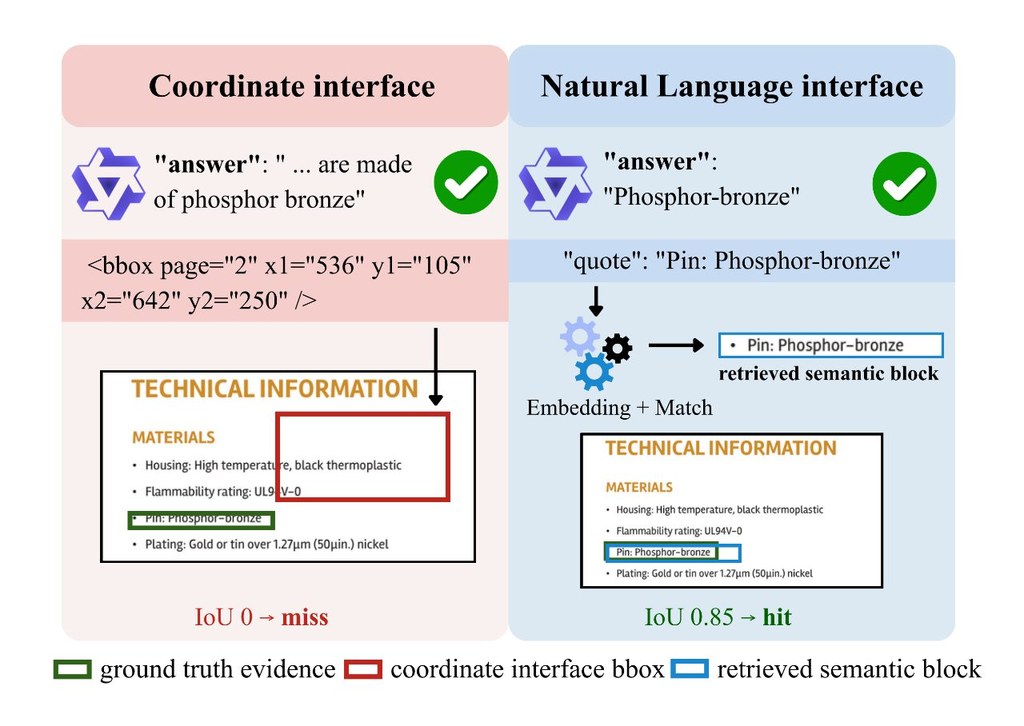
你可以把它理解成:當 VLM 答對問題卻指錯位置,問題未必出在模型,而是出在要求它輸出座標這種介面設計。換成「引文+檢索」後,歸因召回率翻倍,幻覺率近乎減半。

Repository image for Ryenhails/quote-and-retrieve

視覺語言模型 (VLM) 讀完文件回答問題時,傳統做法會要求它同時輸出 bounding box 標註證據位置;然而開源模型經常「答對但指錯」,這現象被稱為 Attribution Hallucination。這個來自赫爾辛基 Aalto 大學的開源項目主張,問題癥結很大程度是輸出介面本身的限制,而非模型缺乏 grounding 能力。

他們設計了一組控制變量實驗:固定模型、輸入頁面、題目與評分機制,僅改變證據表達方式。座標介面要求模型逐 token 生成框;語言介面則由模型輸出逐字引文,再交由外部 layout parser 與 retriever 找回對應區域(表格與圖片透過 caption 或註解引用)。在四個家族共六款開源 VLM 上,evidence recall 由座標介面下最高 8 分躍升至語言介面的 26 至 47 分,hallucination rate 近乎砍半,而答題品質幾乎不變。

基於這個對比,作者進一步提出 region-label-free GRPO 訓練方法:獎勵訊號只讀取 gold answer 與檢索區域的裁切圖,毋須任何 region-level 標註。8B 模型在這個框架下,strict attributed accuracy 由 22.4 提升至 33.8,等於用更便宜的監督換到明顯的歸因改善。

對於處理長文件、多模態表格或需要可追溯證據鏈的團隊(例如文件審核、研究文獻回顧)來說,這條 quote-and-retrieve 路線既繞開昂貴的人工框標註,也避開模型不擅長的座標生成。想要快速感受差異,只需 clone 項目後執行 python src/score_citevqa.py examples/sample_predictions.jsonl 與同一指令對座標版本跑一次;附帶的範例檔只有四題合成題,卻已重現論文核心發現。

重點摘要:
– 問題重新定位:歸因幻覺多屬輸出介面產物,並非模型能力不足
– 介面切換:座標介面換成引文+外部 retriever,evidence recall 由 ≤8 升至 26–47
– 訓練替代方案:region-label-free GRPO 用 gold answer+裁切圖作獎勵,毋須昂貴框標註
– 規模效益:8B 模型 strict attributed accuracy 由 22.4 提升至 33.8
– 快速驗證:附範例 JSONL,無需 GPU 即可重現對比結果

GitHub · Paper

Categories: 開源, 模型, 視覺模型, 多模態模型, Qwen, Clone, Python

ClinFusion 把醫療影像讀懂再回答

ClinFusion瞄準的不是一般聊天,而是把2D與3D醫療影像連同文字指令一併理解。它想解決的重點,是醫療多模態模型常見的看得多、答得快,卻未必貼近臨床判讀。

radar chart

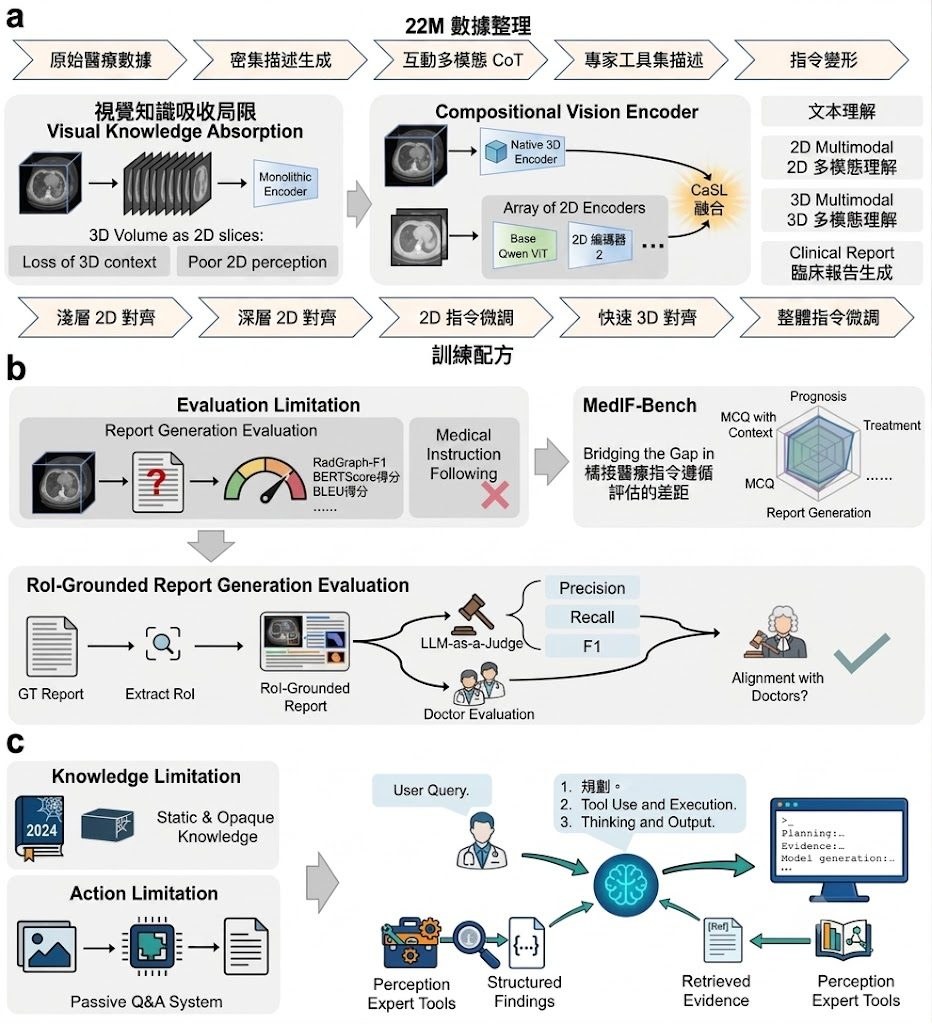
醫療多模態模型最易失準的位置,往往不是會不會答,而是有沒有真正對準影像內容。ClinFusion屬於模型,更準確地說是面向臨床理解的 vision-centric Multimodal large language models (MLLMs) 系統,重點放在同時處理 2D 圖像、原生 3D NIfTI 影像與文字任務,減少只靠文字對齊時常見的臨床細節流失。

現有做法常把醫療問題當成一般多模態問答處理,但作者認為這種範式忽略了 3D 影像與放射科判讀流程,因此用 compositional and cascaded vision encoder 配合 Cascade Spatial-Aware Locality Fusion,把 2D 與 native 3D 醫療影像放進同一個 fused encoder。另一個關鍵不是只換模型,而是連評測也改寫:加入 MedIF-Bench 檢查 instruction following,並用 region-of-interest-grounded 方法評估報告生成的 factualness。

論文給出的成績相當進取:ClinFusion 在 24 個基準中有 20 個超過 Hulu-Med、Lingshu 等開源醫療 MLLMs,也在 16 個比較裡有 13 個勝過 GPT-5.2 與 Gemini-3-Flash。盲測部分由 board-certified radiologists 進行,報告排名亦拿到最佳,RoI-grounded metric 與專家判斷的相關性也最高,這點比單看自動分數更有說服力。

  • 可接受文字 prompt、2D 圖像路徑,以及 3D NIfTI volumes(.nii.gz)
  • 定位不是通用聊天,而是臨床導向的整體醫療理解
  • 核心取向是把 2D/3D 視覺編碼與臨床一致的評測一併重做
  • 已公開模型推理方向,但儲存庫資訊未完整交代部署流程與完整安裝細節

較適合留意這個項目的,會是做醫療 AI、放射影像、多模態研究或醫療報告生成評測的團隊。它的亮點在於把「模型看見了什麼」與「臨床上是否講得準」放到同一條線上;限制亦很清楚,現有 GitHub 資訊主要集中在作者主張與推理輸入格式,真正要落地到醫院工作流,仍要再看公開模型、硬件需求與後續工具鏈是否齊備。

GitHub · 模型

Categories: 開源, 清華大學, 阿里巴巴, 模型, 多模態模型, Qwen, Image, Medical醫學, 3D, 中國, Dataset 數據集

Google 開源 GNM Head:更完整的人頭 3D 模型

做人頭 3D 建模時,最麻煩往往唔係外形,而係眼球、牙齒同舌頭呢類細節。GNM Head 把呢些結構一併納入,定位明顯唔止係傳統面部 3DMM。

GNM Teaser Image

只做臉部外殼,很多時已經唔夠用;去到動畫、重建同生成式影像控制,眼球、口腔同頭部姿態一旦分離得唔好,效果就會即刻穿崩。google/GNM 目前先開放的 GNM Head,屬於3D parametric statistical human model 項目,焦點是用更完整的人頭幾何表示,處理傳統 3D Morphable Models (3DMMs) 對內部 anatomy 覆蓋不足的問題。

這個項目的取向很鮮明:不只是追求一個可調參的人臉網格,而是把 head、face、neck、eyeballs、teeth、tongue 放進同一個生成式人體測量框架。作者在技術報告指出,現有公開模型多數只覆蓋外部幾何,亦容易受限於低保真掃描資料;GNM 則結合高解析 3D scans 與 anatomy-specific artist-made samples,並加入 ocular 同 intra-oral specialized sub-models,目的就是改善幾何品質同可控性之間的取捨。

現有儲存庫較像一個生態系入口,而唔係即開即用的單一應用程式。README 清楚列出 GNM Head 已提供 NumPy、JAX、PyTorch、TensorFlow 多後端支援,亦有 Linux、macOS、Windows 的 CI;但目前公開資訊以模型與技術報告為主,未見到很完整的產品化操作流程說明,所以較適合研究、角色生成、數碼人、3D 視覺或生成式影像控制團隊按其子目錄文件逐步接入。

  • 補足傳統 3DMM 常見缺口:不只外形,連眼球、牙齒、舌頭都可控
  • GNM Head 強調 identity、expressions、head pose 的 disentangled control
  • 同時支援 NumPy、JAX、PyTorch、TensorFlow,方便接去不同研究流程
  • 技術報告聲稱在 fitting target 3D face scans 達到 SotA 表現,但具體指標仍要回看原報告

它最吸引人的地方,在於把「可生成、可擬合、可作條件控制」三條路線拉到同一個模型家族內。現階段公開內容仍以 GNM Ecosystem 的起步版本為主,想拿來做完整 production pipeline,仍要自己判斷與現有重建、動畫或生成系統的整合成本;但作為高保真人頭 3DMM 的新基礎,這個項目的研究價值同延展空間都相當高。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Google, TensorFlow, Mac, 3D, Linux, Python, 語音, Dataset 數據集

ARI 用 RAG 修復韓國朝鮮古籍殘字

遇到人名、地名殘缺的古籍,單靠上下文往往會估錯。ARI把檢索到的史料一併交畀模型判斷,明顯更適合做歷史文獻修復。

Method Figure

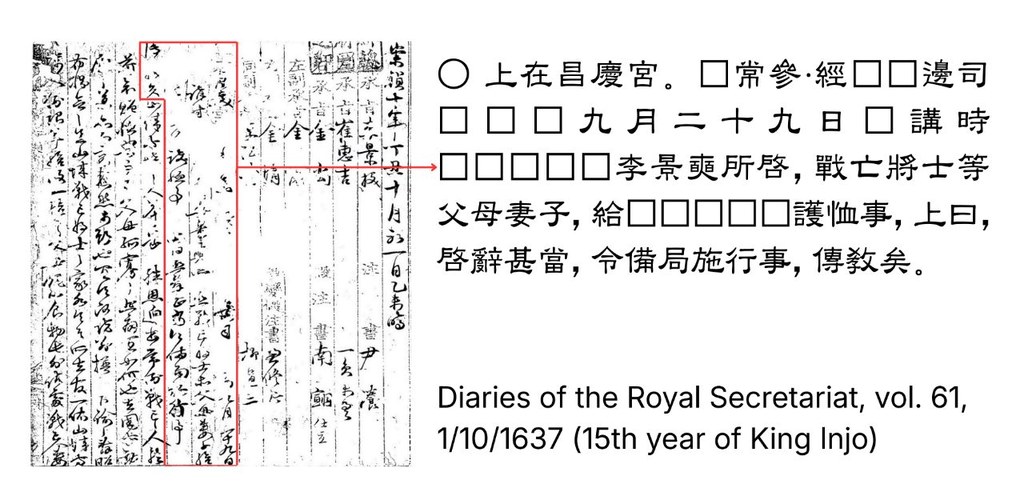
最值得留意的,不是模型把缺字補回來本身,而是它專門處理古籍修復最棘手的一類內容:人名、地名等 Named Entities。ARI 屬於一個結合 Retrieval-Augmented Generation(RAG)的文獻修復框架,針對朝鮮王朝實錄與承政院日記這類韓文漢字史料,補足只靠局部語境時經常失準的缺口。

現有做法多數依賴 masked language modeling,擅長根據前後文猜測一般字詞,但一遇到需要外部史實支持的專名就容易失手。ARI 的取向很清楚:先用 BM25 從歷史語料找出前 20 份相關文本,再以字串相似度 0.8 過濾重複內容,將這些外部證據交給模型一併生成,修正通用 LLM 容易出現的幻覺。

模型部分不是從零開始,而是建基於 Qwen3 32B 與 Qwen3 8B 微調成 ARI-32B 和 ARI-8B,並加入 25% named entity-prioritized masking 訓練策略,把學習重點放在知識密集片段。論文亦指出,對漢字材料而言,詞彙層面的 BM25 檢索比 embedding-based retrieval 更有效,這一點頗有說服力,因為表意文字的字形與字詞對應關係本身就影響檢索效果。

  • 適合歷史文獻整理、數位人文研究與古籍校勘團隊參考
  • 主要強項在於修復需要外部知識支撐的 Named Entities
  • ARI-32B 與 ARI-8B 同步提供,前者追求表現,後者較重視運算成本
  • 論文結果顯示,它在 named entity 與隨機遮罩字元修復都勝過多個基線與通用模型

把它視為一個已有公開模型與方法說明的研究項目。對需要先驗證效果的人來說,現階段較合理的路線會是先查看論文設定與模型頁面,再判斷是否足以接入自己的古籍修復工作流。

項目主頁 · GitHub · Paper

Categories: 開源, RAG, Embedding, 模型, Qwen, 語音, Dataset 數據集

JoyAI-Image 想做懂空間的影像模型

JoyAI-Image唔只想生圖,仲想令模型真正理解畫面入面物件點擺位、點互相關聯。對要做指令修圖、排版生圖同多視角內容的人,呢個方向幾有參考價值。

Repository image for jd-opensource/JoyAI-Image

改圖最怕模型聽得明文字,卻改壞原本場景結構;生圖亦常見字排得唔準、物件關係走位。JoyAI-Image就係朝住呢個痛點落手,定位屬於多模態基礎模型,把影像理解、text-to-image 生成同指令式編輯放入同一個模型家族,重點處理空間理解不足帶來的失真與失控。

唔係把理解模型同生成模型鬆散拼埋,而係用 8B Multimodal Large Language Model (MLLM) 配 16B Multimodal Diffusion Transformer (MMDiT),強調理解、生成、編輯之間的閉環協作。換句話說,模型唔只讀圖後再畫圖,仲會利用視角變換等生成結果反過來補強空間推理,呢點令它在 grounded generation、關係定位同可控編輯上有更鮮明方向。

現有公開內容顯示,部署路線算完整,已提供 Hugging Face 權重、Diffusers 版本、ComfyUI 原生支援,同埋可直接參考的 workflow;另外亦有 Spatial Edit 同 General Edit 示範空間。對內容製作、電商視覺、設計流程或者研究多模態編輯的人,較值得留意的是它不只處理單次修圖,仲想處理長文字排版、版面忠實度、多視角生成,以及「指定物件移去指定位置」呢類容易出錯的操作。

JoyAI Image Edit Plus in ComfyUI - How Does it Compare?
  • 把理解、生成、編輯整合到同一條多模態流程
  • 核心賣點係較強的 spatial intelligence,而不只是畫面更靚
  • 已有 Diffusers 與 ComfyUI 兩條使用路線,測試門檻較研究原型低
  • 延伸到 OpenSpatial data engine 同 OpenSpatial-3M dataset,反映它連資料與訓練配方都一併公開

效能方面,儲存庫描述集中在能力展示與訓練設計,現階段較適合把它理解成一個方向清晰、工具鏈逐步成熟的開源影像模型項目。最吸引之處唔係單一指標,而係它把空間理解當成生成與編輯的核心能力,對需要更穩定版面、關係同位置控制的工作流,確實比單講畫質更實用。

GitHub · 模型

Categories: 開源, ComfyUI, 模型, 視覺模型, 多模態模型, Qwen, Image, txt2img, Dataset 數據集

SoulX-Singer 把零樣本歌聲合成

想快速試一把未見過的歌手聲線,SoulX-Singer提供咗幾近成品級嘅路線。它唔只唱得準,連跨語言同改詞後的人聲一致性都放埋入同一套流程。

SoulX-Logo

做歌聲生成,最難往往唔係「唱到」,而係未見過的聲線仍然要自然、準音、像本人。SoulX-Singer正是朝住呢個矛盾而來的開源模型項目,重點放在 zero-shot singing voice synthesis:唔使為每位歌手再微調,都可以用參考聲線配合旋律或樂譜生成歌聲。

它的定位幾清楚:一邊照顧創作控制,一邊盡量保住音色身份。你可以用 melody-conditioned 的 F0 contour 控制音高走向,亦可以用 score-conditioned 的 MIDI notes 對齊節奏與音符;對於需要改詞、換語言、保留同一把聲去做 demo、作曲草稿或虛擬歌手內容的人,這種控制方式比只靠文字描述更實際。README 亦提供 Hugging Face 模型與線上示範,部署理解上屬於下載預訓練權重後做推理的典型流程。

同類做法常見取捨,是控制愈細,聲線就愈易散;複製音色愈強,跨語言和改詞後又可能變得生硬。SoulX-Singer把 timbre 與 content 盡量拆開處理,目標是讓 Cantonese、Mandarin、English 之間仍能維持歌手辨識度,這點比單純追求「像真」更有產品意味。項目另外還有從 SoulX-Singer 微調而來的 SoulX-Singer-SVC,處理 singing voice conversion,直接由原始歌聲音訊轉換成目標歌手風格,連歌詞或 MIDI 標註都可省去。

  • 支援 F0 contour 與 MIDI 兩種控制,適合作曲草稿與精修流程
  • 主打 zero-shot,未見過的歌手聲線都可生成,減少逐人微調成本
  • 42,000+ 小時對齊人聲資料覆蓋 Mandarin、English、Cantonese
  • 可做改詞編修與跨語言合成,同時維持音色一致性
  • 另設 SoulX-Singer-SVC,補上 audio-to-audio 轉換場景

現有資料未完整列出量化指標細節,但項目已公開技術報告、arXiv 與示範頁,代表它不只停在概念展示。對音樂 AI 團隊、虛擬歌手內容製作、語音與歌聲研究者而言,SoulX-Singer吸引之處在於它把可控性、跨語言與免微調三件事放入同一條生成鏈,而限制則仍要留意倫理風險、聲線授權,以及最終作品是否需要後期混音補足細節。

GitHub · 模型

Categories: 開源, 模型, Audio, 聲效, 音樂

eeg-difflogic:邊緣 EEG 分類改用邏輯電路

這個項目把 EEG 分類從浮點神經網絡,轉向可直接編譯成布林電路的 Diff-Logic。你可以把它理解成一種更貼近邊緣裝置限制的做法,重點放在低延遲與記憶體壓力。

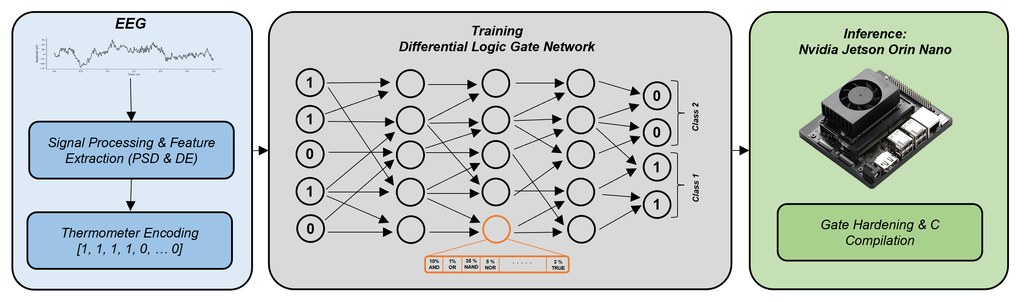
Workflow for EEG classification using differentiable logic gate networks

這份項目對準的是要在邊緣裝置即時分析 EEG 的場景,核心矛盾很直接:傳統神經網絡雖然準,但浮點運算和記憶體開銷會拖慢部署。它屬於研究型工具/框架,處理的是把 Differentiable Logic Gate Networks (Diff-Logic) 用在 EEG 分類,並在推理階段編譯成 Boolean circuits,以 bitwise CPU operations 跑得更輕。

作者同時看了兩類任務:臨床失智分類與情緒辨識。前者用 Power Spectral Density (PSD),後者用 Differential Entropy (DE),再配合 fold-wise Min-Max normalization、thermometer encoding 和多層 differentiable logic gates,最後把學到的 soft gates 硬化成可執行的布林電路。

和 Multi-Layer Perceptrons (MLPs) 及 Binarized Neural Networks (BNNs) 比起來,這個項目不追求單純堆大模型,而是用 iso-parameter evaluation 去看同等參數量下的表現與效率。論文報告在 dementia screening 上 Diff-Logic 拿到 80.2% Macro F1,較 MLP 高 6.8%;在 emotion recognition 上 MLP 準度略有優勢,但部署到 NVIDIA Jetson Orin Nano 單核心 CPU 時,延遲高 2.3 倍、模型體積大 14 倍。

  • 推理路徑清楚:先訓練,再轉成 Boolean circuits 做 inference
  • 適合關心低延遲、低記憶體、能在 edge device 跑的 EEG 系統
  • 評測覆蓋 CN vs. AD、CN vs. FTD,以及三類情緒辨識資料集
  • 在較大規模下,Diff-Logic 的推理時間幾乎保持不變
  • 這個項目最有價值的地方,不在於取代所有 EEG 模型,而是在資源受限環境下提供另一條更貼近硬件的路線

GitHub · Paper

Categories: 開源, 模型, NVIDIA, 框架, Medical醫學, Dataset 數據集

CrisperWhisper 把語音逐字稿變成可控制輸出

同一段錄音,可以要逐字保留停頓與口吃,也可以要乾淨可讀版本。CrisperWhisper 把語音辨識最常混在一起的兩種需求分開處理。

Repository image for nyrahealth/CrisperWhisper

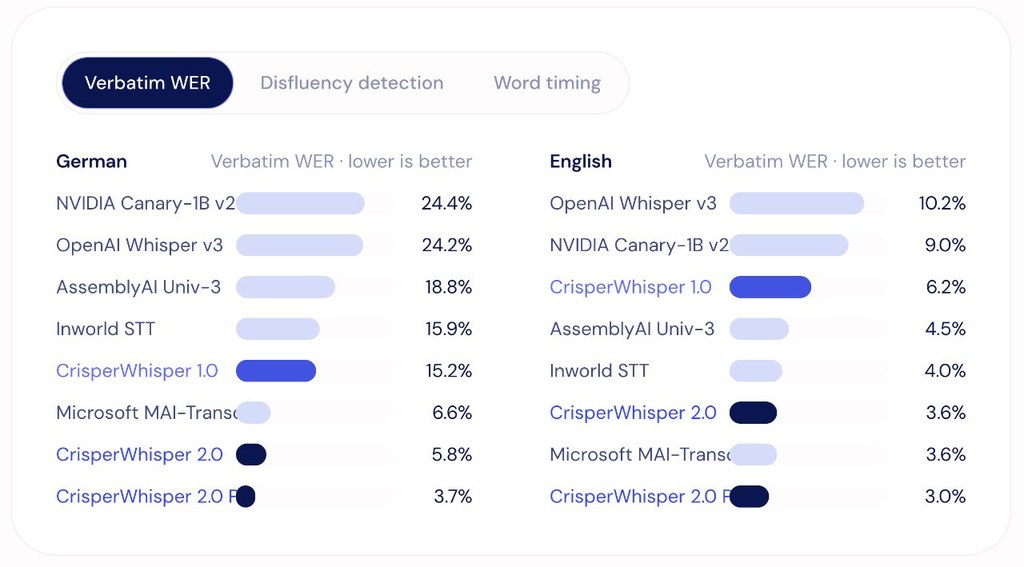
做會議紀錄、訪談整理或臨床語音分析時,最大落差往往唔係辨識到幾多字,而係系統究竟寫出「講咗乜」定「本來想表達乜」。CrisperWhisper 屬於開源語音辨識模型項目,核心價值係將 verbatim 同 intended 兩種轉錄模式變成可明確控制的輸出,令逐字稿唔再受訓練資料風格左右。

呢個取向同一般 speech-to-text 系統好唔同。常見做法會不一致地刪走 filler、重複、停頓同 cut-off,CrisperWhisper 2.0 就刻意保留呢啲語音細節,或者按需要輸出整理後版本;同一段錄音可以得出兩份用途完全不同嘅文本。對做 TTS 資料整理、醫療或研究訪談分析、需要精準字幕時間碼嘅團隊,呢種分流比單純追求可讀性更有用。

項目另一個關鍵位係時間對齊同長音訊處理。它提供 word-level timings,讀稿語音平均邊界誤差約 30 ms,對話語音約 41 ms;長音訊則用 conditional continuation 避免一般分段轉錄常見嘅重複漏字。README 亦提到推理端基於 CTranslate2,配合 speculative decoding,同時減輕 Whisper 常見 looping-hallucination 問題,方向明顯係朝住 production inference。

  • verbatim 與 intended 兩種模式分開控制,適合同一錄音對應不同工作流
  • 支援 multilingual,覆蓋多數 Whisper 支援語言
  • 可用 Verbatimize 依據音訊加乾淨文本補回真實語氣詞與口誤
  • 長音訊轉錄著重連續性,減少 chunk 邊界造成嘅錯漏
  • Nyra Verbatim Speech Benchmark 以 disfluency F1 等指標衡量保真能力

安裝與部署方向相對清晰:模型可經 PyPI、Hugging Face 同文件使用,推理路線圍繞 CTranslate2 runtime,而唔係只停留喺研究展示。要留意嘅取捨亦好直接,當你要的是可讀、可發布文本,intended 模式更合適;當你要保留猶豫、重複、笑聲同語音事件,verbatim 模式先真正發揮價值。呢個項目唔係單靠更高 WER 成績去吸引人,而係重新界定逐字稿應否忠於說話表面形式,並且用 benchmark 將呢件事量化。

項目主頁 · GitHub · 模型

Categories: 開源, 文字轉語音, 模型, NVIDIA, Medical醫學, 語音, Dataset 數據集

Google 開源表格基礎模型 TabFM:零樣本處理混合欄位資料

你可以把它理解成一個專門為表格資料設計的基礎模型,由 Google Research 開源,無需訓練即可做分類與迴歸,對於常用 scikit-learn 的團隊特別友善。

Repository image for google-research/tabfm

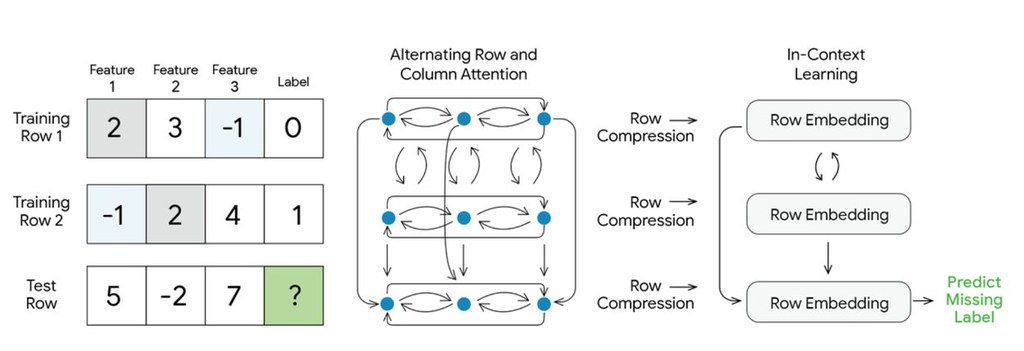
對熟悉表格資料分析的人來說,每次換資料集就得重新訓練模型,是一個長期存在的痛點。TabFM 想解決的就是這個卡位:透過 in-context learning,把訓練資料當作「上下文」直接餵進模型,省掉逐個資料集做參數訓練的步驟,支援數值與類別混合欄位的零樣本分類與迴歸。

這個項目屬於模型與框架混合性質的開源工具,以 scikit-learn 風格的 API 呈現,因此熟悉 fit、predict、predict_proba 的人可以幾乎無痛地接入。它提供 v1.0.0 預訓練權重,使用者可選擇 JAX(含 Flax 0.12.7 的 flax.nnx API)或 PyTorch(torch 2.12.1)作為後端,權重會自動從 Hugging Face Hub 下載。

與傳統監督式表格模型相比,TabFM 的差異在於「即時預測、不需要再訓練」這個取向,特別適合快速原型設計或資料集頻繁變動的場景;不過它的實際效果仍取決於預訓練權重對目標領域的覆蓋程度。中小型資料團隊、需要處理多種表格欄位類型的研究者,以及想用統一介面同時跑分類與迴歸任務的人,較容易從中受惠。

效能方面,由於原文提供的評測細節有限,難以斷言它在所有基準上的強弱;採用 GPU 版本時推理速度會明顯提升,但 CPU 環境亦可運行。需注意此項目並非 Google 官方支援產品,定位偏向研究原型,正式部署前應自行評估穩定性與資料合規性。

重點摘要:

  • 零樣本推論:無需在自己資料上訓練參數,靠 in-context learning 即時產生預測
  • scikit-learn 相容 API:可用熟悉的 fit、predict、predict_proba 流程接入
  • 混合欄位支援:同時處理數值與類別特徵,免去額外前處理設計
  • 雙後端選擇:可依環境需求在 JAX(Flax)與 PyTorch 之間切換
  • 開源但非官方產品:定位為研究性質,部署前宜自行驗證效果與合規

項目主頁 · GitHub · 模型

Categories: 開源, 模型, Google, API, Python, Dataset 數據集

Page 31 of 59
1 … 29 30 31 32 33 … 59