GitHub Copilot 桌面 app 全面開放

而家唔止付費用戶先可用 GitHub Copilot app,連 Free 同教育方案都可以直接開跑。你可以把它理解成將 agent-driven development 帶到桌面的入口。

Og image

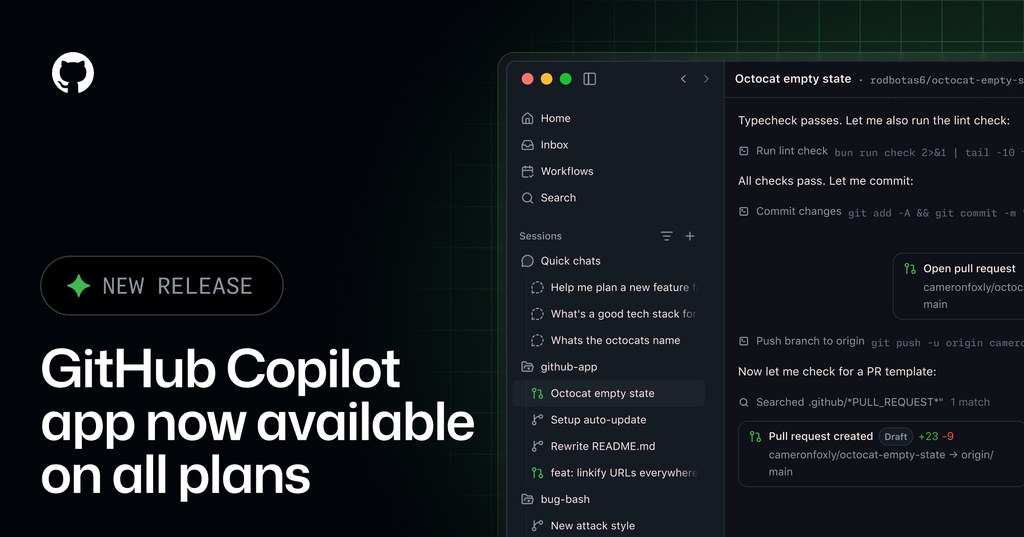
寫程式想快啲進入 agent-driven development,而家門檻低咗好多。GitHub Copilot app 已經開放畀所有 Copilot 方案使用,涵蓋 Copilot Free 同 GitHub Education,並且支援 macOS、Windows 同 Linux,等開發者可以直接由桌面開始工作。

對一般開發者而言,重點唔只係「多一個 app」,而係登入 GitHub 帳戶後,幾下點擊就可以開 session,將 Copilot 由編輯器內的輔助,延伸到更完整的桌面互動流程。呢個變化對想集中用單一入口管理開發節奏、快速試 agent 工作方式的人會更有吸引力。

另一個取向幾清楚:就算冇訂閱 Copilot 方案,仍然可以用 bring your own key(BYOK)接上自己嘅 model provider 跑 session。即係話,GitHub 將入口開放得更闊,一邊照顧現有 Copilot 用戶,一邊容許偏好自選模型供應商嘅團隊或個人保留彈性。

  • 所有 Copilot 方案都可使用,包括 Copilot Free 同 GitHub Education
  • 支援 macOS、Windows、Linux 三個桌面平台
  • 可用 GitHub 帳戶直接登入並快速開始 session
  • 冇 Copilot 訂閱亦可透過 BYOK 連接自有 model provider
  • Business 或 Enterprise 方案需由管理員啟用 Copilot CLI 政策設定

對團隊環境來講,Business 同 Enterprise 用戶仲要留意權限設定:組織或企業管理員需要先在 policy settings 啟用 Copilot CLI,先可以存取 GitHub Copilot app。呢點反映出 GitHub 既想擴大可用範圍,同時亦保留企業管理所需的控管方式。
項目主頁

Categories: Agentic, 微軟, API, Mac, Linux, 編程

GitHub 規則集新增審核撤銷權限控制

團隊而家可以直接限制邊啲人有權撤銷 pull request 審核。對需要嚴格合併流程嘅項目,呢個更新可減少誤操作同權限過闊帶來嘅風險。

Og image

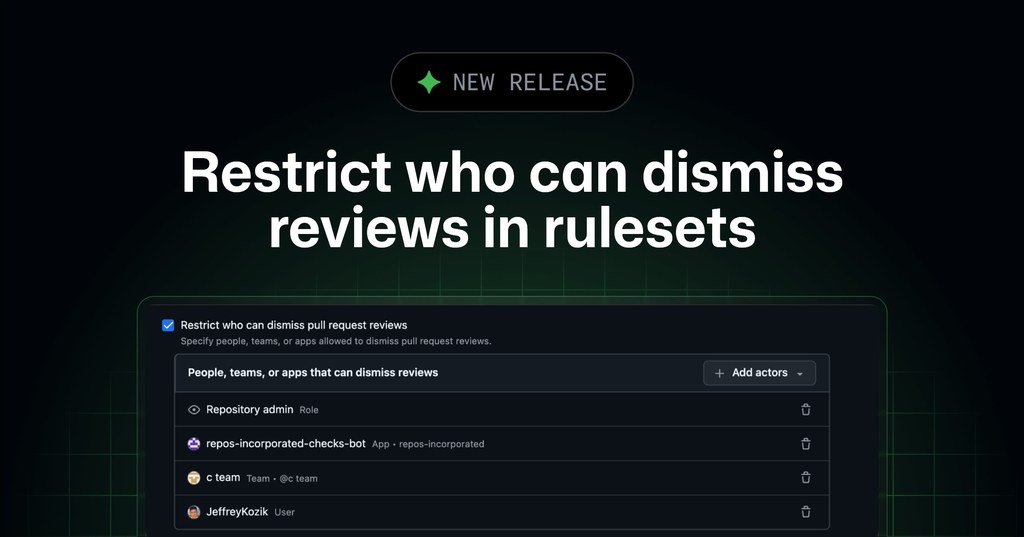
當團隊依賴 pull request 審核去把關程式碼質素時,最怕唔係冇人批核,而係批核已經完成後,任何唔合適嘅人都可以把審核撤銷。GitHub 今次更新屬於 repository rulesets 功能強化,處理嘅正正係合併前權限邊界唔夠細緻呢個問題。

新設定放入 Require a pull request before merging 規則之中,管理者可以直接指定邊啲 users、teams 同 apps 能夠 dismiss reviews。對比以往較寬鬆或者分散嘅管控方式,呢種做法將審核撤銷權限收返去規則集內統一管理,分支保護流程會更清晰。

重點整理:
– 可限制特定 users、teams、apps 撤銷 pull request reviews
– 設定位置已整合到 repository rulesets 既有審核規則內
– 可透過 UI、REST API 同 GraphQL 配置
– 功能已經 generally available,適用於 github.com 上嘅 repository rulesets

呢個更新最適合有多人協作、需要明確審批責任,或者要配合內部治理要求嘅開發團隊。Rulesets 本身已經係 GitHub 建議用來保護 branches 嘅方式,而家再加上審核撤銷限制,等項目喺合併前多一層可追蹤、可控嘅流程保護。

使用上做法唔複雜,只要打開 repository-level ruleset,啟用 Require a pull request before merging,再選擇 Restrict who can dismiss reviews 就可以。呢類更新唔係花巧功能,而係直接改善日常協作入面最常見嘅權限管理細節。

項目主頁

Categories: 開源, 微軟, API, 教學, 軟件, 安全

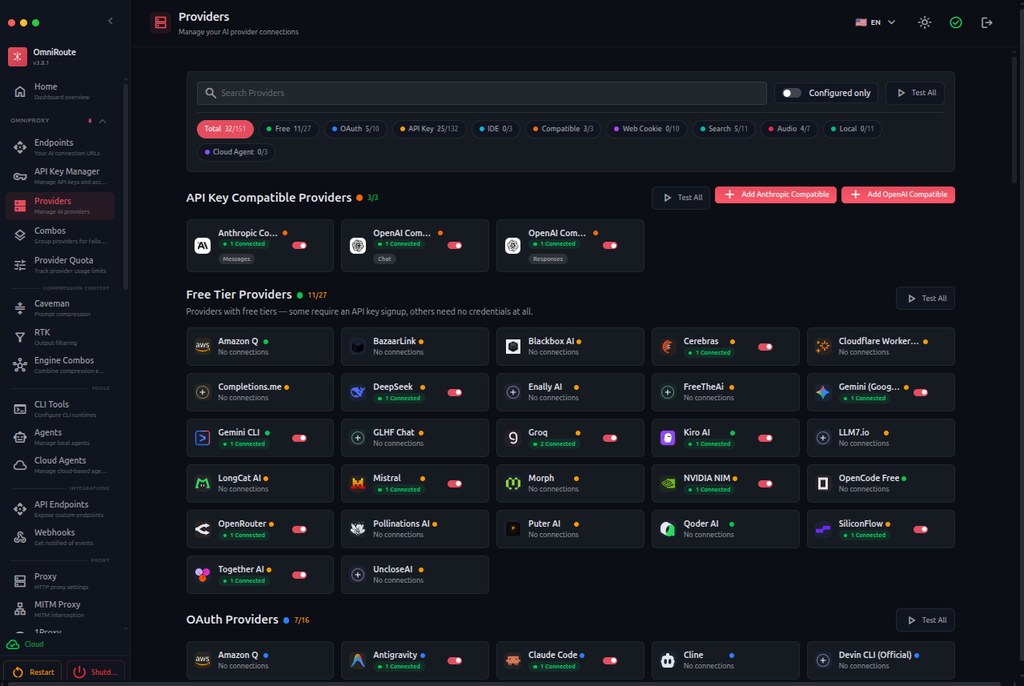
OmniRoute:免費 AI 路由閘道值唔值得用

想用 Claude Code、Codex 或 Cursor,又唔想被單一供應商限額綁死,OmniRoute 提供咗一條幾務實的路。它把免費模型池、備援切換同壓縮節省 token 放埋一齊。

OmniRoute Dashboard

寫程式最怕做到一半先撞到配額上限,或者工具只綁死某一個模型。OmniRoute 把自己放在 AI gateway 呢個位置,直接處理多個 AI coding 工具同多個模型供應商之間的路由問題,重點唔係再造一個聊天介面,而係幫你維持請求可用、控制成本,並用 auto-fallback 減少中斷。

同類做法通常會主打單一 API 聚合,OmniRoute 的取向明顯更偏向「免費額度整合 + 路由策略 + 壓縮節流」。它聲稱可接到 237 個 providers,當中 90+ 提供 free tiers,並以 RTK + Caveman compression 把 token 消耗壓低 15% 至 95%。呢個方向的好處係對長提示、程式碼上下文同重複輸出較有幫助,但壓縮始終係取捨,所以它加咗 inflation guard,遇到壓縮後反而變長,就會送回原文。

OmniRoute + OpenCode: 100% Free AI Coding Setup, Free AI Gateway
New FREE Unlimited AI Coder | OmniRoute

你可以把它理解成放在 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity 後面的中介層。部署後,工具經同一個 endpoint 出請求,再由 OmniRoute 分配到 Claude、GPT、Gemini 及其他供應商;README 也提到每個模型會列出本月已用與剩餘額度,並標示 provider terms,這點對團隊控管比較有用。

幾個值得留意的重點:
– 定位屬於工具 / 閘道型軟件,解決的是多模型切換、免費額度整合同配額中斷
– 支援 Claude Code、Codex、Cursor、Cline、Copilot、Antigravity,適合多工具並行的開發流程
– 以 documented free tokens/month 作招徠,現有資料提到穩定約 1.6B,首月可到 2.1B
– 內建 17 routing strategies,並加入 auto-fallback,減少單一 provider 失效帶來的停頓
– 壓縮模組已針對 German、French、Japanese、Chinese,以及 Gradle、.NET 輸出做過強化

受益最大的一般會係重度依賴 AI 編碼助手的個人開發者、細團隊,同想把成本壓到最低的實驗性項目。要留意的是,免費池本身受各 provider 條款影響,OmniRoute 雖然強調統計方式較透明,但效能與穩定性仍然建基於外部服務;它較像一個把資源調度做得更聰明的控制層,而唔係保證品質一致的模型平台。

GitHub

Categories: 開源, 微軟, Gemini, API, Vibe Coding, 工具, IDE, 編程, Anthropic

微軟 ResearchStudio:AI 助你研究你的方案

微軟開源一套研究輔助技能組,覆蓋從模糊方向到論文發表的全流程,並以 ICLR、ICML、NeurIPS 論文集訓練出可追溯的構思模式。

logo

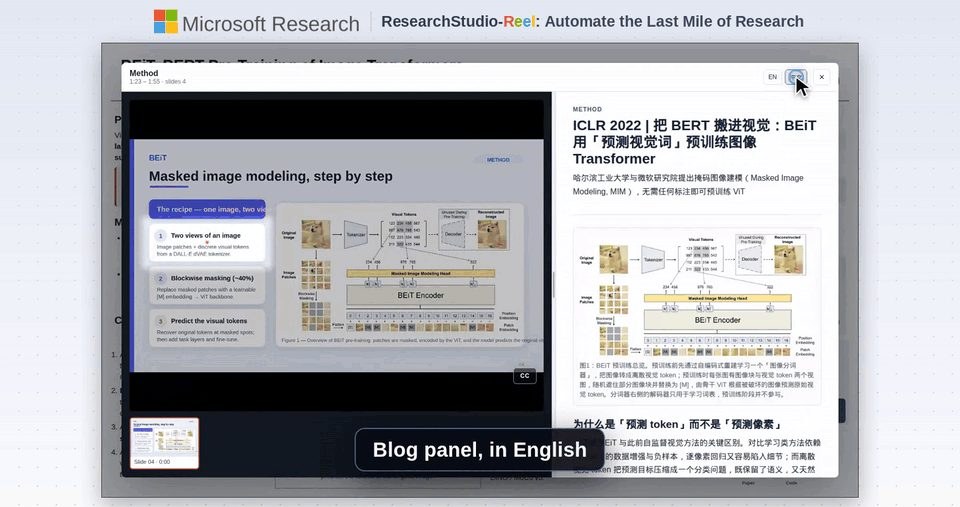
ResearchStudio 的核心任務是把大型語言模型(Large Language Model, LLM)變成研究流程中的協作角色,從構思、文獻搜尋到成稿後的展示素材皆涵蓋在內。它由兩個互補的子項目組成:ResearchStudio-Idea 處理「論文前」階段,協助將尚未成形的研究方向轉化為可辯護的構想;ResearchStudio-Reel 則處理「論文後」階段,把已完成的 PDF 轉成海報、旁白影片、雙語部落格文章及互動式摘要頁面。

傳統的 LLM 輔助構思多半只停留在「生成候選題目」這一層,研究人員仍須自行補上文獻脈絡、辨識瓶頸、區隔既有方案並評估風險。ResearchStudio-Idea 對此提出的修正做法,是從 2021 至 2025 年間 ICLR、ICML、NeurIPS 共 1,947 篇論文中歸納出 31 個反覆出現的構思子模式,再收斂成 15 個可重用的構思模式(ideation patterns),每張模式卡都附帶研究脈絡、瓶頸類型、差異化策略、支援先例與常見失敗模式。這樣的設計讓 IdeaSpark 能以「證據整備度評估 → 脈絡重建 → 瓶頸辨識 → 模式選擇 → 候選生成 → 衝突檢索 → 結果導向稽核」七個步驟,把抽象模式轉化為可追溯的研究提案。

套件內另外兩個獨立技能 Paper-Search 與 Scoop-Check 分別負責多源文獻搜尋與新穎性碰撞檢查,讓構思過程中對「現有方法如何做」與「作者為何不同」這類對比能即時取得佐證。和坊間通用寫作助手相比,ResearchStudio 的差異在於把會議投稿結果(包含口頭報告、高引用子集與被拒稿件)當作訓練素材,使生成的構想能對照真實的審稿標準。技能以 Claude Code 與 Codex 為執行環境,透過 install.sh 即可建立符號連結並完成環境配置。

適合的對象包括需要快速整理文獻的研究生、準備投稿 ML 會議的團隊,以及希望把既有論文包裝成海報或短片的學術機構。對會議投稿文化熟悉的讀者會更容易判斷模式卡的適用邊界;而非 ML 領域的使用者則可借鏡其「以證據為基礎的構思流程」這套方法論。兩篇 arXiv 論文(Idea: 2607.04439、Reel: 2607.04438)分別詳述技術細節與評估方式,值得在採用前先行閱讀。

重點摘要:

  • 全流程覆蓋:從模糊研究方向到論文發表後素材生成,由 Idea 與 Reel 兩個子項目分工處理。
  • 基於會議資料的模式庫:以 1,947 篇 ICLR、ICML、NeurIPS 論文歸納出 15 個可重用的構思模式。
  • 可追溯的構思步驟:七階段工作流程將抽象模式轉為具備文獻佐證的研究提案。
  • 獨立技能模組化:Paper-Search 與 Scoop-Check 可單獨用於文獻搜尋與新穎性檢查。
  • 依賴 Claude Code 與 Codex:需在這兩種 AI 編碼環境中執行,門檻偏向熟悉 LLM 工具鏈的研究者。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 微軟, 框架, Dataset 數據集

OpenMontage:AI 代理拍片流程

OpenMontage 想把 AI coding assistant 變成自動化影片製作流程。它重點不只生圖做片,亦會搜集真實動態素材再完成剪輯。

OpenMontage

OpenMontage 是一個開源、Agentic 的影片製作工具型項目。它的核心任務是把研究、寫稿、素材生成、片段檢索、剪輯到輸出成片串成同一條流程,讓 AI coding assistant 代為協調整個製作過程。

這個項目最值得留意的地方,在於它不把「幾張靜態圖加動畫」當成影片的唯一做法。它亦會從免費 stock footage 與公開影像檔案建立 corpus,抽取真正的 motion clips,再放入時間線完成合成,取向上比純 txt2img 或 image-to-video 工具更接近剪輯工作流。

部署理解上,現有資料顯示它依賴 FFmpeg,以及 Claude Code、Cursor、Copilot、Windsurf、Codex 這類 AI coding assistant。換句話說,它不像一般單一網頁服務,更像一套由代理驅動的製片管線;測試時較合理的方式,是先用簡單 prompt 驗證腳本規劃、素材來源、成本預估,再觀察最後能否穩定輸出可看的 timeline 與成片。

  • 定位清晰:多個生成與剪輯步驟接駁起來的工作流工具。
  • 差異明顯:支援真實影片片段檢索與編排,不只依賴靜態圖轉影片。
  • 適合情境:內容創作者、小型 marketing 團隊、需要快速做樣片的創意項目會較受惠。
  • 取捨存在:自由度高,但效果會受可用模型、素材來源與代理穩定性影響。

它可保留參考影片的節奏、hook style、結構與 tone,同時改動主題、畫面處理、切入角度與旁白方式,亦會在素材生成前估算目標片長成本。性能數字與正式 benchmark 暫未見完整公開,因此現階段較適合視為早期但方向鮮明的製片自動化項目;相關模型與服務例子包括 Veo,以及配合 AI coding assistant 與 Remotion、FFmpeg 一類組件完成輸出。

GitHub

Categories: 開源, Agentic, 微軟, Video, Image, txt2img, Content Creator, IDE, Anthropic

微軟用殘差強化學習補強機械人 VLA

這是一個提升機械人操控穩定性的研究方法。它用模擬訓練的殘差策略,零樣本補強真實世界的 VLA 表現。

Og image

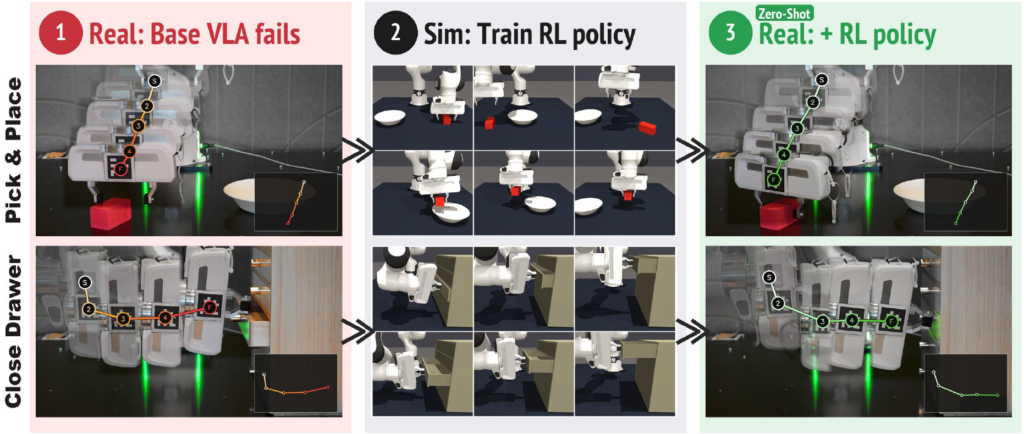
這是 Microsoft Research 的 Object-Centric Residual RL 方法。它的用途是為 Vision-Language-Action(VLA) 模型加入一層修正策略,減少機械人在真實操控中因細小誤差累積而失手的情況。

核心做法是把一個已凍結的 base VLA 保留不變,再額外疊加一個輕量 residual policy。這個 residual policy 完全在模擬環境訓練,輸入不是原始影像,而是 object-centric state、proprioception,以及 base VLA action,藉此避開常見的 visual sim-to-real gap,令策略可直接 zero-shot 轉移到真實機械人。

這個方法處理的是 imitation learning 常見的脆弱性:示範資料未覆蓋到的狀態一旦出現,誤差會一路放大。與直接微調 VLA、或在真實世界再做 reinforcement learning 相比,這個方法的差異在於只學「修正量」,而且訓練放在模擬中完成,成本與風險都較低。

  • 保留 frozen base VLA,不用重訓整個模型
  • residual policy 以物件中心狀態為主,減少依賴影像對齊
  • 目標是 zero-shot sim-to-real enhancement
  • 適合需要精準抓取、放置或接觸操作的機械人工作流

這類方法較適合關注 VLARobotic 與 sim-to-real transfer 的研究者和開發者。現有資料清楚交代方法方向與問題設定,但未提供完整安裝流程或操作步驟;評估部分可確認作者以真實機械人成功率改善作為重點,更多數值細節仍需參考原始論文。

項目主頁 · Paper

Categories: Agentic, AI productions, 視覺模型, 多模態模型, 微軟, Image, VLA, Robotic, 框架, 編程, 安全

Ponytail:幫 AI Agent 減少大量的程式碼

Ponytail 是給 AI Agent 用的規則型工具,重點不是炫技,而是逼模型先刪繁就簡。它特別適合想減少過度工程化的人。

Ponytail, the lazy senior dev

Ponytail 是一個針對 AI Agent 的工具型項目,核心作用不是取代模型,而是替模型加上一套固定判斷規則,令它在寫程式前先問自己:這段東西是否真的需要存在、標準函式庫能否處理、平台本身有沒有現成功能。它想解決的問題很直接,就是不少 AI Agent 會把簡單任務寫得太重,順手加框架、包裝層、額外抽象,最後程式碼變多、回應變慢,成本也上升。

這個項目已相當成熟。它把「少寫不是偷懶,而是保留必要部分」變成一條清晰階梯:先跳過不需要的東西,再優先用 stdlib、原生平台功能、已安裝依賴,最後才自己寫最少可行實作。這種設計對 AI Agent 特別有效,因為模型常見問題不是完全不懂,而是太願意補很多你未必需要的東西。Ponytail 等於把資深工程師那種「先刪再寫」的習慣,包成可重複套用的規則。

如果你想試它,先找幾類容易被模型寫得過火的小任務,例如日期輸入、debounce、rate limiter、簡單驗證或 CSV 處理。倉庫資料顯示,它支援 Claude Code、Codex、GitHub Copilot CLI、Gemini CLI、OpenCode、OpenClaw 等多種環境,亦即它不是綁死單一平台,而是瞄準「那些 AI Agent」的日常編碼流程。對於經常要用 Agent 產生前端小功能、工具腳本、日常後端邏輯的人,這類規則比再換一個新模型更實際。

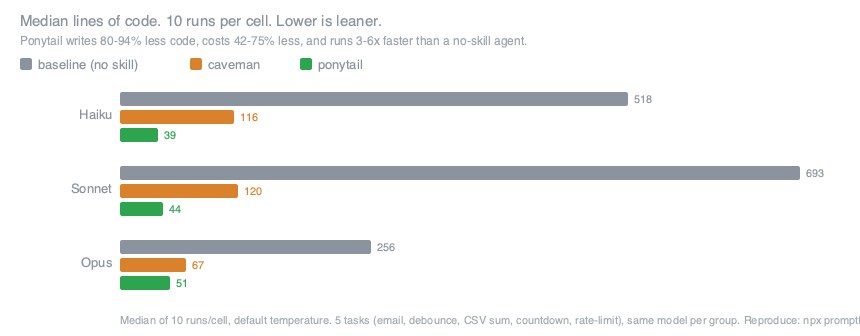
在 Claude API 的基準測試中,官方列出每項任務程式碼可減少 80% 至 94%,延遲快 3 至 6 倍,成本下降 42% 至 75%。不過這些結果有清楚前提,只能代表特定模型與提示方式下的中位數表現,並非所有模型都一定受惠;倉庫亦明言像 GPT-5.5 這類較簡潔的推理模型,規則注入與思考步驟本身可能抵消節省效果。這種寫法反而增加可信度,因為它沒有把 benchmark 包裝成放諸四海皆準的勝利宣言。

  • 重點不是生成更多程式,而是限制 AI Agent 只寫任務真正需要的部分
  • 支援多個 Agent 宿主,包括 Claude Code、Codex、Gemini CLI、OpenClaw 等
  • 提供 /ponytail-review/ponytail-audit/ponytail-debt 等指令,方便檢查過度工程化
  • benchmark 數據亮眼,但倉庫已提醒不同模型、提示長度與回合數會影響結果
  • 適合經常叫 AI Agent 寫工具碼、介面小功能、重複邏輯的人

Ponytail 的創新在於它把工程判斷流程產品化,讓 AI Agent 先經過一道「有沒有更省、更原生、更少依賴」的篩選。這令它比較像一個行為約束層,而不是新模型或框架。相關模型與環境方面,倉庫內容直接提到 Claude 的 Haiku、Sonnet、Opus,也提到 GPT-5.5,並覆蓋 Codex、Gemini CLI、Antigravity CLI、GitHub Copilot CLI 等代理工具鏈。若你想要的不是更花巧的生成能力,而是更穩定地避免 AI Agent 過度設計,這個項目有很明確的價值;若你的工作本身需要大量自訂架構與長鏈依賴,它未必會永遠選出你最喜歡的答案,但至少會迫使模型先證明「為何需要寫那麼多」。

GitHub: https://github.com/DietrichGebert/ponytail

Categories: 開源, Agentic, AI productions, 模型, 微軟, OpenAI, Gemini, API, 框架, 工具, IDE, , OpenClaw, Anthropic, Skill 技能

WeaveBench:測試 CUA 真本事的基準

WeaveBench 不只是題庫,而是專門檢驗 Computer-use agents 能否跨 GUI 與 CLI 完成長流程工作的基準項目。

Click to watch: an agent managing a RabbitMQ dead-letter-queue topology end-to-end

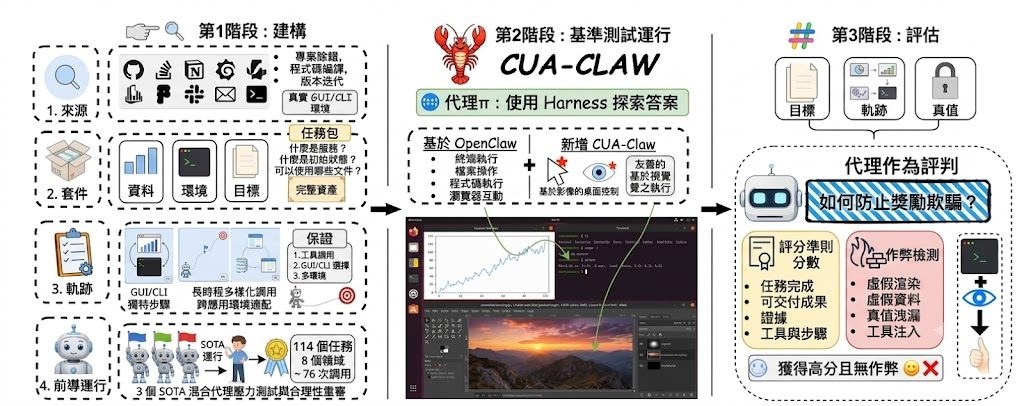
WeaveBench 是一個 benchmark 基準項目,聚焦測試 Computer-use agents(CUAs)在真實桌面環境中,能否把 GUI 點擊、shell 指令與程式碼編修串成同一條工作流程。它處理的不是單一步驟準確率,而是長流程、多介面協作這類更接近日常工作的問題。

這個項目的判分方式比常見的「有沒有生成某個檔案」嚴格得多。它使用 trajectory-aware Agent-as-Judge,會閱讀 chat trace、交付物,並按條款提供證據;論文亦指出,只看最終結果會高估代理表現,這點對研究 CUAs 的人很有參考價值。

如果想先了解它怎樣運作,可以先看離線 demo,直接觀察 score.json、judge model 回應和逐項證據,再決定是否下載完整資料集與 qcow2 執行環境。完整流程需要 Linux、KVM、Docker 及相當多記憶體與磁碟空間,較適合研究團隊、模型評測人員,或正在建構代理系統的工程師。

  • 114 個長流程任務,涵蓋 8 個工作領域
  • 每個任務都要求 GUI 與 CLI/code 交替操作
  • 最佳公開結果為 41.2% PassRate,顯示難度仍然很高
  • 提供 OSWorld hybrid-scoring experiment,可對照不同評分與執行框架
  • 資料集、runtime 與 qcow2 已放在 🤗 wanlilll/WeaveBench

相關模型與組合方面,公開結果包括 Claude Opus 4.7 + Claude Code、Claude Opus 4.7 + OpenClaw、GPT-5.5 + Codex CLI、GPT-5.5 + OpenClaw、GPT-5.4 + OpenClaw,以及 Gemini 3.1 Pro + OpenClaw。若你關心代理是否真的懂得跨介面完成工作,而不是只會在單一測試集刷分,這個項目很有研究價值。

GitHub: https://github.com/weavebench/WeaveBench

項目: https://weavebench.github.io/

Categories: 開源, 清華大學, 微軟, 框架

Lens:更慳算力的高質文字生圖

Lens 主打用較少訓練資源,做出接近大型文字生圖模型的效果。這個 GitHub 項目則提供最精簡的圖片生成功能。

Lens Teaser

Lens 是 Microsoft 推出的文字生成圖片模型,規模約 3.8B 參數,重點不只是畫質,還包括「用較少訓練成本做到接近甚至追上更大模型」。這個 GitHub 項目目前定位清晰,主要提供推論用途的最小程式碼,方便直接用現成 checkpoint 生成圖片。

動手方式很直接:準備好 Lens 的權重後,利用這個項目的推論程式輸入文字提示,便可生成圖像。它特別適合想快速試畫面風格、測試長提示詞效果,或者比較不同文字生圖模型輸出的人;若要完整訓練或微調流程,現有儲存庫資訊顯示並不是這個項目的重心。

它解決的核心問題,在於近年文字生圖模型愈做愈大,訓練成本高得驚人。Lens 嘗試從資料密度、模型結構和解析度學習方式入手,在較緊湊的 3.8B 規模下,仍保持不錯的提示理解、高解析度輸出,以及多種長寬比生成能力。

較值得留意的地方有幾個:它用長篇密集描述的圖文資料預訓練,配合 mixed-resolution learning,令模型一次學到更多內容;文字理解方面則結合 GPT-OSS 多層特徵與 FLUX.2 semantic VAE。官方亦提到有 Lens-Turbo 這類後續變體,主打 4-step 快速生成,另有 RL 調整版本用來改善畫質與壓低瑕疵。不過仍需要 A100/V100 GPU。

  • 3.8B 參數規模,定位是高效率文字生圖模型
  • 支援約 1:2 至 2:1 長寬比,最高可到 1440×1440
  • 相關模型包括 Lens、Lens-Turbo,以及經 RL 調整的變體
  • 官方論文指出 1024×1024 輸圖可達約 3.15 秒,Turbo 4-step 約 0.84 秒

整體來看,這個項目最吸引之處不是功能包山包海,而是把焦點放在「精簡推論」與「高效率模型設計」上。對研究生成式 AI 趨勢、想評估新一代文字生圖效率,或需要高解析度輸出的開發者與創作者來說,Lens 是一個值得留意的項目;不過涉及基準細節與全面比較時,仍建議一併參考論文與模型頁面。

GitHub: https://github.com/microsoft/Lens

Paper: https://arxiv.org/pdf/2605.21573

Categories: 開源, 模型, 微軟, 影像模型

VideoRLVR:教影片模型學會推理

這個項目把強化學習帶入影片推理訓練,重點是用可驗證獎勵提升解題能力。對想研究生成式影片與推理結合的人特別值得留意。

Repository image for luka-group/VideoRLVR

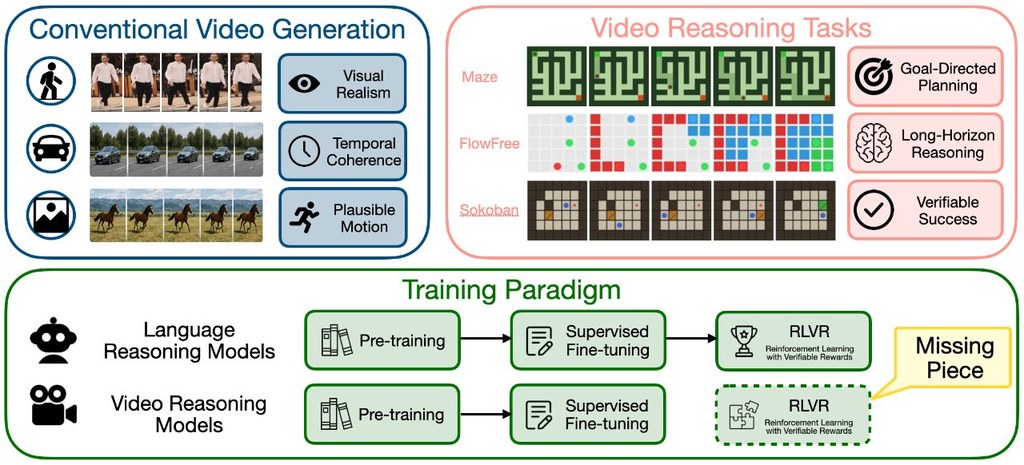
VideoRLVR 是一個用來訓練影片推理模型的項目,核心做法是把強化學習加入影片生成流程,並用「可驗證」的獎勵來判斷答案是否正確。簡單說,它不是只追求畫面像真,而是希望模型在生成影片時,連帶表現出可檢查的解題能力。

這個項目目前圍繞 Wan2.2-TI2V-5B 展開,並以 Maze、FlowFree、Sokoban 這類有明確規則的任務作為訓練與評估場景。這類設計的好處,是模型表現不只靠主觀觀感,而是可以透過任務成功與否來量度,對研究推理能力特別重要。

要理解這個項目,可先由它提供的資源入手:公開集合內有 SFT 與 RLVR 檢查點,也有訓練及測試資料。程式結構亦分開了訓練、推論與評估腳本,並提供多任務及單一任務版本,方便比較不同設定下的結果。

  • 重點放在可驗證獎勵,比只看主觀生成質素更易評估
  • 以 Wan2.2-TI2V-5B 為基礎,提供 SFT 與 RLVR 相關模型
  • 任務涵蓋 Maze、FlowFree、Sokoban,偏向規則清晰的推理測試
  • 已整理模型與資料集到 Hugging Face,查找資源較方便

這個項目的新意,在於把影片生成與可量化的推理訓練更緊密地結合,並且明確提供一套可重複的訓練配方。從 README 可見,它亦包含多任務訓練、純成功訊號版本,以及 OOD 推論與評估腳本,表示作者不只關心是否學會指定題目,也在意模型離開熟悉分佈後的表現。

適合留意這個項目的人,包括研究多模態模型、影片生成、強化學習,或想觀察模型如何在規則環境中表現推理能力的開發者。至於性能數字,這份儲存庫摘要未展示完整量化結果,因此較穩妥的看法是:它的價值目前更偏向研究方法、訓練流程與公開資源,而不是單靠一兩個分數定勝負。

GitHub: https://github.com/luka-group/VideoRLVR

Paper: https://arxiv.org/pdf/2605.15458

Categories: 開源, 視覺模型, 微軟, 深度學習

Page 2 of 3
1 2 3