KeyFrame-Compass:關鍵幀尺度評測

想知道影片生成有沒有跟住關鍵畫面,KeyFrame-Compass 就把這個矛盾拆開量度。它同時看畫面有沒有到位、順序有沒有跟足,還會檢查整體影片質感。

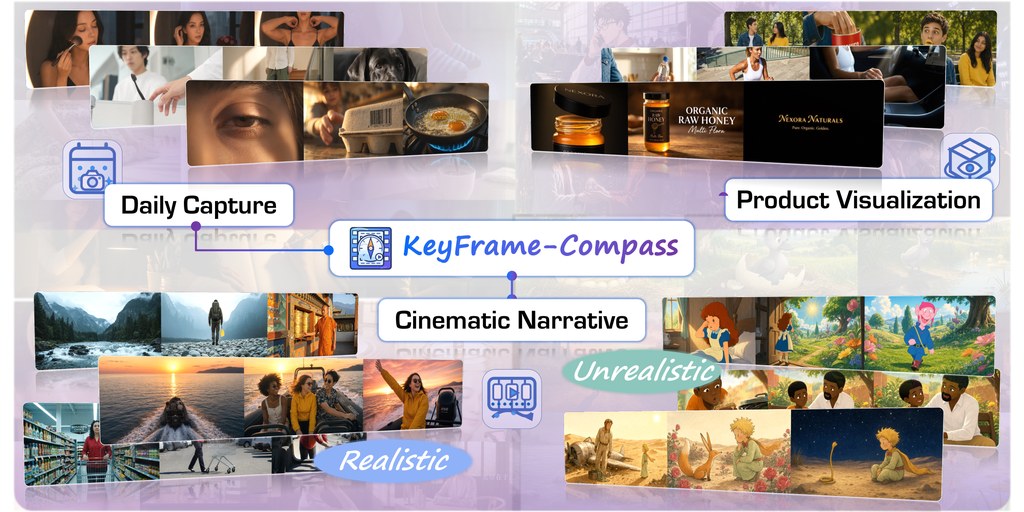
KeyFrame-Compass benchmark domains and examples

KeyFrame-Compass 是一個用來評測 keyframe-conditioned video generation 的基準項目,重點在於檢查模型能否同時跟住文字提示同一組按順序排列的 keyframes 生成影片。對做影片生成的人來說,這類測試最有價值的地方,是它不只看成片好不好看,還會追問畫面有沒有真係按要求出現、順序有沒有走樣。

這個項目把評測拆成兩層:一層看 keyframe execution,包括關鍵畫面存在、視覺還原、時間順序、定位、持續性同回應唯一性;另一層看 overall video quality,會用 evidence-grounded MLLM(Multimodal Large Language Model, MLLM)判斷,加上專門的感知模型去量度視覺質素、時間連貫性、指令遵從同音訊表現。這種分法比單純比對整體分數更清楚,因為它能分辨出模型係「畫得靚」定「跟得準」。

官方提供 386 個案例,涵蓋三個應用領域,亦分有 multi-shot 同 one-take 片段,配合四種 keyframe 密度。安裝上需要 Linux、Conda 或 Mamba、NVIDIA GPU,同埋可用的 VLM API;倉庫亦提供 envs、assets 同 all 三種設定模式,方便只建環境、只拉資產,或者一次過做完整驗證。

  • 把影片生成的「跟畫面」同「成片質感」分開量度,結果較容易解讀
  • 支援不同 keyframe 密度,較適合比較模型對控制力的穩定度
  • 適合做影片生成模型、研究原型或產品 demo 的質量驗證
  • 需要 GPU 同外部 VLM API,部署門檻唔算低
  • 相關模型類別可歸到 Video、視覺模型、多模態模型、模型、工具
GitHub

Categories: 開源, 模型, 視覺模型, 多模態模型, 視頻模型, NVIDIA, Gemini, API, Video, 工具, Linux

MultiRef-Compass:多模態影片不再各自為政

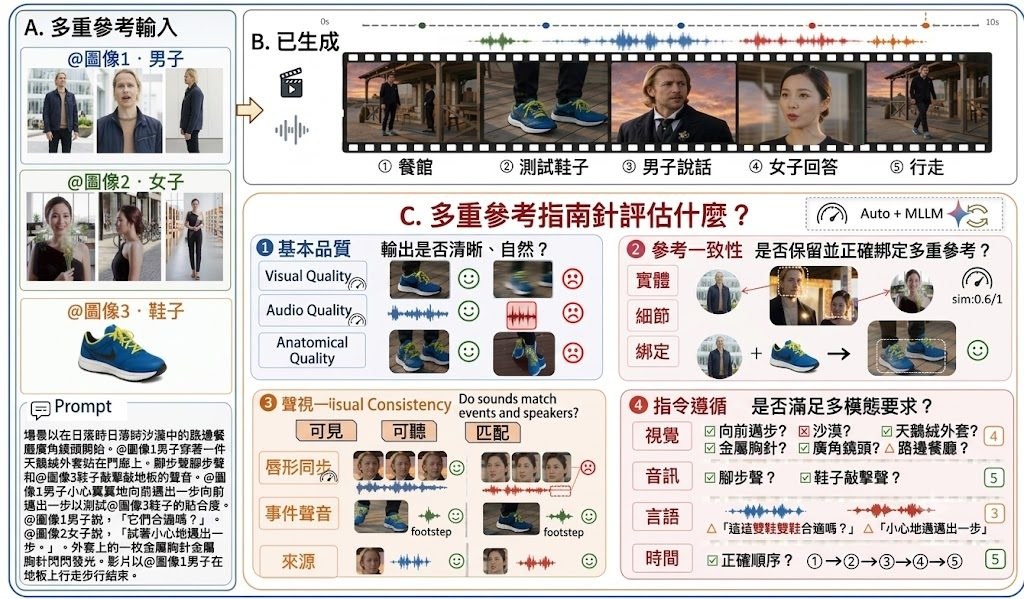
做多模態影片生成,最難往往唔係出片,而係點樣公平比較結果。MultiRef-Compass 把文字、影像參考同音訊參考放入同一套評測流程。

MultiRef-Compass overview

同一段生成影片,畫面可能順眼、聲畫卻唔對位;角色外觀接近參考圖,指令跟從又未必準。MultiRef-Compass 抓住呢種常見落差,定位成一個開源評測工具包,處理 multi-reference multimodal video generation 的比較問題,重點唔係逐條片人手睇,而係用可重現的方法把不同模型放到同一把尺上量度。

它的取向相當明確:偏向研究比較,而唔係臨時檢查作品。項目用固定的 CSV 輸入欄位,接收文字、視覺參考、音訊參考同生成影片,再輸出 per_sample.csv、model_summary.csv、ranking.md 同 details.json。這種設計的好處,是團隊可以用同一批樣本反覆測不同模型;代價是流程較講究資料整理,較適合已有實驗管線的人。

跟只看單一分數的做法相比,MultiRef-Compass 把結果拆成四組共 14 個公開指標,包括 Basic Quality、Entity Fidelity、Audio-Video Consistency 同 Instruction Following。它同時混合 classical media-analysis pipelines、learned quality models、speaker embeddings,以及 multimodal language model judges,所以看到的不只是整體高低,仲會知道問題出在 anatomy、reference fidelity、voice timbre similarity,定係 temporal order。

  • 用統一 schema 比較不同影片生成模型,較容易做橫向排名
  • 保留 sample-level diagnosis,同時支援 model-level ranking
  • 支援 text、visual-reference、audio-reference 三種條件一齊評測
  • 著重公開 metric taxonomy,同類研究較易重現結果

現有資訊未見到完整安裝細節,但理解方式已很清楚:先準備符合欄位要求的 CSV manifest,再按指標群組跑評測後端。受益最大的,會是做多模態影片生成、聲畫對齊、角色一致性與指令跟從研究的團隊。相關能力圍繞 Visual Quality、Audio Quality、Entity Fidelity、Speech-Lip Synchronization、Voice Timbre Similarity 等指標展開;它未必幫你直接提升模型質素,卻能先把模型到底差在哪一環講清楚。

GitHub · 模型

Categories: 開源, Embedding, 多模態模型, 視頻模型, Video, Audio, 語音

Kimi K3 把開源大模型推到 3T 級別

想要一個同時處理寫碼、長文件同推理工作的模型,Kimi K3值得留意。它未追平最強閉源模型,但已把開源模型的上限再推高一截。

Kimi K3 hero visual

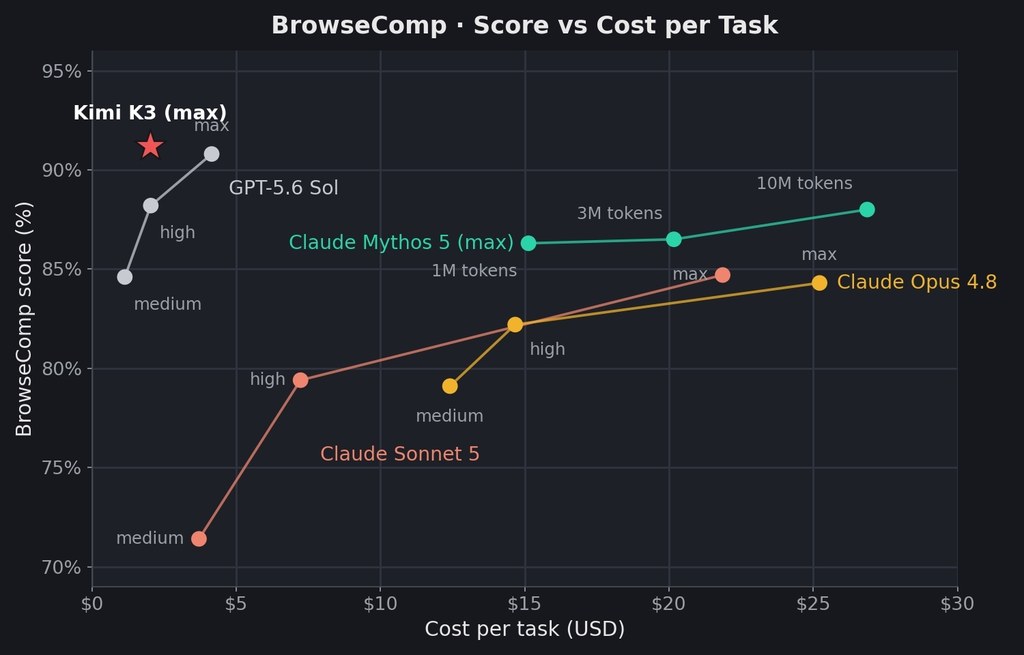
長上下文、程式開發同知識工作往往要分開交畀不同模型處理,Kimi K3嘗試把這幾件事收在同一個開放模型內。它屬於大型多模態模型,重點是處理長流程 coding、長篇資料閱讀與推理之間的切換成本,並提供原生 vision 能力與 1M context。

Kimi K3 的定位,不是單靠參數規模取勝,而是想在開源路線上逼近 frontier intelligence。資料提到它有 2.8T parameters,屬於首個 open 3T-class model,整體表現仍落後於 Claude Fable 5 和 GPT 5.6 Sol,但在自家 evaluation suite 內已持續超過其他被測模型,顯示它在開源陣營有明顯競爭力。

技術上,這個模型建基於 Kimi Delta Attention(KDA)同 Attention Residuals(AttnRes),目的是改善資訊在長序列與深層網絡中的流動方式;同時也擴大了 Mixture of Experts(MoE)sparsity。這種做法反映它要處理的核心矛盾:一邊維持超長 context 與多類任務能力,一邊控制推理與訓練效率。

  • 首個 open 3T-class model,規模達 2.8T parameters
  • 原生支援 vision,並提供 1M context window
  • 目標場景包括 long-horizon coding、knowledge work 同 reasoning
  • 採用 Kimi Delta Attention(KDA)、Attention Residuals(AttnRes)與 Mixture of Experts(MoE)
  • 已在 Kimi.com、Kimi Work、Kimi Code 同 Kimi API 提供使用

對開發者、研究者同需要長文檔工作流的人來說,Kimi K3最有吸引力的地方,在於它把「夠長、夠廣、夠開放」放在同一個項目裡。現階段可確認的限制也很清楚:它未到最強閉源模型的水平,而完整權重、架構與訓練細節仍要等後續 technical report 與正式釋出。

項目主頁

Categories: 開源, Agentic, 多模態模型, API, Vibe Coding, 教學, 線上服務, IDE, Mac, 編程, OpenClaw

Self-in-Space 補上無人機空間理解盲點

無人機睇得見環境,未必真正理解自己點樣移動。Self-in-Space把評測、數據同模型放埋一齊,專門拆解呢個落差。

Teaser

講無人機視覺理解,很多方法集中在環境辨識或任務完成,但較少正面處理飛行器本身的狀態感知。Self-in-Space屬於研究型基準測試、訓練數據集與模型組合項目,核心是把 UAV 的 spatial cognition 與 self-awareness 分開檢查,看看模型是否不只「見到空間」,亦知道自己在場景中如何移動。

作者明確批評現有 UAV-oriented MLLMs 普遍偏向 environment-centered、task-oriented 範式:重視周圍有什麼,較少處理自身運動如何影響理解。為此,他們提出 SIS-Bench、SIS-Motion-54K 與 SIS-Motion,重新把 aerial understanding 拆成 perception、memory、reasoning 三層,再同時覆蓋空間與自我兩條軸線,令問題定義比一般影片問答 benchmark 更貼近 embodied UAV 場景。

SIS-Bench 包含 1,646 段真實 UAV 影片與 4,856 組 QA,覆蓋 13 個任務;團隊用它測試 26 個 video MLLMs,包括 6 個 proprietary models 與 20 個 open-source models。結果指出兩個穩定現象:模型對 self 的建模弱過 space,而且能力會由 perception 走到 memory、再到 reasoning 時逐步下跌,這個診斷比單看整體分數更有參考價值。

  • 結合 benchmark、training dataset 與 motion-aware model,不是單一模型發佈
  • 直接針對 UAV embodied intelligence 的 self-awareness 缺口
  • 評測設計有清楚分層,方便看出模型在哪一段開始失準
  • SIS-Motion 嘗試用 motion-aware representation 改善 aerial video understanding
  • 已公開 SIS-Bench 與 SIS-Motion-54K,可在 Hugging Face 或 ModelScope 了解內容

這項目的受眾很清楚:做 UAV 視覺、aerial video understanding、embodied AI、video MLLMs 評測的人,都會較容易用得着。現階段它更像研究與比較基礎設施,而不是即裝即用產品;想部署測試,較合理做法是先從 SIS-Bench 驗證現有模型在 self-awareness 與 spatial reasoning 的表現,再看 SIS-Motion 是否能為下游 UAV navigation tasks 帶來可轉移的增益。相關模型與資源以 SIS-Motion、SIS-Bench、SIS-Motion-54K 為主,並且對照了多個 video MLLMs 的表現。

項目主頁 · GitHub · 模型

Categories: 開源, 清華大學, 字節跳動, 多模態模型, 模型訓練, Qwen, Gemini, Video, Dataset 數據集

awesome-Self-Improving-Agents:拆解自我改進 Agent 地圖

想追蹤 self-improving agents 點樣由概念走到方法,呢個整理庫比單看論文更省時間。它把分散做法收成一張可導航地圖,方便快速判斷研究路線。

Main figure of the survey

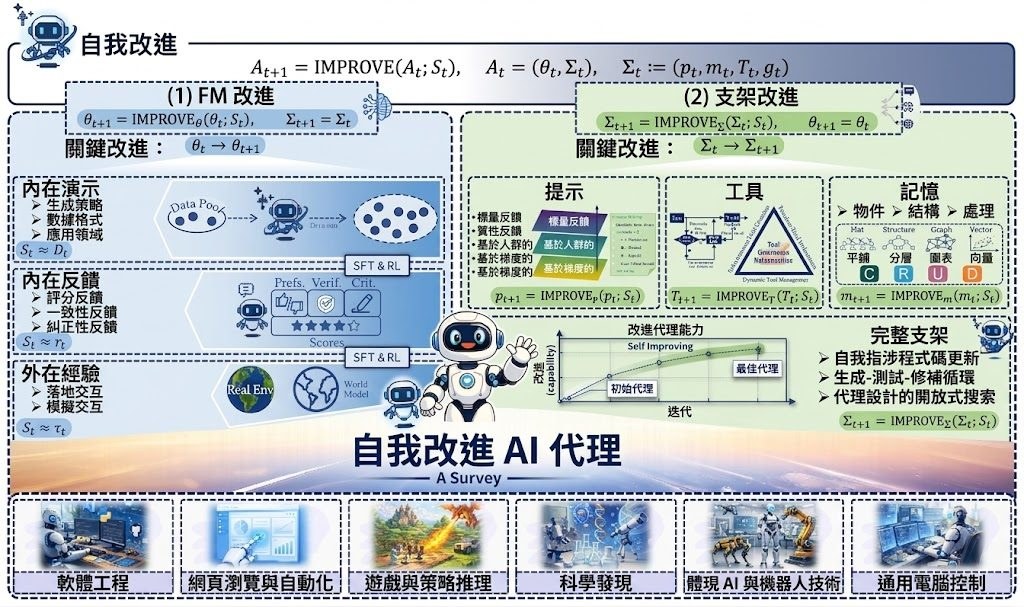
當大家都在談 Agent 會否愈跑愈聰明,真正麻煩的往往不是資料太少,而是做法太散、名詞太多、更新位置又不一樣。awesome-Self-Improving-Agents 把這件事整理成一個論文地圖型資源庫,核心不是教你直接部署系統,而是幫你分清楚 self-improving agentic systems 究竟在改進模型本身,還是在改進 prompt、memory、tools 與 control logic 這些外圍 scaffolds。

現有討論常把各類自我改進方法混在一起看,作者則用一條很實際的分界重組內容:一邊是 Foundation Model Improvement,另一邊是 Scaffolding Improvement。這個切法的好處,是你很快知道某篇工作追求的是更持久但較重的參數更新,還是較快、較平、亦較容易回退的代理層更新,閱讀時不會把 LoRA、工具路由、記憶結構調整當成同一類問題。

它不是可即裝即跑的軟件工具,更像研究與產品規劃都用得著的索引庫。你可以直接從 GitHub README、survey hub 同 arXiv 論文交叉閱讀;要測試這個項目的價值,最直接的方法是按 taxonomy 揀一條路,例如 Intrinsic Generative Demonstrations、Intrinsic Evaluative Feedback,或者 memory、tool refinement、full scaffolding,看看它能否幫你更快找到代表性工作與相近分支。

  • 把 self-improvement 分成 Foundation Model Improvement 與 Scaffolding Improvement 兩大路線
  • 收錄 239 篇 papers,當中 73 篇屬 FM improvement,166 篇屬 scaffolding improvement
  • 細分到 Intrinsic Generative Demonstrations、Intrinsic Evaluative Feedback、dynamic tool routing、autonomous tool creation 等機制
  • 適合研究員、Agent 產品團隊、技術寫作者整理文獻脈絡與比較方法取向

相關模型與系統脈絡圍繞 Foundation-Model-Based Agents 展開,但這個項目本身不提供單一模型權重或 benchmark 分數,也不是 OSWorld 那類直接跑任務的評測框架。它的價值在於建立閱讀順序與判斷框架;想找可落地的 agent 改進方向,這份 curated map 比單篇 survey 更接近工作清單。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, 模型, 多模態模型, Meta, Dataset 數據集

EgoMemo 讓助手懂得幾時先開口

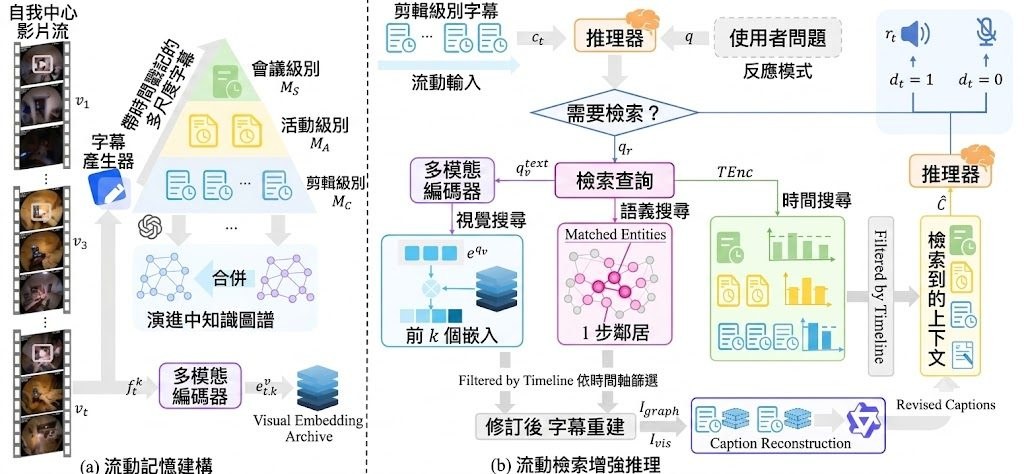
唔少助手識回應,真正難的是判斷應否打擾你。EgoMemo把連續第一身影片整理成可檢索記憶,嘗試把主動提醒變成可評測的能力。

Repository image for SitongGong/EgoMemo

助手最難處理的,不是看見了甚麼,而是判斷幾時該出聲、幾時應該保持安靜。EgoMemo對準的正是這個空位:它屬於一個面向連續第一身影片的記憶增強代理系統,同時附上 benchmark,目標是讓系統根據累積情境主動提供服務,而不只是等人發問或對每個事件都作反應。

現有做法多數落在兩個範式:reactive,只會被問到先答;semi-proactive,偵測到預先定義事件就回應。作者認為這兩類方法都欠缺對使用者歷史、當前活動與介入時機的判斷,所以用 EgoServe 重新定義問題,把主動協助視為 context-dependent decision problem,再由 EgoMemo用 three-level temporal memory graph、semantic knowledge graph 同 visual embedding archives 做 retrieval-augmented reasoning。

這個 GitHub 項目不止放出模型思路,亦包含 memory-graph construction + retrieval pipeline、evaluation suite、dataset annotation 與 streaming demo。理解部署方式並不複雜:先準備 Python 3.10 環境與 .env 內的 API keys、資料路徑,再下載 EgoServe 註釋及對應來源影片,之後按不同資料集分開執行 processing 與 retrieval 兩階段,前者建立記憶圖,後者生成 proactive-service response。

  • EgoServe 收錄超過 3,000 個 service instances,橫跨 4 個 temporal memory horizons 與 10 類服務
  • EgoMemo 採用 training-free 設計,重點放在記憶組織與檢索,而不是再訓練一個大模型
  • 項目同時支援 EgoLife、HoloAssist、CaptainCook4D、EyeWo / ESTP-Bench、OVO-Bench 等資料來源
  • retrieval 可切換 caption retrieval、visual retrieval 等設定,方便做 ablation

EgoMemo 不是追求單次問答表現,而是補上長時間情境累積後的判斷能力。受益最大的是做 egocentric AI、智能助理、穿戴式裝置或多模態 Agentic 項目的研究團隊;限制也同樣直接,整個流程依賴外部影片資料、API keys 與多階段處理,重點更接近研究基線與評測框架,而未算一個即裝即用的消費級產品。相關模型與組件方面,儲存庫示例已出現 QwenVL 3 8B Instruct、GPT-5、Gemini 等作為 caption 或 response 端選項。

項目主頁 · GitHub · Paper

Categories: 開源, Agentic, Embedding, 多模態模型, 模型訓練, OpenAI, Gemini, API, KnowledgeGraph, Python, Dataset 數據集

Hallo4D 點樣補救 3D 與 4D 生成穿崩

3D同4D生成最怕畫面一轉角度就走樣,或者動起來之後角色忽然變臉。Hallo4D想處理的,正正是這類跨視角、跨時間都難收拾的失真。

4d boy

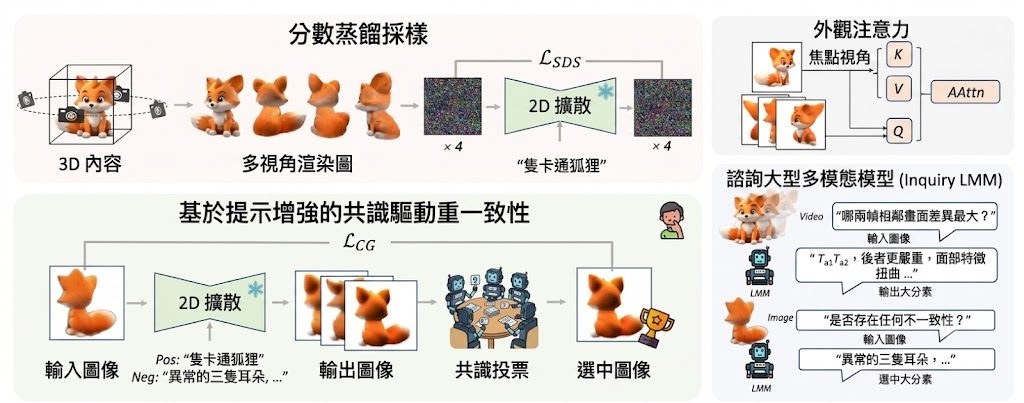
做3D同4D內容生成,最麻煩往往唔係單張畫面唔夠靚,而係鏡頭一轉、時間一推進,物件結構開始重複、錯位,角色仲會出現 jitter、identity flicker 同 structural drift。Hallo4D沿住呢個痛點出發,屬於一個研究型框架,重點唔係再訓練新模型,而係插入現有流程,幫3D與4D生成結果找出並修正時空不一致。

而家常見做法多數仍然依賴 2D diffusion-based supervision,但欠缺直接約束幾何一致性的機制,所以會出現 duplicated structures 同 misaligned geometry;去到4D,問題再擴大到時間軸。Hallo4D提出的是 generation-detection-correction 範式:先生成,再用 Large Multimodal Models(LMMs)從 multi-view、multi-frame renderings 判斷邊度出錯,之後以 image-space consistency optimization 做修正,並用 multi-model voting 揀較穩定的候選結果。

它不是跟同類方法鬥基礎生成能力,而是做一層 tuning-free、model-agnostic 的補救機制,聲稱毋須 retraining 或 architectural modification。代價亦很明顯,整個流程更依賴外部 LMM 推理、候選修正與投票判斷,較像高質後處理,而唔係最省算力的路線。

  • 重點放在 spatio-temporal hallucination mitigation,不是直接取代原有 3D / 4D 生成模型
  • 用 LMMs 檢查多視角、多幀輸出,再引導修正不一致位置
  • 針對時間穩定性加入 optical flow 驅動的 keyframe sampling
  • 以 CSEA、log-dynamic-range loss 同 union-of-frusta visibility pruning 處理曝光崩壞

目前較適合當作研究方法理解,而不是即開即用的產品工具。測試方式大致應是把它接到既有 Text-to-3D、Image-to-3D 或 4D pipeline,對比 baseline 與修正後結果,觀察多視角幾何、角色身份穩定度同曝光控制有無改善;頁面亦提供多組 visual comparisons,以及在 SV4D 的額外 4D 場景結果。

十分適合本身已經在做 3D / 4D 生成、又經常被跨視角穿崩同時序閃爍拖慢流程的研究團隊。相關脈絡亦值得一併看:Hallo3D主攻 multi-view-consistent 3D generation,Hallo4D則把範圍擴展到統一處理 3D + 4D 的時空一致性;量化表現,現有儲存庫文字未見完整指標表,判斷仍要以論文與項目頁面的可視化對比為主。

項目主頁 · GitHub · Paper

Categories: 開源, 多模態模型, Image, 3D, 中國, Dataset 數據集, 任何模型

MonkeyOCRv2 文件通用 OCR 底座

掃描文件、表格、公式到場景文字,往往要分開處理。MonkeyOCRv2想做的是用同一套視覺編碼器,接住多語言文件理解與 OCR 工作流。

overview

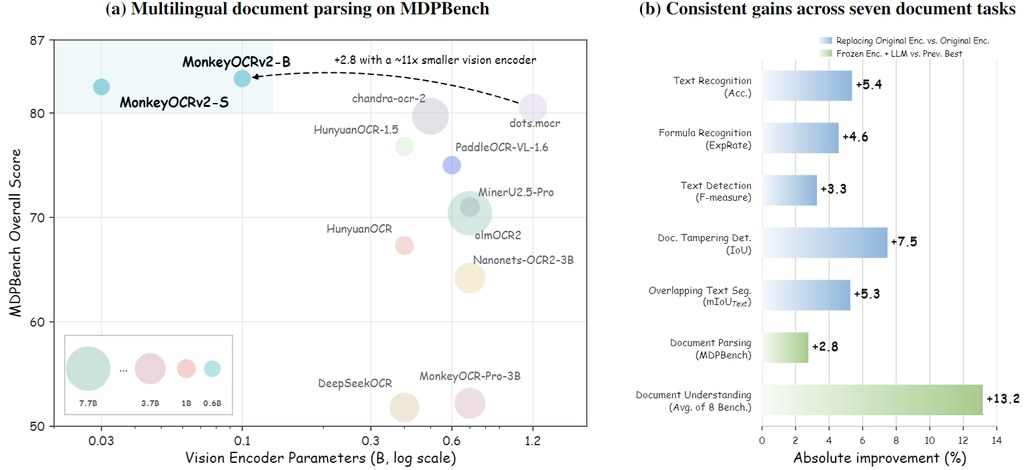
文件 AI 最麻煩的地方,在於文字辨識、版面解析、文件理解、公式辨識,甚至竄改檢測,很多時都要拆成幾個模型串起來。MonkeyOCRv2 把自己放在視覺文字基礎模型的位置,核心不是只追單一 OCR 指標,而是想用同一個 encoder 同時覆蓋多語言文件 parsing、understanding、text recognition、formula recognition 以至 scene text detection。

它採取的路線很明確:不像部分做法會按任務各自訓練小模型,MonkeyOCRv2 強調 fine-grained text modeling、cross-task representation learning 同 cross-lingual generalization,等於先把「文字作為視覺內容」這件事學得更深,再把能力分流到不同文件任務。這種取向的好處,是同一套底座較適合研究團隊或產品團隊整合工作流;代價則是現有資訊仍以模型發布為主,完整效能對比與部署細節還要結合論文與 checkpoint 再判斷。

現階段最值得留意的,是項目已不只放出單一模型名稱,而是分成幾條較清晰的能力線。 MonkeyOCRv2 vision encoder,以及面向 multilingual document parsing 的 MonkeyOCRv2-Parsing、面向 efficient document understanding 的 MonkeyOCRv2-Und,並提供 Hugging Face 與 ModelScope checkpoint,代表測試方式大致會圍繞下載權重後,按任務接入 parsing、recognition 或 understanding 流程,而不是單純打開一個聊天介面就完成。

  • 涵蓋 OCR、文件理解、公式辨識、竄改檢測、重疊文字分割等多類任務
  • 提供 MonkeyOCRv2-S、MonkeyOCRv2-B、MonkeyOCRv2-AS,不同 backbone 對應不同場景
  • S、B 版本偏向 Recognition / Parsing / Understanding,AS 版本偏向 Detection / Segmentation
  • 已公開 Demo、Hugging Face 集合與 MonkeyDocv2 數據集線索,方便交叉驗證

從現有公開資訊看,這個項目較適合做 Document AI、智能審核、票據與表單處理,也適合想比較 dots.mocr、PaddleOCR-VL、Qwen3-VL 這類路線差異的人。它未必是最輕量的選擇,但「一個編碼器橫跨多任務與多語言」這個方向,對需要長期維護文件工作流的項目有相當吸引力。

GitHub · Paper

Categories: 開源, 模型, 多模態模型, Qwen, OpenAI, 影像處理, 框架, Medical醫學, Dataset 數據集

RINO 用圖像編輯統一視覺任務

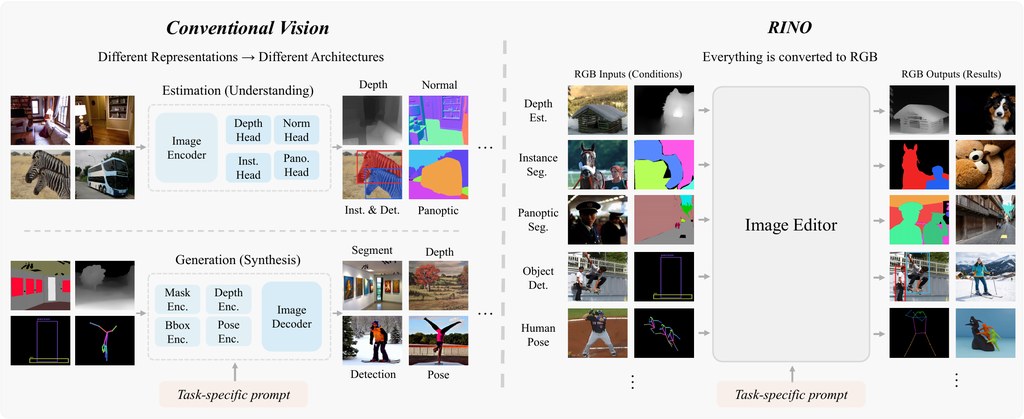
把深度、分割、姿態估計都改寫成 RGB 圖像輸入輸出,RINO 想驗證一個大膽方向:凍結式 image editor 能否直接兼任理解與生成。

RINO unifies vision under a single RGB interface: one frozen image editor, driven by a task-specific prompt, handles est

與其為每個視覺任務各自接駁 head、decoder 或 adapter,RINO 選擇更激進的路線:全部改寫成 RGB In, RGB Out。它屬於一個以 PyTorch 實作的研究型評測與實驗項目,核心問題是檢查單一凍結式 image editor,能否同時處理視覺理解與條件生成,而毋須為深度、segmentation、pose 之類任務另建模組。

這個定位帶來的吸引力很直接:流程統一、介面統一、後端也能互換。項目目前接上三個開源 image-edit 模型作為黑盒後端,包括 Qwen-Image-Edit、FireRed-Image-Edit 與 LongCat-Image-Edit;任務目錄結構一致,每個 task 都有獨立 evaluate 程式與 output 結果,方便逐項跑 benchmark,比起各任務各寫一套推理邏輯,整理與比較都省事得多。

但它的取捨同樣明顯。RINO 並沒有訓練新模型,也不做 fine-tuning,而是堅持用 released weights 直接測 zero-shot 表現;好處是比較乾淨,較能反映 image editor 本身的泛化能力,限制則是上限會被原生編輯模型綁住,對結構化輸出是否穩定、是否容易受 prompt 與渲染方式影響,仍要按任務逐個看。

  • 重點不是追求單一任務最佳成績,而是測試「同一個 RGB 介面」能否橫跨多類視覺工作
  • 三個後端可互換:Qwen-Image-Edit、FireRed-Image-Edit、LongCat-Image-Edit
  • 採用 copied official metric code 評分,數字理論上較容易與既有文獻對齊
  • 部署理解不複雜:安裝依賴後,按 task 準備 dataset,再選 BACKEND 與對應 MODEL 便可執行評測

較適合留意這個項目的,會是想研究 unified vision 介面、比較不同 image editor 泛化力,或者想把多個 benchmark 收攏到同一工作流的團隊。現有資訊未列出完整成績表,但它已清楚交代評測方法、資料夾規格與模型來源;作為研究驗證平台,價值在於提出一套可重覆比較的做法,而不是即刻取代每類任務的專用模型。

項目主頁 · GitHub

Categories: 開源, 模型, 多模態模型, 模型訓練, Qwen, Image, 影像處理, Python, Dataset 數據集

AMID 把醫學影像建模流程交畀代理協作

AMID唔係只幫你諗模型,而係想連驗證、提交物料同審計痕跡一併產出。你可以把它理解成面向醫學影像比賽與研究任務的自動化建模工作流。

AMID logo

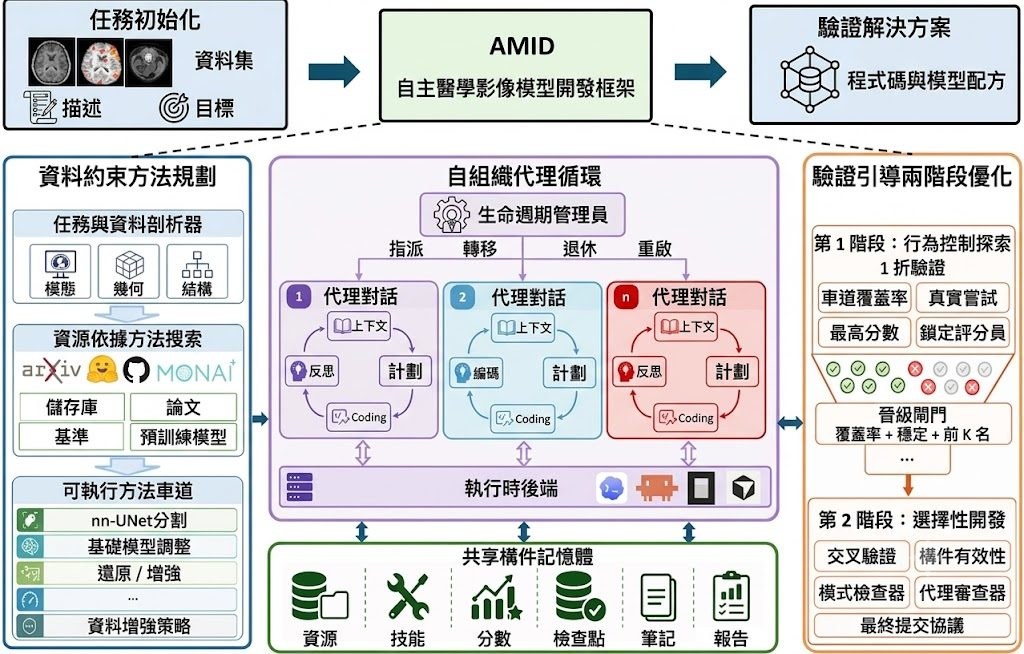
醫學影像建模最麻煩的位,往往唔係只係揀網絡,而係每個任務都有唔同資料形態、指標、切分規則同提交要求。AMID把呢個痛點拉到枱面:它屬於一個 autonomous multi-agent framework,目標唔係產生一段建議文字,而係交出可訓練、可推理、可驗證、可提交的完整模型產物。

現有通用 MLE agent 往往沿用比較粗略的搜尋與試錯範式,先提方案、再寫碼、再靠結果反覆修補;作者認為放到醫學影像場景,呢種做法容易忽略資料條件、驗證協議同提交格式。AMID改用 Data-Conditioned Method Planning,先按任務資料與可運行資源整理出可執行的 method lanes,再用 Verification-Guided Two-Stage Optimization 由早期廣泛探索,轉去後期集中追蹤有潛力路線,同時持續檢查 metric computation、validation protocol 同 prediction artifacts。

呢種取向的差異,在於它把「做得出分數」同「流程可核對」放埋一齊處理。對醫療 AI 團隊、挑戰賽參賽者,或者要同時管理 2D 影像、3D volumes、segmentation masks、class labels 等異質資料的人,AMID的吸引力在於減少人手串接流程的時間;代價是它目前仍以技術報告與任務解法報告為主,README亦寫明 source code 尚未釋出,暫時未到可以直接部署測試的階段。

效能方面,AMID用 ReX-MLE 的 20 個 medical imaging challenge tasks 做基準,比較對象包括一般用途 MLE systems,同時拿 human-designed challenge solutions 作參照。作者指出它整體表現優於被評測的通用系統,部分任務接近或追平人手設計方案;現階段較適合把它理解成一套清晰的方法論與工作流藍圖,而唔係即裝即跑的開源工具。

  • 核心定位係 autonomous multi-agent framework,處理醫學影像模型開發與驗證交付
  • 主要方法包括 Data-Conditioned Method Planning 同 Verification-Guided Two-Stage Optimization
  • 輸出唔止模型建議,仲包括 training code、inference code、weights、prediction files 同 audit trail
  • 基準測試來自 ReX-MLE 的 20 個任務,整體表現優於通用 MLE systems
  • 目前已公開 technical report 同 20 份 solution reports,source code 尚未發布

相關模型與系統脈絡方面,AMID直接對比的是 general-purpose MLE systems,同時以 human-designed challenge solutions 作為高水位參考。它未有把重點放在單一 backbone 或某個固定醫學影像模型,而是把多代理規劃、優化與驗證流程包成可重複的方法,呢點比單次調參工具更值得留意。

GitHub · Paper

Categories: 開源, 香港中文大學, Agentic, 多模態模型, 模型訓練, 微軟, Image, 影像處理, 框架, 香港, Medical醫學, 3D, Dataset 數據集

Page 18 of 29
1 … 16 17 18 19 20 … 29