BioMatrix 把生物序列與 3D 結構放進同一模型

BioMatrix 嘗試用同一個模型同時理解分子、蛋白質、3D結構與文字。它的重點不只是多模態,而是連生成方式都統一起來。

BioMatrix

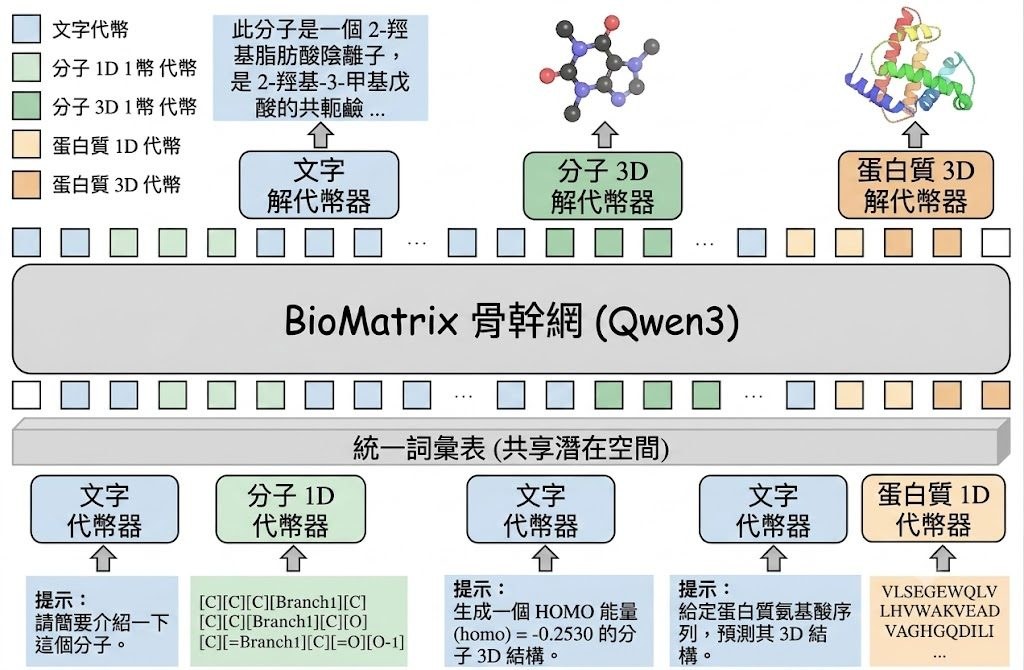
BioMatrix 是一個多模態 foundation model,建立在單一 decoder-only 架構之上。它要解決的問題,是把 molecules、proteins、1D sequences、3D structures 與自然語言放進同一套生成流程,令模型不只可讀取不同資料,也可用同一個 next-token prediction 目標處理與輸出它們。

現有 biological foundation models 通常分成兩類:一類可在共享目標下融合多模態,但多數只集中單一 entity type;另一類雖然覆蓋 molecules 與 proteins,卻常常欠缺顯式 structural modeling,或者依賴 adapter-based designs、external encoders、projection adapters 與 modality-specific output heads。BioMatrix 的取向很鮮明:直接把 SMILES、SELFIES、分子 3D、蛋白質序列、蛋白質 3D 同自然語言映射到 shared discrete token space,將「可讀」與「可生成」統一。

技術上,這個項目最值得留意的是 unified tokenization scheme。分子 3D 用改良版 MolStructTok,蛋白質 3D 用 GCP-VQVAE,並以 description-based embedding initialization 把新增 token 先對齊到 pretrained Qwen3 embedding space,再做 continual pretraining;這種做法比起後加模態接頭更完整,但訓練成本亦明顯更高,官方資料提到曾用 64 張 NVIDIA H100 GPUs 配合 LLaMA-Factory 訓練。

從 GitHub 與 Hugging Face 現有資訊看,這個項目較適合當作模型下載與研究評測基線使用,目前可找到 BioMatrix-1.7B-Base、BioMatrix-4B-Base、1.7B-SFT、4B-SFT 等版本。若你想測試,較合理的理解方式是先用已發佈模型做推理或任務比較,再按需要研究其 tokenizer,例如 MolStructTok 與 GCP-VQVAE;完整重訓對一般團隊門檻很高。

  • 模型定位:多模態 biological foundation model,不是單一分子模型或單一蛋白質模型
  • 核心差異:把 sequences、structures、language 放入同一 shared discrete vocabulary,而非靠外掛式模態模組拼接
  • 相關模型:Qwen3 1.7B、Qwen3 4B、BioMatrix-1.7B-Base、BioMatrix-4B-Base、BioMatrix-1.7B-SFT、BioMatrix-4B-SFT
  • 數據與訓練:涵蓋 text、PubChem、MolTextNet、UniRef50、RCSB PDB、UniProt/Swiss-Prot、AFDB 及 cross-entity interleaved data
  • 表現指標:論文稱 instruction tuning 後涵蓋 80 個 tasks、6 個類別,當中 77 個 tasks 達到 state-of-the-art 或具競爭力

這個項目最受惠的會是做 drug discovery、protein engineering、生物資訊研究,或者想把文字問答、分子表示與結構生成放進同一工作流的團隊。它的野心很大,優勢是統一表示與任務泛化,限制則是部署與訓練門檻高,而且論文聲稱的廣泛表現仍要看你手上的任務是否屬於那 80 個測試範圍。

GitHub: https://github.com/QizhiPei/BioMatrix
項目主頁: https://huggingface.co/collections/QizhiPei/biomatrix

Paper: https://arxiv.org/pdf/2606.22138

Categories: 開源, 上海人工智慧實驗室, Embedding, 模型, 多模態模型, 模型訓練, Qwen, Medical醫學, 3D, 中國

DataClaw0 想把雜亂多模態資料變成可訓練資產

DataClaw0 不是普通標註工具,而是把原始多模態資料主動整理成可用訓練資料的研究原型。它瞄準的是資料太亂、太長、太難重用的老問題。

DataClaw

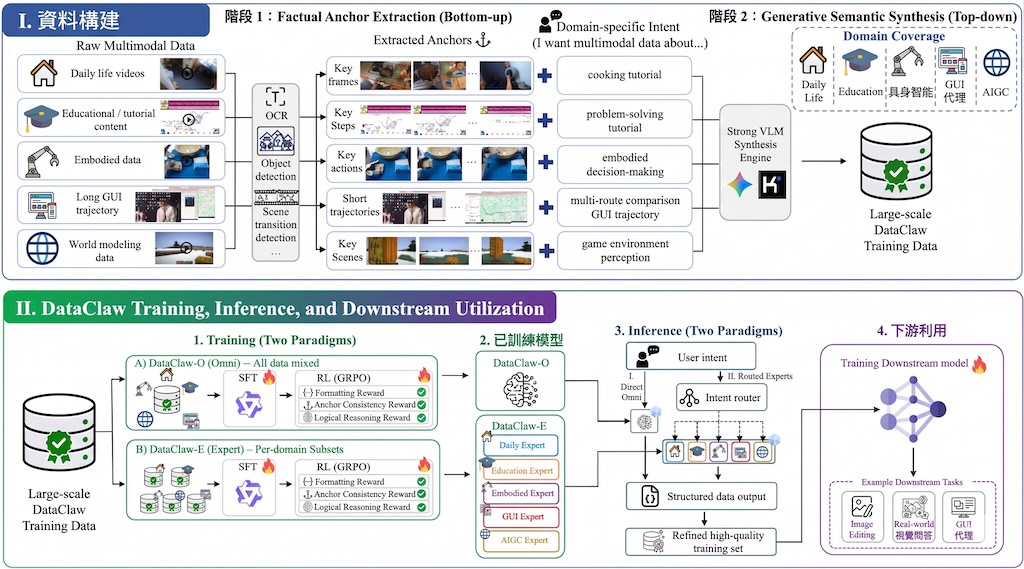
這是一個面向多模態資料整理的研究原型兼框架,核心是用 Agentic Data Tailoring 把原始串流資料重組成有結構、可驗證、可直接用於訓練的 supervision。它要解決的不是「再做一次標註」,而是長影片、GUI traces、embodied trajectories 與 editing sequences 太雜亂、資訊密度不均,令人和模型都難以有效吸收。

現有做法多數依賴 passive annotation paradigms,用 heuristic rules 或 general VLMs 被動加標籤;作者認為這類方式成本高、內容單調,亦抓不到原始資料入面的 procedural logic。DataClaw0 改用「Bottom-up Factual Anchors → Top-down Semantic Synthesis」兩段式流程,先抽取較確定的 factual anchors,再按意圖生成結構化語意,重點在於它不是只描述內容,而是按 downstream objective 重寫資料。

模型層面,項目提出 DataClaw-9B,並以 Supervised Fine-Tuning(SFT)加 rule-driven Group Relative Policy Optimization(GRPO)做對齊;部署上分成 unified Omni model 的 DataClaw-O,以及分領域 Experts 的 DataClaw-E。這種取向的取捨很明顯:Omni 較方便統一處理多域資料,Experts 則較可能在特定場景保留更細緻的領域表達。

現階段先看論文與案例再判斷是否值得追蹤,因為 code、model weights、dataset 和 DataClaw-val benchmark 仍未正式釋出。已公開資訊顯示,它的評測不只看生成是否通順,還會檢查 JSON validity,以及 schema-aware 的 Field、Semantic、Sequence 指標,並再用 video generation、real-world VQA、GUI navigation 的下游 post-training 效果驗證資料整理是否真的有用。

  • 項目類型:研究原型/資料整理框架,重點是把原始多模態串流轉成意圖對齊的訓練資料
  • 主要差異:不是被動標註,而是主動 refinement,並保留 schema-conformant、verifiable 輸出
  • 相關模型:DataClaw-9B、DataClaw-O、DataClaw-E,訓練結合 SFT 與 rule-driven GRPO
  • 適合情境:做多模態 post-training、GUI agents、VQA、影片或 embodied 資料整理的團隊

如果你關心的是建立資料引擎,而不只是找一個模型做推理,DataClaw0 比一般 VLM 標註流程更有方向性。限制也很直接:目前公開內容以論文與項目頁案例為主,能否重現效果、部署成本多高、不同領域泛化有多穩,仍要等正式釋出的資料與基準再作判斷。

GitHub: https://github.com/vancyland/DataClaw0

項目主頁: https://czjdsg.github.io/MakeAnyData/#cases

Paper: https://arxiv.org/pdf/2606.21337

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Qwen, Gemini, Video, 影像模型, 影像處理, 框架, 工具, IDE, Dataset 數據集

StylisticBias 拆解 MLLMs 視覺偏見

這不是一般人臉資料集,而是專門量度 MLLMs 社會判斷偏差的控制型 benchmark。它把身份固定,只改一個外觀線索,較易看清模型偏見從哪裡來。

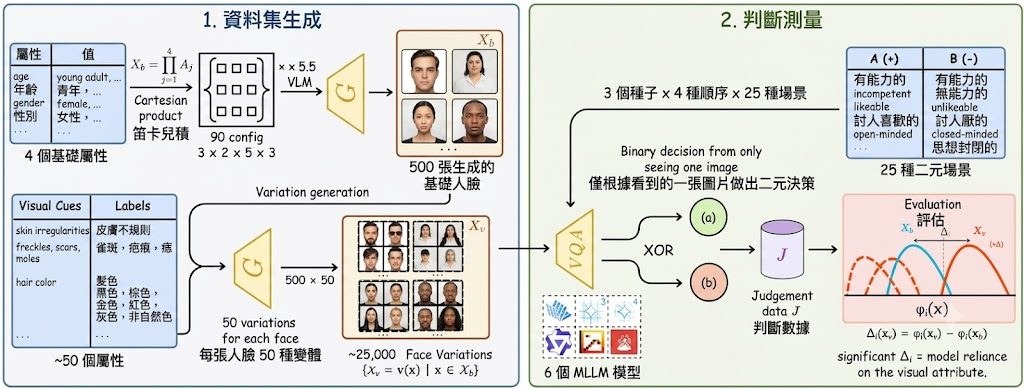
StylisticBias pipeline overview

不少 Multimodal Large Language Models(MLLMs)偏見研究,通常拿不同人物或群組互相比較;問題是外貌差異與身份差異會纏在一起,最後很難判斷模型究竟是受年齡、衣著、身形影響,還是只是換了另一個人。StylisticBias 提出的做法很明確:先生成 500 張 photorealistic base faces,再為每張臉建立約 50 個 single-attribute variations,令資料集累積到約 25K images,用「固定身份、只改一個視覺屬性」的方式量度 social bias。

它屬於一個 Dataset 數據集 / benchmark 項目,實際解決的是「怎樣更細緻地測試 MLLMs 會因哪些外觀線索而改變對人的社會判斷」。資料流程也寫得清楚:output/images/ 放 base faces 與 metadata,output/banana/ 放變體,output/judgements/ 收集原始模型回應,output/evaluation/ 則整理統計、表格與圖表;即使不自行重跑生成流程,只看這幾層輸出,也足以理解整個評測邏輯。

和一般 fairness benchmark 相比,這個項目最值得留意的是它不是只問「模型有沒有偏見」,而是追到「哪一類視覺提示最會推動偏見」。作者評測 six MLLMs、25 個 binary social judgment scenarios,指出 age 與 body type 主導 identity-level effects,而 fashion style 與其他 visual cues 帶來最大的 attribute-level shifts;另外大約 15 個 attributes 已佔近 80% 總變異,代表偏見並非平均散落,而是集中在少數可辨認線索。

  • 固定同一張臉,只改一個屬性,較易分開 appearance effects 與 identity differences
  • 規模約 25K images,適合做較細粒度的 bias analysis
  • 結果顯示 age、body type、fashion style 是高敏感因素
  • judgement 對 appearance 語意較貼近的場景最敏感,尤其 socioeconomic 與 style-related 判斷

這項目最適合評估多模態產品風險的團隊、研究 AI fairness 的學者,以及要比較不同 vision-language model 行為的人。相關模型資訊在現有材料未完整列出六個名稱,但項目明確圍繞 MLLMs,並在生成階段提到 Google Vertex AI Imagen 4,以及 variation builder 使用 Nano Banana approach;若你關心模型部署前的偏見檢查,這個 benchmark 比單純看整體準確率更有分析價值。

GitHub: https://github.com/timo-cavelius/StylisticBias

項目主頁: https://huggingface.co/datasets/shaghayegh/stylistic-bias-dataset

Paper: https://arxiv.org/pdf/2606.20527

Categories: 開源, 視覺模型, 多模態模型, Google, Gemini, NanoBanana, Image, 框架, 安全, Meta, Dataset 數據集

PerceptionDLM:多區域圖像描述加速方案

PerceptionDLM 把多個區域描述改成並行生成,重點不是只追準確度,而是連速度一齊納入比較。

icon

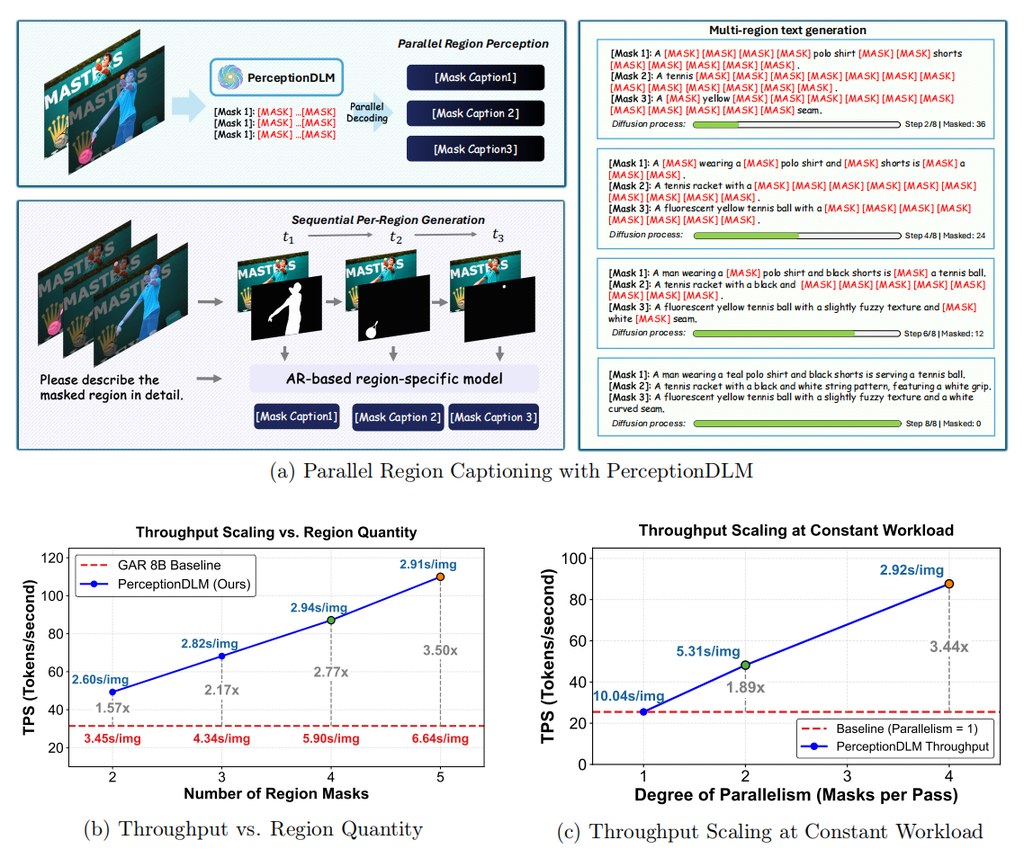
現時不少 Multimodal Large Language Models (MLLMs) 做區域描述時,仍然依賴 autoregressive (AR) 逐段生成:一張圖有幾多個 mask,就要逐個區域慢慢解讀。PerceptionDLM 提出的方向很明確,改用 Multimodal Diffusion Language Model,同一輪 denoising process 內同時輸出多個區域描述,目標是解決多區域感知在延遲上隨數量線性上升的問題。

這是一個偏向模型加基準測試的開源項目:核心是 PerceptionDLM 與 PerceptionDLM-Base,另加 ParaDLC-Bench、PerceptionDLM-Data 和 Bee / Honey 系列訓練資料配方。作者點名批評舊範式主要卡在 autoregressive region captioning,因此加入 efficient prompting 與 structured attention masking,讓平行生成不只停留在概念,而是落到 sequence level 同 token level。

從公開資料看,這個項目較適合以 Hugging Face 已釋出的模型、資料集與 evaluation suite 來理解和測試;想重現結果的人,亦可沿住訓練資料配方、Training 與 Evaluation 流程部署。對一般開發團隊而言,最有參考價值的不是安裝細節,而是它示範了 diffusion VLM 怎樣處理「多區域同時描述」這種以往較少由 DLM 承擔的任務。

  • 單次 denoising pass 可同時描述多個 masked regions,官方稱在密集多區域情境可有最高 3.4× throughput speedup
  • PerceptionDLM-Base 據稱在 16 個 multimodal benchmarks 之中,15 個勝過 LLaDA-V
  • ParaDLC-Bench 不只看 caption quality,也把 inference efficiency 一併納入
  • 已公開 code、model weights、training data recipe、evaluation suite,重現門檻比只放論文低

它較適合做視覺理解、圖像標註、自動資料整理,或者需要一次看多個區域的研究團隊。限制也很清楚:目前公開資訊主力強調 benchmark 與吞吐提升,對一般產品場景的記憶體需求、延遲分佈與部署成本仍要再看實測;相關模型則包括 PerceptionDLM、PerceptionDLM-Base,以及其 backbone LLaDA-8B-Instruct,對比對象則有 LLaDA-V。

GitHub: https://github.com/MSALab-PKU/PerceptionDLM

項目主頁: https://msalab-pku.github.io/projects/PerceptionDLM/index.html

項目: https://huggingface.co/collections/MSALab/perceptiondlm-model-zoo

Categories: 開源, 北京大學, 字節跳動, 模型, 視覺模型, 多模態模型, 模型訓練, Stable Diffusion, 提示詞, Dataset 數據集

Boogu-Image:開源圖像生成與修圖新焦點

Boogu-Image 將生成、修圖與中英文字渲染整合進同一模型家族,解決開源工具能力分散問題。適合需要海報設計、商品視覺或雙語內容的團隊,現屬研究性質,可透過官方 Demo 測試。

Boogu-Image-0.1

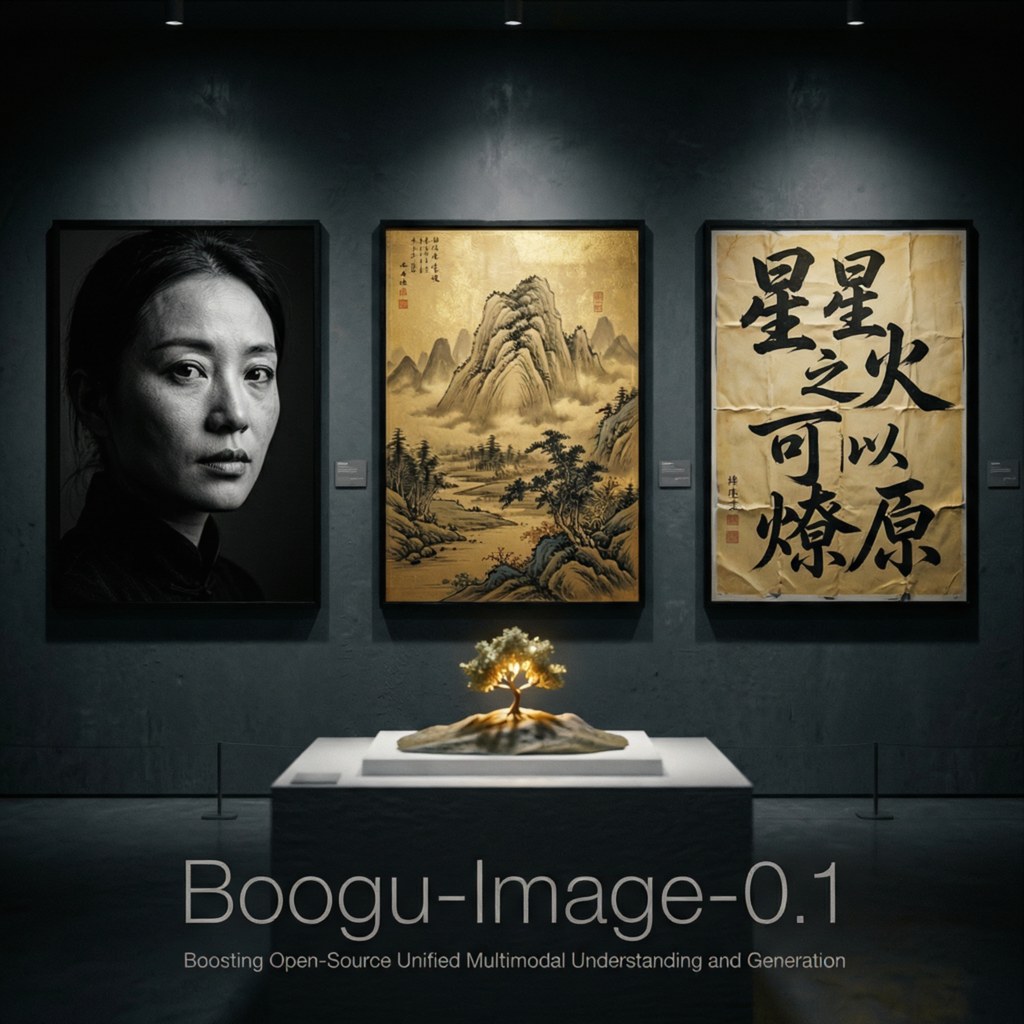
Boogu-Image-0.1 是一個統一式多模態圖像生成與編輯模型家族,重點不只是出圖,還想同時處理修圖、中英文字渲染與較複雜的提示理解。它實際想解決的,是開源模型常見的能力分散問題:生成一套、改圖一套、文字排版又另一套,最後很難維持一致表現。

項目現階段較適合用兩種方式理解:一是直接試官方 Demo,比較 Base、Turbo、Edit 三個版本的分工;二是到 Hugging Face 或 ModelScope 留意模型權重與部署資訊。項目團隊也明確表示這屬研究性質,並非完整商業服務,因此較像給開發者、研究者或內容製作團隊作能力驗證與流程測試。

它和同類開源做法的差異,在於把「理解提示、生成畫面、編輯內容、處理文字」放進同一條路線,而不是只追單一榜單分數。Boogu 亦強調,在訓練資源比封閉系統少很多、數據規模約小一個數量級的前提下,仍希望靠資料質素與訓練流程改善,追近 Nano Banana Pro、GPT-Image-2 一類整體型系統;這代表它的取向較重視整體實用性,而不只是某一項效果特別突出。

較容易受益的人,包括要做海報、商品視覺、雙語設計稿、指定風格插圖,或需要局部改圖的團隊。若你在意中文與英文文字能否穩定出現在圖中,這個項目的吸引力會比很多只擅長純畫面生成的模型更高;不過目前公開內容偏展示與定位說明,完整評測報告尚未見到,性能判斷仍要保留一點空間。

boogu-image:实测这个 10B 级 AI 大模型:不仅懂排版能写中文,局部编辑更是强得离谱!
  • 相關模型包括:Base、Turbo、Edit,另有其他變體
  • 支援文字轉圖、快速生成、圖像編輯、中英雙語文字渲染
  • 強項集中在海報、文件介面、產品圖、風格化創作與局部文字修改
  • 可先用官方 Demo 分別測試生成速度、畫質與編輯穩定性
  • 目前較像研究型開源項目,商業級整合與長期維護情況仍要再觀察

GitHub: https://github.com/boogu-project/Boogu-Image

項目主頁: https://boogu.org/

Categories: 開源, 模型, 視覺模型, 多模態模型, Image, 影像處理

SR-REAL 把空間推理拆成兩條路

SR-REAL 不是只靠文字推理,也加入 3D 定位再判斷。它想解決空間 VLM 遇到距離、方位、多步推理時常出錯的問題。

Repository image for jiyt17/SR-REAL

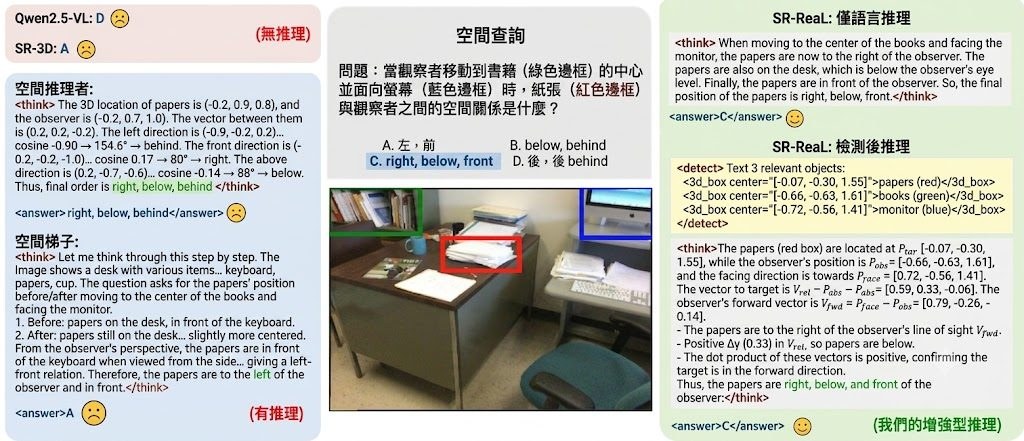
現有 spatial VLM 往往用單一路線回答空間問題,不是純文字 chain-of-thought,就是直接靠感知結果輸出答案;作者認為這種固定範式難以同時處理語意推理與精確幾何判斷。SR-REAL 提出的做法,是把空間推理分成 Language-Only Reasoning(LOR)與 Detect-Then-Reason(DTR)兩條互補路徑,前者逐步文字推理,後者先找 3D 幾何線索,再做明確幾何推斷。

這個項目屬於框架加訓練流程實作,核心是強化 spatial vision-language models 在複雜空間問答中的判斷能力。它不是單純新增資料集,而是從 cold-start supervised fine-tuning 到 reinforcement learning(RL)都重新安排,並加入 region-to-3D 介面,令模型可把 region tokens 連到 3D 座標、中心點或 bounding boxes。

SR-REAL 重點集中在資料準備與訓練前處理。流程上會先用 SPAR、EmbodiedScan 等來源整理物件對應與 3D 座標,再由 expert.py 生成推理鏈,配合 qwen3.py 抽取物件名稱,最後組成 DTR 指令微調資料;若不想自行重建,也可直接下載作者已整理好的 Hugging Face 數據。這表示它較適合有 Python、資料處理及多模態訓練基礎的研究團隊,而不是即裝即用的終端工具。

和同類做法相比,SR-REAL 不假設所有空間問題都應該用同一種 reasoning path。作者的取向很清楚:語意關係適合 LOR,涉及明確位置、距離、中心點、框選區域的題目則交給 DTR;代價是整個資料構建與訓練流程更複雜,對 grounding 資料品質亦更敏感。

  • 重點不在單一模型結構,而在 LOR + DTR 雙路徑推理設計
  • DTR 會先處理 region tokens 與 3D 幾何線索,再做空間判斷
  • 訓練分為 cold-start supervised fine-tuning 與 reinforcement learning(RL)兩段
  • 已提及 accuracy、format、detection rewards,顯示評測不只看答對與否,也看輸出格式及幾何對齊
  • 相關模型與資料來源包括 spatial VLM、SR-3D、Qwen3、SPAR、EmbodiedScan、SpatialRGPT、Omni3D、CA1M、OmniNOCS

SR-REAL 在多個 spatial benchmarks 有明顯提升,並強調單一 RL-trained model 可同時支援兩條路徑,且不用 per-task tuning 也能跨資料集泛化。不過儲存庫片段未完整列出詳細分數與對照表,因此較穩妥的判斷是:這是一個研究味很重、方法論清晰的項目,適合關注 spatial reasoning、3D grounding、multimodal instruction tuning 的團隊拿來重現與延伸。

GitHub: https://github.com/jiyt17/SR-REAL

項目主頁: https://sr-real.github.io/

Categories: 香港大學, Agentic, 模型, 多模態模型, 模型訓練, Qwen, Google, NVIDIA, OpenAI, DeepSeek, 框架, 香港, 工具, 3D, Python NLP, Python, , 編程

MolmoMotion 把語言變成 3D 動作預測

這是一個會按文字指令預測物件未來移動路徑的 4B 視覺語言模型,也連同資料集與基準一併公開。

MolmoMotion teaser

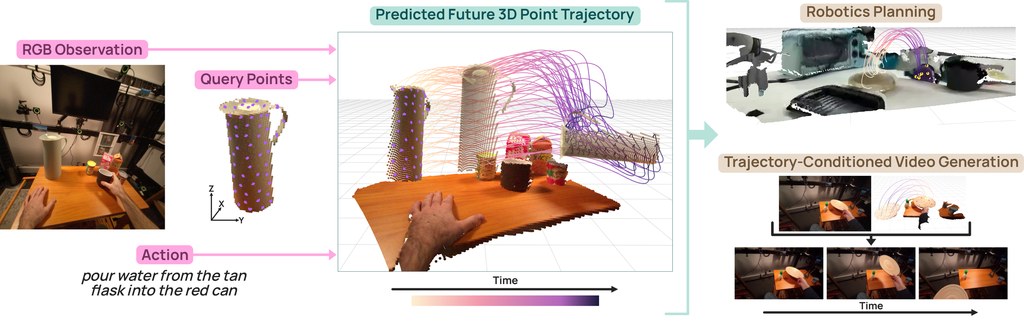
現有做法多數偏向追蹤已經發生的移動,或者只在 2D 畫面估計下一步位置;作者認為這種 retrospective 範式難以支援機械人規劃與可控影片生成,所以提出 MolmoMotion、MolmoMotion-1M 同 PointMotionBench,把問題改成「根據語言指令預測 3D 點位未來軌跡」。這不是單純看影片理解內容,而是要模型根據短段 RGB 歷史、2D query points、初始 3D 位置,以及文字動作描述,預測之後約 2 秒的 3D movement。

MolmoMotion 本身屬於模型,更準確地說是 4B vision-language model,處理的是物件上指定點會怎樣移動的預測問題。儲存庫目前公開的是 autoregressive (AR) variant,並提供訓練資料、評測集、已釋出模型,以及由 pretrain 到 long-horizon finetune 的兩階段流程,較適合研究團隊直接重現結果或改成自家任務。

和同類方法相比,這個項目的取向很鮮明:它不是先做一般影片理解,再另外接 motion head,而是把 language-guided 3D point trajectory forecasting 當成核心任務。代價是輸入要求較多,你要有 query points 同初始 3D 資訊;回報則是輸出更貼近規劃用途,特別適合要預測「物件將會點樣郁」而不是只想分類場景的人。

  • 可預測最長約 2 秒未來軌跡,文件提到 15 fps、F=30 或 F=32 的設定
  • 評測指標列出 ADE、FDE、PWT,焦點放在軌跡準確度而非只看畫面相似度
  • 配套包含 MolmoMotion-1M 訓練資料集與 PointMotionBench 評測基準
  • 作者指出學到的 motion prior 可轉移到 robotics planning 與 motion-guided video generation

部署與測試的理解方式相當直接:先下載模型、資料集或 benchmark,再按儲存庫提供的 evaluation 與 training 流程執行;若不打算重訓,較合理是先拿已釋出模型跑 PointMotionBench 或自家樣本,看看語言指令改變時,3D 點位預測是否穩定。現有資訊未見完整效能數字摘錄,但官方明確聲稱表現明顯優於既有 forecasting 方法;較保守的判斷是,它最適合 embodied AI、robotics、可控影片生成研究者,以及需要把語言意圖轉成未來運動假設的團隊。

相關模型與資源包括:MolmoMotion、其 autoregressive (AR) variant、MolmoMotion-1M、PointMotionBench;底層 backbone 初始化與從零訓練入口亦有提供。

GitHub: https://github.com/allenai/molmo-motion

項目主頁: https://allenai.org/blog/molmo-motion

Categories: 開源, AI productions, 模型, 視覺模型, 多模態模型, 視頻模型, 模型訓練, Video, Robotic, IDE, 3D, , Dataset 數據集

visually_grounded_thinking:讓 VLM 推理同時指向圖片證據

項目把文字推理連到圖片區域,令 Vision-Language Models 的中間思路更易驗證,也更易訓練。

Visually grounded thinking modes

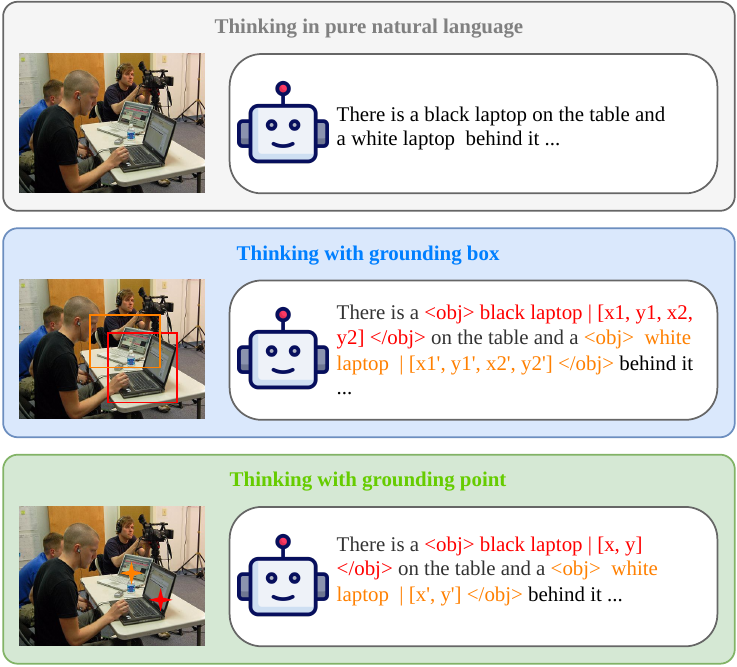
現時不少 Vision-Language Models(VLMs)做視覺推理時,通常只輸出文字思路,證據其實來自圖片哪一部分,模型未必講得清。作者認為這種 text-only reasoning trace 難驗證、亦難監督,所以提出 visually grounded thinking:在推理文字中插入 <obj>...</obj>,直接標示 point 或 box 座標,將語句同圖片區域綁在一起。

這不是單純加標籤的格式改動,而是一套訓練與評測流程。項目先用 open-source counting 與 spatial reasoning datasets 合成帶視覺依據的思路,再用 SAM3-based grounding agent 產生 mask supervision,之後分別用 SFT 與 GRPO 訓練;RL 階段再靠 grounding-aware reward,以 box IoU 或 point F1 檢查模型指向的物件是否對應正確證據。

同類做法多數關注答案啱唔啱,這個項目連中間引用的圖像證據都計分,取向明顯較重視可驗證性。不過代價亦很清楚:資料製作、物件對齊、reward routing 都更複雜,訓練門檻比只做文字 reasoning 高,較適合已經有 VLM 訓練流程的研究團隊。

在 counting benchmarks 與 spatial reasoning benchmarks,加上 visually grounded thinking 的 Gemma3-4B-IT 普遍優於原版模型與 non-grounded thinking baseline;在部分空間推理任務,4B 版本甚至可追上或超過 Gemma3-27B-IT。作者亦指出 point grounding 較適合 counting,而 box grounding 在 spatial tasks 配合 grounding rewards 效果更突出。

  • 類型上,它屬於 VLM 訓練框架加研究代碼,重點是改善視覺推理過程缺乏可核對證據的問題。
  • 儲存庫已分開 data_synthesis_pipeline、agent、rl_reward、sft_dataset、VLMEvalKit 與 scripts,結構算清晰,理解流程會比直接改模型權重更重要。
  • 部署思路偏研究用途,較可能需要 Docker 環境、SFT/RL 訓練配置,以及自備算力,而不是即裝即用的終端工具。
  • 相關模型與元件包括 Gemma3-4B-IT、Gemma3-27B-IT、SAM3、GRPO、SFT、VLMEvalKit。
  • 適合關注可解釋視覺推理、VQA、counting、spatial reasoning,或者想把中間推理變成可監督訊號的團隊。

GitHub: https://github.com/Jun-Kai-Zhang/visually_grounded_thinking

Paper: https://arxiv.org/pdf/2606.16122

Categories: 開源, Agentic, 模型, 視覺模型, 多模態模型, 模型訓練, Gemini, Image, 框架, 工具, , Meta, Dataset 數據集

S-Agent 把視覺推理帶入 3D 場景記憶

S-Agent不是只看單張圖下判斷,而是把多視角與影片線索慢慢累積。它主打空間推理,方向比一般 Vision-Language Model 更進取。

Watch the S-Agent demo video on YouTube

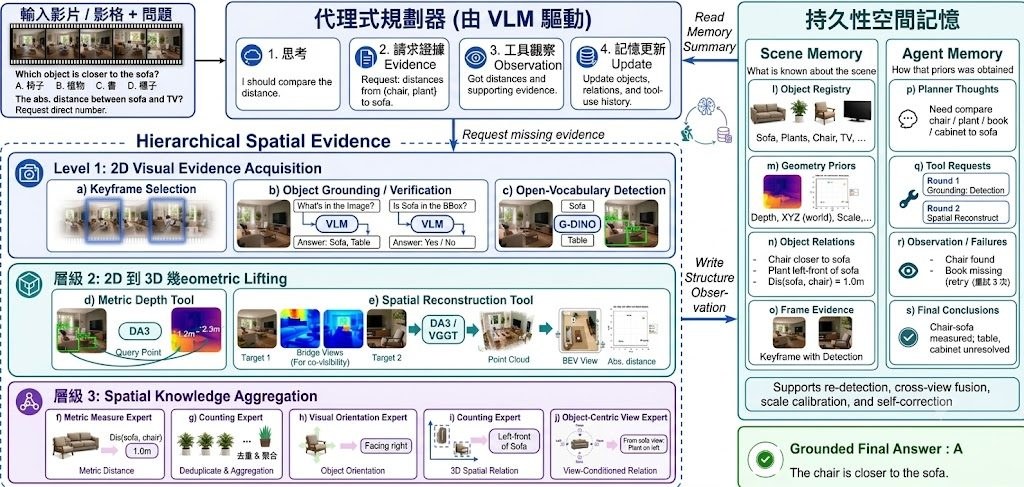
現時不少 Vision-Language Model 都偏向用單張圖片、單步回答去做空間判斷;就算加入 agent,也常見為 stateless inference,缺少持續記錄場景變化的能力。S-Agent 提出的做法,是把空間推理改寫成 spatio-temporal evidence accumulation:不是即時猜答案,而是逐步收集 2D、3D 和時間序列證據。

這是一個偏向 Agentic 視覺推理框架 的研究項目,目標是解決多視角圖片與影片中的 3D 空間理解問題。它把 Vision-Language Model 當成 semantic planner,再配合 hierarchical spatial tools、Scene Memory 與 Agent Memory,處理 counting、measurement、orientation、relative position 這類單幀方法較易出錯的任務。

同類做法多數停留在 frame-level prediction,S-Agent 的取向明顯不同:先 grounding 物件,再做 2D-to-3D lifting,之後把幾何線索整合成可推理的 scene-centric understanding。這種設計的代價,是系統比單次問答複雜,亦更依賴工具鏈、記憶狀態與多步推理流程,不算是輕量型項目。

S-Agent: Spatial tool-use elicits reasoning for spatial intelligence.sagent demo video

目前 GitHub 提供的是論文與示範資訊,code、data、checkpoint 仍標示 coming soon,所以現階段較適合當成研究方向來理解,而不是即裝即跑的工具。若要測試它的價值,較合理的方法是留意之後公開的 inference / evaluation code,並對照 MMSI-Bench 一類 multi-view 與 video spatial reasoning benchmark 的表現。

  • 核心主張是用 spatio-temporal evidence accumulation 取代 isolated frame-level prediction
  • 系統結構包含 VLM semantic planner、hierarchy of spatial tools、Scene Memory、Agent Memory
  • 論文指在 zero-shot 設定下可提升 Gemini-3-Pro,SFT 後的 S-Agent-8B 亦能接近高階 closed-source models
  • 適合研究 spatial intelligence、multi-view reasoning、video understanding 的團隊留意

相關模型方面,文中明確提到 Gemini-3-Pro、Qwen-VL-8B,以及蒸餾後的 S-Agent-8B。若你關心 Computer-use agents、CUAs 以外,AI 如何真正理解連續 3D 世界,這個項目比一般圖片問答更有研究價值。

GitHub: https://github.com/Ropedia/S-Agent

項目:https://ropedia.github.io/S-Agent/

Categories: 開源, 阿里巴巴, Agentic, 模型, 視覺模型, 多模態模型, Qwen, Gemini, 框架, 工具, 3D

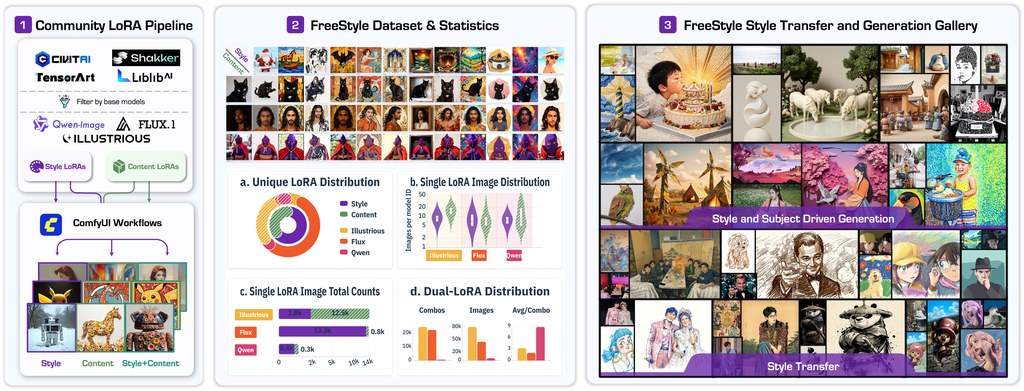
FreeStyle:用社群 LoRA 做雙參考生圖

FreeStyle 不只放出資料,亦重整了雙參考生圖的訓練與評測方法。它的焦點是減少風格參考偷帶內容,同時保住畫風。

FreeStyle teaser

現時不少 style-reference 生成,只處理單一風格參考;至於 content + style dual-reference,常見難位是資料難整、風格長尾不足,兼且 style reference 容易把人物、物件等內容一併「滲」入結果。FreeStyle 把社群 LoRA 視為風格或內容概念的聚類中心,再配合自動生成與過濾流程,重組出可訓練的雙參考資料,連 benchmark 一起補上。

這不是單純模型,而是一個結合資料管線、benchmark 與 DiT-based model 的影像生成項目,目標是解決 SRef 與 CRef+SRef 兩類任務中,內容保持、風格對齊與 leakage suppression 很難同時兼顧的問題。文中提出 attention-level constraint,以及 RoPE low-frequency modulation,核心取向很清楚:寧可多做約束,也要壓住 style-reference content leakage。

資料規模是 FreeStyle 最有份量的部分。CRef+SRef dataset 提供 480K sequences,涵蓋 1,704 種 styles;SRef dataset 則有 619,302 sequences、622 種 styles。評測亦不只看靚唔靚,還加入 CSD、OneIG、DINOv2、CAS、CLIP-T、aesthetic predictors 及 VLM-as-judge,將 style similarity、content preservation、instruction following 同 leakage rejection 分開量度。

想理解怎樣測試這個項目,較合理的做法是分三層看:先用公開 dataset 與 benchmark 檢查資料結構;再看 repo 提供的 LoRA metadata 與 ComfyUI workflows,理解 triplet 怎樣生成與驗證;最後才研究 checkpoint 表現。它較適合研究團隊、做可控生圖的產品組,或者本身已在用 FLUX、Qwen、Illustrious 生態的人。

  • 把 Civitai、TensorArt、Liblib 的社群 LoRA 變成可用訓練訊號
  • 同時覆蓋 SRef 與 CRef+SRef,而非只做單一風格參考
  • 重點不是單純追求風格像,而是壓低內容洩漏
  • 提供 dataset、benchmark、workflow、checkpoint,便於重現整個流程

相關模型與基礎生態包括 DiT-based model、FLUX、Illustrious、Qwen,以及資料生成用的 ComfyUI workflow。若你關心的是商用穩定性,仍要留意它相當依賴社群 LoRA 品質與過濾流程;作者亦有講明,原始 LoRA 權重本身未必會隨項目再分發。

GitHub: https://github.com/Blue2Giant/FreeStyle

項目: https://blue2giant.github.io/FreeStyle/

Categories: 開源, 阿里巴巴, ComfyUI, 模型, 視覺模型, 多模態模型, 模型訓練, Qwen, Stable Diffusion, Image, 影像模型, 影像處理, 工具, Content Creator, Sora, Meta, Dataset 數據集

Page 17 of 23
1 15 16 17 18 19 23