Motion2MixamoRig:把真人動作搬入 Mixamo 角色的開源工具

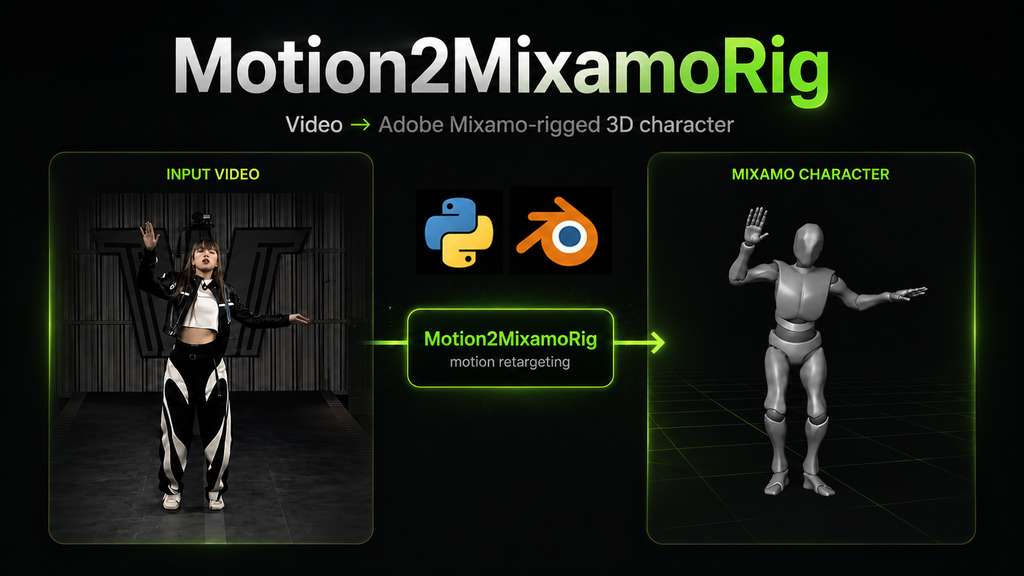
Motion2MixamoRig 將單人影片或照片姿勢轉成 Mixamo 角色動作,直接輸出可供 Blender、Unity 使用的 3D 檔案。

Motion2MixamoRig

把單人動作影片或一張姿勢照片套到 Mixamo 角色上,Motion2MixamoRig 便可輸出預覽影片及帶蒙皮的 .glb 角色檔,減少遊戲開發者重新製作基礎動作的工序。它屬於 3D 動作轉移工具,處理的是真人影像與已綁定骨架角色之間的動作銜接問題。

流程以 SMPL-X、GVHMR 等模型先從影像估計人體動作,再將結果映射到 Adobe Mixamo rig;模型不負責生成全新動作,而是把影片或照片中的姿勢重建後套用到指定角色。輸出可放入 Blender 或 Unity,仍要留意單人畫面、遮擋、鏡頭角度及原角色骨架會影響結果。

模型權重首次執行時約需下載 5 GB;原始資料沒有提供正式性能基準或準確率數字。項目目前仍屬 experimental,0.1.0 提供 command-line pipeline,亦附有 Blender 4.2+ Extension,並在外部 Python 環境執行同一套流程。

  • 支援影片動作及單張照片姿勢
  • 輸出預覽影片與 .glb 檔案
  • 兼容 Blender、Unity 工作流程
  • 需要單人素材及外部模型權重

遊戲原型、角色動畫測試及需要快速重用真人動作的團隊較適合採用。ffmpeg 並非流程必需,但缺少它會令輸出影片沒有聲音,並可能無法在瀏覽器播放;對需要穩定製作級動畫的人員而言,仍要自行檢查骨架映射、腳部滑動和遮擋造成的誤差。

GitHub

Categories: 開源, AI productions, 數字人, 模型, Video, Image, Audio, 工具, 3D, Python, 庫, 動畫

OuroWorld 讓靜態 3D 世界循環動起來

OuroWorld 把靜態 3D 場景轉成可由移動鏡頭觀看、動作無限循環的 3D cinemagraph,亦毋須手動製作遮罩。

OuroWorld Logo

想把重建好的 3D 場景變成有火焰、流水、物件活動或光線變化的循環畫面,OuroWorld 提供了一條直接的處理流程。它屬於 mask-free 的 3D 動態生成框架,會將任何來源的靜態 3D Gaussian Splatting (3DGS) 場景轉成可從不同視角觀看的 3D cinemagraph。

項目不只處理流體般的局部變化,也涵蓋一般形變、物件運動及 illumination change;輸入可以來自傳統重建,亦可以是 HY-World 2.0、Marble 或 Lyra 2.0 等 3D world model。相比需要逐個區域製作遮罩的流程,OuroWorld 減少了前期標註工作,但動態內容的控制精度和生成結果仍要視乎輸入場景與模型能力。

測試時需準備符合格式的 3DGS 場景,以及描述鏡頭的 camera JSON。c2w 使用 OpenCV convention 的 4×4 camera-to-world pose,K 以像素表示,principal point 必須位於影像中心;項目亦提供 ouroworld-import world 方式匯入場景,沒有 camera JSON 時會採用預設鏡頭配置。README 的資料格式說明對接駁外部 3D 世界尤其重要。

可留意的重點包括:
– 由靜態 3DGS 場景生成動態 3D cinemagraph
– 支援移動鏡頭,而非只輸出固定視角動畫
– 不需人工 mask,並處理形變、物件運動與光線變化
– 可接駁重建場景及多種 3D world model
– 筆者被拒下載 Hugging Face 由 Meta 管理的權重

對 3D 重建、世界模型展示、互動場景預覽及視覺內容製作團隊而言,OuroWorld 的價值在於把靜態資產延伸成可循環播放的動態內容。它較適合研究原型和展示項目,正式製作前仍應檢查鏡頭參數、場景格式,以及長時間循環時是否出現動作或光照接縫。

項目主頁 · GitHub

Categories: 開源, 模型, 世界模型, Image, 框架, 3D, 動畫, Dataset 數據集

mg-styles-15:AI 寫出 15 種動態設計短片

Claude Opus 5.5 以程式碼生成畫面、動畫、音樂與音效,並公開提示詞和完整源碼。

The showcase page: the Frame-by-Frame film next to its style notes, with the prompt open below

由一段提示詞開始,Claude Opus 5.5 便能寫出 15 支各具風格的 10 秒動態設計短片,連畫面、動畫、配樂和音效都由程式碼生成。這個開源項目同時提供成片、風格說明、完整提示詞和源碼,實際解決的是把視覺創意轉成可重現瀏覽器渲染流程的問題。

每支片本質上是一個能按時間繪製畫面的網頁,以背景執行 Chrome 逐幀截圖,再由 ffmpeg 合成影片和音軌;3D 作品則額外使用 Blender。使用者需要 Node、Chrome 和 ffmpeg,複製指定提示詞後可修改故事、品牌、配色、尺寸和時長,亦可用 rubric.md 交由另一個 AI 評審再迭代。

• 15 種風格,涵蓋逐格動畫、等距 2.5D、像素藝術、液態動態及 9:16 字幕作品
• 畫面每次重新生成未必相同,原作經過多輪修訂,單次執行通常達不到相同完成度
• 音效腳本具確定性,但只有 4 支能在指定環境精確重現原音軌,其餘 11 支可能因數值庫版本而有差異
• 字體未隨倉庫提供,缺少指定字體會令文字造型與原片不同

對內容創作者、動態設計師和想研究 AI 輔助編程的人,這個項目更像可拆解的製作案例,而不是按掣即出的成品工具。它把創意、提示詞、瀏覽器渲染和聲音合成放在同一條可閱讀的流程內,方便比較不同風格如何透過程式結構呈現;代價是需要自行處理環境、字體和多輪修訂。

項目主頁 · GitHub

Categories: 開源, AI productions, Video, Audio, 提示詞, 工具, Content Creator, 3D, 庫, 編程, Anthropic, 動畫, 音樂

MiniMax H3 4-bit 量化保留原生影音生成

MiniMax H3 壓縮至 4-bit 後,仍保留影片與音訊生成能力。

Og image

要在較有限的硬件資源下製作影片,又不想放棄同步音訊,MiniMax H3-QuantFunc-4bit 提供了一個量化選擇。頁面將它定位為 MiniMax H3 的 4-bit 量化版本,而非獨立微調模型;原始基礎模型可確認為 MiniMax H3,但未交代更完整的 base model 訓練資料或微調流程。

模型把核心權重精度由 16-bit 降至 4-bit,官方稱壓縮幅度約為 4 倍,並宣稱角色細節、風格一致性及快速動作仍可維持。它支援 text-to-video、image-to-video,以及原生 video+audio generation;附真人演出、動畫追逐、高速汽車及風格化角色展示生成結果。

FL2VA 在相同提示詞及 seed 下,QuantFunc INT4 對 BF16 基準取得約 23.7 dB PSNR。這個數字可用作重建品質參考,但屬項目方的內部測試,未有列出測試硬件、影片設定、速度或顯存用量,因此不能單憑該指標推算日常生成體驗。

  • 標籤包含 svdquant、int4、quantized 及 comfyui,但沒有交代量化演算法細節。
  • 頁面未提供 GGUF 檔案名稱、檔案大小、mmproj、上下文長度或推薦量化級別。
  • 未列明 llama.cpp、Ollama 或 LM Studio 支援,也沒有硬件需求及 MTP draft speculation 資訊。
  • 項目連結 ComfyUI-QuantFunc,較適合配合相關工作流探索;授權為 MiniMax H3 Community License,使用前應查閱條款。

模型

Categories: 開源, ComfyUI, AI productions, 模型, 視頻模型, 模型訓練, Video, Image, 影像模型, 影像處理, Audio, 提示詞, Discord, LLaMa, Ollama, 動畫, MiniMax

4Director:3D 幾何精準控制影片世界模型

4Director 將鏡頭、物件與新加入的物件放進同一個 3D 空間,改善影片生成中動作失控和視角不一致的問題。

4Director

想令影片中的鏡頭、原有物件和新加入的物件按指定路徑移動,4Director 提供了一個較接近 3D 動畫製作的控制方式。它屬於影片世界模型,處理的是生成影片時深度、旋轉和跨視角一致性難以同時維持的問題。

系統會先為每件物件重建一個 canonical mesh,再以每幀一組 rigid transformation 推動物件,並把整個場景渲染成深度影片。Motion Adapter 之後將這份幾何骨架轉換成具備外觀、光照和非剛性動態的影片;新物件則可透過參考影像插入場景,並與鏡頭及原有物件共同控制。

相較只控制鏡頭、依賴 image-plane cues,或使用 3D tracks、blobs 的方法,完整網格能保留物件未被鏡頭看見的幾何,減少物件離開畫面後再出現時形狀和身份改變的情況。影片生成研究、視覺特效預演,以及需要精確安排物件運動的製作團隊較容易受益,但重建網格和建立剛性軌跡亦增加了準備工作。

  • RealCOD-Rigid 提供 20,774 段附有剛性 3D 場景標註的影片片段。
  • Identity-Gated IoU(IG-IoU)同時衡量物件動作是否跟隨指令,以及物件身份能否保持。
  • 實驗報告指 4Director 在畫質、鏡頭控制和物件控制方面優於多種先前方法。

4Director 目前更適合作為研究原型和可控影片生成的實驗基礎,而非即裝即用的剪片工具。理解其效果時,應同時檢查生成畫面的外觀品質、指定軌跡的遵循程度,以及物件離開後重新出現時的身份一致性。

項目主頁 · GitHub

Categories: 開源, AI productions, 世界模型, Video, 工具, 3D, 動畫

PhysStream:邊播邊拉物件,讓 AI 影片生成更貼近物理直覺

PhysStream 是一個物理導向的影片生成模型,用戶可以在生成過程中隨時拖動物件來改變它的運動方向,做到真正的中途互動控制。

Og image

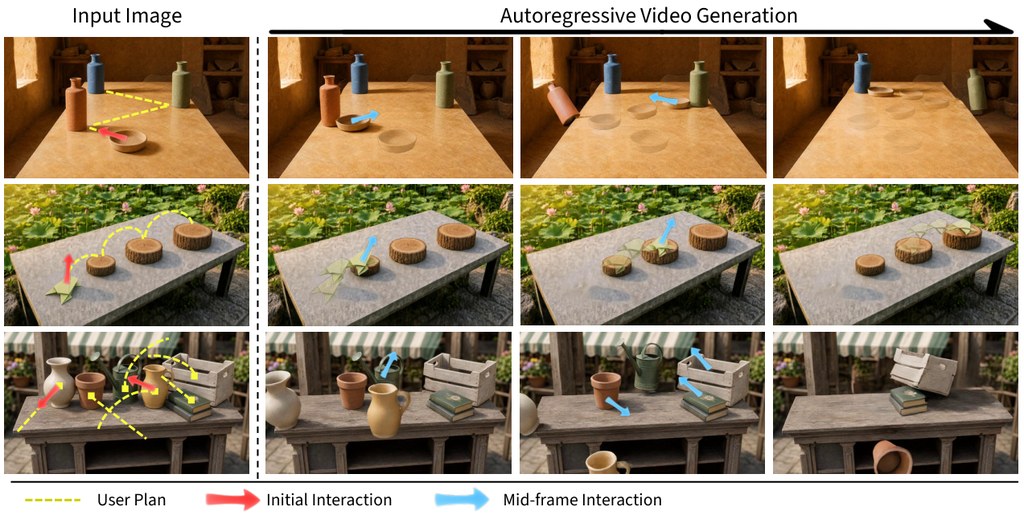
以往想用 AI 生成一段符合物理規律的影片,往往需要在生成前就設定好整個控制排程,而且很多方法只懂在像素層面指定物件位置,未必真正理解「力」與「速度」這類物理量。PhysStream 的切入點正正落在這個空隙:它是一個自回歸的物理導向圖生影片模型,支援中途互動,容許用戶在生成過程中隨時拉動物件,改變它的運動方向。

核心做法分兩個階段。先用一個雙向模型做微調,加入速度增量(velocity increment)這類稀疏信號作控制條件,讓模型學到背後的動力學;再訓練一個因果自回歸模型,引入結構化場景記憶,記錄位置圖與物件追蹤圖,使每一幀生成都能參考歷史畫面的一致狀態。同時解決了「中途介入」與「物理一致性」兩個難題。

PhysStream 把運動分佈距離(FVMD)降低 33%、軌跡誤差降低 12%,而且在真實場景的人類評測中,超過 85% 的對比都獲得偏好。在多物件桌面剛體場景裡,這種邊生成邊控制的能力是目前其他方法做不到的。對做特效、動畫預覽或物理模擬預演的團隊來說,這種「拉到邊做」的互動模式會比較貼近日常工作流。

重點摘要:

  • 中途拖動控制:生成過程中可隨時改變物件運動方向,毋須事先設定控制排程
  • 物理導向信號:採用速度增量而非像素位置,讓模型學習真正的動力學
  • 結構化場景記憶:以位置圖與物件追蹤圖維持長影片一致性
  • 兩階段訓練:先雙向微調學控制條件,再因果自回歸強化物理一致性
  • 評測表現:FVMD 降 33%、軌跡誤差降 12%,人類評測偏好率逾 85%

項目主頁

Categories: AI productions, 視頻模型, 模型訓練, Video, World-Action Model, Robotic, 動畫

KaiNinja 將 3D 生成推到部件級 – 直接拆零件

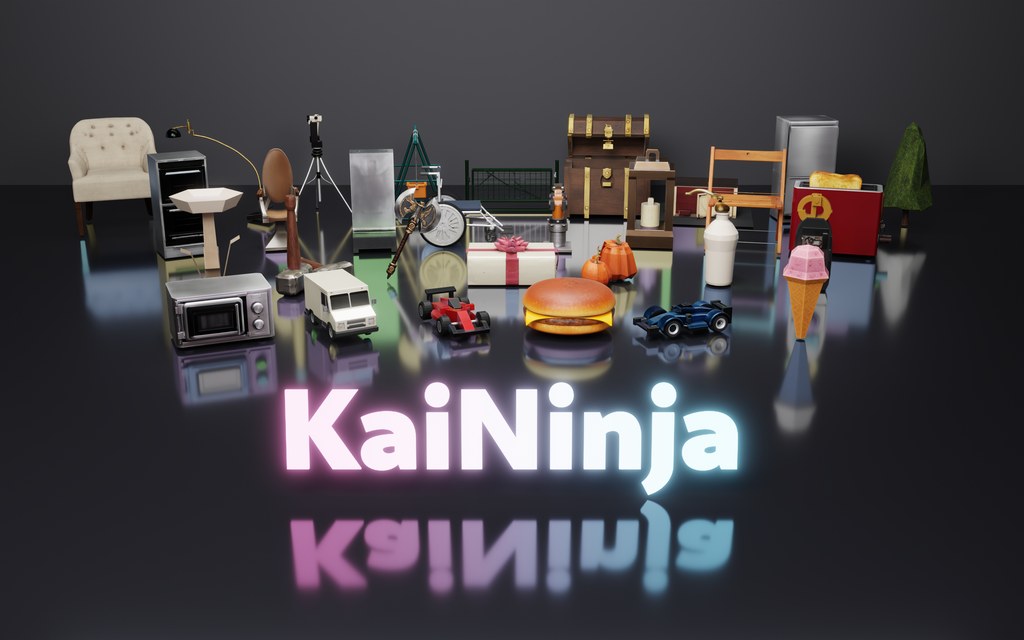
一張圖就能生成分件可拆的 3D 模型,毋須人手標註或語義分割。KaiNinja 用兩個 O-Voxel 體素保留部件接觸面,把原生 3D 生成器延伸到部件級。

KaiNinja teaser

以往想做一張椅子、可以分開拆件再重新組裝的 3D 模型,往往要事先畫遮罩或跑一套語義分割網絡,既費時又限制後續編輯彈性。KaiNinja 由 Alaya Lab 團隊提出,目標是把 TRELLIS.2 這類原生 3D 生成器直接延伸成「部件級」輸出,毋須遮罩或分割網絡就能從單張圖生成可拆分的部件網格。

模型輸出兩個 O-Voxel 體素,各自解碼後透過連通區分量化成獨立部件,同時保留部件之間的接觸面,避免拆件後出現破洞或懸空。換言之,它在現有 3D 生成流程中替代或補強的,就是那一步手動標註與分割。

對遊戲美術、3D 資產設計、以及需要快速做可編輯原型的團隊來說,這類即拆即改的部件輸出明顯降低後製成本。雖然目前只釋出技術報告與項目頁面,推斷碼與預訓練權重尚未開源,但官方展示的下游材質替換與手繪動畫片段,已能看出部件分離對後續工序的實質幫助。

官方在 986 個物件的評測中,以匈牙利配對方式同時報告整體與部件級指標,在 CD、F1、mIoU 七個項目上均領先 X-Part、OmniPart、PartPacker、AutoPartGen 等同類方法,亦勝過用同一語料微調過的 TRELLIS.2。Fail 率(即整體 CD 大於 0.1 的比例)亦由 5.4% 降至 0.7%,代表部件拆分並沒有犧牲整體幾何質素。

重點摘要

  • 輸入單張圖片即可輸出部件級 3D 網格,免遮罩免分割網絡
  • 以兩個 O-Voxel 體素保留部件接觸面,避免拆件破洞
  • 在 986 件評測中,部件與整體指標同步領先 OmniPart、PartPacker、AutoPartGen
  • Fail 率由 TRELLIS.2 的 5.4% 降至 0.7%,整體幾何質素未受部件任務拖累
  • 目前僅有技術報告與項目頁面,源碼與權重標示為 Coming soon

項目主頁 · GitHub

Categories: 開源, 騰訊, AI productions, 模型, Image, 3D, 動畫

BVB 用 影片內容令 AI 自動轉為 Blender 3D 場景

BVB 拋開選擇題,要求 AI 代理直接用 Blender 重建 288 段真實室內影片,從程式碼品質判斷它到底有冇真正理解畫面內容。

BVB logo

現時大多數影片理解 benchmark 都係問 AI 「張圖入面有幾多張椅」,但 BVB(Blender-VideoBench)行另一條路:畀 AI 睇一段室內影片,然後叫佢自己寫 Blender 腳本,把場景、鏡頭動線逐個 primitive 砌返出嚟。如果代理人交到一個可以重新開啟、可以渲染嘅 .blend 檔,代表佢真係睇明條片。

每個代理會都被困喺同一個 Blender 4.2 Docker 沙盒入面,淨係可以用 bash 同 frames,仲有共享成本上限。禁止使用任何外部素材庫,幾何體全部由代理自己用基本操作砌出嚟。呢種「同條件競技」設計解決咗以往影片 benchmark 靠選擇題容易被 prompt hack 或者背答案嘅問題。

數據方面,BVB 用咗 ARKitScenes、ScanNet、ScanNet++ 嘅 288 段室內影片,配合 5,130 條時空題目,並涵蓋 10 個模型家族、共 51 個配置。評分用兩條軸:Dual VQA 睇重建場景保留幾多影片入面嘅時空事實;Latent Similarity 就用凍結影片 embedding 對比重建結果同原片嘅感知距離,再以平方根均值合成綜合分數。

對做空間智能、機器人感知或者影片理解研究嘅團隊嚟講,呢個 benchmark 提供咗一個更貼近「代理人真係要喺軟件入面操作世界」嘅測試場景。視頻生成、動畫製作或者世界模型團隊亦可以直接借用 Mini-BVB harness 喺自己 pipeline 度做壓力測試。

團隊結果顯示,最強配置喺 Latent Similarity 做到 88.6,但 Dual VQA 仲有明顯差距,代表現時頂級模型仲未做到「理解」同「重建」兩條線同步推進。呢個落差本身就係 BVB 想凸顯嘅訊號:識答題未必等於識建模。

重點摘要

  • 288 段真實室內影片,全部來自 ARKitScenes、ScanNet、ScanNet++ 嘅 held-out split。
  • 51 個代理配置橫跨 10 個模型家族,統一跑喺 Mini-BVB 沙盒同成本上限下。
  • 禁止使用外部素材庫,逼代理人由 Blender primitives 自己砌幾何。
  • 評分用 Dual VQA 加 Latent Similarity 兩條軸,避免單一指標偏廢。
  • 目標係可執行、可重新渲染嘅 .blend 檔案,而唔係文字描述或者單張圖。

項目主頁 · GitHub

Categories: 開源, Agentic, AI productions, Embedding, 視覺模型, 多模態模型, 世界模型, Qwen, OpenAI, Gemini, Video, 軟件, 庫, Anthropic, 動畫, Dataset 數據集

ComfyUI-DLSS5-Enhancer:強化影片材質細節

直接調用原生 D3D12 渲染管線,把遊戲級嘅 DLSS 5 Neural Rendering 套到影片幀上面,重建皮膚、頭髮同布料嘅材質反應。

Repository image for Blueforcer/ComfyUI-DLSS5-Enhancer

一般後製銳化或 AI upscale 工具處理嘅多數係邊緣同紋理,皮膚嘅次表面散射、頭髮嘅光線穿透呢類材質反應好難靠濾鏡模擬。Blueforcer/ComfyUI-DLSS5-Enhancer 選擇咗另一條路:將 ComfyUI 內部嘅 RGBA8 幀傳去一個原生 D3D12 worker,由 ReShade 載體配合 RenoDX DLSS 5 add-on 觸發 NGX feature 18,重建完再送返 ComfyUI,仲支援 1.5x 到 3x 升頻。影片本身冇 motion vectors,佢哋用 OpenCV DIS 做稠密光流逐幀估算,並喺場景切換時自動重置 history,等渲染器唔會將錯誤嘅時序資料傳入去。

呢個項目嘅類型係工具 / 節點包,定位好明確:畀 ComfyUI 用戶喺影像同影片工作流直接用 DLSS 5 嘅神經渲染器。佢唔係一個自帶模型嘅外掛,神經組件係 NVIDIA、ReShade、RenoDX 嘅原生 binary,呢個 repo 只負責實作 client side 嘅二進制協議,包括 session 建立、解像度協商、幀序、取消同診斷。

NVIDIA DLSS 5 In ComfyUI Changes EVERYTHING! Full Setup Guide

硬件要求 NVIDIA RTX 50 系列原生支援,透過社區 runtime 可以喺 RTX 40 同 30 上面跑,RTX 20 或更早直接拒絕。ComfyUI 需要 V3 node API(comfy_api.latest),Python 依賴 numpy、av 同 OpenCV,ComfyUI portable 通常已經內建。

幾個重要限制:nr intensity 鎖死喺 1.0,1.0、1.5、2.0 嘅輸出 bit identical;skin structure strength 必須開啟 automatic mask 先有效,閂咗之後所有皮膚參數都唔再產生變化;nr preset 喺任何數值下都係 bit identical。只有 local structure strength 同 local tone strength 係全程範圍真正可調。預設、J、K 幾個 dlss model preset 嘅源幀 detail energy 大約喺 0.56x 左右,呢個唔係銳化工具想要嘅走向,反映嘅係材質重建比邊緣強化重要嘅設計取向。
適合已經用 ComfyUI 做影片後製、CG 合成、AI 動畫修復或者數字人相關工作嘅團隊同個人創作,尤其係想處理 skin、hair、fabric 呢類容易被傳統濾鏡抹平嘅材質細節嘅場景。留意到嘅限制係 GPU 受限於 NVIDIA,而且沒有 Python API,調用方式只能透過 ComfyUI 節點流程。

GitHub

Categories: 開源, ComfyUI, AI productions, 數字人, NVIDIA, API, Video, Image, 工具, 3D, Python, 動畫

jarvis-voice-butler:識睇住嘢同你傾偈 + 開瀏覽器幫你查資料

用講嘢就可以叫 AI 幫你上網、搜尋、填表,仲配上一把英式管家口吻。這個項目把 LiveKit Agents、Google Gemini Live 同 Playwright 串成一套聲控代理人。

Repository image for ruxakK/jarvis-voice-butler

聲控助手最麻煩嘅地方,往往係講完一句佢就要重新聽成段指令,又或者根本無法直接代你落手做嘢。Jarvis 直接針對呢個卡位,把 LiveKit Agents 框架、Google Gemini 3.1 Flash Live 即時語音模型,同 Playwright 操控嘅 Chromium 瀏覽器三樣嘢扣埋一齊。你可以理解成一個識講英式冷笑話嘅 AI 管家:你開口叫佢搜尋資料、撳掣、打字、捲頁、讀網頁內容,佢都會即時用「Enceladus」把聲回應你,過程仲支援自適應打斷同搶先生成。

對比起一般只能對答嘅語音 bot,呢個項目最大嘅突破係將語音輸入直接打通到瀏覽器操作層。佢內建十一個工具,包括開網址、搜尋、讀取同檢查頁面、撳掣、打字、捲動、撳掣鍵同截圖,仲有一個 confirm_browser_action 安全閘,去處理會造成實際後果嘅動作,例如提交表單或者刪除資料。視訊鏡頭輸入亦支援,等 AI 可以「睇到」你。

How to build a JARVIS AI Voice Agent for FREE | Full Livekit Tutorial (2026)

如果你想由頭砌起,作者用 uv 管理 Python 依賴,前端就用 Next.js 加 React,而家嘅程式庫亦用 Python 寫評估測試,覆蓋代理行為、瀏覽器操作同 prompt 表現。前端介面跟住會播一段自訂粒子動畫,連 Flutter 手機客戶端都一齊包埋,等你可以用手機當遙控。

呢類項目最適合做內部自動化研究助理,或者需要示範 Computer-use agents(CUAs)點樣融入聲音介面嘅團隊。值得留意嘅限制係實作仍處於早期階段,prompt 同安全策略都係寫死嘅版本,如果你想用佢處理高風險任務,仍然要自行加多一層審批同監察。

GitHub

Categories: 開源, Agentic, Google, Gemini, Audio, 框架, 工具, Python, 庫, 語音, 動畫

Page 3 of 5
1 2 3 4 5